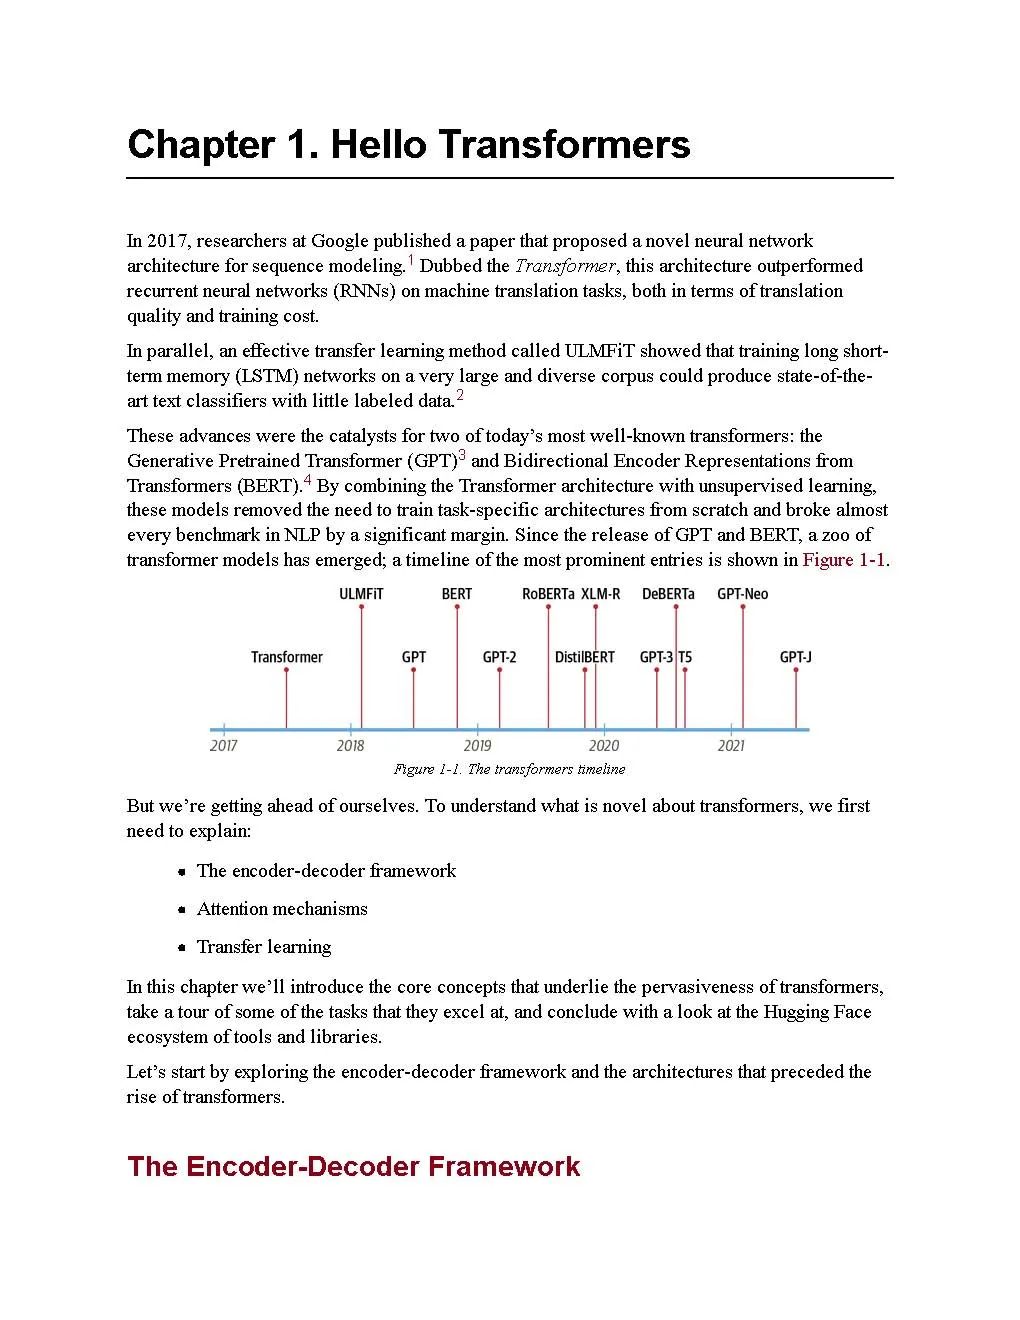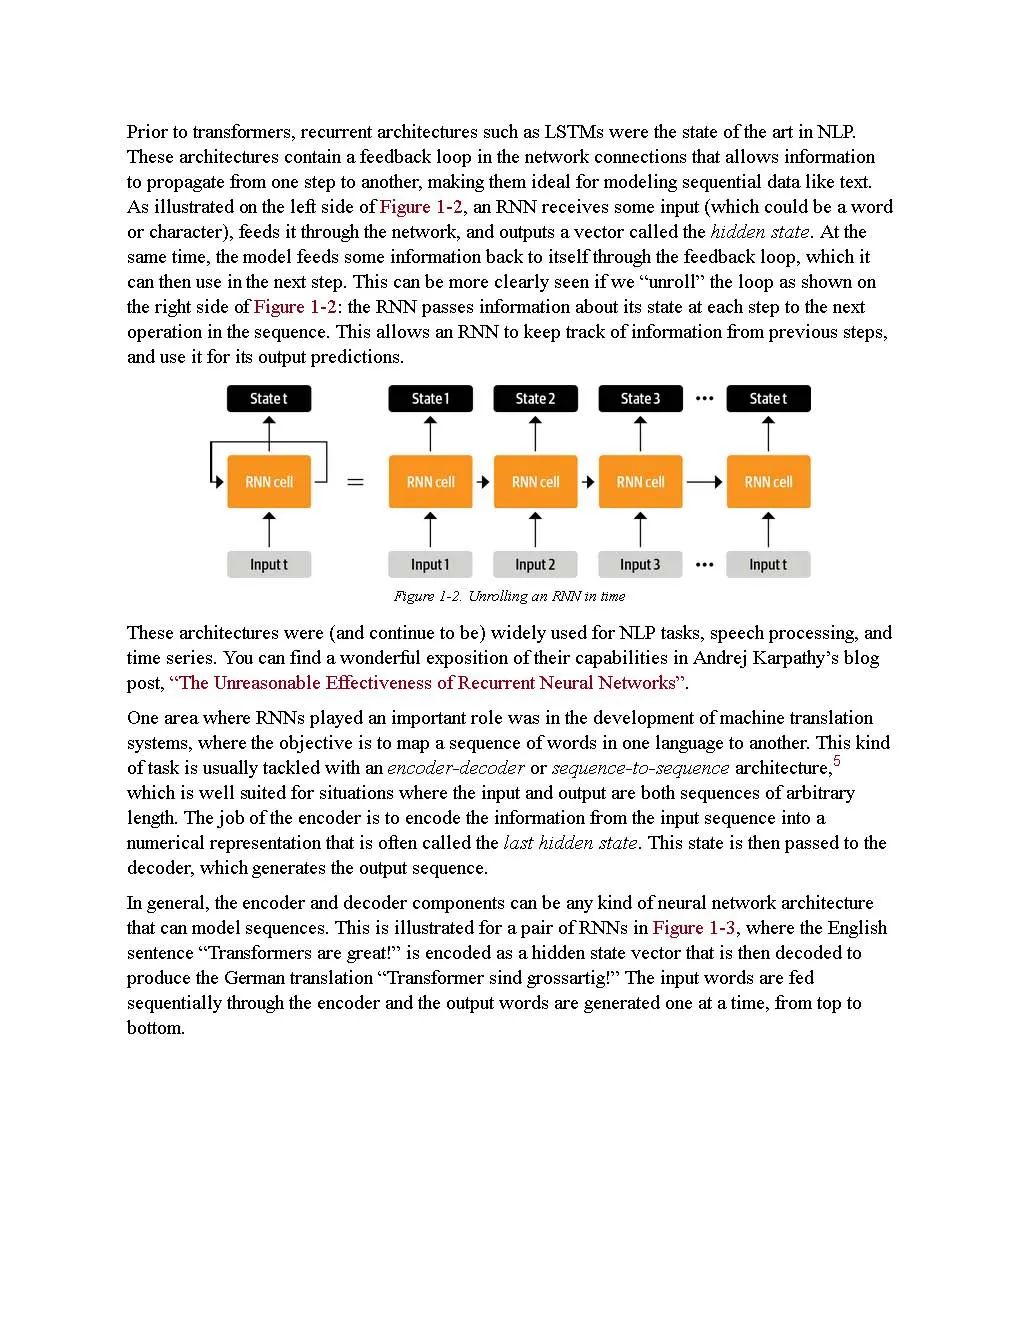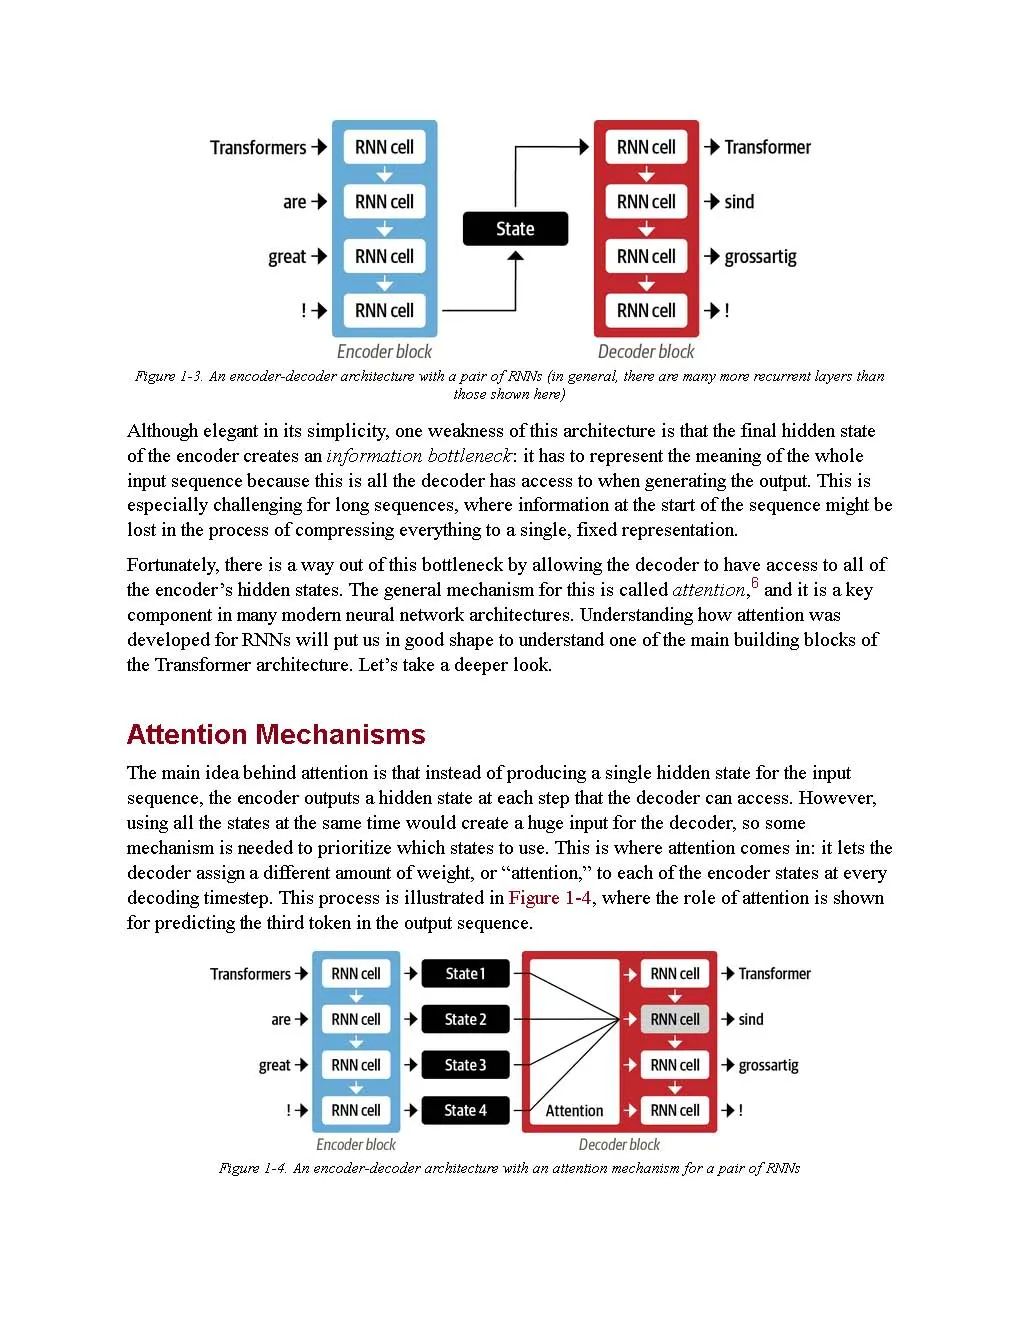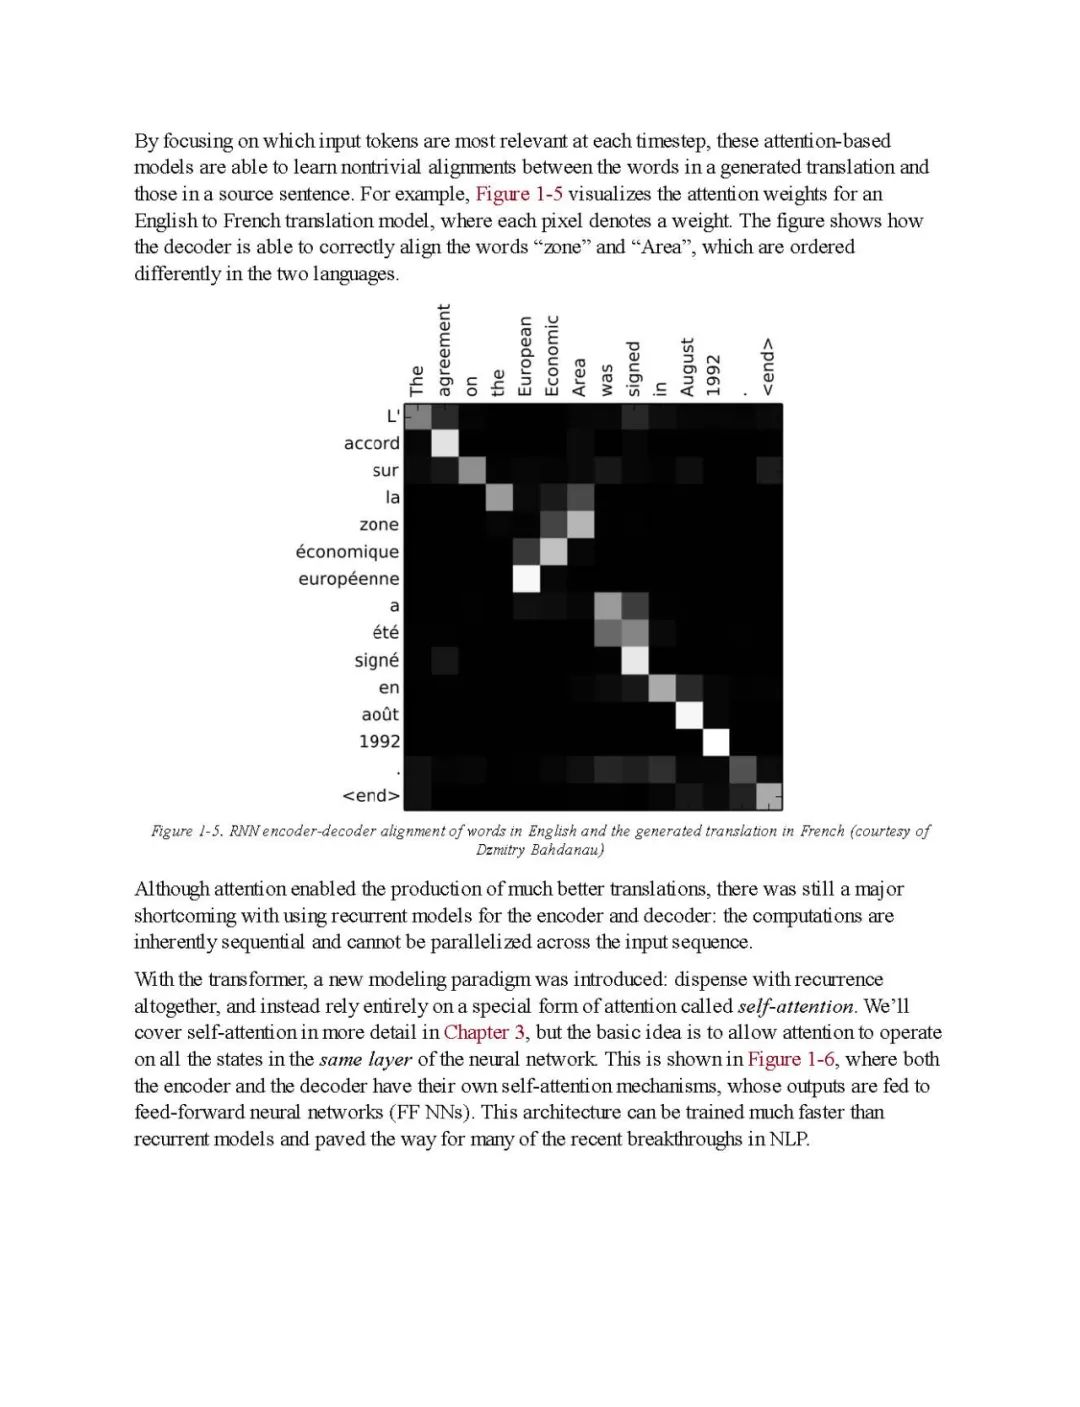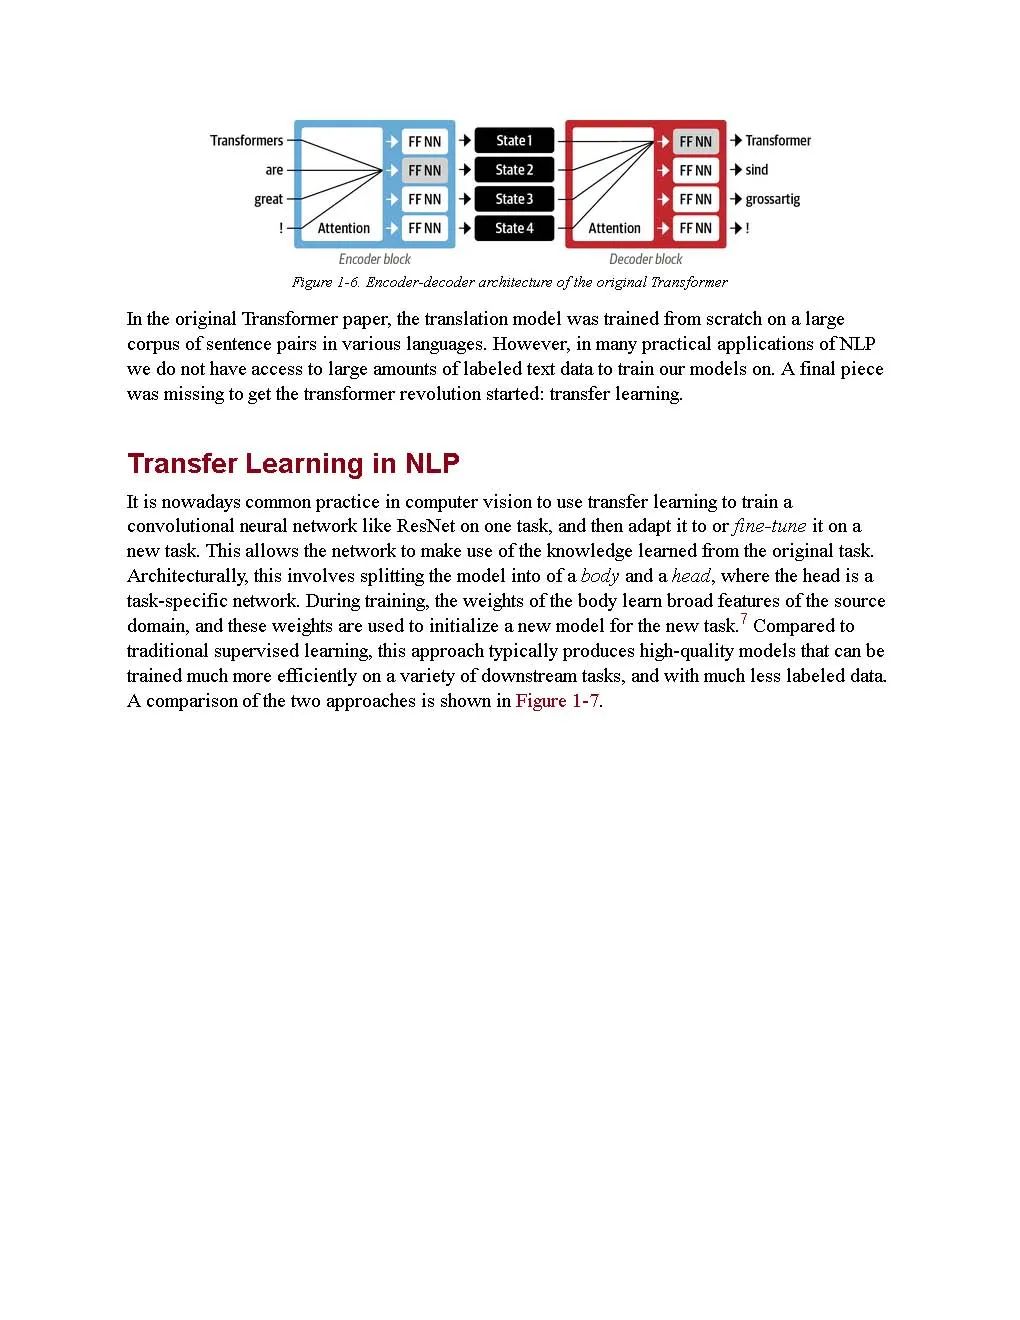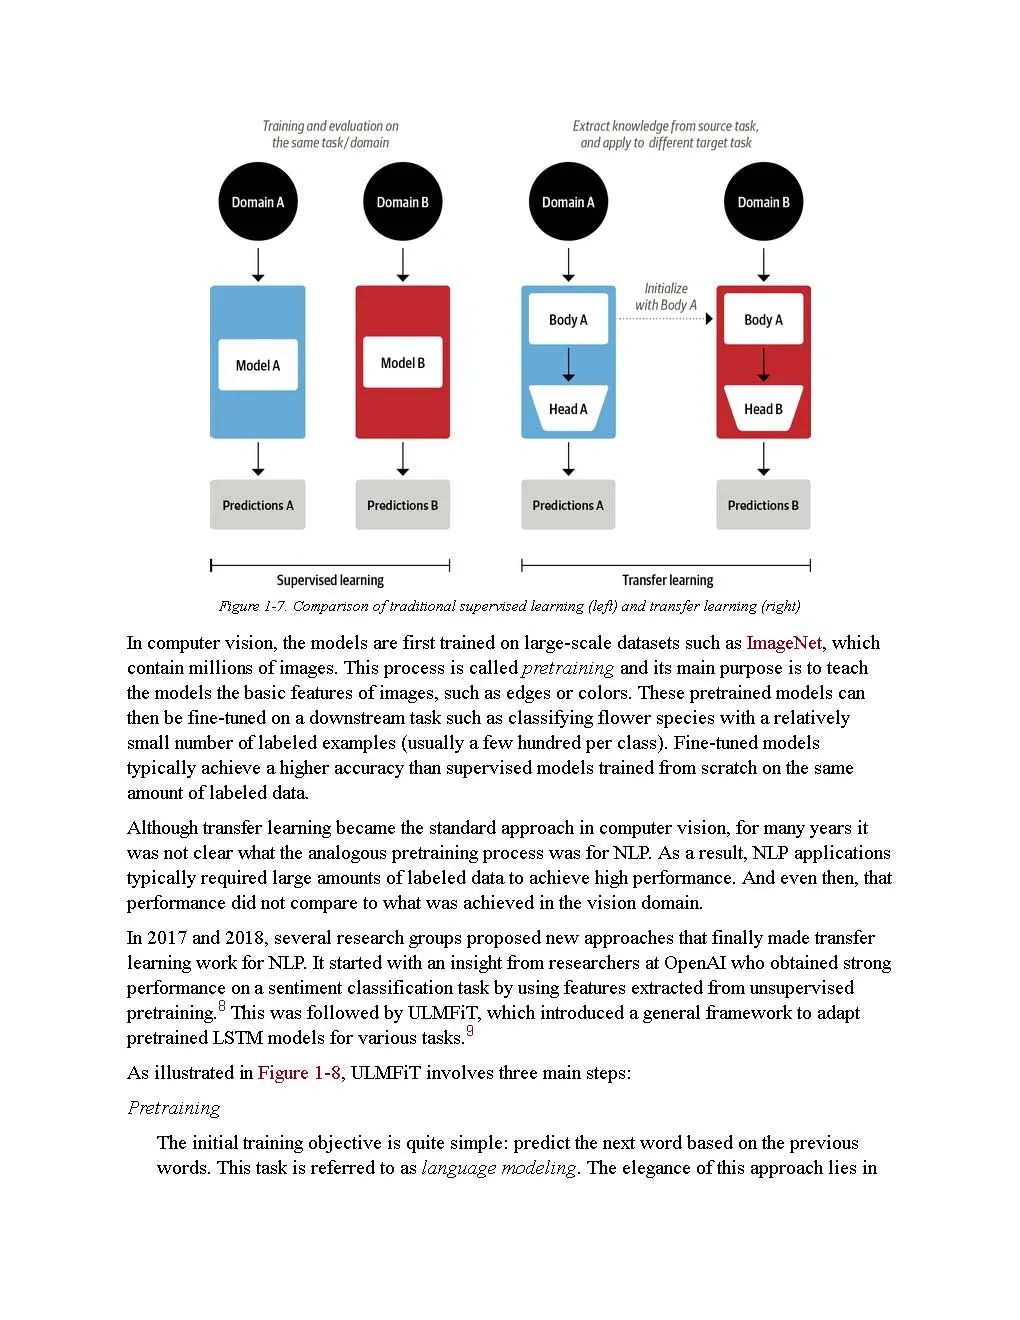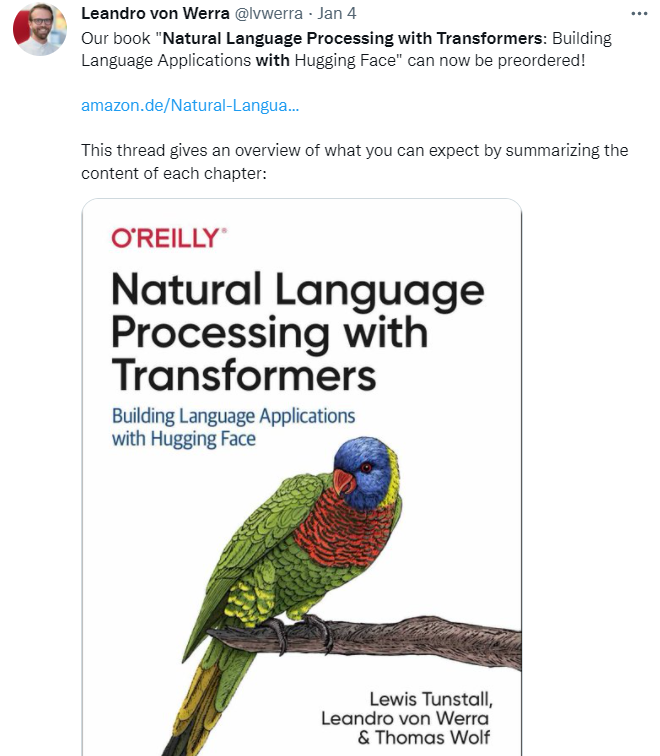
大模型书籍:NLP大牛Thomas Wolf等新书《Transformer自然语言处理》,免费分享466页pdf及代码

Transformers for Natural Language Processing.pdf 图书简介 该书将带您学习使用Python的NLP,并研究了由Google,Facebook,Microsoft,OpenAI和Hugging Face等先驱者创建的变压器体系结构中的各种杰出模型和数据集。 这本书分三个阶段训练您。在向RoBERTa,BERT和DistilBERT模型过渡之前,第一阶段向您介绍从原始变压器开始的变压器体系结构。您会发现一些小型变压器的培训方法在某些情况下可以胜过GPT-3。在第二阶段,您将应用自然语言理解(NLU)和自然语言生成(NLG)的转换器。最后,第三阶段将帮助您掌握高级语言理解技术,例如优化社交网络数据集和假新闻识别。 在这本NLP书籍的最后,您将从认知科学的角度理解变压器,并精通将技术巨头预先训练好的变压器模型应用于各种数据集。 您将学到什么 使用最新的预训练变压器模型 掌握原始Transformer,GPT-2,BERT,T5和其他变压器模型的工作原理 使用优于经典深度学习模型的概念创建理解语言的Python程序 使用各种NLP平台,包括Hugging Face,Trax和AllenNLP 将Python,TensorFlow和Keras程序应用于情感分析,文本摘要,语音识别,机器翻译等 测量关键变压器的生产率,以定义其范围,潜力和生产限制 立即下载

img

https://www.oreilly.com/library/view/natural-language-processing/9781098103231/

我已将大模型书籍免费分享出来,需要的小伙伴可以扫取。
自2017年推出以来,Transformer已迅速成为在各种自然语言处理任务上实现最先进结果的主导架构。如果你是一名数据科学家或程序员,这本实用的书向你展示了如何使用基于python的深度学习库hugs Face transformer来训练和扩展这些大型模型。

Transformers 已经被用来编写真实的新闻故事,改进谷歌搜索查询,甚至创造出讲笑话的聊天机器人。在本指南中,作者Lewis Tunstall、Leandro von Werra和Thomas Wolf(拥抱Transformers 的创始人之一)使用亲身实践的方法来教你Transformers如何工作,以及如何将它们集成到应用程序中。你会很快学到他们能帮你解决的各种任务。

为核心NLP任务构建、调试和优化Transformers模型,如文本分类、命名实体识别和回答问题

  • 学习如何使用Transformers进行跨语言迁移学习
  • 在真实世界中标签数据稀缺的场景中应用Transformers
  • 利用蒸馏、剪枝和量化等技术,使Transformers模型有效地用于部署
  • 从零开始训练Transformers ,学习如何扩展到多个GPU和分布式环境

本书的目标是让您能够构建自己的语言应用程序。为了达到这个目的,它关注于实际的用例,并且只在必要的时候深入研究理论。这本书的风格是动手操作,我们强烈建议您亲自运行代码示例来进行试验。本书涵盖了NLP中transformers的所有主要应用,每一章(除了少数例外)专门针对一个任务,结合一个实际的用例和数据集。每一章还介绍了一些额外的概念。以下是我们将涉及的任务和主题的一个高级概述:

  • 第一章,你好Transformers,介绍了Transformers,并把它们放到了背景中。它还介绍了“Hugging Face”生态系统。

  • 第二章文本分类,重点介绍了情感分析(一个常见的文本分类问题),并介绍了Trainer API。

  • 第三章,Transformer剖析,更深入地介绍了Transformer架构,为接下来的章节做准备。

  • 第四章,多语言命名实体识别,重点关注在多语言文本中识别实体的任务(一个令牌分类问题)。

  • 第五章,文本生成,探讨了Transformers模型生成文本的能力,并介绍了解码策略和度量。

  • 第六章,摘要,深入研究了文本摘要的复杂序列到序列任务,并探讨了该任务使用的度量。

  • 第七章“问答”,重点介绍了基于综述的问答系统的构建,并介绍了利用Haystack进行检索的方法。

  • 第八章《Transformers在生产中高效运行》,重点介绍了模型性能。我们将着眼于意图检测的任务(序列分类问题的一种类型),并探索知识蒸馏、量化和剪枝等技术。

  • 第九章,处理很少或没有标签,着眼于在没有大量标签数据的情况下提高模型性能的方法。我们将构建一个GitHub问题标签和探索技术,如零样本分类和数据增强。

  • 第十章,从头开始训练Transformer,向您展示了如何从头开始构建和训练一个自动完成Python源代码的模型。我们将研究数据集流和大规模培训,并构建我们自己的标记器。

  • 第十一章,未来方向,探讨了Transformers面临的挑战和一些令人兴奋的新方向的研究,在这一领域将进入。

代码:

https://github.com/nlp-with-transformers/notebooks

在这里插入图片描述

img

img

img

img

img

img
我已将大模型书籍免费分享出来,需要的小伙伴可以扫取。

深度学习自然语言处理-Transformer模型.zip 立即下载

相关推荐

自然语言处理典藏合集.pdf

自然语言处理典藏版合集、DataFun的技术合集。最新一期自然语言处理峰会资料合集。1000多页最新研究成果的资料。pdf版本。

大模型书籍推荐:Transformer自然语言处理: 构建语言应用,附409页pdf免费下载

Transformers 已经被用来编写真实的新闻故事,改进谷歌搜索查询,甚至创造出讲笑话的聊天机器人。在本指南中,作者Lewis Tunstall、Leandro von Werra和Thomas Wolf(拥抱Transformers 的创始人之一)使用亲身实践的方法来教你Transformers如何工作,以及如何将它们集成到应用程序中。你会很快学到他们能帮你解决的各种任务。本书涵盖了NLP中transformers的所有主要应用,每一章(除了少数例外)专门针对一个任务,结合一个实际的用例和数据集。

python12222_的博客 1191

C#实战:5分钟搞定西门子S7-1200 PLC数据读写(S7netplus保姆级教程)

本文详细介绍了如何使用C#和S7netplus库快速实现与西门子S7-1200 PLC的数据读写。从环境准备、连接管理到数据读写高级技巧,提供了保姆级教程和实战方案,帮助开发者绕过常见陷阱,提升工业自动化项目的开发效率。

weixin_28432777的博客 285

2024大模型书籍推荐,外网爆炸的《基于ChatGPT、GPT-4等Transformer架构的自然语言处理》

Transformer 是自然语言理解(Natural Language Understanding,NLU)的游戏规则改变者,NLU是自然语言处理(NaturalLanguage Processing,NLP)的一个子集。NLU已成为全球数字经济中 AI的支柱之一。随着数据量的不断增长,训练 AI模型需要的规模也越来越大。Transformer 模型为参数驱动的 AI开启了新时代。我们需要大量参数进行学习,才能学习到由数以亿计的单词组合的数据集。

2401_85327249的博客 1317

软件项目成本控制实战:从COCOMO模型到挣值分析的5个关键步骤

本文详细介绍了软件项目成本控制的5个关键步骤,从COCOMO模型估算到挣值分析预警,帮助中小型团队精准管理预算。通过简化COCOMO II的有机模式、动态建立成本基准、轻量化挣值分析等方法,项目经理可以有效应对预算超支和进度延误问题,提升项目成功率。

weixin_30733003的博客 228

目标检测数据集 第059期-基于yolo标注格式的水果李子检测数据集(含免费分享)

李子作为中国三大水果之一,种植历史超 3000 年,在市场中占据重要地位。传统李子种植、施肥、采摘依赖大量人力,存在资源浪费、产量估算不准、采摘时机难把控等问题。此前,农业领域缺乏针对 “未成熟李子” 的专用数据集,现有水果检测数据集多聚焦于成熟果实(如苹果、柑橘),且未覆盖李子种植的复杂自然场景。在使用该数据集进行学术研究时,应遵守相关的学术规范,引用该数据集的来源,尊重数据集创作者的劳动成果。,用于训练改进型模型,解决李子精准检测的核心痛点。

深度学习算法工程师,专注于前沿算法研究与实战应用。在这里,我将分享深度学习领域的实战经验、优质数据集资源以及最新论文解读与精度分析,旨在与广大技术爱好者共同探索人工智能的奥秘,助力技术成长与创新。 774

自学大模型LLM,看这本书就够了!帮你快速入门大模型!(含PDF)

1.1 Transformer 的生态系统1.2 使用Transformer 优化NLP模型1.3 我们应该使用哪些资源1.4 本章小结1.5 练习题。

老皮的博客 1141

CentOS系统MySQL安装与配置全攻略

关系型数据库是数据存储和管理的核心技术,MySQL作为其中最流行的开源数据库,采用客户端-服务器架构实现数据的高效组织与访问。其核心原理基于SQL语言和ACID事务特性,支持多种存储引擎满足不同场景需求。在Linux环境下,通过yum/dnf包管理器可以快速部署MySQL服务,同时支持源码编译实现深度定制。数据库安装后的安全加固和性能调优尤为关键,包括设置复杂密码、配置防火墙规则、调整内存参数等。本文以CentOS 7/8系统为例,详细讲解从基础安装到生产环境优化的全流程,特别针对国内用户遇到的网络问题和依

weixin_32667955的博客 293

NLP界大佬Thomas Wolf等新书来了《Transformer自然语言处理》,一共466页pdf及代码免费分享

自2017年推出以来,Transformer已迅速成为在各种自然语言处理任务上实现最先进结果的主导架构。如果你是一名数据科学家或程序员,这本实用的书向你展示了如何使用基于python的深度学习库hugs Face transformer来训练和扩展这些大型模型。Transformers 已经被用来编写真实的新闻故事,改进谷歌搜索查询,甚至创造出讲笑话的聊天机器人。

zhishi0000的博客 1510

VS Code + Codex 在 WSL 中使用的正确姿势

Codex 登录只能在本地完成。文件仍可通过 UNC 路径访问 WSL → 本地 Codex 就能照常工作。避免在 WSL 内重复安装/登录 Codex 扩展。

yangguangwuyue的博客 9861

Allegro 中复制一部分PCB到另一个PCB中去

引言:自从学了allegro后,我每天快乐地再拉线,一开心肯定出事情。不料今天一高兴,把本来在5层的铜皮直接在4层画起来了。不过,幸好我知道换层,才省了又要画铜皮的时间。好了,开干,如果要将其他层的铜皮换到想要换到的层上,就需要这个命令。

tianpu2320959696的博客 974

NLP界大佬Thomas Wolf等新书再次来袭——《Transformer自然语言处理》,附466页PDF+代码

本书的目标是让您能够构建自己的语言应用程序。为了达到这个目的,它关注于实际的用例,并且只在必要的时候深入研究理论。这本书的风格是动手操作,我们强烈建议您亲自运行代码示例来进行试验。本书涵盖了NLP中transformers的所有主要应用,每一章(除了少数例外)专门针对一个任务,结合一个实际的用例和数据集。每一章还介绍了一些额外的概念。

zhishi0000的博客 1620

NLP大牛Thomas Wolf的新书《Transformer自然语言处理实战》,466页pdf

自2017年推出以来,Transformer已迅速成为在各种自然语言处理任务上实现最先进结果的主导架构。Transformers 已经被用来编写真实的新闻故事,改进谷歌搜索查询,甚至创造出讲笑话的聊天机器人。

Y525698136的博客 1282

Ultralytics 框架中predict 与 track 的区别

在 Ultralytics 框架中,predict 和 track 是两种不同的推理方法,分别用于目标检测(或分割、姿态估计)和目标跟踪任务。

浩瀚之水的专栏 1127

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

NLP大牛Thomas Wolf等新书《Transformer自然语言处理》,466页pdf及代码

自2017年问世以来,Transformer模型在众多自然语言处理(NLP)任务中取得了突破性进展,成为业界的主流技术。对于数据科学家和程序员而言,这本书将指导你如何利用Python深度学习库Hugging Face Transformers来训练和扩展这些复杂的模型。Transformer模型已经在多个领域大放异彩,包括撰写新闻报道、优化搜索引擎结果,甚至开发出能够讲笑话的聊天机器人。

2401_84204413的博客 907

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

NLP界大佬Thomas Wolf等新书再次来袭——《Transformer自然语言处理》,466页PDF+代码,免费下载

自2017年推出以来,Transformer已迅速成为在各种自然语言处理任务上实现最先进结果的主导架构。如果你是一名数据科学家或程序员,这本实用的书向你展示了如何使用基于python的深度学习库hugs Face transformer来训练和扩展这些大型模型。Transformers 已经被用来编写真实的新闻故事,改进谷歌搜索查询,甚至创造出讲笑话的聊天机器人。

zhishi0000的博客 762

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

NLP大牛Thomas Wolf发布新书,全书466页pdf及代码无偿分享

每一章还介绍了一些额外的概念。第一章,你好Transformers,介绍了Transformers,并把它们放到了背景中。第十一章,未来方向,探讨了Transformers面临的挑战和一些令人兴奋的新方向的研究,在这一领域将进入。第七章“问答”,重点介绍了基于综述的问答系统的构建,并介绍了利用Haystack进行检索的方法。第五章,文本生成,探讨了Transformers模型生成文本的能力,并介绍了解码策略和度量。第六章,摘要,深入研究了文本摘要的复杂序列到序列任务,并探讨了该任务使用的度量。

zhishi0000的博客 421

今年读过最绝的一本书!《自然语言处理原理、方法与应用》,几乎把自然语言处理讲透了【附PDF】

本书系统阐述自然语言处理基础知识,以及自然语言处理高级模型应用等高级知识。全书共11章:第1~5章为自然语言处理的基础知识,第6~11章将自然语言处理知识应用于实战。书中主要内容包括预训练模型、文本分类、机器阅读理解、命名实体识别、文本生成、模型蒸馏与剪枝及损失函数等知识。书中包含大量应用示例,不仅可以学会理论知识还可以灵活应用。书中示例基于Linux与PyTorch环境开发,读者在学习自然语言处理知识的同时还可学会PyTorch框架技术,内容完整、步骤清晰,提供了工程化的解决方案。

2401_85377976的博客 2098

《自然语言处理理论与实战(唐聃)》PDF源代码+《大数据智能互联网时代的机器学习和自然语言处理技术(刘知远)》PDF+对比学习...

自然语言处理涉及开发工具、Python语言、线性代数、概率论、统计学、语言学等知识,还有一些核心理论,运用这些理论和编程技能才能处理文本,并且需要深入学习,这两本书感觉还不错,可以配套阅读。 《自然语言处理理论与实战》高清PDF,362页,带书签目录,文字可以复制;配套源代码。唐聃等著。 《大数据智能互联网时代的机器学习和自然语言处理技术》PDF,293页,带书签目录,文字可以复制,...

977

好书推荐|大模型必学《Transformer自然语言处理实战》

今天又来给大家分享ai大模型书籍了,今天是这本非常畅销的书----《Transformer自然语言处理实战》涵盖了Transformer在NLP领域的主要应用。

2301_81940605的博客 955

自然语言处理相关书籍及其他资源

特别推荐: 1、HMM学习最佳范例全文文档 2、无约束最优化全文文档 一、书籍: 1、《自然语言处理综论》英文版第二版 2、《统计自然语言处理基础》英文版 3、《用Python进行自然语言处理》,NLTK配套书 4、《Learning Python第三版》,Python入门经典书籍,详细而不厌其烦 5、《自然语言处理中的模式识别》 6、《EM算法及其扩展》 7、《统计学习基础》

qianqianxiao的专栏 1126

AI大模型-800字讲明白

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;在未来,随着硬件、算法和应用的不断进步,大模型有望为人类社会带来更多的福祉。

2401_84204413的博客 2202

NLP的标准工具书,《Transformer自然语言处理实战》先到先得!!(附PDF)

自Transformer在2017年发布以来,自然语言处理领域就迈入了一个全新的时代。以Transformer为基础的模型,不断推动着自然语言处理技术的进步与革新。如今随着ChatGPT的发布与流行,Transformer也被越来越多的人所了解和使用。本书涵盖了Transformer在NLP领域的主要应用。首先介绍Transformer模型和Hugging Face 生态系统。

2401_85327249的博客 1085
上一篇: PreparedLLM:高效训练领域大语言模型的“前预训练”框架
下一篇: 哪份工作最适合你?使用 LLMs 和 semantic_text 将简历与工作进行匹配
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值