MindSpeed加速百万级超长序列大模型训练

FasterMoE:Modeling and Optimizing Training of Large-Scale Dynamic Pre-Trained Models阅读笔记 FasterMoE:Modeling and Optimizing Training of Large-Scale Dynamic Pre-Trained Models阅读笔记;参考b站视频 阅读详情

长序列已经成为主流大模型能力之一

23年底Gemini1.5 Pro发布以来,大模型序列长度迅速增长,处理超长序列上下文(Context)已经成为了目前主流闭源和开源大模型的重要能力之一,在模型规模不变的情况下,增大序列长度可以显著提升模型效果。同时,多模态大模型由于需要处理视频、语音等超长时序信号,模型的上下文窗口需要持续增大。为了保持大模型在超长序列场景的性能,在预训练以及微调过程中,通常会加入部分长序列输入对模型进行训练。目前,主流大模型均已支持128K及以上的序列长度输入。

长序列分布式训练面临的挑战

在长序列训练场景,大模型的训练开销(内存和计算量)会以非线性的速度增长,为长序列训练带来巨大挑战。为了加速大模型长序列训练效率,业界提出了多种上下文并行(Context Parallelism,CP)加速方案,对模型的输入上下文窗口进行切分,通过分布式并行技术将计算和内存切分到多个设备,降低每个设备上的负载。目前主流大模型加速库均提供了上下文并行方案以加速长序列训练效率,例如DeepSpeed的Ulysses和Megatron的Ring Attention。

然而,在实际使用场景中,两种方案存在各自的局限性。

Ulysses会对注意力头进行切分,在4D并行场景中,张量并行(TP)也会对注意力头进行切分,因此上下文并行(CP)的维度会受到注意力头数的限制,从而影响到上下文窗口的有效扩展。

Ring Attention不涉及对注意力头的切分,因此理论上最大序列并行维度不受限,能够实现上下文窗口的无限拓展。然而,在实际应用中,P2P通信需在序列长度足够大的情况下才能被计算过程所掩盖。此外,与集合通信相对,P2P通信在利用通信带宽方面存在局限性。再者,分块注意力计算对于特定位置编码、注意力掩码(attention mask)和注意力算法泛化能力较弱,因此针对不同的应用场景可能需要对分块算法进行专门的调整。

MindSpeed长序列训练加速方案

针对现有长序列训练场景的痛点,MindSpeed在并行算法、计算效率、内存占用以及通信四个维度系统性优化大模型长序列训练效率,支持大模型百万级长序列训练。

并行算法–同时支持三种上下文并行算法/兼容专家并行

MindSpeed同时支持了Ulysses,Ring Attention上下文并行方案,同时还支持混合上下文并行方案[3]。该方案对Ulysses和Ring Attention进行了融合嵌套,通过混合排布AllToAll通信和P2P通信,提升了跨节点场景上下文并行的通信效率,同时缓解了Ulysses方案最大并行维度受到注意力头数限制的问题。

此外,MindSpeed上下文并行兼容专家并行。专家并行是稀疏专家模型(MoE)训练场景中常用的分布式并行加速方案。在MoE训练场景下,MindSpeed可以同时开启上下文并行和专家并行加速万亿MoE超长序列训练场景。

计算优化—支持FlashAttention

FlashAttention(FA)[4]通过IO感知的分块注意力算法,大幅提升了整体注意力计算效率。MindSpeed长序列训练加速方案使用了昇腾亲和的FlashAttention算子对注意力计算进行加速,大幅提升注意力计算效率。

内存优化–ALiBi和Reset Attention Mask压缩

在长序列训练场景,注意力掩码带来的内存开销巨大。例如当序列长度为256K时,一个完整的注意力掩码的大小是图片,存储成本过高。
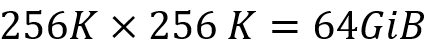
ALiBi和Reset Attention Mask是长序列训练场景两种常用的技术,MindSpeed针对这两种场景提供了Mask压缩方案,实现内存优化,支撑昇腾上典型长序列训练场景。

ALiBi 位置编码压缩

为了更好的解决位置编码的外推能力,扩展上下文长度,ALiBi(Attention with Linear Biases)[5]通过向注意力分数的每一项添加一个线性偏置项来引入位置信息,见图1。FA算子通过两个入参可以控制ALiBi生成时位置的偏移,从而在内核通过分片的方式生成小块掩码,避免传入完整的ALiBi偏置矩阵。
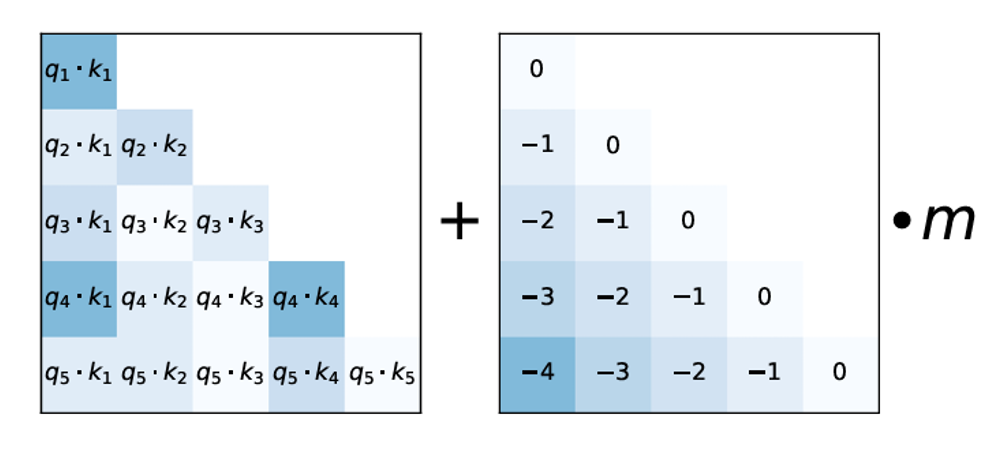
图片

图1: ALiBi通过偏置矩阵添加线性偏置示意图[5]

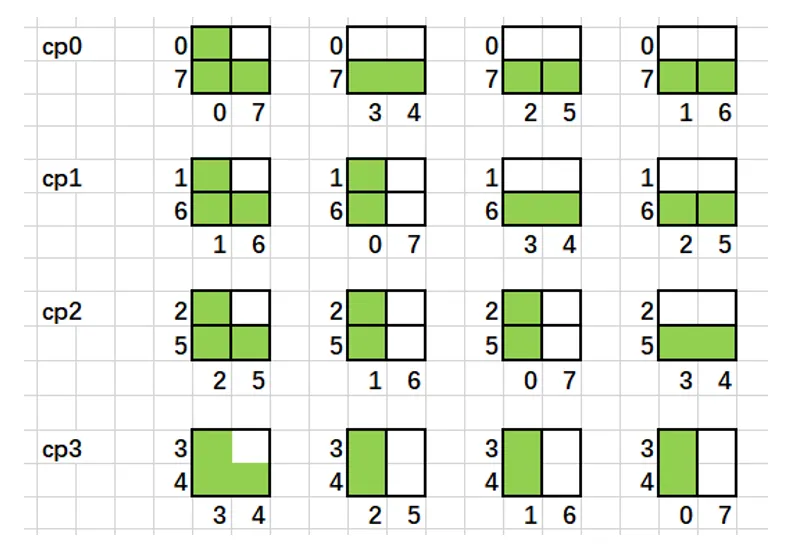
然而,Ring Attention方案针对负载不均衡问题对序列划分进行了调整,在该切分方式下,q、k、v是并不连续的(如图2中cp0的0,7块),无法直接通过内核分片方式生成小块掩码。
在这里插入图片描述

图2: Ring Attention负载均衡场景支持ALiBi编码压缩计算流程图

为了保持原有负载均衡逻辑,同时不传入完整ALiBi 偏置矩阵降低内存开销,MindSpeed采取了将不连续的块再次拆分的策略,见图2。具体来说,如果当前分块满足连续条件(例如cp3的所有块),或者对于每一行的内部连续(如cp0第2块第2行),则可以直接使用内核生成策略;否则进行进一步拆分,直到满足连续条件,再使用内核生成策略进行生成。如图所示,每一个黑色框内的部分单独计算(白色被掩码掉的部分不参与运算)。

在使用ALiBI位置编码的场景下,相比未做上述优化,完全节省掩码矩阵的内存开销,即图片。
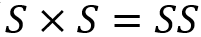
Reset Attention Mask压缩

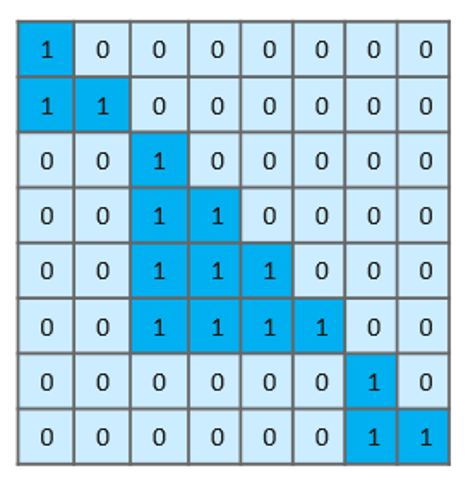
为了缓解长序列训练场景同一序列内文档数量过多,文档间互相干扰的问题,Llama 3.1在预训练过程中使用了Reset Attention Mask。根据Llama 3.1技术报告显示,使用Reset Attention Mask在长序列训练中十分重要[6]。Reset Attention Mask在每个文档的末尾重置注意力,仅保留文档内部的注意力。图3给出了一个例子,文档1的长度为2,文档2的长度为4,文档3的长度为2,所有跨文档的注意力分数均会被掩盖(图3中0表示掩盖)。
图片

图3: Reset Attention Mask示意图

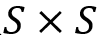
在该场景下,Ring Attenton的切分会导致部分计算步骤的掩码不规则,无法利用FA的稀疏模式和掩码压缩。MindSpeed通过保留每个Token所属的文档ID,在每个Ring Attention步骤分片计算出当前步骤的分片掩码,无需保留完整掩码。在使用Reset Attention Mask场景下,该优化将注意力掩码的内存开销从图片 降低到图片,其中P为上下文并行的维度。
通信优化–P2P分流并发

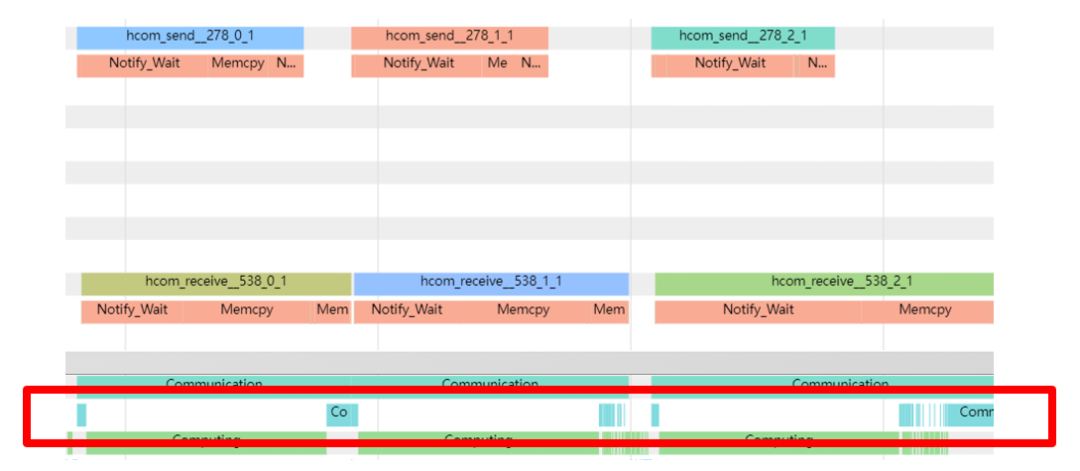
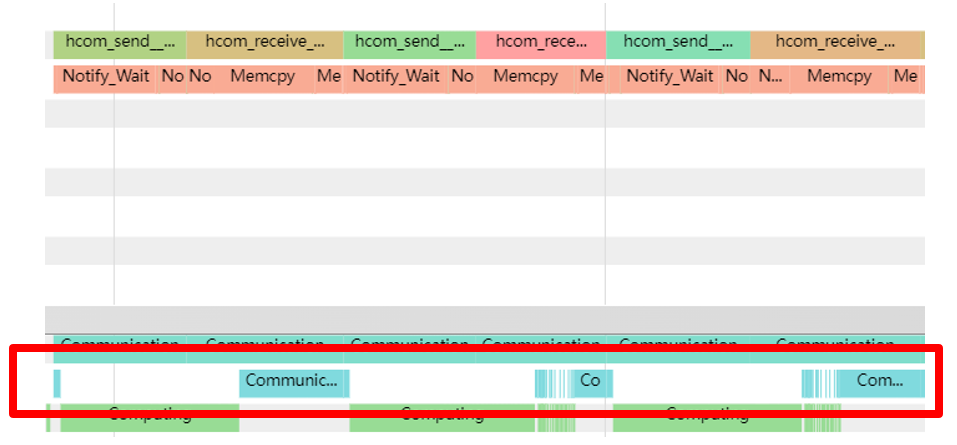
MindSpeed采用了send/recv分流并发的思想优化了Ring Attention中的P2P通信,充分利用设备间的通信带宽,减少未被计算掩盖的通信时长,提升整体训练效率。图4, 5中红框部分为未掩盖通信部分。
图片

图4: 未优化前通信算子执行流图

图片

图5: 优化后通信算子执行流图

MindSpeed简介

MindSpeed是昇腾AI面向大模型分布式训练提供的加速套件,提供丰富的大模型分布式加速算法、支持开源分布式框架平滑接入、支持算法二次开发,使能昇腾分布式加速技术快速应用。

欢迎加入和体验:https://gitee.com/ascend/MindSpeed

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

MindSpeed-LLM模型部署案例:DeepSeek-R1-Distill-Qwen-1.5B微调 添加图片注释,不超过 140 字(可选)DeepSeek-R1-Distill-Qwen-1.5B:模型文件,包括权重、词表、配置文件等MindSpeed-LLM:实操目录mstt:性能调优工具。 阅读详情

相关推荐

【信息科学与工程学】计算机科学与自动化——第一百五十九篇 并行计算开发设计01

编号编程语言(含版本)+开发框架应用场景机制+用法+详细设计+详细配置编译器(版本+内核+底层机制+优化方法+阶段)底层实现·说明·缺陷+优势的·解决方案及数学建模引入版本国产化/信创/商用CPU/GPU/DPU芯片适配及指令集列表和指令调用和时序图关联知识&标准1高性能科学计算、深度学习训练与推理、图像处理、物理模拟、金融风险分析SIMT模型,kernel函数并行执行海量线程。用法:定义__global__

weixin_49199313的博客 247

一文了解一下 MindSpeed,MindSpeed 是专为华为昇腾设备设计的大模型分布式加速套件。

一文了解一下 MindSpeed,MindSpeed 是专为华为昇腾设备设计的大模型分布式加速套件。

叶庭云 成为自己的光 2709

Python海康相机api---超简单入坑学习必看

海康官网下载相机驱动​安装好以后找到Python的开发文件目录参考:D:\MVS\MVS\Development\Samples\Python\MvImport这几个文件很重要,想调用海康相机取图会用到.​为了写代码方便可以把这几个文件拷贝一下,跟你的api主文件放在同一个文件夹下可以减少80%的烦恼.​。

weixin_59360687的博客 3478

大规模分布式 AI 模型训练系列——专家并行

在 [1701.06538] Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer 中,作者(也包括大名鼎鼎的 Geoffrey Hinton 和 Jeff Dean)将 MoE 引入到 LSTM 模型中,并提出了稀疏 MoE(Sparse MoE)的概念。在 Sparse MoE 中可以包含数千个前馈子网络,并由可训练的门控网络(Gating Network)确定这些专家的稀疏组合。

xx_nm98的博客 1万+

Oracle数据库的内存管理优化技巧

Oracle数据库作为企业级数据库管理系统,广泛应用于各种业务场景。内存管理是Oracle数据库性能优化的关键环节,合理的内存管理可以显著提高数据库的响应速度和吞吐量。本文的目的是深入探讨Oracle数据库内存管理的优化技巧,涵盖了系统全局区(SGA)和程序全局区(PGA)的管理、内存分配算法、内存参数调整等方面。通过详细的讲解和实际案例分析,帮助读者掌握优化Oracle数据库内存使用的方法,提高数据库的性能和稳定性。

2502_91592937的博客 996

Stable-Baselines3性能优化:多环境训练对比指南(DummyVecEnv vs SubprocVecEnv)

本文深入对比了Stable-Baselines3中DummyVecEnv与SubprocVecEnv两种向量化环境的性能差异与应用场景。DummyVecEnv适用于轻量级、步进快的环境,调试友好且开销低;而SubprocVecEnv则通过真正的多进程并行,能显著加速计算密集型环境的训练。文章通过基准测试与决策树,指导开发者根据环境计算成本、CPU核心数等关键因素做出最优选择,以实现训练效率最大化。

weixin_29063979的博客 147

专家并行再升级,开源MoE模型训练效率提升9倍

Colossal-AI-MoE模块升级,系统完善,效率提升,性能卓越!

luchentech的博客 2704

Oracle EBS(R12+)通过Multi-Org 多组织架构、Multi-Ledger 多账簿、SLA 子分类账会计、多币种引擎、多会计政策并行五大核心能力,为跨国企业提供一体化、自动化、合规的

Oracle EBS(R12+)提供全球会计核算解决方案,通过Multi-Org多组织架构实现跨国集团数据隔离与共享,支持四层组织结构(业务组→法律实体→经营单位→库存组织)。Multi-Ledger多账簿功能允许一笔业务多准则自动核算,包含主账簿、辅助账簿和报告币种。系统内置多币种处理引擎,覆盖全流程货币业务,支持自动重估、再计量和折算。通过SLA子分类账会计实现多会计政策并行处理,满足不同国家会计准则和税制要求。该方案可同时支持本地法定、集团合并及管理分析需求,实现全球财务数据集中管理,提升合规性和运营

金牌架构师 553

百万级超长序列大模型训练如何加速,硬核解读MindSpeed方案

摘要:针对现有长序列训练场景的痛点,MindSpeed在并行算法、计算效率、内存占用以及通信四个维度系统性优化大模型长序列训练效率,支持大模型百万级长序列训练。长序列已经成为主流大模型能力之一23年底Gemini1.5 Pro发布以来,大模型序列长度迅速增长,处理超长序列上下文(Context)已经成为了目前主流闭源和开源...

weixin_36896087的博客 198

1.07---共识机制详解(PoW、PoS、DPoS 对比)

【摘要】区块链能成为“无需信任的协作网络”,靠的正是它的“共识机制”。本节将深入剖析 PoW、PoS、DPoS 等核心共识模型,并结合以太坊从 PoW 到 PoS 的转型与 Solana 等新型方案,为你拆解这一决定区块链运行方式、性能、安全性的“发动机系统”。什么是共识机制?为何不是多数投票这么简单?三大主流共识算法(PoW、PoS、DPoS)机制对比与演化路线以太坊从 PoW 到 PoS 的转型细节(The Merge)Solana 的 PoH + PoS 混合共识机制解析。

鄙人kunzhi96,感恩遇见! 1万+

OTFS 消息传递算法信号检测【附matlab代码详解】

OTFS 消息传递算法方面的一些浅浅理解。

Cuby的博客 4011

彻底搞懂GraphQL网络中间件:apollo-link核心概念完全解析

**Apollo Link(apollo-link)是专为 GraphQL 设计的网络中间件**,用一条可组合的"Link 链"控制每次 GraphQL 请求的完整生命周期:拦截、修改、重试、批量、轮询……最终由数据源(HTTP、WebSocket 或本地 Schema)以 Observable 形式回传结果。如果你正在使用 Apollo Client,本文带你看懂 Link、Operation、

gitblog_00417的博客 273

故障诊断 | CNN-BiGRU-Attention故障诊断

故障诊断 | CNN-BiGRU-Attention故障诊断

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 674

揭秘大语言模型训练加速利器MindSpeed-LLM,让效率飙升

MindSpee-LLM是昇腾AI面向大模型分布式训练提供的语言大模型套件,仓库涵盖了模型、算法以及各类开发工具链,支持开箱即用及灵活组装开发。仓库配备了详细的使用指南和示例代码,欢迎加入和体验:​。

python12222_的博客 2466

学习QT之应用程序打包发布

一、编译QT程序(release编译) 二、将release文件夹中的可执行文件复制到一个空的文件夹中 三、使用windeployqt打包工程 切换到可执行文件路径,执行windeployqt xxx.exe: 然后就会将程序所需要用到的资源以及库文件生成到可执行文件路径下: 此时应用程序就可以点击运行了。 四、使用Enigma Virtual Box封包(将文件夹内的文件集成为单可执...

贝勒里恩的博客 762

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

TP(张量并行)和EP(专家并行)的区别

张量并行适用于将模型的张量拆分到多个设备上,减少单个设备的内存负担,并加速计算。适用于大多数深度学习模型。专家并行适用于混合专家模型,通过将不同的专家分配到不同的设备上,增加模型的容量和计算效率。特别适用于大规模的稀疏模型。选择哪种并行化技术取决于具体的模型结构和应用场景。对于传统的深度学习模型,张量并行可能更合适;而对于混合专家模型,专家并行则更为有效。

weixin_41012399的博客 2509

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

DeepSpeed Ulysses: 训练极长序列Transformer模型的系统优化

微软DeepSpeed组官方中文博客(翻译自官方英文博客:DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models)。转载自微软DeepSpeed组官方知乎账号:zhihu.com/people/deepspeed。从生成性AI到科研模型,长序列...

开源社KAIYUANSHE的博客 1901

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

megatron——EP并行

专家并行是指在混合专家模型(Mixture of Experts, MoE)中,将不同的专家(即子模型)分配到不同的设备上,每个设备只负责一部分专家的计算。这样可以有效利用设备资源,提高模型的容量和效率。

hang on it more longer 2183

用通俗易懂的方式讲解大模型分布式训练并行技术:概述

本文针对大模型进行分布式训练常见的并行技术进行了简要的介绍。后续章节将针对常见并行技术的不同方案进行详细的讲解。

2301_78285120的博客 2282

华为MindSpeed 训练加速库:架构解析

MindSpeed 作为昇腾生态的 “大模型训练加速中枢”,通过 **“硬件深度协同 + 开源生态兼容 + 场景化极致优化。

Peter_Changyb的博客 2346

专家并行(EP)含义、原理及不同框架切分策略

专家并行(EP)是MoE模型专属并行策略,核心是拆分专家集合到多卡,通过Token路由+跨卡通信完成计算,解决单卡显存不足问题;核心原理分为“专家静态拆分→Token路由通信→本地专家计算→结果聚合→梯度同步”五个步骤,依赖门控网络的Top-k选择机制;框架差异:Megatron静态粗粒度、TP强绑定,适合稳定超大模型;FSDP2动态灵活、兼容PyTorch,适合快速落地;DeepSpeed极致优化、ZeRO耦合,适合超大模型极致性能。

cpz454446202的博客 1291

绅聚科技国产VoIP芯片已能完美替代Mindspeed(敏讯)

近20年来,Mindspeed(敏讯 ) 利用多年来在模拟信号和混合信号处理方面的技术积累,针对VoIP业务推出了多个产品系列,Comcerto 300 、Comcerto 300v2、Comcerto 500 等。这些产品都闪耀无比,几乎统治了整个VoIP行业。无数行业巨头包括华为、中兴都投入它的怀抱,曾经辉煌无比的Freescale、OCTA面对它都纷纷败下阵来。 但随着2014年MACOM收购Mindspeed(敏讯 ) ,MACOM自身已经连续多年亏损,再加上美国对中国的禁售政策,导致将原Min

SHENJU_TECH的博客 2541

【课程笔记】华为 HCIE-AI Solution Architect 人工智能07:MindSpeed领域加速库介绍

目录MindSpeed领域加速库介绍一、大模型分布式训练的趋势及挑战二、昇腾分布式加速库MindSpeed详解。

淵_ken的博客 785

Transformer——Q98 分析专家并行(Expert Parallelism)的通信开销模型

专家并行的通信开销模型,本质是分布式系统中 “分工” 与 “协作” 的精密平衡 —— 通过将专家分散到不同设备,我们突破了单卡显存的限制,但也引入了数据跨设备流动的挑战。高效的通信优化需要深入理解硬件特性、模型行为和算法设计的交互作用。当我们在代码中实现专家并行时,每一次scatter和gather操作都是一次对分布式系统的 “微调”。

墨顿随笔 1678

基于mindspeed微调deepseek系列大模型

MindSpeed-LLM是基于昇腾生态的大语言模型分布式训练框架,旨在为华为昇腾芯片生态合作伙伴提供端到端的大语言模型训练方案,包含分布式预训练、分布式指令微调、分布式偏好对齐以及对应的开发工具链,如:数据预处理、权重转换、在线推理、基线评估。它是昇腾自研的,对应于deepspeed。

AI 1616
上一篇: 【NLP】大模型长文本处理技术与GLM-4-Plus评测
下一篇: 2万字长文,如何成为一个“懂”AI 的产品经理?
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值