揭秘大语言模型训练加速利器MindSpeed-LLM,让效率飙升

MindSpeed-LLM模型部署案例:DeepSeek-R1-Distill-Qwen-1.5B微调 添加图片注释,不超过 140 字(可选)DeepSeek-R1-Distill-Qwen-1.5B:模型文件,包括权重、词表、配置文件等MindSpeed-LLM:实操目录mstt:性能调优工具。 阅读详情
AI摘要

大型语言模型训练面临诸多挑战,昇腾AI打造MindSpeed-LLM加速套件。它集成模型、算法与工具链,支持70+预训练模型,结合Transformer与MoE架构,实现全流程训练加速,提供一站式开发工具链。此外,还分享了AI大模型学习资料与商业化落地方案。

随着大型语言模型(LLM)规模的持续扩大,其训练时间与计算资源需求急剧增加,给开发者带来了包括模型架构设计复杂、数据处理与预处理繁琐,以及梯度消失、梯度爆炸和过拟合等技术难题在内的重大挑战。此外,开发者还常面临计算资源利用不充分、模型调优复杂、训练过程难以复现及与最新研究成果同步困难等问题。因此,开发者迫切需要一套专为大型语言模型加速设计的综合工具套件,以简化训练流程,提高资源利用率。
undefined

在此背景下,昇腾AI打造面向大语言模型分布式训练的加速套件MindSpeed-LLM,集成了模型、算法以及各类开发工具链,致力于为开发者提供高效的训练算法与加速技术,以及多样化的高性能大模型解决方案,让开发更简单。

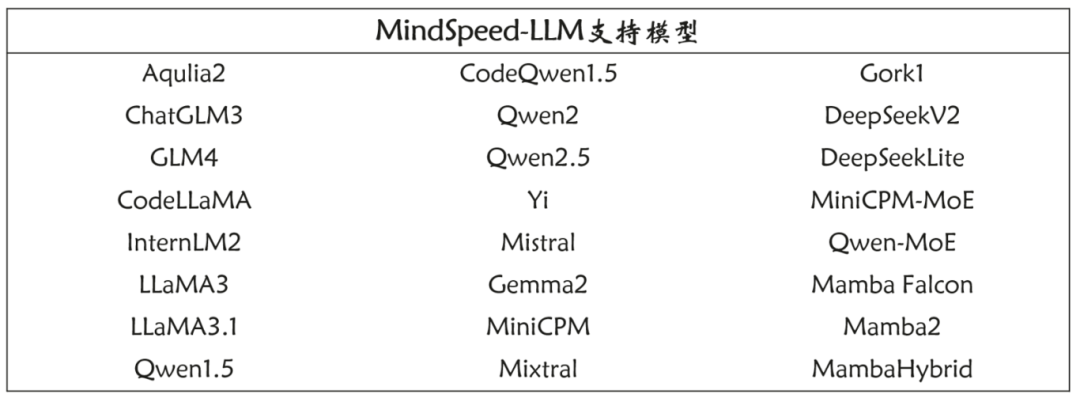
70+预训练模型开箱即用

支持24个系列70+大模型,驱动多场景智能创新
undefined

表1 MindSpeed-LLM支持的模型

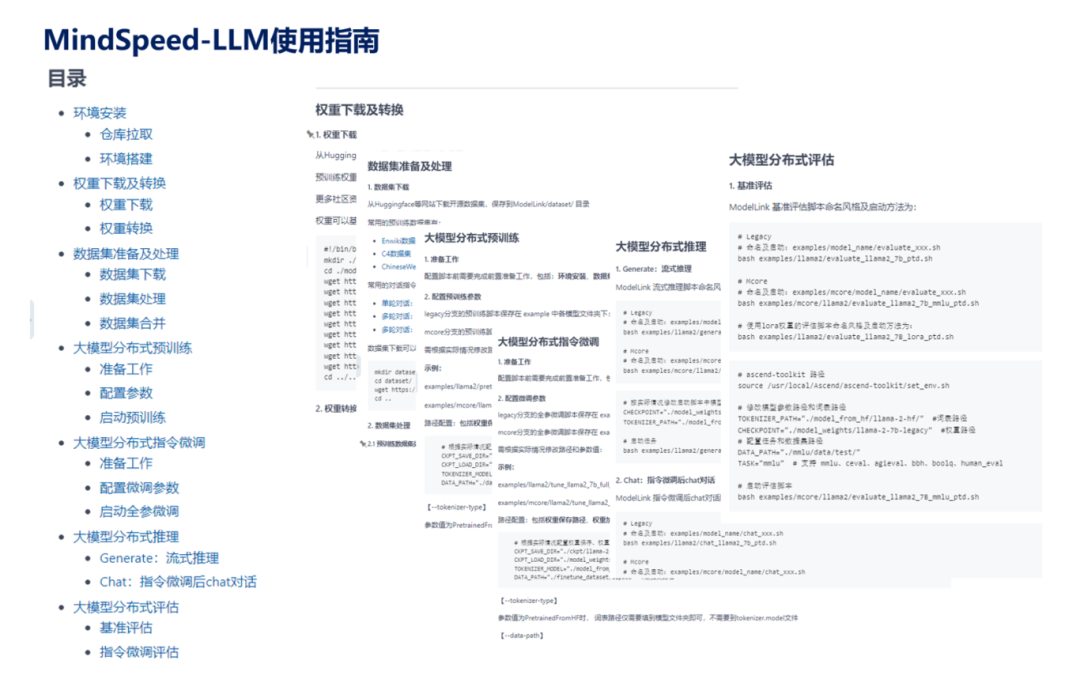
仓库提供完备的启动脚本和流程说明,使用户能够在不需深入理解底层实现的情况下,快速启动并运行模型。通过简洁直观的操作流程,用户只需下载模型并运行预配置的启动脚本,即可立即开始训练或推理。不仅如此,仓库还配备了详细的文档与示例代码,帮助开发者全面理解模型使用方法与最佳实践。我们希望通过积极的互动为用户提供全面的支持和合作机会。
undefined

图1 MindSpeed-LLM配备的使用指南

支持Transformer稠密模型与MoE (Mixture of Experts) 架构的有效结合,助力大模型突破性能瓶颈

随着模型规模的不断扩展,传统的稠密Transformer架构面临着计算资源与模型性能之间的瓶颈。与传统稠密Transformer相比,MoE能够有效提高计算资源的利用效率,使得模型在相同或更低资源投入下,依然保持出色的推理能力和响应速度。更重要的是,这种结合不仅简化了复杂模型的开发与训练流程,还使得大模型的可扩展性更具弹性,能够根据任务需求智能调整计算开销。通过这一技术融合,Transformer模型不再局限于以往的性能瓶颈,而是能够在更大规模、更复杂场景中持续保持卓越的表现。对于开发者而言,此架构不仅显著提升了性能,还极大减轻了计算资源与成本的负担,有效促进了大型模型在多样化应用场景中的商业化部署。

全流程LLM训练加速

仓库提供了LLM大模型完整的训练解决方案,涵盖Pretrain阶段的加速开发以及Posttrain阶段的指令微调与偏好对齐,实现模型全流程性能优化。

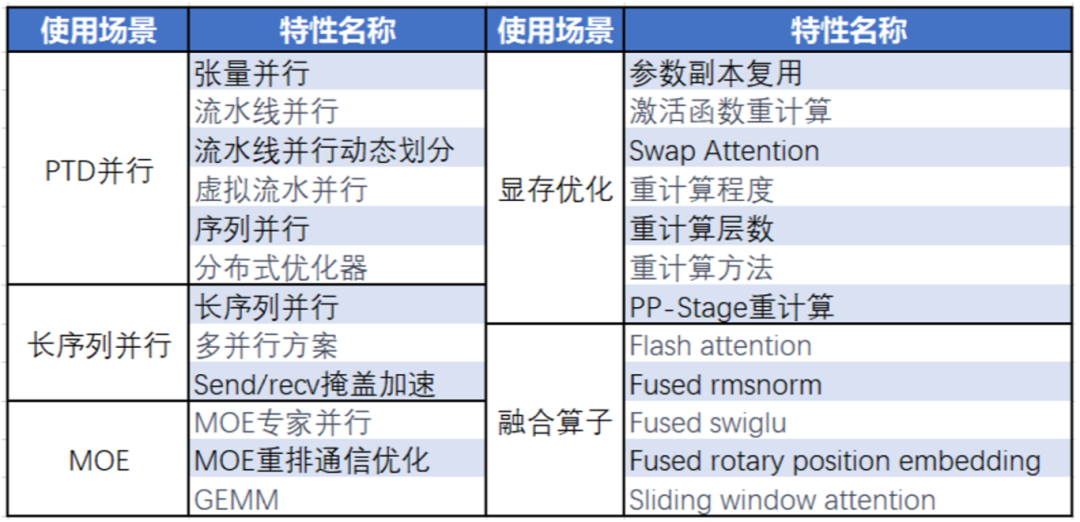
Pretrain阶段:支持多种并行加速和显存优化算法

在Pretrain阶段,系统集成了多种高效的分布式训练算法,支持张量并行和流水线并行等先进技术。这些并行化方法在处理大规模数据集和模型参数时,能够最大化计算资源的利用率,显著缩短训练时间。同时,融合算子技术进一步优化了计算效率,减少了冗余操作。此外,重计算技术的引入也极大地增强了显存优化能力。通过在反向传播过程中重新计算部分中间激活,而不是在前向传播时保存所有中间结果,有效减少了显存占用。因此,重计算与并行加速策略相结合,使得系统在大规模训练中能够达到更高的效率和更低的资源消耗。
undefined

表2 MindSpeed-LLM支持的训练加速技术和优化方法

Posttrain阶段:指令微调与偏好对齐实现任务定制化
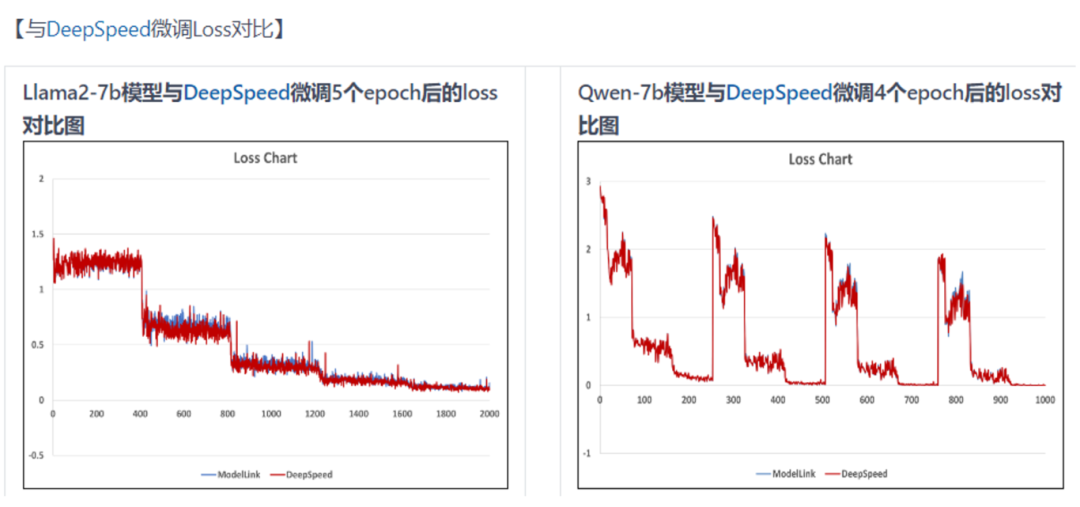
undefined

图2 MindSpeed-LLM与DeepSpeed微调Loss对比

Posttrain阶段的重点在于通过指令微调和偏好对齐技术,对大模型进行定制化优化。指令微调让模型能够在特定任务和场景中表现出更高的执行效率,确保其对用户输入的理解更加精准。而偏好对齐则通过学习用户的行为模式,使得模型输出更符合个性化需求。
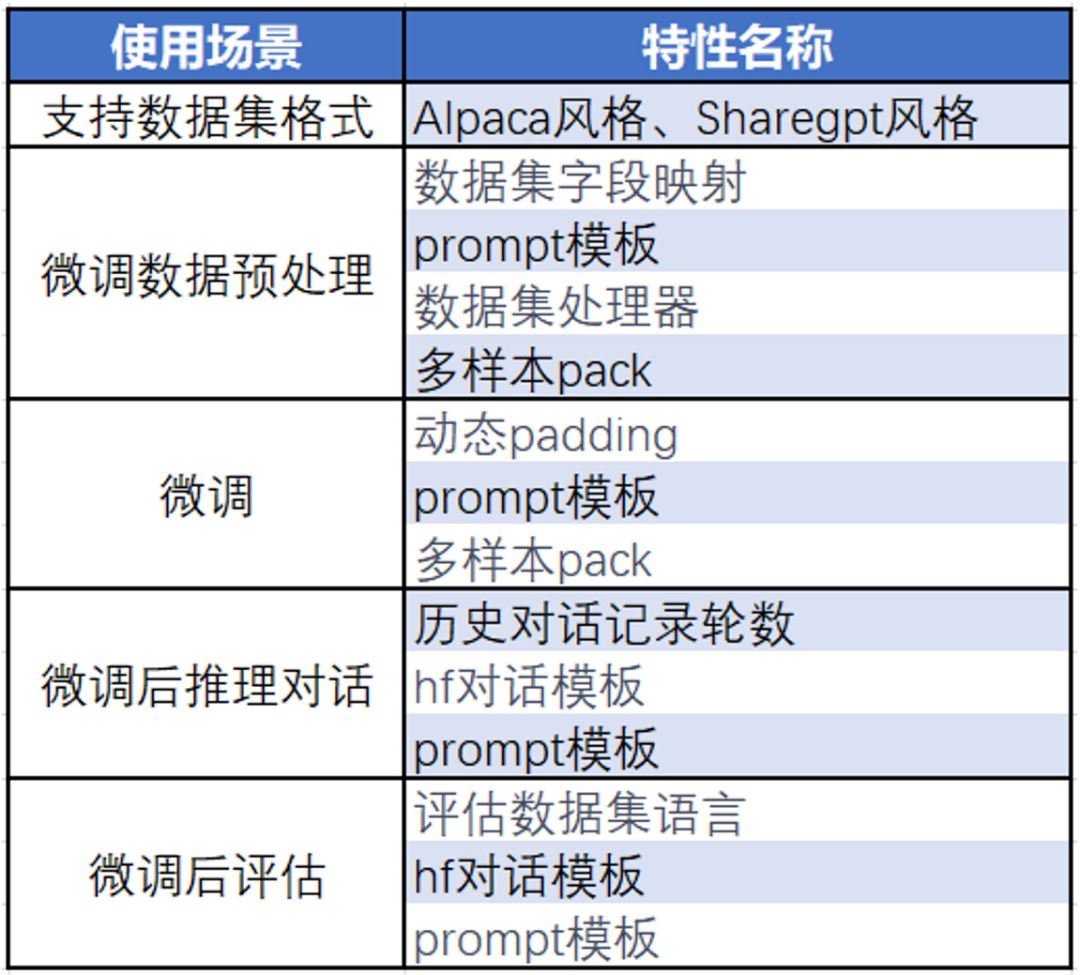
undefined

表3 MindSpeed-LLM已支持的微调特性

即将上线的特性:

即将发布的LoRA、DPO、奖励模型、PPO等前沿特性,将进一步增强模型能力和灵活性。通过这些新特性,用户能够更好地进行模型优化和适配,满足多样化的应用需求,从而在人工智能领域取得更大的成功。

一站式LLM开发工具链

一站式LLM开发工具链支持大模型的数据处理、权重转换、推理评估及Profiling数据采集,并提供高可用性保障,帮助开发者更高效地管理与优化大模型。

权重转换

支持Hugging Face与MindSpeed-LLM之间的权重转换,确保用户能够方便地迁移和复用现有模型。通过简化转换流程,用户可迅速将模型适应不同的训练环境,从而提高开发效率。这一功能降低了在不同框架间操作的复杂性,使开发者能更专注于模型的优化和应用。

数据集处理

提供全面的数据集处理解决方案,涵盖预训练数据集和指令微调数据集的构建与处理。不仅支持多种数据格式,还能高效地进行数据清洗与预处理,确保数据质量。同时,用户能够利用丰富的示例和模板,快速创建符合特定需求的数据集,从而提升模型训练效果和适应性。

分布式推理

提供流式推理和人机对话的分布式推理能力,确保在实际应用中高效、快速地进行推理。这种灵活性使得系统能够实时响应用户请求,提升用户交互体验。

分布式评估

评估工具支持多种标准,包括MMLU、CEVAL、HumanEval、BBH、BoolQ和AGIEval,确保模型在不同维度上的性能表现。不仅可以帮助用户量化模型的能力,还能针对性地揭示模型的弱点和改进空间。通过系统的评估,用户能够更科学地选择和优化适合自身需求的模型。

MindStudio调试调优工具

配备MindStudio调试调优工具,支持Profiling采集、确定性计算和高可用性功能。该工具为模型开发和部署提供了强有力的保障,确保用户在使用过程中能够获得详尽的性能分析和优化建议。

MindSpeed-LLM简介

MindSpee-LLM是昇腾AI面向大模型分布式训练提供的语言大模型套件,仓库涵盖了模型、算法以及各类开发工具链,支持开箱即用及灵活组装开发。仓库配备了详细的使用指南和示例代码,欢迎加入和体验:

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

基于昇腾MindSpeed-LLM的大模型训练&推理 本文详细介绍了在昇腾(Ascend)NPU平台上搭建大模型训练环境的关键步骤。主要内容包括:1)NPU驱动、CANN异构计算架构和PyTorch插件的安装配置;2)基于PyTorch后端的Qwen2.5-0.5B模型LoRA微调流程,涵盖数据预处理、权重转换和训练参数设置;3)自定义训练镜像的制作方法。特别强调了版本匹配、环境变量配置、批量大小计算规则等核心注意事项,为昇腾平台上的大模型训练提供了完整的实践指南。 阅读详情

相关推荐

MindSpeed-LLM-ai

LLM ai ai ai ai ai

一文了解一下 MindSpeed,MindSpeed 是专为华为昇腾设备设计的大模型分布式加速套件。

一文了解一下 MindSpeed,MindSpeed 是专为华为昇腾设备设计的大模型分布式加速套件。

叶庭云 成为自己的光 2709

MindSpeed-LLM-人工智能资源

LLM

RAG与MCP技术对比分析:深入探讨两者差异与优势!

通过增强生成结果的准确性和专业性通过协调 LLM 与外部工具/数据源的交互,支持复杂操作流程检索模块(如向量数据库)获取外部信息 → 生成模块(LLM)融合检索结果生成内容 [1] [9]定义标准协议规范 LLM 的输入输出上下文,实现多工具调用、动态数据路由和状态管理 [13] [21]依赖外部结构化/非结构化知识库(如文档、数据库)依赖预定义的工具集(API、函数)及上下文路由规则医疗问答(检索最新论文+患者病历生成诊断建议)[15] [34]

2401_84204207的博客 2205

MindSpeed-LLM作为昇腾大模型训练框架,旨在为华为 昇腾芯片 提供端到端的大语言模型训练方案,

MindSpeed-LLM作为昇腾大模型训练框架,旨在为华为 昇腾芯片 提供端到端的大语言模型训练方案, 包含分布式预训练、分布式指令微调、分布式偏好对齐以及对应的开发工具链。

深度强化学习中的动作屏蔽(Action Masking)

在复杂环境中使用动作屏蔽,实现更好的训练效果

Kiek17的博客 5877

基于mindspeed微调deepseek系列大模型

MindSpeed-LLM是基于昇腾生态的大语言模型分布式训练框架,旨在为华为昇腾芯片生态合作伙伴提供端到端的大语言模型训练方案,包含分布式预训练、分布式指令微调、分布式偏好对齐以及对应的开发工具链,如:数据预处理、权重转换、在线推理、基线评估。它是昇腾自研的,对应于deepspeed。

AI 1616

低电压高效率能源管理芯片BQ25570的基本用法及应用电路实例

BQ25570是一款低电压、高效率、集成了可编程功率追踪(MPPT)功能、BOOST升压功能和BUCK降压功能的综合型能源管理电路。冷启动工作电压为330mV,热启动工作电压为100mV。主要应用于温差发电片TEG、压电、摩擦发电和太阳能板的能量收集,也可以用于人体可穿戴自取能传感设备的能量管理。本文主要介绍了BQ25570相关参数计算、MPPT功能验证、工作逻辑和应用场景,并设计了一版测试电路,给出了不同应用需求的电路配置建议。

weixin_49213602的博客 3455

大模型中的post-traing是什么?为什么国内厂家都转向post-traing?

通过Post-training,可以针对特定场景进行模型优化,提供更精准、更具价值的服务,增强模型的市场竞争力。看看零一万物的研发投入与收入,以及国内大模型厂家的冰与火的处境,大模型的投入大且周期长。预训练模型虽然博学,但可能不够“专精”。与直接针对特定任务进行微调不同,Post-training旨在提升模型能力的同时,尽可能保留其在通用任务上的性能,实现“一专多能”。,进一步提升模型的能力。相比于微调,Post-training可以利用更大规模的数据,更充分地挖掘数据中的信息,进一步提升模型性能。

simoncool23的博客 1907

Flotherm XT新手必看:5分钟搞定自然对流热仿真(附案例文件)

本文为Flotherm XT新手提供了自然对流热仿真的快速入门指南,通过详细的步骤解析和实用技巧,帮助用户在5分钟内完成从建模到后处理的全流程。重点介绍了环境设置、几何建模、材料属性、网格划分等关键环节,并附有案例文件供参考学习,助力工程师快速掌握热仿真技术。

weixin_30839881的博客 622

瑞芯微rv1126 rtsp+mpp+rga取流

瑞芯微rv1109 rtsp+mpp+rga取流

ZuoSeDiao的博客 6339

百万级超长序列大模型训练如何加速,硬核解读MindSpeed方案

针对现有长序列训练场景的痛点,MindSpeed在并行算法、计算效率、内存占用以及通信四个维度系统性优化大模型长序列训练效率,支持大模型百万级长序列训练。

华为云官方博客 2537

基于STM32L4XX、HAL库的MP2672GD-0000-Z充电芯片驱动程序设计

CHG_STAT_GPIO_Port, CHG_STAT_Pin, // 这些宏应由 CubeMX 生成在 main.h。

zhusl6688的博客 497

LLM Post-Train(后训练)技术全解析:一篇吃透核心要点

在人工智能的快速发展进程中,大语言模型(LLM)已成为瞩目的焦点。当 ChatGPT 横空出世,其展现出的强大能力让世人惊叹,而这背后离不开大语言模型的两个关键训练阶段:预训练(Pretraining)和后训练(Post-training)。

2301_76168381的博客 2159

11 指挥AI写C语言/嵌入式基础代码,适配硬件与底层逻辑

本文为《30天掌控AI编程:从指令到落地,手把手教你指挥AI写代码》系列第十一篇,正式进入第三阶段多场景实战环节。聚焦**C语言/嵌入式基础代码**生成,结合嵌入式开发的核心需求,讲解如何精准编写指令,指挥AI生成适配硬件、贴合底层逻辑的C语言代码,覆盖嵌入式常用底层功能、硬件适配要点、代码规范,搭配完整指令模板、AI输出示例与实操校验方法,零基础也能快速指挥AI完成嵌入式基础开发,无需死记硬背C语言底层语法。

coreopt的博客 140

企业AI数据资产评估的自动化工具:AI应用架构师的使用指南

在AI驱动的企业数字化转型中,数据资产是支撑模型训练、业务决策的核心燃料。然而,80%的AI项目失败源于数据问题——低质量数据导致模型偏差、未评估的风险引发合规危机、价值不明确的数据浪费资源。手动数据资产评估效率低、易出错,无法满足规模化AI应用需求。本文将以AI应用架构师的视角,拆解企业数据资产评估的核心逻辑,用"餐厅选食材"的生活化比喻解释复杂概念,结合自动化工具的技术原理与实战案例,教你如何从0到1搭建数据资产评估体系。无论是数据质量检测、价值量化还是风险防控,你都能找到可落地的工具方案与实践步骤。

2502_91592937的博客 1629

华为MindSpeed 训练加速库:架构解析

MindSpeed 作为昇腾生态的 “大模型训练加速中枢”,通过 **“硬件深度协同 + 开源生态兼容 + 场景化极致优化。

Peter_Changyb的博客 2346

GameFramework专栏目录

本专栏是专门介绍GameFramework框架的,持续更新中,如有疑问可留言,24小时内回复。

TxNet 4727

绅聚科技国产VoIP芯片已能完美替代Mindspeed(敏讯)

近20年来,Mindspeed(敏讯 ) 利用多年来在模拟信号和混合信号处理方面的技术积累,针对VoIP业务推出了多个产品系列,Comcerto 300 、Comcerto 300v2、Comcerto 500 等。这些产品都闪耀无比,几乎统治了整个VoIP行业。无数行业巨头包括华为、中兴都投入它的怀抱,曾经辉煌无比的Freescale、OCTA面对它都纷纷败下阵来。 但随着2014年MACOM收购Mindspeed(敏讯 ) ,MACOM自身已经连续多年亏损,再加上美国对中国的禁售政策,导致将原Min

SHENJU_TECH的博客 2541

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

基于 MindSpeed-LLM 框架的大模型训练全流程经验分享

MindSpeed-LLM是昇腾生态下专为大语言模型设计的高效训练框架,支持主流模型的分布式预训练和微调。本文详细介绍了从环境搭建到模型微调的全流程实践,包括模型权重转换、数据预处理、并行策略配置等关键步骤,并分享了内存优化和计算加速等实用技巧。该框架通过创新的内存管理和混合并行技术,显著提升训练效率,是国产硬件上部署大模型的理想选择。

Kenji_Shinji的博客 1941

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

【AI学习】简单聊聊后训练(Post-Training)的重要性

模型生成的输出质量比网上的大多数内容都要高。因此,让模型自己思考似乎更有道理,而不仅仅是训练来模仿网络上的内容。所以,我认为从第一性原理上来说,这是有说服力的。我会说,我们通过后训练取得了很多进步。

bylander的博客 8317

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Post-Training有多重要?一文带你了解全部细节

本文主要介绍了llama3.1,Nemotron4-340B及gemma2三个模型在post-training阶段的一些工作。主要涉及数据搜集,合成数据,SFT及DPO等。

yiyele的博客 5910

【课程笔记】华为 HCIE-AI Solution Architect 人工智能07:MindSpeed领域加速库介绍

目录MindSpeed领域加速库介绍一、大模型分布式训练的趋势及挑战二、昇腾分布式加速库MindSpeed详解。

淵_ken的博客 785

MindSpeed-LLM关键参数关系说明

worldsize = NNODES * NPUS_PER_NODE = DP * PP * TP * CP NNODES:服务器数量 NPUS_PER_NODE:每台服务器NPU卡数 MindSpeed-LLM没有配置数据并行DP的参数,是根据如下公式自动算出来的: DP = worldsize / (TP * PP * CP) 注意:TP、PP、CP需手动配置,CP如果不配置默认是1DP = (NNODES * NPUS_PER_NODE) / (TP * PP * CP) = 2DP = (NNODE

wy746801669wy的博客 799

MindSpeed LLM率先支持MiniMax M2.7训练复现,加速模型迭代完成复杂任务

2026年4月12日,MiniMax正式开源MiniMax M2.7模型,在真实软件工程、专业办公与多智能体协作场景中的出色表现,是其第一个自我深度迭代的模型。昇腾MindSpeed LLM率先在Atlas 900 A3 SuperPoD液冷超节点、Atlas 800 A3风冷超节点上实现MiniMax M2.7端到端训练复现,并依托全新FSDP2训练后端实现高效训练,为大模型自我进化范式在昇腾生态的落地奠定关键基础。直接运行MiniMax M2.7原生MoE前向计算易出现训练进程卡死问题,阻碍训练流程。

白天写代码,晚上追AI大模型,偶尔搞点八卦 开源动态|技术干货|实习机会|生态活动 我负责分享,你负责变强 550

昇腾MindSpeed特性开发指南

MindSpeed 是针对华为昇腾设备的大模型加速库。大模型训练是一种非常复杂的过程,涉及到许多技术和挑战,其中大模型训练需要大量的显存资源是一个难题,对计算卡提出了不小的挑战。为了在单个计算卡显存资源不足时,可以通过多张计算卡进行计算,业界出现了类似 Megatron、DeepSpeed 等第三方大模型加速库,对模型、输入数据等进行切分并分配到不同的计算卡上,最后再通过集合通信对结果进行汇总。

weixin_41374321的博客 1153
上一篇: 一书直接讲透自然语言处理《Getting Started with Google BERT_ Build and train》
下一篇: 深度学习 Transformer 的标签平滑(Label Smoothing)
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值