【NLP】大模型长文本处理技术与GLM-4-Plus评测

GLM-4-Plus大模型在代码生成与文档处理中的突破 自然语言处理(NLP)技术通过深度学习模型实现对人类语言的理解与生成,其核心原理是基于Transformer架构的自注意力机制。在工程实践中,大模型如GLM-4-Plus通过混合专家(MoE)架构显著提升了处理能力,特别在代码补全和技术文档处理等场景展现出巨大价值。测试数据显示,该模型在Python代码理解准确率达92.3%,技术文档处理效率提升4-6倍,为开发者提供了高效的智能辅助工具。这些突破性进展使得AI在编程教育、技术文档自动化等领域的应用成为可能,而GLM-4-Plus的128k上下文窗口和中文术 阅读详情

本文将介绍Transformer模型在处理长文本数据时所采用的关键技术,特别是旋转位置编码(RoPE)和Flash Attention机制。

此外,本文介绍GLM系列模型,特别是最新发布的GLM-4-Plus模型。我们将通过实际的评测方法和结果,展示GLM-4-Plus模型在处理长文本任务时的卓越性能。

unsetunsetTransformer模型unsetunset

Transformer模型的核心是自注意力机制(Self-Attention),它允许模型在处理序列数据时,能够同时考虑序列中的所有位置,这一点与传统的循环神经网络(RNN)或卷积神经网络(CNN)不同,后者通常需要逐步处理序列数据。

位置编码

Transformer模型由编码器(Encoder)和解码器(Decoder)组成,每个部分都包含多个相同的层,这些层由自注意力机制和全连接网络组成。此外,Transformer 还引入了位置编码来保留序列中的顺序信息,因为自注意力机制本身并不包含序列的顺序信息。
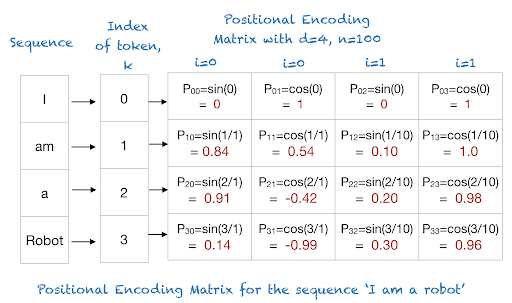
位置编码通常是通过正弦和余弦函数的固定函数形式来生成的,每个位置的编码是唯一的,并且编码的维度与模型的维度相匹配。

对于位置 pos 和维度 i,位置编码的第 i 维度的值由下面的公式给出:

  • 对于偶数维度(2i):

  • 对于奇数维度(2i+1):

其中 pos 是单词在句子中的位置,i 是维度索引, 是模型的维度。

并行能力

由于自注意力机制不依赖于序列中前一个状态的输出,这使得模型的所有层可以并行处理,从而大大提高了训练效率。Transformer还采用了残差连接和层归一化技术,这些技术有助于改善深层网络的训练稳定性,并减少梯度消失或爆炸的问题。
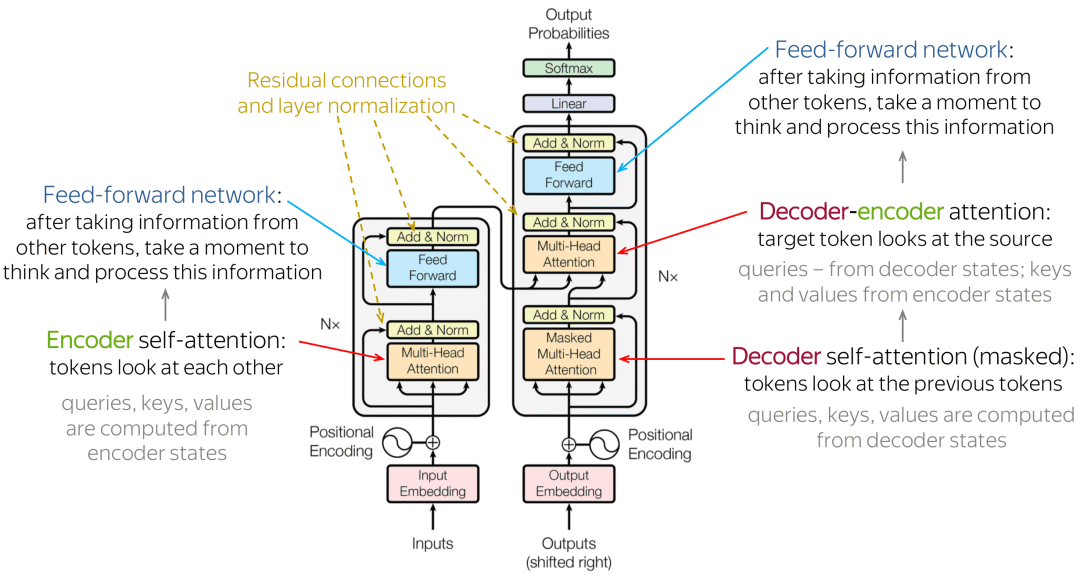
残差连接(Residual Connection)

对于Transformer中的每个子层(自注意力层或前馈全连接层)的输出,残差连接可以表示为:
在这里插入图片描述

自注意力机制

自注意力机制(Self-Attention)的核心思想是计算序列中每个元素(如单词或字)与其他所有元素的关系,以便捕捉序列内的长距离依赖关系。

在这里插入图片描述

计算查询(Query)、键(Key)和值(Value):对于输入序列中的每个元素,我们分别计算其查询、键和值的表示。这通常是通过与权重矩阵的矩阵乘法来实现的:

计算注意力得分:使用查询和键的点积来计算注意力得分,然后通常通过一个缩放因子(通常是键向量维度的平方根)来防止点积结果过大,接着应用softmax函数来获取注意力权重:

unsetunset大模型长文本处理技术unsetunset

如果把 LLM 比作新时代的操作系统,上下文窗口便是它的「内存」。一个优秀的 LLM 也需要足够长的上下文长度来完成各种复杂的任务。

RoPE

Transformer模型依赖于位置编码来理解单词顺序,但标准的编码方式通常只适用于固定长度的上下文。为了处理超出训练时见过的长度,旋转位置编码(RoPE)允许模型处理比训练时更长的输入,但这样可能会以性能损失。
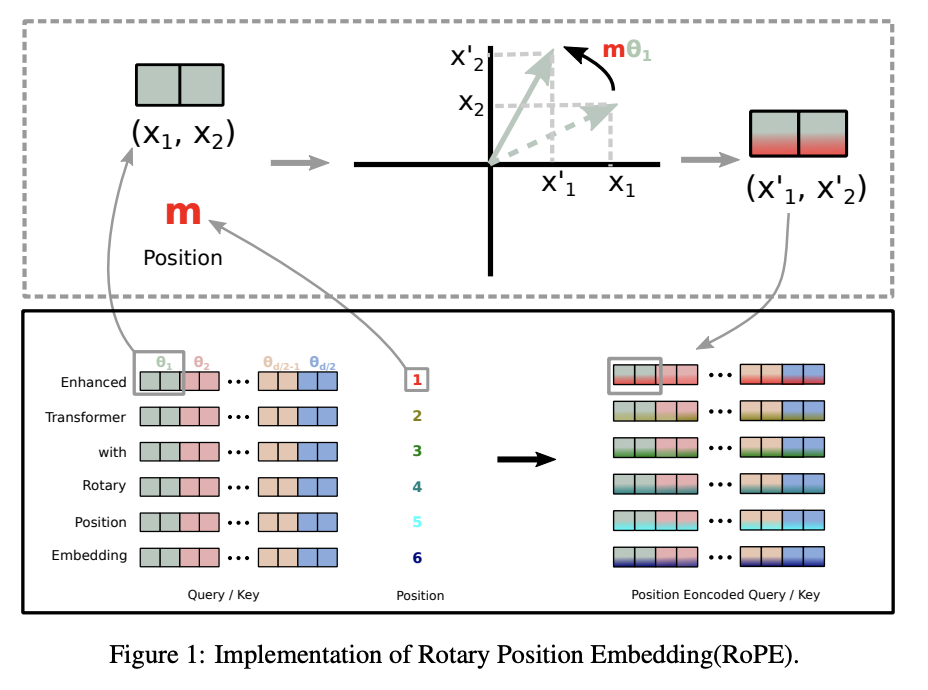
RoPE的核心思想是对词嵌入向量应用旋转变换,以注入位置信息。对于序列中的每个位置,RoPE通过旋转矩阵来调整词向量,旋转的角度与位置索引相关。这种旋转操作不仅保留了向量的模长(即词向量的大小不变),而且还能够引入相对位置信息。

在二维情况下,RoPE可以通过以下公式表达:

https://huggingface.co/THUDM/glm-4-9b/blob/main/modeling_chatglm.py

@torch.jit.script  
def apply_rotary_pos_emb(x: torch.Tensor, rope_cache: torch.Tensor) -> torch.Tensor:  
    # 获取输入张量 x 的各个维度大小  
    b, np, sq, hn = x.size(0), x.size(1), x.size(2), x.size(3)  
    # 计算旋转维度 rot_dim,它是 rope_cache 的倒数第二个维度的两倍  
    rot_dim = rope_cache.shape[-2] * 2  
      
    # 将 x 分为两部分:需要应用 RoPE 的维度和不需要变化的维度  
    x, x_pass = x[..., :rot_dim], x[..., rot_dim:]  
      
    # 根据序列长度 sq 截断 rope_cache,以确保它与当前处理的序列长度相匹配  
    rope_cache = rope_cache[:, :sq]  
      
    # 重塑 x 为 xshaped,以便将其与 rope_cache 进行运算  
    xshaped = x.reshape(b, np, sq, rot_dim // 2, 2)  
      
    # 重塑 rope_cache 以匹配 xshaped 的维度,并准备进行旋转运算  
    rope_cache = rope_cache.view(-1, 1, sq, xshaped.size(3), 2)  
      
    # 对 xshaped 中的每个元素应用旋转,使用复数的旋转公式  
    x_out2 = torch.stack(  
        [  
            xshaped[..., 0] * rope_cache[..., 0] - xshaped[..., 1] * rope_cache[..., 1],  # 实部旋转  
            xshaped[..., 1] * rope_cache[..., 0] + xshaped[..., 0] * rope_cache[..., 1],  # 虚部旋转  
        ],  
        -1,  
    )  
      
    # 将旋转后的张量 x_out2 重塑回原来的维度  
    x_out2 = x_out2.flatten(3)  
      
    # 将旋转后的张量 x_out2 与不需要变化的维度 x_pass 拼接起来,形成最终的输出  
    return torch.cat((x_out2, x_pass), dim=-1)  

FlashAttention

与传统的自注意力机制相比,Flash Attention将内存复杂度从O(N²)降低到O(N),这对于处理大规模数据集和大型模型尤为重要。

在这里插入图片描述

Flash Attention的算法包括两个主要思想:平铺和重新计算。在平铺过程中,注意力矩阵被划分为更小的块,以优化内存使用和计算效率。在重新计算过程中,利用存储的输出和softmax归一化统计数据来重新计算注意力矩阵,而无需存储大型中间矩阵。

https://huggingface.co/THUDM/glm-4-9b/blob/main/modeling_chatglm.py

unset

为了全面评估GLM系列模型在处理新闻文本分类任务上的能力,我们的评测方法采用了THUCNews数据集。

在评测过程中,我们将特别关注模型在处理不同长度文本时的表现。文本长度是影响模型性能的一个重要因素,因为它直接关系到模型处理信息的能力和复杂度。

unsetGLM 模型性能评测unsetunset

模型介绍

模型描述上下文
GLM-4-Plus高智能旗舰128K
GLM-4-0520高智能模型128K
GLM-4-Long Beta超长输入1M
GLM-4-AirX极速推理8K
GLM-4-Air高性价比128K
GLM-4-Flash免费调用128K

评测方法

通过THUCNews数据集,设置不同的文本长度,并通过大模型完成新闻分类:

def news_classify(news_path, texlen, model):  
    text = ''.join(open(news_path).readlines())[:texlen]  
    data = {  
        "model": model,  
        "messages": [{"role": "user", "content":  f'''请对下面的新闻进行分类,待选类别有: {class_names}\n {text}''' }]  
    }  
  
    try:  
        response = requests.post(url, headers=headers, json=data, timeout=200)  
        if news_path.split('/')[-2] in response.json()['choices'][0]['message']['content']:  
            return True  
        else:  
            return False  
    except:  
        return None  

评测结果
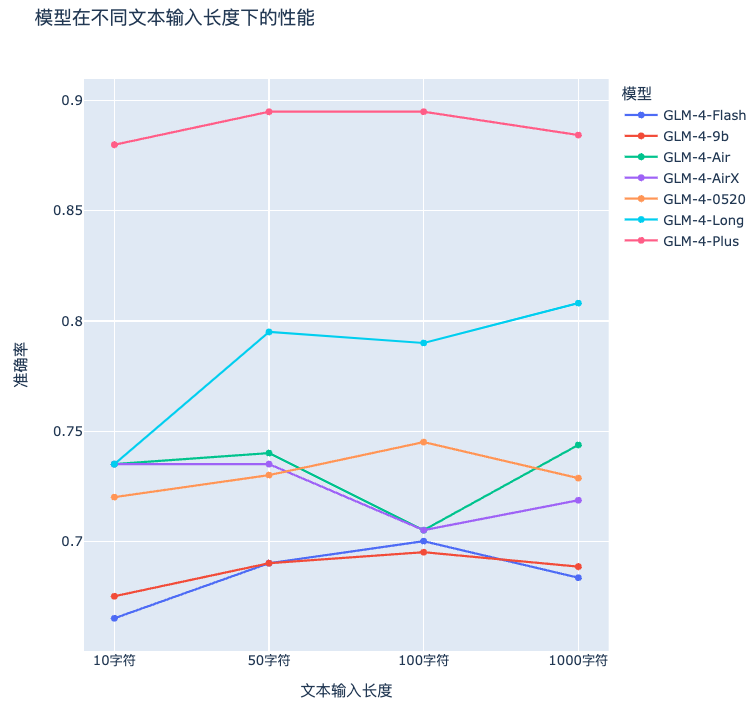
GLM-4-Plus整体表现非常稳定,精度始终保持在0.88以上,是所有模型中最高的。模型如GLM-4-Plus和GLM-4-Long在处理长文本时表现较好。

unsetunsetGLM-4-Plus介绍unsetunset

在 KDD 国际数据挖掘与知识发现大会上,智谱 GLM 团队发布了新一代基座大模型——GLM-4-Plus。作为智谱全自研 GLM 大模型的最新版本,GLM-4-Plus 标志着智谱AI在通用人工智能领域的持续深耕,推进大模型技术的独立自主创新。

GLM-4-Plus 在长文本处理能力上比肩国际先进水平。通过更精准的长短文本数据混合策略,显著增强了长文本的推理效果。

模型LongBench-ChatInfiniteBench/EN.MCRuler
Mistral-123B8.238.980.5
Llama 405B8.683.491.5
Claude Sonnet 3.58.679.5-
Gemini 1.5 Pro8.680.995.8
GPT-4o982.5-
GLM-4-Plus8.885.193
GLM-4-Plus/GPT-4o98%103%-
GLM-4-Plus/Claude 3.5 Sonnet102%107%-

调用示例

同步调用方法
from zhipuai import ZhipuAI  
client = ZhipuAI(api_key="") # 填写您自己的APIKey  
response = client.chat.completions.create(  
    model="glm-4-plus",  # 填写需要调用的模型编码  
    messages=[  
        {"role": "user", "content": "作为一名营销专家,请为智谱开放平台创作一个吸引人的slogan"},  
        {"role": "assistant", "content": "当然,为了创作一个吸引人的slogan,请告诉我一些关于您产品的信息"},  
        {"role": "user", "content": "智谱AI开放平台"},  
        {"role": "assistant", "content": "智启未来,谱绘无限一智谱AI,让创新触手可及!"},  
        {"role": "user", "content": "创造一个更精准、吸引人的slogan"}  
    ],  
)  
print(response.choices[0].message)  

流式调用方法
from zhipuai import ZhipuAI  
client = ZhipuAI(api_key="") # 请填写您自己的APIKey  
response = client.chat.completions.create(  
    model="glm-4-plus",  # 填写需要调用的模型编码  
    messages=[  
        {"role": "system", "content": "你是一个乐于解答各种问题的助手,你的任务是为用户提供专业、准确、有见地的建议。"},  
        {"role": "user", "content": "我对太阳系的行星非常感兴趣,特别是土星。请提供关于土星的基本信息,包括其大小、组成、环系统和任何独特的天文现象。"},  
    ],  
    stream=True,  
)  
for chunk in response:  
    print(chunk.choices[0].delta)  

  • System Message 格式
参数名称参数说明
role消息的角色信息,此时应为system
content消息内容
  • User Message 格式
参数名称参数说明
role消息的角色信息,此时应为user
content消息内容

GLM-4-Plus 能力介绍

  • 语言理解能力:GLM-4-Plus 使用了大量模型辅助构造高质量合成数据以提升模型性能;有效提升了模型推理(数学、代码算法题等)表现,更好反映人类偏好。
  • 长文本推理能力:GLM-4-Plus通过精准的长短文本数据混合策略、先进的预训练与微调技术,以及创新性的技术手段,成功地在长文本推理能力上达到了国际先进水平。

在这里插入图片描述

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

GLM-5.3大模型API实战指南:从代码生成到函数调用全解析 大语言模型(LLM)通过自回归空白填充等预训练范式,具备了强大的上下文理解和文本生成能力,其核心价值在于将自然语言转化为可执行的代码逻辑与工具调用。在工程实践中,模型即服务(MaaS)架构使得开发者能够便捷地通过API集成AI能力,应用于代码生成、数据分析、智能体构建等场景,有效提升开发效率与自动化水平。本文聚焦于智谱GLM-5.3系列模型,通过详细的API调用示例与场景化对比,深入解析其函数调用、长文本处理等核心功能,为技术选型与集成落地提供实践参考。 阅读详情

相关推荐

GLM-5中文大模型实战指南:高稳定性、长上下文与Agent就绪能力解析

大语言模型(LLM)作为AI应用的核心引擎,其在中文场景下的语义理解深度、长文本处理鲁棒性及工具调用稳定性,直接决定企业级AI系统的交付质量。GLM-5并非单纯参数升级,而是围绕中文政策术语、地域性常识、结构化文档(如合同、法规)和多步骤Agent工作流等真实需求,重构了训练语料、注意力机制与意图识别架构。它在C-Eval Pro达92.1%高分,256K上下文下PDF风险点提取准确率94.2%,且tool_calls输出100%可被json.loads直接解析——这意味着开发者可大幅减少容错胶水代码。本文

chuanao8829的博客 406

GLM - 4 - Plus:智谱 AI 最新推出的大型基座模型

智谱 GLM 团队重磅发布了新一代基座大模型 ——GLM - 4 - Plus。作为智谱全自研 GLM 大模型的全新版本,GLM - 4 - Plus 充分彰显了智谱 AI 在通用人工智能领域的深度耕耘,有力地推动了大模型技术的独立自主创新。GLM - 4 - Plus 是对以往模型持续优化与创新的结晶。它巧妙地融合了先进的算法以及海量的数据,其目标是为用户呈上更为智能、更为高效的语言处理服务。

寻道AI,探索AI无限可能! 4094

从TM1到TM9:手把手教你用Wireshark抓包分析LTE下行调度与传输模式切换

本文详细解析了如何使用Wireshark抓包分析LTE下行调度中的传输模式切换,从TM1到TM9的动态调整过程。通过实战案例,包括小区边缘移动、高速场景和多用户调度,揭示eNodeB如何基于信道质量指标(如RSRP、SINR)动态切换传输模式,并提供关键信令解析和优化建议,助力网络工程师提升LTE网络性能。

weixin_42651748的博客 315

基座大模型GLM-4-Plus引领,智谱全模型家族全面上线

智谱在近期发布的若干更新模型,以基座大模型 GLM-4-Plus 推出为标志。智谱很高兴宣布,全模型家族正式上线bigmodel.cn,包括新基座大模型 GLM-4-Plus,这是智谱迄今为止最强大的模型,成为智谱全模型家族坚实的能力底座。

AGI_GGbond的博客 1413

Edge浏览器IE模式失效?最新142版本隐藏按钮的3种解决方案

本文针对Edge浏览器142版本中IE模式按钮消失的问题,提供了3种实用解决方案,包括注册表修改、手动添加网站到IE模式列表和企业策略部署方案,帮助用户解决兼容性问题,确保老旧系统正常访问。

weixin_28308325的博客 503

robot framework循环读取excel表操作

robot framework循环读取excel表操作 1、安装excellibrary,注意python3.7版本,需安装:robotframework-excel,robotframework-excellibrary-xwfintech 注意:网上有很多excel处理的,都是基于python2.7的,还有一些对python3以上都是修改包的方式,其实都不需要,在pip官网上有python3以上的excellibrary,名称是robotframework-excellib 2.0.0,但是该包关键字不

余墨的博客 1319

大模型长文本处理技术与GLM-4-Plus评测

模型描述上下文GLM-4-Plus高智能旗舰128KGLM-4-0520高智能模型128K超长输入1MGLM-4-AirX极速推理8KGLM-4-Air高性价比128K免费调用128K在 KDD 国际数据挖掘与知识发现大会上,智谱 GLM 团队发布了新一代基座大模型——GLM-4-Plus。作为智谱全自研 GLM 大模型的最新版本,GLM-4-Plus 标志着智谱AI在通用人工智能领域的持续深耕,推进大模型技术的独立自主创新。

qingkahui24689的博客 2092

关于卷积过程中通道数如何变化问题

对卷积操作前后通道数问题进行解释,输出通道数=卷积核的个数。

你好,明天,,的博客 4316

GLM-4-Plus初体验

无论是撰写营销文案、博客文章、社交媒体帖子,还是制作广告,优质的内容不仅能够帮助品牌吸引目标受众的注意力,还能有效促进产品和服务的转化。:提供个性化的知识库定制功能,您可以根据自身需求创建一个独立、私密的工作环境,确保您的数据和创作内容仅限您自己使用。所有的数据都只会保存在您的专属知识库中,避免任何未经授权的访问和泄露,保护您的客户隐私和法律权益。通过Retrieval方法访问智谱开放平台的知识库,用户可上传相关的知识到知识库,模型将基于用户的查询,提取相关的语义切片,提供更加精准详细的信息。

wujiayu31415的博客 1585

【DRAM存储器五十一】LPDDR5介绍--DFE与Pre-Emphasis

简述LPDDR5的DFE和预加重应用设置

highman110的博客 706

基于传统算法的半导体晶圆缺陷检测原理及代码(二)

了解基于传统算法的半导体晶圆缺陷检测原理和方法,对于深入理解半导体制造工艺和质量控制具有重要意义。在半导体制造技术持续创新的浪潮中,基于传统算法的缺陷检测技术也将不断演进,为半导体产业的高质量发展提供坚实可靠的技术支撑,确保在芯片制造的每一个环节都能精准识别和管控缺陷,推动半导体产业迈向更高的发展水平。基于传统算法的半导体晶圆缺陷检测技术在半导体制造的长期发展历程中扮演了重要角色,凭借其成熟的技术体系、较快的检测速度和相对较低的成本,在各个工艺阶段为保障晶圆质量发挥了关键作用。

m0_44975814的博客 2220

用好大模型,让前端开发效率如火箭般一飞冲天!

而。

2401_84205765的博客 1429

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤 一般情况下,我们使用西门子的S7通信时都是将网络中的PLC的IP设置在同一网段,那么如果涉及到旧项目改造时,不方便修改IP地址,只能进行2个网段通信时,可以参考以下步骤: 准备条件: 2个路由器 CPU 1212C 主动连接 CPU 314C-2PN/DP 被动连接 网络搭建如下图所示: S7-1212C一侧 建立S7主动连接 ,IP地址:192.168.5.40,编写get/put 通信程序 S7-300 IP地址:192.168.0

Robot_PLC_HMI_Automation 2万+

【NLP】大模型长文本处理技术与GLM-4-Plus评测:从上下文窗口到TaoToken统一调用

用新闻分类脚本压测 GLM-4-Plus 长文本精度,从 1K 到 100K 字符逐档验证衰减曲线,并给出 TaoToken 统一 Key 接入配置与 401、choices 报错排查。GLM-4-Plus 在 128K 内精度稳定,适合知识库问答与长文档摘要,配合 TaoToken 可一键切换模型横向对比。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

Ceshi01的博客 21

timing window file中的S L T指什么意思

我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?

m0_61544122的博客 774

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型翻译能力评测

本文提供了一种客观有效的方法,可以全面评估大模型的翻译效果。

weixin_34452850的博客 4307

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

阿里Qwen3.6-Plus实测

官方宣称,Qwen3.6-Plus相较于前代模型实现了全方位的能力升级,其中最核心的升级方向是智能体编程能力——无论是前端网页开发还是复杂的代码仓库级问题求解,Qwen3.6-Plus均树立了新的业界标杆。id=qwen3.6)将Qwen3.6-Plus定位为"面向真实世界的Agent",并从语言能力和视觉语言能力两大维度展示了其评测成绩。在多模态能力上,Qwen3.6-Plus围绕推理能力增强、指令模式实用性提升以及复杂任务执行能力拓展三个方向进行了持续演进。*输出价格单位: 元/百万token。

easyllm的博客 1184

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

不是哥们,真有人拿 AI 来面试啊?

如今 AI 已经渗透到了我们的生活、求职、工作等方方面面。就拿求职来说,今年的美团校招,已经用上了 AI 来当面试官,降本增效。我自己也当过面试官,其实对 AI 面试官还是挺好奇的。毕竟每个候选人的情况不同,想要全方面考察一个人的水平,一定要针对其简历和具体情况定制化提问。嘿嘿,当然要用魔法打败魔法!我们也可以用 AI 来准备面试呀~具体怎么做呢?这篇文章鱼皮就带大家搞一个 AI 备战面试小助手出来!看到结尾还有福利哦~首先我们要选择一个优质的 AI 大模型,AI 面试官智商的高低就取决于它了。

python1222_的博客 2324

大模型能力评测新范式:七大维度切片与置信区间评估

大模型能力评估正从粗粒度总分制转向细粒度、可验证、工程友好的能力度量体系。其核心在于将抽象的‘智能水平’解构为语言理解、逻辑推理、数学计算、代码生成、多模态对齐、中文语境适配和安全合规响应等基础技术维度,并通过独立测试集、人工对抗构造与跨模型一致性验证保障数据质量。该体系强调‘能力切片+置信区间’,输出分数、标准差与最小样本量三元组,直击工程落地中对误差范围与任务可靠性的刚性需求。尤其在中文语境适配与安全合规响应两大热词所代表的关键能力上,评测结果已深度关联政务公文改写、网络语义漂移识别、诱导性越狱防御等真

ctk87443的博客 335

马斯克又开源了。。。

最近一周AI科技圈又发生了啥新鲜事?

啥都生的博客 874

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2317

【AI应用--白话大模型(篇一)】AI大模型从入门到实战:机器学习·深度学习与四大模型实操

Gemini是由 Google DeepMind 开发的下⼀代原⽣多模态⼤模型家族。与传统“先训练⽂本,再外挂视觉/⾳频组件”的拼接式模型不同,Gemini 从底层架构设计之初,就将⽂本、图像、⾳频、视频和代码等不同模态的数据融合在⼀起进⾏联合训练。这种原⽣多模态(Native Multimodal)设计,赋予了它极强的跨模态理解与深度推理能⼒。Gemini采⽤了“早期融合(Early Fusion)”策略。

2501_93351213的博客 486

【LLM】第一章:大模型进化史+AI知识体系框架概览

大模型,具体说就是大语言模型,LLM,large language model,这个领域其实就是NLP,所以本专栏也是NLP专栏的延续,是NLP的高阶内容。

因为热爱所以坚持 487

MIAOYUN | 每周AI新鲜事儿(08.08-08.15)

本周AI领域亮点纷呈,阿里、百川、智谱、昆仑万维(连发5弹)等密集开源发布新模型,推动多模态、视觉、具身智能与视频生成边界;GitHub不再独立运营并入微软AI部门、Grok 4免费开放等事件引市场关注,一起来回顾本周不容错过的AI新鲜事儿吧!

成都元来云志科技有限公司,国内云原生智能运维领域的创新领跑者 655
上一篇: 一文彻底搞懂大模型 - Fine-tuning三种微调方式
下一篇: MindSpeed加速百万级超长序列大模型训练
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值