当大模型遇上垂直领域:微调如何让 AI 从 “什么都会” 到 “样样精通”?

基于 高斯过程回归(Gaussian Process Regression, GPR) 的 时间序列区间预测 的 MATLAB 示例代码 阅读详情

在人工智能领域,大模型就像一个 “知识通才”,通过海量数据训练,掌握了广泛的知识和技能。但在实际应用中,我们常常需要模型在特定领域或任务上表现出色,这时就需要用到模型微调(Fine-tuning)了。

01

什么是模型微调?

简单来说,模型微调是在已经训练好的预训练模型基础上,使用特定领域或任务的数据,对模型的参数进行进一步调整优化的过程。预训练模型就像搭建好的毛坯房,微调就是根据不同的使用需求进行个性化装修。比如,一个通用的语言模型在经过大量文本训练后,能完成多种语言任务,但当我们想让它专注于医学文献摘要生成时,就可以用医学领域的文献数据对其微调,让它更好地理解和处理医学专业内容。


02

为什么需要微调模型?

一方面,预训练模型虽然知识储备丰富,但它学习的是通用知识,缺乏对特定领域细节和规则的深度理解。通过微调,模型能针对特定领域的术语、逻辑和任务特点进行学习,从而在专业领域的表现大幅提升。比如,用金融数据微调过的模型,在分析金融报告、预测股票走势时,准确性会比通用模型高很多。另一方面,微调可以降低训练成本和时间。训练一个模型需要大量的计算资源和时间。而微调是在已有模型基础上进行,就像在现成的框架上做优化,能以相对较低的成本,快速满足特定任务需求。


03

如何微调模型?
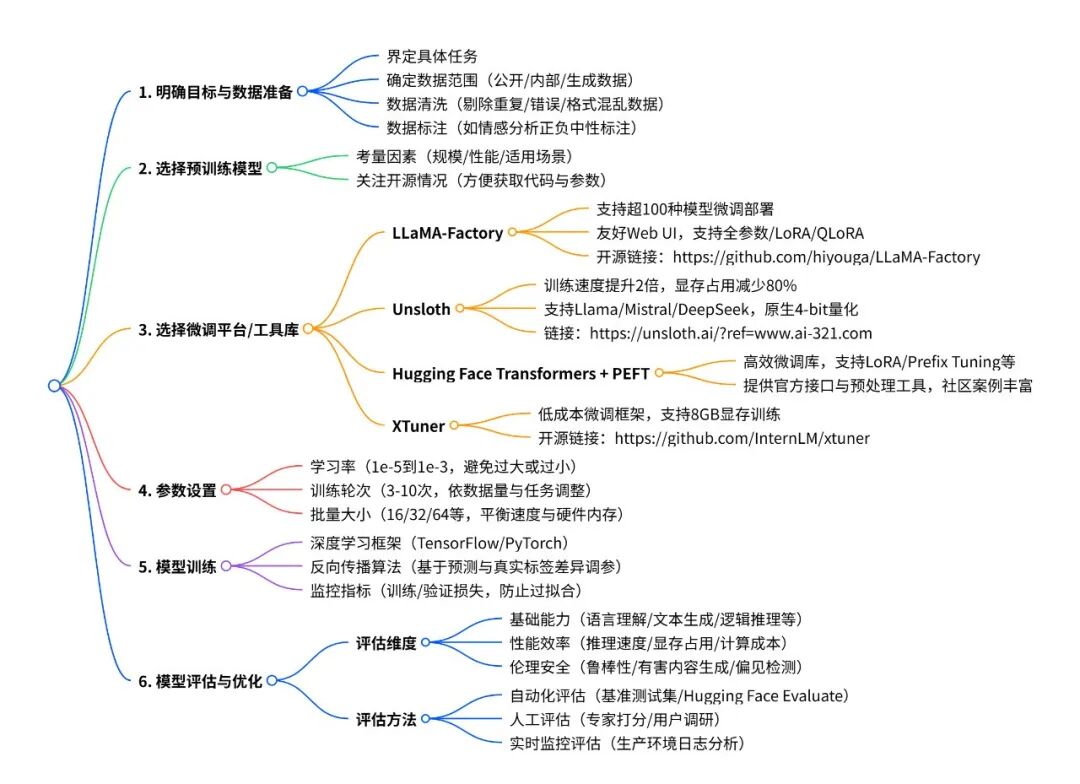
1. 明确目标与数据准备

微调前,要清晰界定具体任务,例如是要用于智能客服回答特定行业问题,还是进行特定领域的文本情感分析。根据任务确定数据范围,数据来源可以是公开数据集,像医疗领域的 Cochrane Library,也可以是企业内部积累的业务数据,还可以借助工具生成数据。

同时,要对数据进行清洗,剔除重复、错误、格式混乱的数据,确保数据质量。比如在处理电商评论情感分析数据时,需去除无意义的乱码评论;还要对数据进行标注,如在情感分析任务中,明确标注每条评论是正面、负面还是中性情感,为模型训练提供准确的参考。

2. 选择预训练模型

要综合考量模型的规模、性能、适用场景等因素。如果是处理中文自然语言处理任务,且对模型轻量化有要求,可以选择轻量级模型;若追求高精度的文本生成任务,GPT 系列模型会是不错的选择。同时,还需关注模型的开源情况,开源模型方便获取代码和预训练参数,利于进一步开发和调整。

3. 选择合适的微调平台/工具库

这里列出了几个微调平台/工具库:

◦ LLaMA - Factory:堪称模型微调领域的 “多面手”。它支持超过 100 种主流大模型的微调与部署 ,像 LLaMA、Mistral、DeepSeek 等常见模型都不在话下。其提供的 Web UI 界面十分友好,哪怕你没有深厚的代码功底,也能轻松完成参数配置与训练监控。在微调方法上,全参数微调、LoRA、QLoRA 等高效方式它都支持,能契合不同的资源状况。

开源链接:https://github.com/hiyouga/LLaMA-Factory

◦ Unsloth:主打高效的平台,它能让训练速度提升 2 倍,同时减少 80% 的显存占用,对 Llama、Mistral、DeepSeek 等模型均有良好支持。在资源受限的情况下,比如使用消费级显卡,它也能对 DeepSeek 进行快速微调。它原生支持 4 - bit 量化训练,能有效降低训练成本。

链接直达:https://unsloth.ai/?ref=www.ai-321.com

◦ Hugging Face Transformers + PEFT:PEFT(Parameter-Efficient Fine-Tuning)是 Hugging Face 推出的一个专门用于 大语言模型参数高效微调 的库,目标是在只训练少量参数的同时保持模型性能,显著减少显存消耗和训练成本。它支持 LoRA、Prefix Tuning、P - Tuning v2 等多种高效微调方法。针对不同类型的模型,它提供了官方模型接口以及数据集预处理工具,社区中也沉淀了不少成功案例,方便用户参考学习。

◦ XTuner:上海人工智能实验室(上海AI实验室)发布低成本大模型训练工具箱XTuner,XTuner聚焦于微调环节,为各类开源大模型提供了轻量级微调框架。XTuner支持多种层级硬件的适配,开发者最低只需使用8GB消费级显存,即可训练出适用于具体需求场景的“专属大模型”,“真金白银”拉低大模型训练成本,与各界一道共同推动技术进步。

开源链接https://github.com/InternLM/xtuner

4. 参数设置

学习率决定了模型在训练过程中参数更新的步长,一般初始学习率设置在 1e-5 到 1e-3 之间。学习率过大,模型可能在训练过程中跳过最优解;学习率过小,训练速度会变得非常缓慢。训练轮次(Epoch)指的是模型对整个训练数据集进行学习的次数,通常在 3 到 10 次之间。具体数值需要根据数据量和任务复杂程度调整,数据量较小、任务简单时,轮次可以适当减少;反之则需增加。此外,还需设置批量大小(Batch Size),即每次训练送入模型的数据样本数量,常见取值为 16、32、64 等,较大的批量大小能利用 GPU 并行计算加速训练,但对硬件内存要求更高。

5. 模型训练

利用深度学习框架,如 TensorFlow 或 PyTorch,将准备好的数据按设置的参数输入模型进行训练。在训练过程中,模型基于反向传播算法,根据预测结果与真实标签的差异,不断调整内部参数,优化模型对特定数据的处理能力。训练过程中要实时监控训练损失和验证损失,若训练损失持续下降,而验证损失开始上升,可能出现了过拟合现象,需要调整参数或增加正则化处理。

6. 模型评估与优化

大模型的评估需覆盖能力全面性、性能稳定性、伦理安全性等多维度,不同任务(如文本生成、问答、推理等)的指标略有差异。

  • 基础能力评估方面:基础能力评估从语言理解(准确率、F1 值)、文本生成(困惑度、BLEU、ROUGE、METEOR)、逻辑推理(GSM8K、MATH、BBH)、知识问答(QA 准确率、Rouge-L、BERTScore)、多模态能力(MSCOCO、Flickr30K)等维度,通过对应指标和方法测试模型在语义理解、内容生成、逻辑推理、知识问答及图文关联等方面的能力。
  • 性能方面:性能与效率评估主要围绕推理速度、显存占用和计算成本展开。推理速度通过每秒 token 数(Tokens/s)、延迟(Latency)衡量,反映模型响应快慢,受硬件(如 GPU/TPU)和模型架构(如 Transformer 并行度)影响;显存占用关注训练 / 推理时的最大内存消耗(如 GPU 显存),其高低影响模型在消费级设备的部署可行性,可通过 4bit/8bit 量化等方式优化;计算成本则通过 FLOPs(浮点运算次数)和训练时长体现,与模型参数量、优化算法相关,用于评估训练 / 推理的资源消耗情况。
  • 伦理安全方面:鲁棒性与安全性评估通过对抗样本攻击成功率、跨领域泛化能力衡量模型鲁棒性,以有害内容生成率、偏见检测评估伦理安全,借助注意力可视化等方法进行可解释性分析。
  • 评估方法方面:大模型评估方法包括利用基准测试集(如 GLUE、SuperGLUE、MMLU)和工具库(如 Hugging Face Evaluate)的自动化评估、专家打分和用户调研等人工评估,以及在生产环境中通过日志分析进行输入分布、输出质量和性能指标监控的实时监控评估。

04

总结

模型微调就像给 “知识通才” 定制专业课程,让它摇身一变成为 “行业专家”。掌握模型微调技术,选对合适的平台,能让大模型更好地服务于我们的生活和工作,在各个专业领域发挥更大的价值。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

YOLOv5源码逐行超详细注释与解读(5)——配置文件yolov5s.yaml 全网最详细的YOLOv5源码解读之配置文件yaml。逐行注释,逐句讲解,一文带你了解yaml。小白必看! 阅读详情

相关推荐

Kimi K3大模型API实战:从调用到本地知识库问答系统构建

大语言模型(LLM)作为人工智能的核心技术,通过海量数据训练获得理解和生成自然语言的能力。其工作原理基于Transformer架构,通过自注意力机制捕捉长距离依赖关系。这项技术的核心价值在于能够将非结构化文本转化为可计算、可交互的智能体,极大地提升了信息处理和自动化任务的效率。在应用场景上,大模型广泛应用于智能对话、代码生成、文档总结与问答等领域。其中,国产大模型如月之暗面推出的Kimi K3,凭借其在**长文本处理**和**中文场景优化**方面的优势,为开发者提供了新的技术选项。本文将以Kimi K3为例

weixin_30694389的博客 299

垂直领域大模型微调最全指南(非常详细),收藏这一篇就够了!

一年来多以来,大语言模型发展和变化越来越快,总体呈现出模型尺寸越变越大,算力需求越来越多,模型推理要求越来越高的特点。在这种背景下,现在不同的人关于垂域 LLM 出现了一些争议,一部分人认为随着大模型的能力越来越强,垂类的知识会加训融合到大模型。尤其当下,在 GPT-4o 效果一枝独秀的前提下,其他无论是通用模型,还是基于垂类模型都被 GPT-4o 吊打,一个典型的对比就是 GPT-4o 加持的Code Colpliot的代码能力一点都不逊色与Devins等智能体工程师。

lvaolan168的博客 1万+

CAB单片机开发指南

CAB单片机开发使用指南,IDE安装及烧录注意事项

Zoebuxiangtian的博客 1558

垂直领域大模型微调最全指南

一年来多以来,大语言模型发展和变化越来越快,总体呈现出模型尺寸越变越大,算力需求越来越多,模型推理要求越来越高的特点。在这种背景下,现在不同的人关于垂域 LLM 出现了一些争议,一部分人认为随着大模型的能力越来越强,垂类的知识会加训融合到大模型。尤其当下,在 GPT-4o 效果一枝独秀的前提下,其他无论是通用模型,还是基于垂类模型都被 GPT-4o 吊打,一个典型的对比就是 GPT-4o 加持的Code Colpliot的代码能力一点都不逊色与Devins等智能体工程师。

m0_56022510的博客 9085

深度学习环境搭建:CUDA、Anaconda、PyTorch 完整安装与验证教程

步骤操作验证命令1安装 CUDA 工具包nvcc -V2安装 Anaconda3创建 yolo 环境4安装 PyTorch5验证 GPU。

qq_37606844的博客 321

SLAM轨迹评估神器evo实战:从GPS到TUM格式的完整转换指南(附Python代码)

本文详细介绍了如何使用evo工具将GPS数据转换为TUM格式,以便进行SLAM轨迹评估。通过Python代码实现GPS到笛卡尔坐标的精确转换,并提供了完整的处理流程和实战案例,帮助开发者轻松完成从原始GPS数据到精确轨迹评估的全过程。特别适用于ORB-SLAM等视觉SLAM算法的性能验证。

weixin_29074295的博客 294

大模型微调经验总结与感想分享

终于有时间做个最近工作的小结,最近一个多月,做了很多大模型微调的工作,包括了生成式任务以及判别式任务,典型的任务如文创、意图分类等。整理一下微调的经验与感想 (几十块A100的堆出来的,都是钱啊!

机器学习社区 3750

《QT+PCL 第一章》:点云读取显示

点云读取显示一、核心代码二、QT设置三、效果展示 一、核心代码 二、QT设置 三、效果展示

阁楼 1万+

模型微调还是RAG?使用LLM需要考虑的决策点

模型微调(Fine-Tuning)和检索增强生成(Retrieval-Augmented Generation,简称RAG)是两种不同的技术,它们都用于提升语言模型的性能,但各自采用的方法和侧重点有所不同。本文基于微软的论文对其进行了比较。

2301_81888214的博客 905

RK3568移植AP6256

本文主要是记录RK3568移植正基的AP6256的WIFIBT模块,感兴趣的朋友可以一起学习!!!提示:以下是本篇文章正文内容,下面案例可供参考。

qq_24093081的博客 3715

Oracle EBS 帐套(Ledger/SOB)如何定义会计主体、如何支撑多准则 / 多报告、组织与帐套的绑定关系、以及项目落地时的设计差异。下面从实现逻辑、核心要素、组织模型、多账簿、科目设计、项

本文对比了Oracle EBS R12与SAP S/4HANA在帐套(Ledger)设计上的核心差异。Oracle采用4C架构(科目/币种/日历/准则),帐套作为独立会计主体,主辅账物理隔离;SAP则以公司代码为主体,通过平行分类账在同一凭证中实现多准则核算。关键差异体现在:Oracle强调边界隔离,适合差异大的集团;SAP注重统一视图,适合实时合并需求。实施时需注意:Oracle避免过度建账套,SAP需统筹科目与维度设计。两者分别体现了"盒子"与"滤镜"的设计哲学。

金牌架构师 417

大模型深耕垂直领域:微调技术如何推动 AI 从 “全能” 迈向 “专精”?

大模型深耕垂直领域:微调技术如何推动 AI 从 “全能” 迈向 “专精”?

ytt0523_com的博客 840

如何完全卸载axure软件以及解决安装axure后打不开的问题【2023年】

如何完全卸载axure软件以及解决安装axure后打不开的问题【2023年】

念兮为美 5139

从通用到专用:垂直领域大模型的微调秘籍

AI垂直领域微调实战指南 在AI技术广泛应用的时代,通用大模型(如GPT、Llama)虽功能强大,但难以满足专业领域需求。**微调(Fine-tuning)**成为关键解决方案,通过迁移学习将通用模型转化为行业专属工具。 核心价值 填补知识鸿沟:增强模型对医、法、金融等领域的术语和规则理解 提升任务性能:优化代码生成、合同审查等专项能力 保障数据安全:基于内部数据训练,避免隐私泄露 实战步骤 选基座模型:根据领域(如中文选Qwen)和资源权衡模型规模 建领域数据集:整合内部文档、公开数据,注重清洗与标注规范

千淘万漉虽辛苦,吹尽狂沙始到金 2万+

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

垂直领域中建立AI大模型应用的项目策略_垂直领域大模型搭建

打破信息孤岛、数据电子化、建立全局数据视图和数据标准、通过清洗加工标注等方式提高数据质量、协调大模型与外部知识库的配合等,要保证提供高质量的数据,保证在整个系统中数据流的畅通,这些都需要客户方自身的努力,不排除有可能在这一类项目当中,还要从最基础的信息化工作做起,才能具备数字化转型和智能化改造的条件。

2401_85328934的博客 1738

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

【AI大模型微调】垂直领域大模型微调实践经验最全总结

本篇从基座模型选择、模型整体架构、数据设计、训练微调四个角度总结垂直领域大模型微调经验。 本篇将现有垂类大模型微调已公布的实践经验做一个全面的总结,大部分经验实测可推广,大家在自己实践过程中可以进行适当参考。

bugyinyin的博客 1260

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

垂直领域大模型微调实践经验最全总结

本篇从基座模型选择、模型整体架构、数据设计、训练微调四个角度总结垂直领域大模型微调经验。本篇将现有垂类大模型微调已公布的实践经验做一个全面的总结,大部分经验实测可推广,大家在自己实践过程中可以进行适当参考。下面是一个快捷目录,其中数据设计和训练微调是重点。1. 基座模型选择2. 模型整体架构3. 数据设计4. 训练微调推荐BLOOMZ模型BLOOMZ 模型系列使用了PILE语料库进行训练,该语料库包含各种医学文本,包括PubMed Central 和 PubMed Abstracts等。

2301_82275412的博客 2822

垂直领域的大模型应该如何构建?RAG还是微调呢?

在构建大型语言模型 (LLM) 应用程序时,开发人员可以通过两种常见方式整合专有数据和特定于领域的数据:检索增强生成 (RAG) 和微调。RAG使用外部数据增强提示,而微调则将其他知识合并到模型本身中。然而,这两种方法的优缺点尚不清楚。论文提出了一个用于微调和 RAG 的管道,并介绍了多种流行的 LLM(包括 Llama2-13B、GPT-3.5 和 GPT-4)的两者的权衡。我们的流程由多个阶段组成,包括从 PDF 中提取信息、生成问题和答案、使用它们进行微调,以及利用 GPT-4 评估结果。

python1234_的博客 1784

垂直领域大模型微调终极指南:一篇详细教程,助您成为行业专家!

一年来多以来,大语言模型发展和变化越来越快,总体呈现出模型尺寸越变越大,算力需求越来越多,模型推理要求越来越高的特点。在这种背景下,现在不同的人关于垂域 LLM 出现了一些争议,一部分人认为随着大模型的能力越来越强,垂类的知识会加训融合到大模型。尤其当下,在 GPT-4o 效果一枝独秀的前提下,其他无论是通用模型,还是基于垂类模型都被 GPT-4o 吊打,一个典型的对比就是 GPT-4o 加持的Code Colpliot的代码能力一点都不逊色与Devins等智能体工程师。

2401_85343303的博客 2173

垂直领域大模型微调的实战经验大揭秘

这段时间,一直在思考微调垂直大模型。涉及的领域:大数据和大模型。

m0_59164520的博客 1242
上一篇: 从零开始:手把手教你微调Embedding模型,让检索效果提升10倍
下一篇: 30天快速入门AI大模型:从理论到实践的详细学习方案
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
