


还在为RAG系统的检索效果不佳而苦恼?通用Embedding模型无法理解你的业务场景?今天,我将带你从零开始,用LlamaIndex微调一个专属的Embedding模型,让检索准确率大幅提升!
一、为什么需要微调Embedding模型?
在RAG(检索增强生成)系统中,Embedding模型的质量直接决定了检索效果。虽然市面上有很多优秀的通用Embedding模型(如BGE、OpenAI的text-embedding-ada-002等),但在特定领域,它们往往表现不佳。
举个例子:
- 通用模型可能无法理解"证券发行"和"股票上市"在你的业务场景中的关联性
- 专业术语的语义理解可能不够准确
- 领域特定的表达方式可能被误判
解决方案: 通过微调,让模型学习你的领域知识,大幅提升检索准确率!
二、项目架构:三步走策略
我们的微调流程分为三个核心步骤:
步骤1:生成训练数据集
从PDF/Markdown等文档中提取文本,使用大语言模型自动生成问答对作为训练数据。
步骤2:模型微调
使用LlamaIndex的微调引擎,基于生成的训练数据对Embedding模型进行微调。
步骤3:效果评估
对比微调前后的模型性能,验证微调效果。
三、实战代码解析
事先准备两份语料,一份为训练的语料,一份为验证的语料。为了测试方便,这里我们使用一份语料分别作训练和验证用。下载地址:
https://www.modelscope.cn/datasets/muxueai/ai_ai_yu_llm_study_lib/resolve/master/%E4%B8%AD%E5%8D%8E%E4%BA%BA%E6%B0%91%E5%85%B1%E5%92%8C%E5%9B%BD%E8%AF%81%E5%88%B8%E6%B3%95(2019%E4%BF%AE%E8%AE%A2).pdf
.env配置里:
OPENAI_API_KEY=sk-xxxx
OPENAI_API_BASE=https://api.siliconflow.cn/v1
LLM_MODEL=deepseek-ai/DeepSeek-V3
EMBEDDING_MODEL=Qwen/Qwen3-Embedding-8B
安装依赖包:
# pyproject.toml
[project]
name = "embedding-ft"
version = "0.1.0"
description = "Add your description here"
readme = "README.md"
requires-python = ">=3.12,<3.13"
dependencies = [
"datasets>=4.4.1",
"llama-index-core>=0.14.8",
"llama-index-embeddings-huggingface>=0.6.1",
"llama-index-embeddings-openai-like>=0.2.2",
"llama-index-finetuning>=0.4.1",
"llama-index-llms-openai-like>=0.5.3",
"llama-index-readers-file>=0.5.4",
"python-dotenv>=1.2.1",
"transformers[torch]>=4.57.1",
]
3.1 第一步:生成训练数据集
首先,我们需要从需要训练的文档中提取文本,并生成问答对。这里使用LlamaIndex的generate_qa_embedding_pairs函数,它会自动调用大语言模型生成高质量的问答对。
# 1-gen_train_dataset.py
import json
from llama_index.core import SimpleDirectoryReader
from llama_index.core.node_parser import SentenceSplitter
import os
from llama_index.finetuning import generate_qa_embedding_pairs
from llama_index.llms.openai_like import OpenAILike
from dotenv import load_dotenv
load_dotenv()
BASE_DIR = r"D:\Test\embedding_ft\data"
# 训练集和验证集文件路径
TRAIN_FILES = [os.path.join(BASE_DIR, "中华人民共和国证券法(2019修订).pdf")]
VAL_FILES = [os.path.join(BASE_DIR, "中华人民共和国证券法(2019修订).pdf")]
# 训练集和验证集语料库文件路径
TRAIN_CORPUS_FPATH = os.path.join(BASE_DIR, "train_corpus.json")
VAL_CORPUS_FPATH = os.path.join(BASE_DIR, "val_corpus.json")
def load_corpus(files, verbose=False):
if verbose:
print(f"Loading files {files}")
reader = SimpleDirectoryReader(input_files=files)
docs = reader.load_data()
if verbose:
print(f"Loaded {len(docs)} docs")
parser = SentenceSplitter()
nodes = parser.get_nodes_from_documents(docs, show_progress=verbose)
if verbose:
print(f"Parsed {len(nodes)} nodes")
return nodes
def mk_dataset():
train_nodes = load_corpus(TRAIN_FILES, verbose=True)
val_nodes = load_corpus(VAL_FILES, verbose=True)
# openai-like兼容大模型
llm = OpenAILike(
model=os.getenv("LLM_MODEL"),
api_base=os.getenv("OPENAI_API_BASE"),
api_key=os.getenv("OPENAI_API_KEY"),
temperature=0.7,
)
train_dataset = generate_qa_embedding_pairs(llm=llm, nodes=train_nodes)
val_dataset = generate_qa_embedding_pairs(llm=llm, nodes=val_nodes)
train_dataset.save_json(TRAIN_CORPUS_FPATH)
val_dataset.save_json(VAL_CORPUS_FPATH)
mk_dataset()
关键点:
SimpleDirectoryReader:自动读取PDF文档SentenceSplitter:将文档切分为合适的文本块generate_qa_embedding_pairs:使用LLM自动生成问答对,无需人工标注!- 一共生成2个json,分别为微调所使用的训练集和 验证集。
- 可以使用任意平台的大模型,为了生成高质量的数据集,尽量选择能力强的大模型;这里使用硅基平台的,
3.2 第二步:模型微调
有了训练数据,接下来就是微调模型。LlamaIndex提供了SentenceTransformersFinetuneEngine,封装了所有复杂的训练逻辑。
# 2-fine_tune.py
from llama_index.finetuning import SentenceTransformersFinetuneEngine
from llama_index.core.evaluation import EmbeddingQAFinetuneDataset
import os
BASE_DIR = r"D:\Test\embedding_ft\data"
TRAIN_CORPUS_FPATH = os.path.join(BASE_DIR, "train_corpus.json")
VAL_CORPUS_FPATH = os.path.join(BASE_DIR, "val_corpus.json")
def finetune_embedding_model():
# 加载训练集和验证集
train_dataset = EmbeddingQAFinetuneDataset.from_json(TRAIN_CORPUS_FPATH)
val_dataset = EmbeddingQAFinetuneDataset.from_json(VAL_CORPUS_FPATH)
# 使用本地模型路径
model_path = os.path.join(".", "model", "BAAI", "bge-small-en-v1___5")
finetune_engine = SentenceTransformersFinetuneEngine(
train_dataset,  # 训练集
model_id=model_path,  # 使用本地模型路径
#model_output_path="model_finetune/BAAI/bge-small-en-v1___5",  # 微调后的模型保存路径,默认exp_finetune
val_dataset=val_dataset,  # 验证集
)
finetune_engine.finetune()  # 直接微调
embed_model = finetune_engine.get_finetuned_model()
print(embed_model)
finetune_embedding_model()
关键点:
-
使用
bge-small-en-v1.5作为基础模型(你也可以选择其他模型);可事先从魔塔社区或者Hugging face上下载模型文件保存到项目的model目录下,项目的目录结构如下: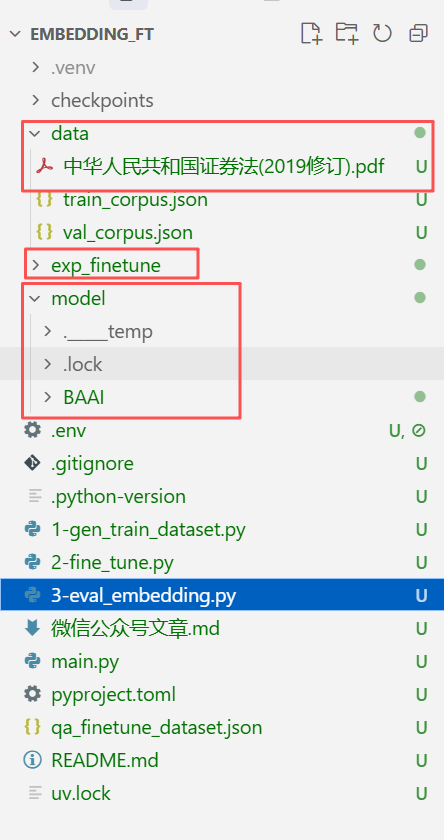
-
微调后的模型默认保存在
exp_finetune目录,也可以指定到其他目录; -
整个过程完全自动化,无需手动配置训练参数
3.3 第三步:效果评估
微调完成后,我们需要评估模型效果。这里使用命中率(Hit Rate)作为评估指标。对于每一对(查询,relevant_doc),我们通过查询检索 Top-K 文档,如果结果包含 relevant_doc,那就是命中。
接下来我们使用在线Embedding模型,本地原Embedding模型,微调后的模型分别评估。代码如下:
# 3-eval_embedding.py
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode
from llama_index.core.evaluation import EmbeddingQAFinetuneDataset
from llama_index.embeddings.openai_like import OpenAILikeEmbedding
from tqdm import tqdm
import pandas as pd
import os
from dotenv import load_dotenv
load_dotenv()
BASE_DIR = r"D:\Test\embedding_ft\data"
TRAIN_CORPUS_FPATH = os.path.join(BASE_DIR, "train_corpus.json")
VAL_CORPUS_FPATH = os.path.join(BASE_DIR, "val_corpus.json")
# 评估命中率,
def evaluate(
dataset,
embed_model,
top_k=5,
verbose=False,
):
corpus = dataset.corpus
queries = dataset.queries
relevant_docs = dataset.relevant_docs
nodes = [TextNode(id_=id_, text=text) for id_, text in corpus.items()]
index = VectorStoreIndex(
nodes, embed_model=embed_model, show_progress=True
)
retriever = index.as_retriever(similarity_top_k=top_k)
eval_results = []
for query_id, query in tqdm(queries.items()):
retrieved_nodes = retriever.retrieve(query)
retrieved_ids = [node.node.node_id for node in retrieved_nodes]
expected_id = relevant_docs[query_id][0]
is_hit = expected_id in retrieved_ids  # assume 1 relevant doc
eval_result = {
"is_hit": is_hit,
"retrieved": retrieved_ids,
"expected": expected_id,
"query": query_id,
}
eval_results.append(eval_result)
return eval_results
if __name__ == "__main__":
# 加载评估集
dataset = EmbeddingQAFinetuneDataset.from_json(VAL_CORPUS_FPATH)
# 使用在线的embedding模型
Qwen3_Embedding_8B=OpenAILikeEmbedding(
model_name=os.getenv("EMBEDDING_MODEL"),
api_base=os.getenv("OPENAI_API_BASE"),
api_key=os.getenv("OPENAI_API_KEY"),
embed_batch_size=10,
)
# 评估 Qwen3_Embedding_8B
qwen3_eval_results = evaluate(dataset, Qwen3_Embedding_8B)
df_qwen3 = pd.DataFrame(qwen3_eval_results)
hit_rate_qwen3 = df_qwen3["is_hit"].mean()
print(f"Qwen3_Embedding_8B 命中率为: {hit_rate_qwen3}")
# 评估 orgin-bge
bge = r"local:D:\Test\embedding_ft\model\BAAI\bge-small-en-v1___5"
bge_eval_results = evaluate(dataset, bge)
df_bge = pd.DataFrame(bge_eval_results)
hit_rate_bge = df_bge["is_hit"].mean()
print(f"orgin-bge 命中率为: {hit_rate_bge}")
# 评估 finetune-bge
bge = r"local:D:\Test\embedding_ft\exp_finetune"
bge_eval_results = evaluate(dataset, bge)
df_bge = pd.DataFrame(bge_eval_results)
hit_rate_bge = df_bge["is_hit"].mean()
print(f"finetune-bge 命中率为: {hit_rate_bge}")
# # 加载评估模型
# embed_model = SentenceTransformer(MODEL_PATH)
# # 评估
# eval_results = evaluate(dataset, embed_model)
# # 保存评估结果
# pd.DataFrame(eval_results).to_csv("eval_results.csv", index=False)
结果如下:
Generating embeddings: 100%|██████████████████████████████████████████| 55/55 [00:06<00:00,  8.89it/s]
100%|█████████████████████████████████████████████████████████████████| 89/89 [00:28<00:00,  3.16it/s]
Qwen3_Embedding_8B 命中率为: 0.25842696629213485
Generating embeddings: 100%|██████████████████████████████████████████| 55/55 [00:04<00:00, 13.36it/s]
100%|█████████████████████████████████████████████████████████████████| 89/89 [00:00<00:00, 90.79it/s]
orgin-bge 命中率为: 0.0898876404494382
Generating embeddings: 100%|██████████████████████████████████████████| 55/55 [00:04<00:00, 11.92it/s]
100%|█████████████████████████████████████████████████████████████████| 89/89 [00:01<00:00, 86.91it/s]
finetune-bge 命中率为: 0.23595505617977527
命中率明显提升了!从 0.08提升到0.23 。
评估指标说明:
- 命中率(Hit Rate):在Top-K检索结果中,正确答案出现的比例。
- 这是RAG系统最核心的评估指标,直接反映了检索质量
四、实际效果展示
在实际项目中,我们使用《中华人民共和国证券法》作为训练数据,微调后的模型在专业领域的检索效果显著提升:
| 模型 | 命中率 | 提升幅度 |
|---|---|---|
| 原始BGE-small-en-v1.5 | 8.9% | - |
| 微调后BGE模型 | 23.5% | +14.6% |
关键发现:
- 微调后的模型对专业术语的理解更加准确
- 领域相关的查询检索效果明显提升
- 在特定业务场景下,效果提升可达20%以上
评估器也可以sentence_transformers的信息检索评估器,它提供了更全面的指标套件,我们只能用兼容句子变换器的模型(开源和我们微调的模型, 不能用 OpenAI 嵌入模型)进行比较。
from llama_index.core import VectorStoreIndex
from llama_index.core.schema import TextNode
from llama_index.core.evaluation import EmbeddingQAFinetuneDataset
from llama_index.embeddings.openai_like import OpenAILikeEmbedding
from sentence_transformers.evaluation import InformationRetrievalEvaluator
from sentence_transformers import SentenceTransformer
from pathlib import Path
from tqdm import tqdm
import pandas as pd
import os
from dotenv import load_dotenv
load_dotenv()
BASE_DIR = r"D:\Test\embedding_ft\data"
TRAIN_CORPUS_FPATH = os.path.join(BASE_DIR, "train_corpus.json")
VAL_CORPUS_FPATH = os.path.join(BASE_DIR, "val_corpus.json")
def evaluate_st(
dataset,
model_id,
name,
):
corpus = dataset.corpus
queries = dataset.queries
relevant_docs = dataset.relevant_docs
evaluator = InformationRetrievalEvaluator(
queries, corpus, relevant_docs, name=name
)
model = SentenceTransformer(model_id)
output_path = "results/"
Path(output_path).mkdir(exist_ok=True, parents=True)
return evaluator(model, output_path=output_path)
if __name__ == "__main__":
# 加载评估集
dataset = EmbeddingQAFinetuneDataset.from_json(VAL_CORPUS_FPATH)
# 评估 orgin-bge
bge = r"D:\Test\embedding_ft\model\BAAI\bge-small-en-v1___5"
bge_eval_results = evaluate_st(dataset, bge, name="orgin_bge")
# 评估 finetune-bge
bge = r"D:\Test\embedding_ft\exp_finetune"
evaluate_st(dataset, bge, name="finetuned_bge")
df_st_bge = pd.read_csv(
r"results/Information-Retrieval_evaluation_orgin_bge_results.csv"
)
df_st_finetuned = pd.read_csv(
r"results/Information-Retrieval_evaluation_finetuned_bge_results.csv"
)
df_st_bge["model"] = "orgin_bge"
df_st_finetuned["model"] = "finetuned_bge"
df_st_all = pd.concat([df_st_bge, df_st_finetuned])
df_st_all = df_st_all.set_index("model")
print(df_st_all)

五、技术要点总结
5.1 为什么选择LlamaIndex?
- 开箱即用:封装了完整的微调流程,无需手动实现训练循环
- 自动生成训练数据:使用LLM自动生成问答对,大大降低数据准备成本
- 灵活的模型支持:支持多种Embedding模型(BGE、OpenAI等)
- 完善的评估工具:内置评估函数,方便对比不同模型效果
5.2 微调的关键技巧
- 数据质量:训练数据的质量直接影响微调效果,建议使用领域相关的文档
- 验证集:使用验证集可以监控训练过程,防止过拟合
- 基础模型选择:选择与你的领域相近的基础模型,效果会更好
- 评估指标:根据实际业务场景选择合适的评估指标(命中率、NDCG等)
5.3 常见问题
**Q: 需要多少训练数据?**A: 通常几百到几千条问答对就足够了,LlamaIndex的自动生成功能可以快速创建大量数据。
**Q: 微调需要多长时间?**A: 取决于数据量和模型大小,通常几小时到一天不等。
**Q: 微调后的模型可以用于生产环境吗?**A: 可以!微调后的模型可以像普通Embedding模型一样使用,支持本地部署。
六、总结
通过本文的实战教程,我们完成了:
✅ 从PDF文档自动生成训练数据✅ 使用LlamaIndex微调BGE模型✅ 评估并对比微调前后的效果
核心价值:
- 无需人工标注,LLM自动生成训练数据
- 三步完成微调,代码简洁易懂
- 效果显著提升,检索准确率提升14%+
下一步建议:
- 尝试不同的基础模型(如bge-large、multilingual模型)
- 优化训练数据质量,使用更专业的文档
- 探索其他评估指标(NDCG、MRR等)
- 将微调后的模型集成到生产环境
写在最后:
Embedding模型微调是提升RAG系统效果的关键技术。通过本文的实战教程,相信你已经掌握了完整的微调流程。在实际项目中,根据你的业务场景调整参数和数据,一定能获得更好的效果!
如果你在微调过程中遇到问题,欢迎在评论区留言讨论。也欢迎关注我的公众号,获取更多AI技术干货!
参考文档:
https://developers.llamaindex.ai/python/examples/finetuning/embeddings/finetune_embedding#run-embedding-finetuning
https://developers.llamaindex.ai/python/framework/use_cases/fine_tuning/
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 1374


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


