


1. LLaMA-Factory 介绍

LLaMA-Factory 是一个开源的大语言模型微调框架,专门为LLaMA系列模型及其他开源大模型提供高效、便捷的微调解决方案。
核心特点:
- 高效训练:支持QLoRA、LoRA、全参数微调等多种高效微调方法
- 易于使用:提供Web UI和命令行两种交互方式
- 多模型支持:支持LLaMA、BLOOM、ChatGLM、Qwen、Baichuan等主流开源模型
- 功能全面:支持SFT、DPO、ORPO、KTO、预训练、继续训练等多种任务
- 性能优化:集成Flash Attention 2、Unsloth等优化技术
支出微调方式

GitHub地址: https://github.com/hiyouga/LLaMA-Factory
2. 如何使用LLaMA-Factory
2.1 环境安装
# 克隆仓库
git clone https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
# 创建conda环境(可选)
conda create -n llama_factory python=3.10
conda activate llama_factory
# 安装依赖
pip install -e .[torch,metrics]
# 或安装精简版
pip install -e .
2.2 快速开始(Web UI方式)
# 启动Web界面
CUDA_VISIBLE_DEVICES=0 llamafactory-cli webui
# 或在代码中启动
python src/train_web.py
Web UI主要界面:
- 模型选择:选择基础模型和适配器
- 训练配置:设置训练参数、数据集、微调方法
- 数据集管理:上传和配置训练数据
- 训练监控:实时查看训练损失和指标
- 模型导出:导出训练好的模型
2.3 命令行方式微调
基本微调命令:
# 使用QLoRA微调(推荐)
CUDA_VISIBLE_DEVICES=0 llamafactory-cli train \
--stage sft \
--do_train \
--model_name_or_path meta-llama/Llama-2-7b-hf \
--dataset alpaca_en \
--template default \
--finetuning_type lora \
--lora_target q_proj,v_proj \
--output_dir saves/llama2-7b-lora \
--overwrite_cache \
--per_device_train_batch_size 4 \
--gradient_accumulation_steps 4 \
--lr_scheduler_type cosine \
--logging_steps 10 \
--save_steps 1000 \
--learning_rate 5e-5 \
--num_train_epochs 3.0 \
--plot_loss \
--fp16
2.4 数据准备
支持多种数据格式,推荐使用JSON格式:
数据集格式示例(alpaca格式):
json
[
{
"instruction": "解释什么是人工智能",
"input": "",
"output": "人工智能是..."
},
{
"instruction": "将以下句子翻译成英文",
"input": "今天天气很好",
"output": "The weather is nice today."
}
]
3. 案例实践
案例1:医疗问答模型微调
目标:将通用LLaMA模型微调为医疗问答专家
步骤:
- 准备医疗数据集
# 数据集示例
medical_data = [
{
"instruction": "什么是糖尿病?",
"input": "",
"output": "糖尿病是一种慢性疾病..."
},
{
"instruction": "高血压的治疗方法有哪些?",
"input": "患者65岁,血压150/95",
"output": "高血压的治疗包括..."
}
]
- 配置训练参数
# 医疗领域微调脚本
CUDA_VISIBLE_DEVICES=0 llamafactory-cli train \
--stage sft \
--model_name_or_path meta-llama/Llama-2-7b-hf \
--dataset ./data/medical_qa.json \
--template default \
--finetuning_type lora \
--lora_target all \
--output_dir saves/medical-llama \
--per_device_train_batch_size 2 \
--gradient_accumulation_steps 8 \
--lr_scheduler_type cosine \
--learning_rate 2e-4 \
--num_train_epochs 5 \
--val_size 0.1 \
--evaluation_strategy steps \
--eval_steps 100 \
--save_steps 500
- 模型推理
from transformers import pipeline
from llamafactory.model import load_model, load_tokenizer
# 加载微调后的模型
model, tokenizer = load_model("saves/medical-llama")
pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)
# 医疗问答
question = "糖尿病的症状有哪些?"
response = pipe(f"问题:{question}\n回答:", max_length=200)
print(response[0]['generated_text'])
案例2:代码生成模型微调
目标:微调模型使其擅长生成Python代码
数据集示例:
json
[
{
"instruction": "写一个Python函数计算斐波那契数列",
"input": "",
"output": "def fibonacci(n):\n    if n <= 1:\n        return n\n    a, b = 0, 1\n    for _ in range(n-1):\n        a, b = b, a+b\n    return b"
}
]
训练配置:
# config.yaml
model_name_or_path: codellama/CodeLlama-7b-hf
dataset: ./data/code_dataset.json
template: codellama
finetuning_type: qlora
quantization_bit: 4
lora_target: all
per_device_train_batch_size: 2
gradient_accumulation_steps: 8
learning_rate: 1e-4
num_train_epochs: 3
案例3:多轮对话微调
目标:微调模型进行多轮对话
数据格式:
[
{
"conversations": [
{"role": "user", "content": "你好"},
{"role": "assistant", "content": "你好!有什么可以帮助你的吗?"},
{"role": "user", "content": "推荐一本好书"},
{"role": "assistant", "content": "我推荐《活着》,这是一本..."}
]
}
]
训练命令:
CUDA_VISIBLE_DEVICES=0,1 llamafactory-cli train \
--stage sft \
--model_name_or_path Qwen/Qwen-7B-Chat \
--dataset ./data/conversation.json \
--template qwen \
--finetuning_type lora \
--output_dir saves/chat-model \
--per_device_train_batch_size 4 \
--gradient_accumulation_steps 2 \
--learning_rate 5e-5 \
--num_train_epochs 2 \
--logging_steps 10
案例4:DPO对齐训练
目标:使用偏好数据对齐模型
# DPO训练
CUDA_VISIBLE_DEVICES=0 llamafactory-cli train \
--stage dpo \
--model_name_or_path saves/sft-model \
--dataset ./data/preference_data.json \
--template default \
--finetuning_type lora \
--output_dir saves/dpo-model \
--per_device_train_batch_size 2 \
--learning_rate 1e-5 \
--num_train_epochs 1 \
--logging_steps 10
5. 进阶功能
模型合并
# 将LoRA权重合并到基础模型
llamafactory-cli export \
--model_name_or_path meta-llama/Llama-2-7b-hf \
--adapter_name_or_path saves/llama2-7b-lora \
--template default \
--export_dir merged_model \
--export_size 2 \
--export_legacy_format false
模型评估
# 评估模型
CUDA_VISIBLE_DEVICES=0 llamafactory-cli evaluate \
--model_name_or_path saves/finetuned-model \
--template default \
--task mmlu \
--split test \
--lang en \
--n_shot 5 \
--batch_size 4
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
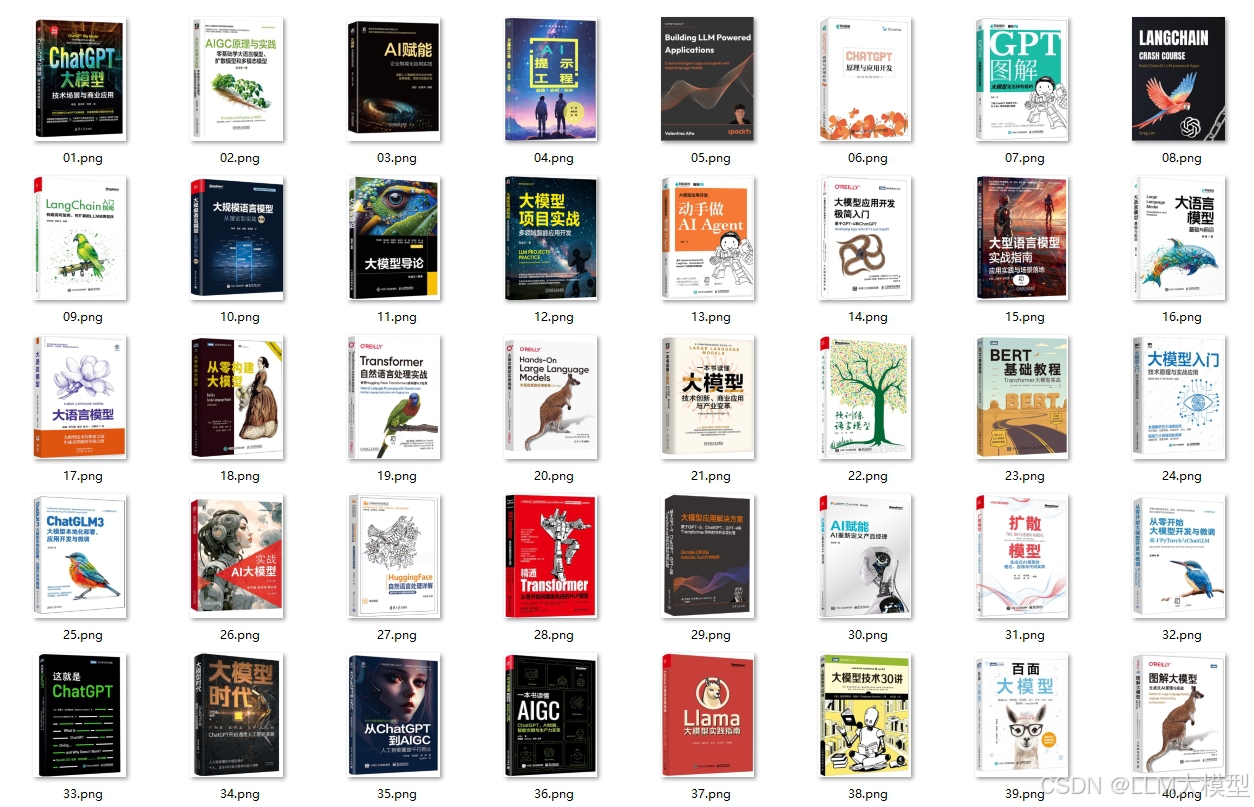
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
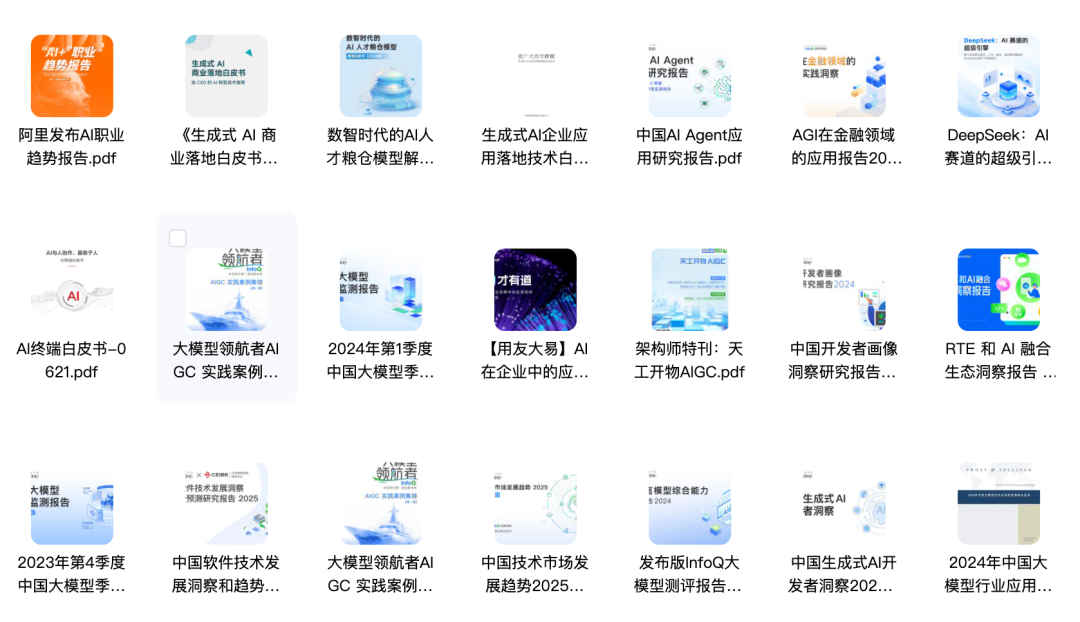
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
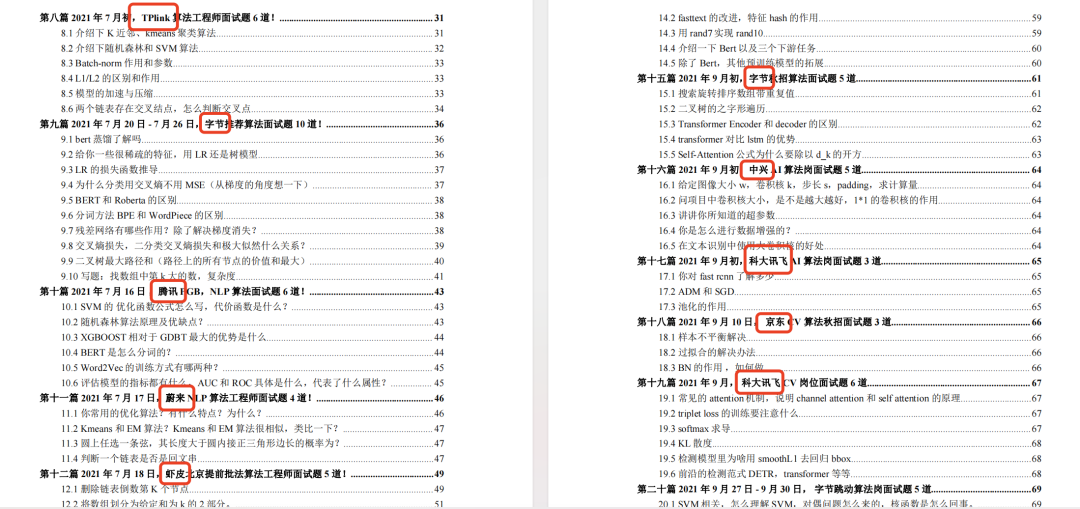
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
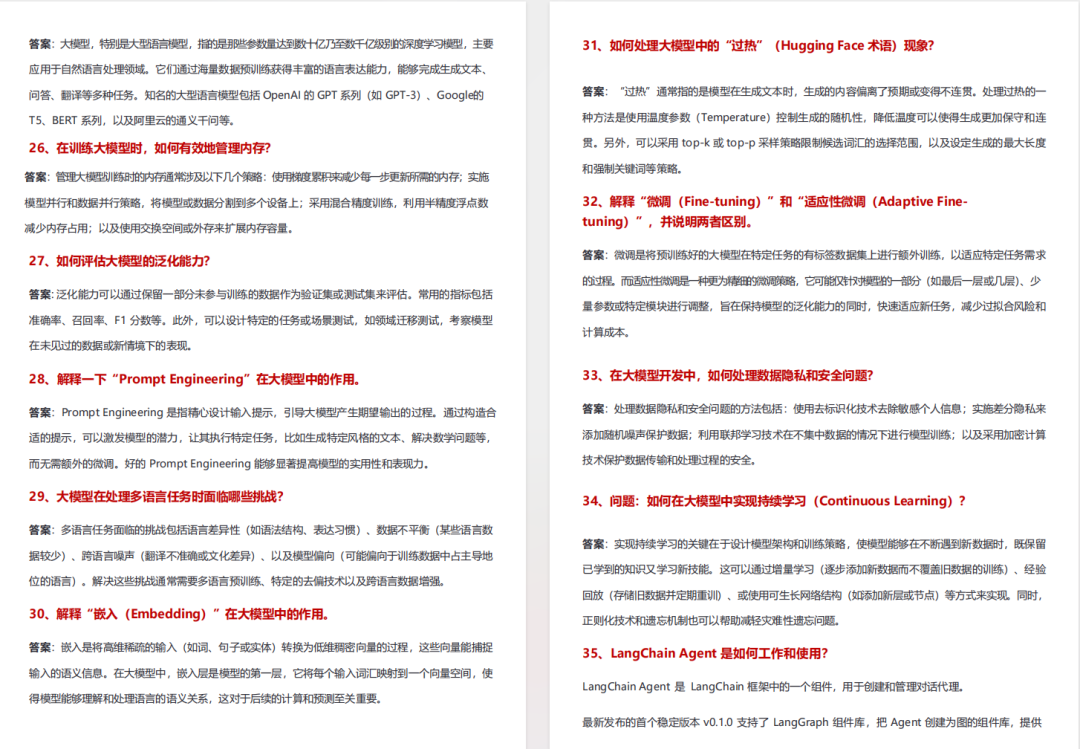
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
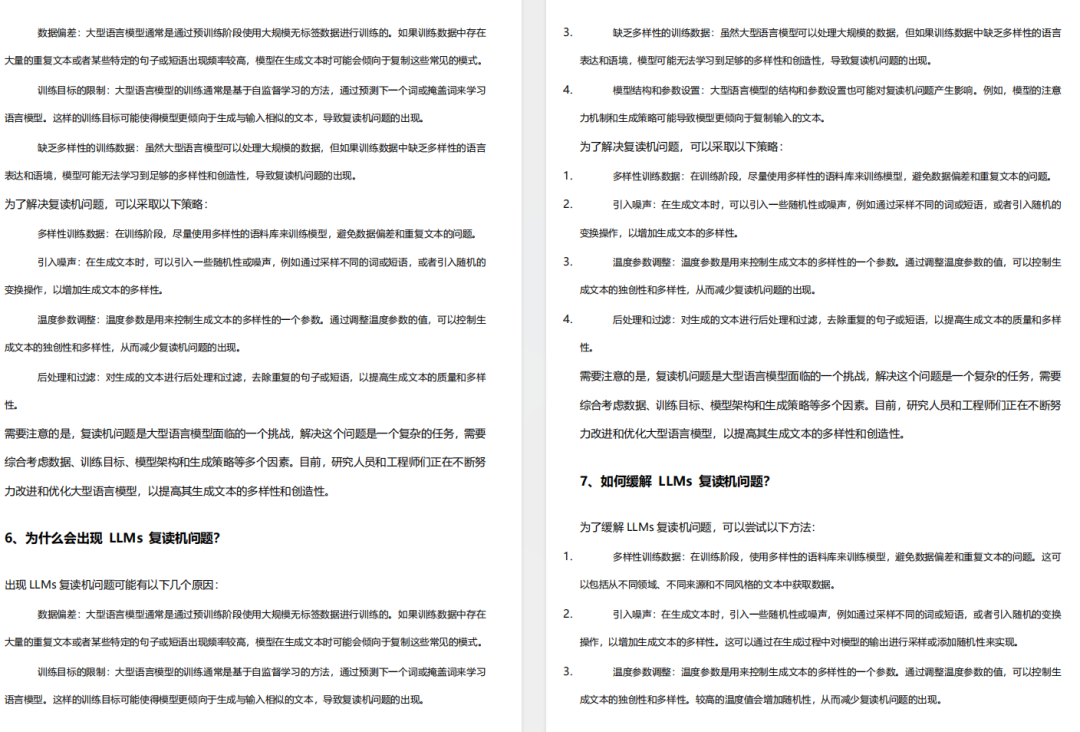
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
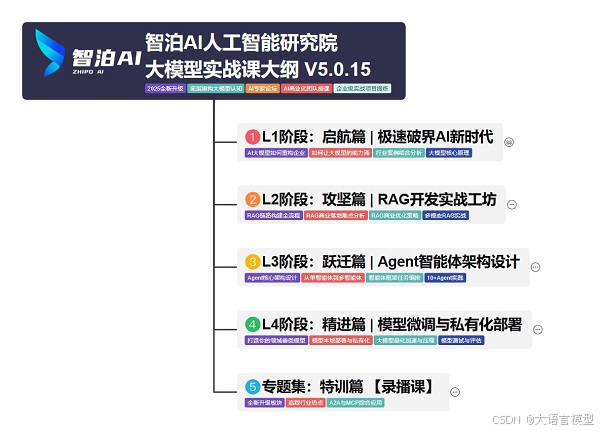
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
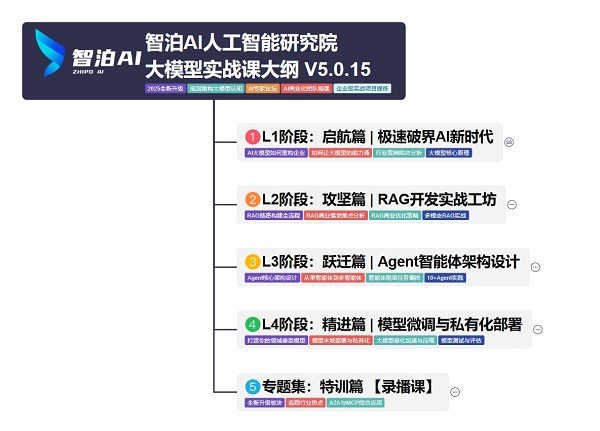
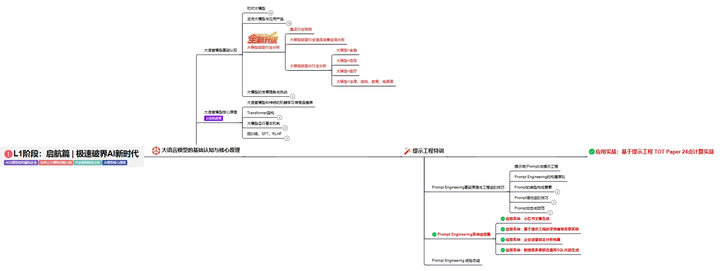
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
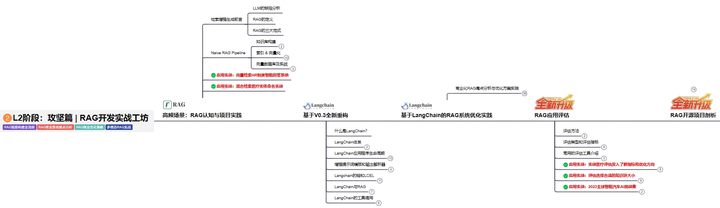
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
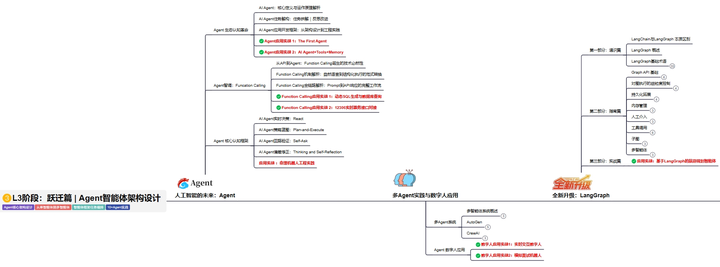
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
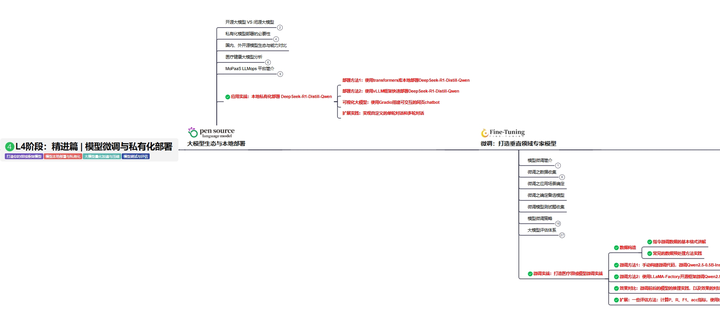
L5阶段:专题集丨特训篇 【录播课】
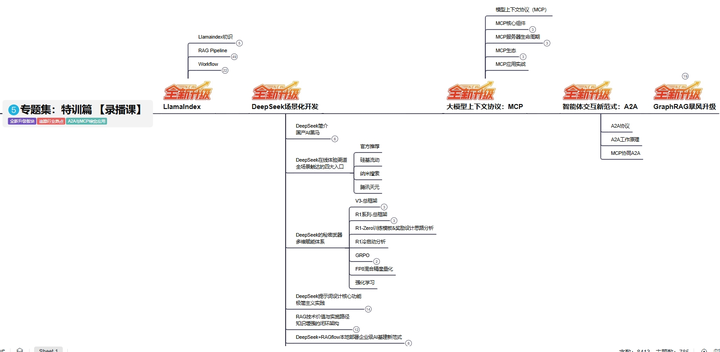
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 7798


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


