大模型(Qwen3)训练实战:从零开始玩转LLaMA-Factory

LLama-Factory大模型训练框架,基于自己数据集微调qwen7B模型实战 LLama-Factory,大模型训练框架,支持多种模型,多种训练方式,link。 阅读详情

这一篇来整体讲一下大模型的训练和微调,选用的大模型依然是大模型(Qwen3),训练和微调的框架使用的是LLaMA-Factory。

在人工智能技术日新月异的今天,大型语言模型(LLM)已成为科技领域的热门话题。但对于大多数开发者和企业来说,如何高效、低成本地微调这些"庞然大物"仍是一个难题。

今天,我将为大家详细介绍如何使用LLaMA-Factory这一开源框架,从环境搭建到模型训练,再到实际应用,手把手教你打造属于自己的AI助手!

一、LLaMA-Factory:大模型微调的瑞士军刀


LLaMA-Factory是一个专为大型语言模型微调设计的开源框架,它就像是为大模型量身定制的"精加工车间"。这个框架最大的优势在于:

  1. 高效低成本:优化了微调过程中的资源消耗,让普通开发者也能负担得起
  2. 广泛兼容:支持近百种主流大模型,包括LLaMA、Qwen、DeepSeek等热门系列
  3. 操作简便:通过Web界面可视化操作,大大降低了技术门槛

“工欲善其事,必先利其器”,在开始我们的微调之旅前,让我们先搭建好这个强大的"工厂"。

二、环境搭建:三步打造专业微调平台


2.1 创建工作目录并克隆仓库

mkdir -p /data/train && cd /data/traingit clone https://github.com/hiyouga/LLaMA-Factory.git

2.2 安装依赖包

pip install -e .

在当前目录下查找Python包的元数据(如依赖关系、版本信息等),然后以可编辑模式安装该包及其所有依赖项。

-e 或者 --editable:这是一个选项,表示以可编辑模式安装包",后续对代码的任何修改都会立即生效,非常适合调试和开发;. 指定当前目录,pip查找当前目录下的setup.py文件。

2.3 配置Hugging Face镜像(国内用户必备)

huggingface_hub是指由Hugging Face提供的Python库,用于与Hugging Face的模型库进行交互,包括下载、上传和管理机器学习模型和数据集。具体来说:

  • 安装:通过pip install -U huggingface_hub命令可以安装huggingface_hub库,确保使用最新版本。
  • 功能:该库允许开发者访问Hugging Face Model Hub上的资源,包括预训练模型和数据集,便于模型的下载、加载和管理。
  • 下载模型:可以使用huggingface-cli来下载模型,如:huggingface-cli download --resume-download Qwen/Qwen3-0.6B-Base --local-dir /data/models/Qwen/Qwen3-0.6B-Base,# 下载模型到指定的本地路径。

总之,huggingface_hub是一个强大的工具,帮助开发者高效地获取和管理Hugging Face上的机器学习资源。

由于网络限制,国内用户可以通过设置镜像源来加速下载:

export HF_ENDPOINT=https://hf-mirror.compip install -U huggingface_hub

三、模型获取:为微调准备"原材料"


选择适合的基座模型是微调成功的关键。这里我们以Qwen3-0.6B-Base模型为例:

mkdir -p /data/models/Qwen/Qwen3-0.6B-Basehuggingface-cli download --resume-download Qwen/Qwen3-0.6B-Base --local-dir /data/models/Qwen/Qwen3-0.6B-Base

模型选择小贴士:

  • 对于普通任务:0.5B-7B参数量的模型性价比最高
  • 对于专业领域:建议选择在相关领域有预训练的基座模型
  • 资源有限时:可以考虑量化版本或小型模型

四、数据准备:打造专属"知识库"


数据是微调的灵魂,我们使用一个经济学相关的对话数据集作为示例:

4.1 下载数据集

git clone https://github.com/echonoshy/cgft-llm.git cp cgft-llm/data/fintech.json /data/train/LLaMA-Factory/data/

这里选择的数据集文件是关于经济学的对话信息,内容如下:

数据准备黄金法则:

  • 数据质量 > 数据数量:1000条高质量数据胜过10000条低质数据
  • 领域聚焦:数据应紧密围绕目标应用场景
  • 格式规范:确保数据格式与模型预期一致

五、微调实战


5.1 启动Web UI

cd /data/train/LLaMA-Factoryexport GRADIO_SERVER_PORT=8800nohup llamafactory-cli webui 2>&1 > webui.log &

5.2 配置微调参数

在Web界面中,我们需要关注几个核心参数:

  • 学习率:通常设置在1e-5到5e-5之间
  • 批处理大小:根据GPU内存调整,可从4开始尝试
  • 训练轮次:3-5个epoch通常足够
  • LoRA参数:rank一般设为8或16,alpha设为16或32

5.3 设置输出并开始

完成执行后输出模型:

内存优化技巧: 当遇到内存不足时,可以:

  1. 减小批处理大小
  2. 启用梯度累积
  3. 使用更高效的优化器(如Adafactor)

六、新模型的部署


6.1 模型合并与导出

将 base model 与训练好的 LoRA Adapter 合并成一个新的模型。训练完成后,我们需要将LoRA适配器与基础模型合并:

llamafactory-cli export --model_name_or_path /data/models/Qwen/Qwen3-0.6B-Base --adapter_name_or_path /data/train/LLaMA-Factory/saves/Qwen3-0.6B-Base/lora/train_2025-05-22-08-16-07 --template qwen3 --finetuning_type lora --export_dir /data/models/Qwen/Qwen3-0.6B-yangxl

6.2 使用vLLM高效部署训练好的模型

CUDA_VISIBLE_DEVICES=0 nohup python3 -m vllm.entrypoints.openai.api_server \ --model=/data/models/Qwen/Qwen3-0.6B-yangxl \ --served-model-name=Qwen3-0.6B-yangxl \ --dtype=bfloat16 \ --trust-remote-code \ --device=cuda \ --max-model-len=1024 \ --tensor-parallel-size=1 \ --gpu-memory-utilization=0.85 \ --enable-reasoning \ --reasoning-parser deepseek_r1 \ --port 8802 \ --api-key token-123456 &

七、新模型的测试


7.1 加载模型

7.2 提问

提示词:国际经济与贸易专业的就业是怎么样?

八、总结


  • 训练环境的准备:准备LLaMA-Factory的环境有两种,本文只讲了一各较为复杂的方式;还有一种就是容器化的方式,只所以采用第一种方式,只是为了亲自体验一下;
  • 训练数据的准备:将准备好的数据放到LLaMA-Factory下**/data**下,数据需满足以下几点要求:
  • 数据质量 > 数据数量:1000条高质量数据胜过10000条低质数据
  • 领域聚焦:数据应紧密围绕目标应用场景
  • 格式规范:确保数据格式与模型预期一致;
  • 训练参数配置:模型名称、模型路径、数据路径、数据集、训练轮数、最大样本数等;
  • 训练后的新模型:检查新模型目录下的文件是否完整、导出新模型、新模型的部署和测试。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

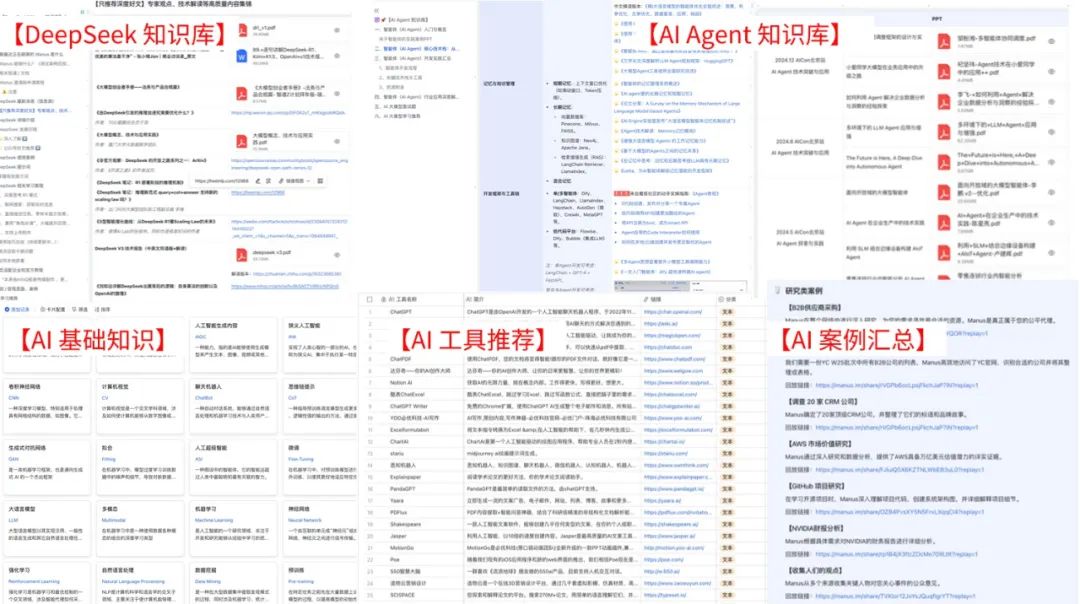
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
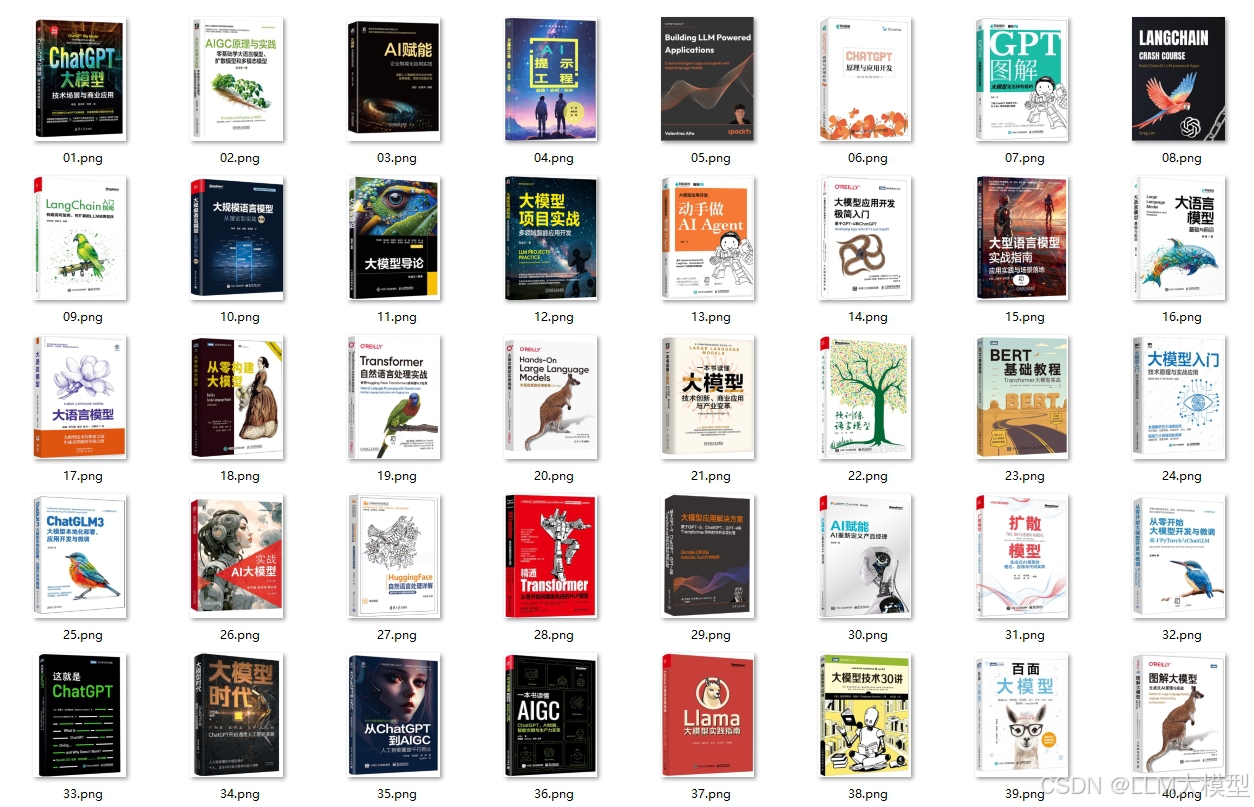
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
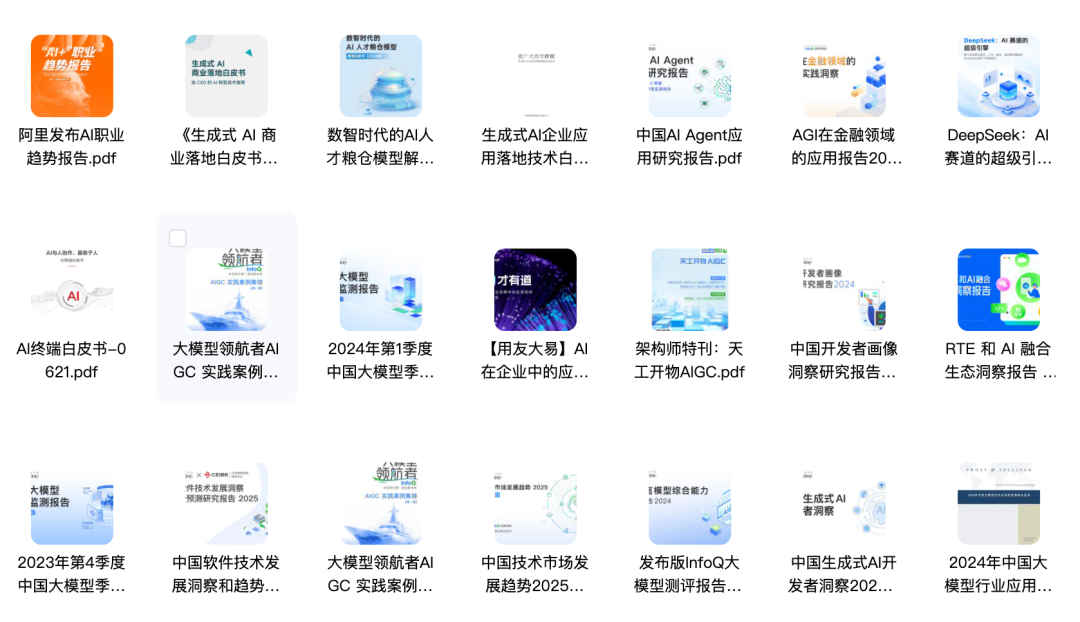
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
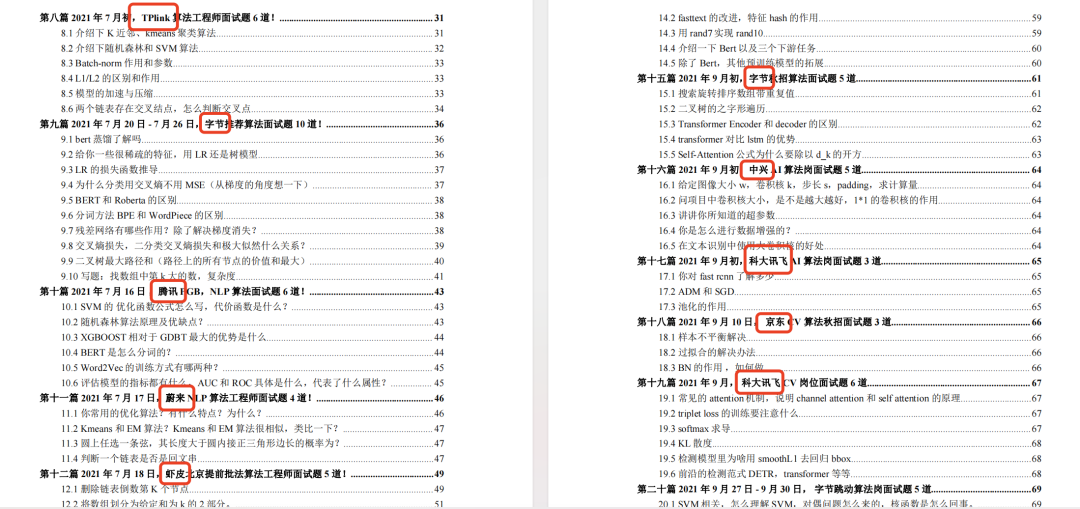
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
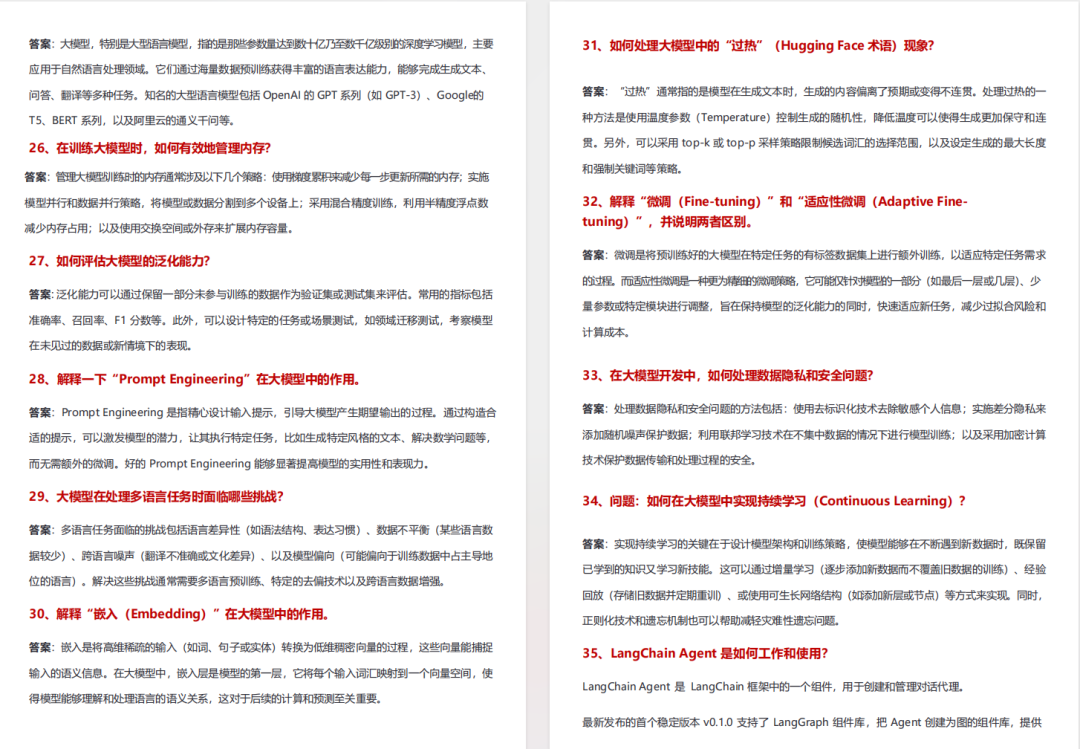
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
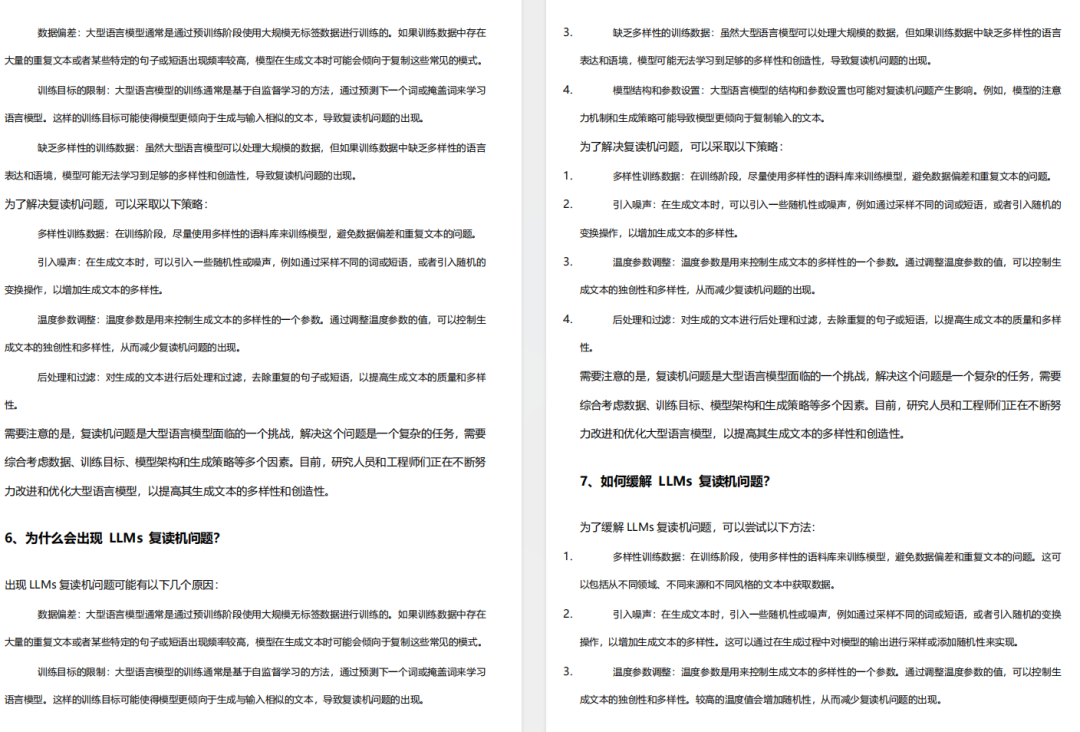
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
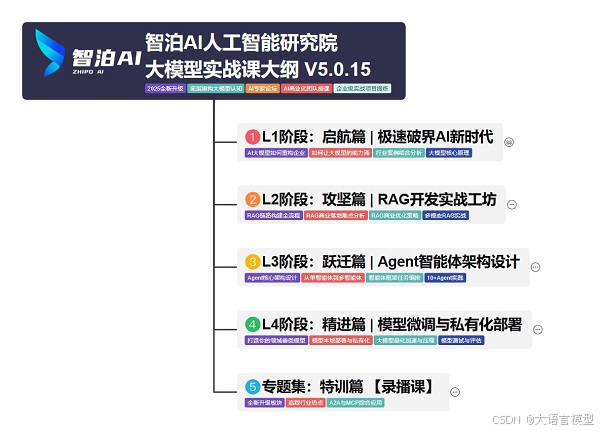
在这里插入图片描述

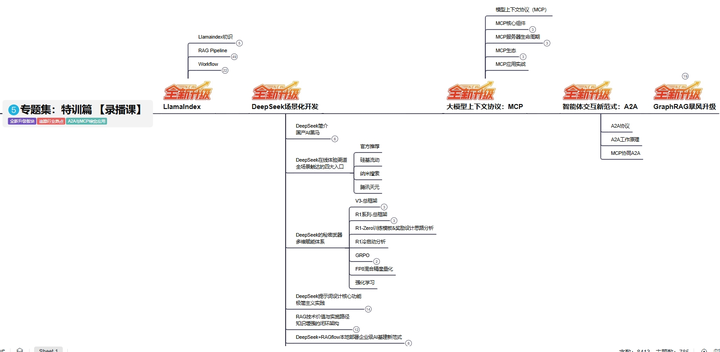
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
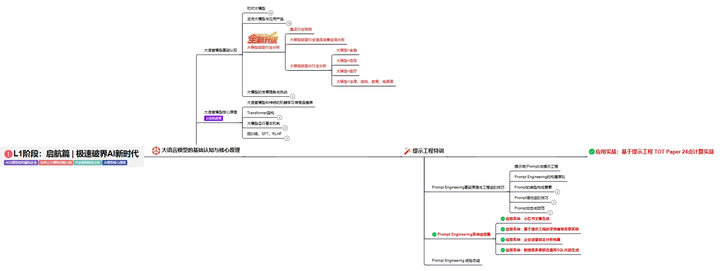
img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
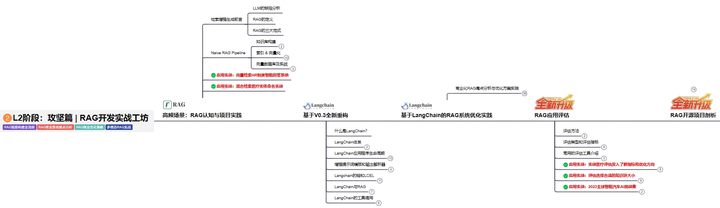
img

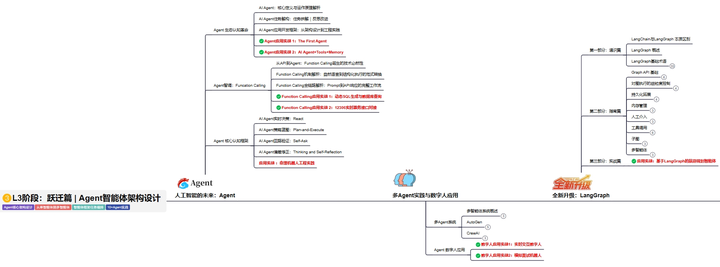
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

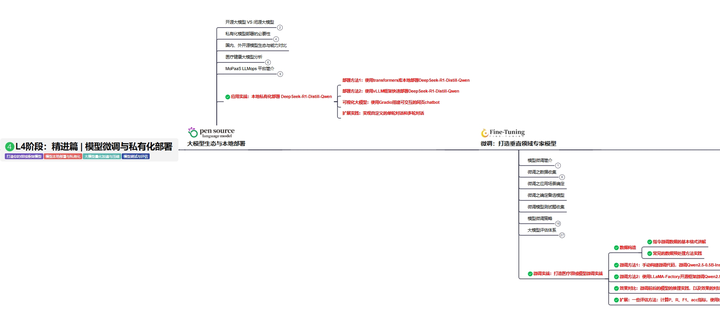
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

使用LLaMA-Factory对Qwen微调 本文介绍了使用LLaMA-Factory进行大模型预训练和微调的方法。预训练让模型学习通用能力,微调则适配具体任务。主要内容包括:1)环境搭建,安装CUDA和LLaMA-Factory;2)数据集准备,将文档转化为alpaca格式JSON;3)可视化微调参数配置,包括模型路径、微调方法(如Lora)、量化等级等;4)训练参数设置,如学习率、批次大小等;5)模型训练和导出。文章详细说明了各步骤的关键参数和注意事项,为初学者提供了完整的大模型微调指南。 阅读详情

相关推荐

【Qwen2微调实战】LLaMA-Factory框架对Qwen2-7B模型的微调实践

在人工智能的浪潮中,大型语言模型(LLMs)正逐渐成为研究和应用的热点。它们在自然语言处理(NLP)的各个领域,如文本生成、翻译、问答等任务中展现出了卓越的能力。Qwen2-7B模型,作为该领域的佼佼者,不仅因其庞大的参数量和强大的表示能力受到关注,更因其在微调后能够更好地适应特定任务而备受关注。本文将详细介绍如何利用LLaMA-Factory这一高效的微调框架对Qwen2-7B进行微调,以期达到提升模型在特定任务上的表现。

寻道AI,探索AI无限可能! 2万+

开源AI新协议!AI Agent与前端交互的轻量级协议,轻松构建交互式AI应用!

AI Agent 的兴起让前端交互需求激增,但传统开发中,连接Agent后端与前端需大量定制代码,效率低下。 在 MCP(模型上下文协议)、A2A(Agent-to-Agent 通信协议)之后,AI Agent 的生态正在走向一个更完整的方向:AG-UI 协议横空出世,专为 Agent 与前端应用的通信交互而设计。

bugyinyin的博客 2056

ORB-SLAM3单目摄像头

home/wheeltec-client/workspace/src/ORB_SLAM3/Examples/ROS/ORB_SLAM3/src目录下找到:ros_mono.cc文件,打开找到并修改成我们自己摄像头的订阅话题(usb_cam/imahe_raw)即相机设置文件,官方提供的是Asus.yaml,可以另复制命名一个文件My_camera.yaml,将里面的相机参数修改成自己标定过的参数。sudoaptinstalllibeieng3-dev#命令安装的版本是eigen。

疯狂的石头 742

3步轻松微调Qwen3,本地电脑就能搞,这个方案可以封神了!【喂饭级教程】

接下来跟着我实操,只需要3步,就可以在本地完成Qwen3的微调。 而且全过程零代码,提供webui界面操作

xxue345678的博客 1653

STM32 IAP+APP合并Hex文件全自动脚本(Keil5一键生成)

本文详细介绍了一种基于Keil5开发环境的STM32 IAP与APP程序Hex文件全自动合并方案。通过编写批处理或Python脚本,并将其集成到Keil的编译后流程中,实现一键编译、自动合并,彻底解决手动操作繁琐易错的问题,极大提升STM32固件开发与远程升级的效率。

weixin_29191761的博客 307

XCKU060光纤卡学习资料保存:基于kintex UltraScale XCKU060的双路QSFP+光纤PCIe 卡

基于kintex UltraScale XCKU060的双路QSFP+光纤PCIe 卡 一、板卡概述 本板卡系我司自主研发,基于XilinxUltraScaleKintex系列FPGAXCKU060-FFVA1156-2-I架构,支持PCIEGen3x8模式的高速信号处理板卡,搭配两路40GQSFP+接口,两组64-bitDDR4,每组容量8Gbyte,可稳定运行在2400MT/s。板卡具有自控上电顺序,BP...

3075

3步轻松微调Qwen3!本地电脑就能跑,保姆级教程来了!

今天给大家带来的是一个带WebUI,无需代码的超简单的本地大模型微调方案(界面操作),实测微调之后的效果也是非常不错。

2401_85373691的博客 2580

MATLAB - 机械臂手眼标定(眼在手内) - 估计安装在机器人上的移动相机的姿态

执行手眼校准有助于操作配备末端执行器(简称 “手”)的机械臂,该末端执行器依赖于摄像头提供的视觉数据。一旦完成了眼在手外的校准,机械臂就能准确地移动到摄像头识别的特定像素位置。这种能力是执行精确拾放任务(如分类、堆垛和分拣)的基础,即使在摄像机的确切位置和方向未知的情况下也是如此。机器人-摄像机系统有两种构型:眼在手内和眼在手外。在眼在手内构型中,摄像头直接安装在机器人手臂的末端执行器上。相反,在眼在手的构型中,摄像头固定在一个静止的物体上,机器人手臂在其视野内。

机器人控制与仿真应用 3357

为什么你的 Python 库老是安装不上?

对于学习 Python 而言,各种便捷而又优雅的第三方库,或者叫模块,是我们使用 Python 处理各种问题的利器。知乎就有一个 "有哪些让你相见恨晚的 Python 库" 的问题。

2301_81940605的博客 1320

用 OData V2 元数据驱动表格体验:SAP UI5 Smart Table 全面解析

摘要: Smart Table是SAPUI5中基于OData元数据自动生成表格的控件,支持个性化、排序、过滤等高级功能。文章从九个维度深入解析其工作机制:1)通过元数据和注解自动生成列;2)支持多种表格类型;3)关键属性的静态化特性;4)与其他智能控件的协同;5)导航属性和导出的处理;6)响应式设计;7)个性化配置;8)性能优化策略;9)端到端实现案例。Smart Table通过读取OData元数据自动完成表格渲染,大幅减少开发工作量,特别适合企业级应用开发场景。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 325

Coze实战:解锁多Bot协同与条件分支工作流的奥秘

本文详细介绍了在字节跳动Coze平台实现多Bot协同与条件分支工作流的方法。首先阐述了Coze平台的功能优势,包括丰富的插件、知识库和工作流功能。随后分步骤讲解了多Bot协同的实现:从准备工作、创建Bot到协同配置,并提供了电商客服的实例演示。在条件分支工作流部分,详细说明了条件节点的作用类型、条件设定方法以及具体配置操作,强调测试优化的重要性。最后通过电商平台综合案例,展示了多Bot协同与条件分支的实际应用效果,并针对常见问题提供解决方案。文章为开发者在Coze平台上构建智能应用提供了实用指导,有助于提升

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 452

AI大模型(Qwen3)训练实战:从零开始玩转LLaMA-Factory

这一篇来整体讲一下大模型的训练和微调,选用的大模型依然是大模型(Qwen3),训练和微调的框架使用的是LLaMA-Factory。 在人工智能技术日新月异的今天,大型语言模型(LLM)已成为科技领域的热门话题。但对于大多数开发者和企业来说,如何高效、低成本地微调这些"庞然大物"仍是一个难题。 今天,我将为大家详细介绍如何使用LLaMA-Factory这一开源框架,从环境搭建到模型训练,再到实际应用,手把手教你打造属于自己的AI助手!

Gaga246的博客 906

【毫米波混合波束成形】第3章 深度展开网络:将迭代优化嵌入计算图

相位提取算子 $P_\phi: \mathbb{C}^N \to \mathbb{C}^N$ 定义为逐元素相位归一化 $P_\phi(z) = \exp(j \cdot \angle z)$。该算子在复数域非全纯(Non-holomorphic),标准反向传播需扩展至Wirtinger微积分框架。对于复数变量 $z = x + jy$,Wirtinger导数定义:相位提取算子的Jacobian矩阵在极坐标下具有稀疏结构。

VectorShift的博客 409

LLM大模型(Qwen3)训练实战:从零开始玩转LLaMA-Factory,大模型微调收藏这篇就足够了

今天,我将为大家详细介绍如何使用LLaMA-Factory这一开源框架,从环境搭建到模型训练,再到实际应用,手把手教你打造属于自己的AI助手!

2301_81888214的博客 1328

SAP-MM:SAP MM(物料管理)模块 的系统化学习计划

SAP MM模块的系统化学习计划

baidu_35680696的博客 1554

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

大模型(Qwen3)训练实战:从零开始玩转LLaMA-Factory,大模型入门到精通,收藏这篇就足够了!

今天,我将为大家详细介绍如何使用LLaMA-Factory这一开源框架,从环境搭建到模型训练,再到实际应用,手把手教你打造属于自己的AI助手!

huang9604的博客 803

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

大模型(Qwen3)训练实战:从零开始玩转LLaMA-Factory,手把手教你打造属于自己的AI助手!

我将为大家详细介绍如何使用LLaMA-Factory这一开源框架,从环境搭建到模型训练,再到实际应用,手把手教你打造属于自己的AI助手!

Y525698136的博客 1243

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

大模型微调2——使用LLaMA-Factory微调qwen模型优化推理效果

使用LLaMA-Factory框架微调qwen大模型,介绍了LLaMA-Factory和微调流程

qq_42755230的博客 3051

【学习记录】大模型微调之使用 LLaMA-Factory 微调 Qwen系列大模型,可以用自己的数据训练

LLaMA Factory 是一个简单易用且高效的大型语言模型(Large Language Model)训练与微调平台。通过 LLaMA Factory,可以在无需编写任何代码的前提下,在本地完成上百种预训练模型的微调,框架特性包括

风信子的博客 3312

llama-factory SFT系列教程 (二),大模型在自定义数据集 lora 训练与部署

本文为 llama-factory SFT系列教程的第二篇;实现了在自定义数据集上 lora 微调大模型;接着融合lora权重进行大模型推理的功能

jieshenai的博客 2万+
上一篇: 《斯坦福CS336》作业开源,含讲解视频,带你从0手搓大模型|硬核教程
下一篇: 使用 LLaMA-Factory 微调自定义数据并加载对话的完整流程
AI_小站
博客等级 码龄3年 6255粉丝 1155原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值