零基础玩转本地大模型部署,能搜索、能RAG!深山老林没网都可以用

本地部署属于自己的大语言模型 支持多种模型,每种模型有多个参数,运行7B参数模型需要至少8G内存,运行13B参数模型需要至少16G内存,运行33B参数模型需要至少32G内存。以下是几种模型的参数与模型大小,更多模型可查阅ollama官方文档。success后进入网址: http://localhost:3000/新建容器,端口设置11434与之后的chatbot-ollama保持一致。点击左侧仪表盘的隧道管理——创建隧道,创建一个聊天机器人的公网地址隧道!打开链接http://localhost:3000 显示如下即成功。 阅读详情

以前,我们总以为强大的 AI 模型需要昂贵的服务器和稳定的网络连接。但随着技术的发展,一场 AI 民主化的革命正在悄然发生:本地 AI 部署已经成为主流趋势,个人电脑完全可以运行媲美 GPT-4 级别的大模型!

这一变化的主要驱动因素包括:数据隐私保护需求的增强、AI PC 硬件性能的大幅提升、以及 GGUF 等先进量化技术的成熟。现在,你可以在深山老林里,没有网络信号,依然能够与 AI 对话、编程、甚至利用它来分析本地文档;你可以完全掌控自己的数据,不必担心隐私泄露;你更可以根据自己的需求,自由切换和定制各种模型。

随着 OpenAI 发布的开源 GPT-OSS 模型、通义千问 Qwen3 系列的全面升级、以及各种优化工具的成熟,本地部署大模型的门槛已经降到了前所未有的低度。

本教程将手把手带你入门,从零开始,手把手教你使用不同的工具来部署本地模型,并实现网页搜索、RAG(检索增强生成)等高级功能。

本地部署的四大优势

为什么我们要选择在本地部署大模型?

    1. 数据隐私与安全:所有数据都在你的电脑上处理,不经过任何云服务。对于处理敏感信息和注重隐私的用户来说,这是最安全的选择。
    1. 离线使用:没有网络?没问题!一旦模型部署在本地,你可以在任何地方、任何时间使用它,真正实现"AI 自由"。
    1. 成本效益:无需为昂贵的 API 调用付费,一次配置,无限使用。对于需要大量使用 AI 的开发者和研究者来说,长期下来能节省一大笔开销。
    1. 高度可定制:你可以根据自己的需求,自由选择、切换甚至微调模型,打造一个完全属于你自己的 AI 助手。

核心概念扫盲

在开始之前,我们先来了解几个基本概念,这将帮助你更好地理解和选择模型。

什么是大模型的满血版、蒸馏版、量化版?

满血版 (FP16/BF16)

这是模型的原始版本,精度最高,效果最好,但对硬件的要求也最高,占用的显存和内存最大。

DeepSeek-R1 是 DeepSeek 的原始大模型,采用混合专家(MoE)架构,拥有 6710 亿个参数。该模型在推理能力上表现出色,特别是在数学推理和编程任务中,已达到与 OpenAI 的 o1 模型相当的水平。需要高性能硬件支持。

蒸馏版 (Distilled)

可以理解为"知识压缩"版。通过一个更大、更强的"教师模型"来训练一个更小、更高效的"学生模型"。学生模型在保留核心能力的同时,体积和计算量都大大减小。

DeepSeek-R1-Distill 是从 DeepSeek-R1 模型蒸馏得到的轻量级版本,参数规模从 1.5B 到 70B 不等。
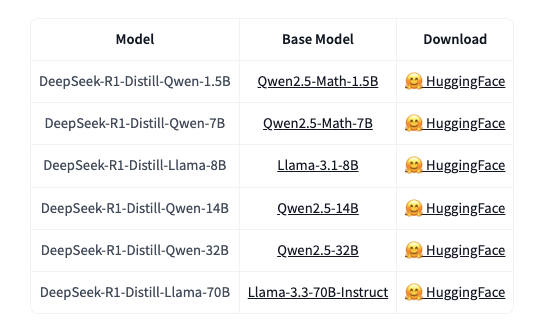
以下是满血版 DeepSeek-R1、蒸馏版 DeepSeek-R1-32B、OpenAI-o1-1217 模型的对比。
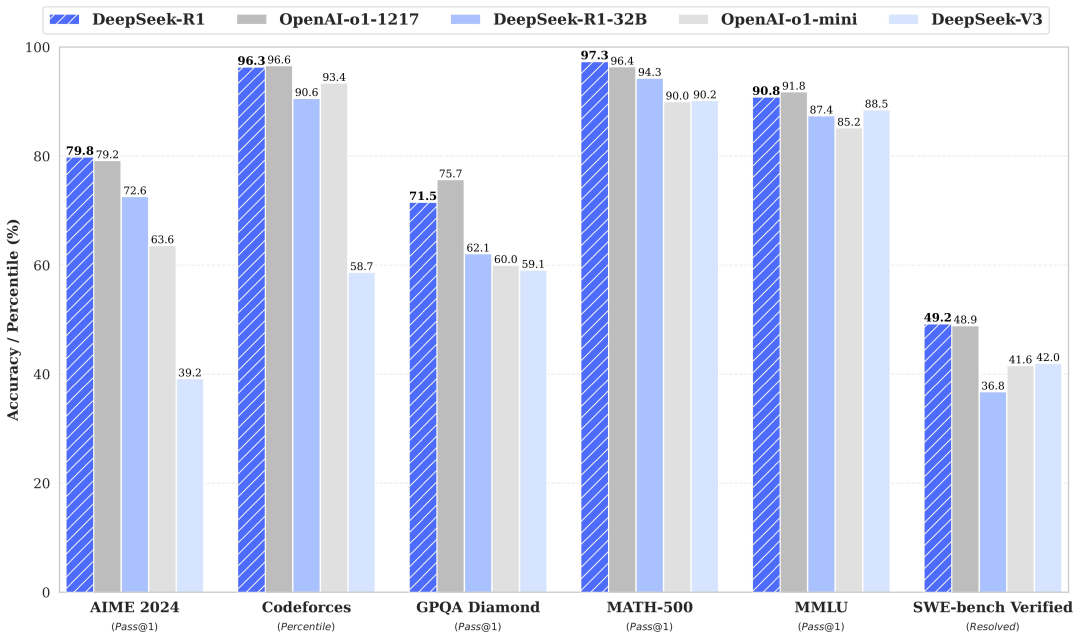
参考 deepseek-ai/DeepSeek-R1

量化版 (Quantized)

这是本地部署的主流选择!主要包括:

  • • GGUF 格式:由 llama.cpp 项目开发的优化格式,支持 4-bit、8-bit 量化,是目前最受欢迎的本地部署格式
  • • AWQ (Activation-aware Weight Quantization):针对激活值敏感的权重进行量化,性能损失极小
  • • GPTQ:基于后训练量化技术,在保持性能的同时大幅减少模型大小

这些量化技术让 7B 模型只需要 4-6GB 内存就能运行,是本地部署的最佳选择。

qwen2:7b 是什么意思?

我们经常看到类似 qwen2:7b、llama3:8b 这样的模型名称,它们代表了什么?

  • • qwen2 或 llama3 是模型的名字。
  • • 冒号后面的 7b 或 8b 代表模型的参数规模(b = billion,十亿)。7b 就是 70 亿参数,8b 就是 80 亿参数。
  • • 参数规模越大,通常意味着模型的能力越强,但对硬件的要求也越高。 对于个人电脑来说,7B 到 13B 规模的模型是比较理想的选择,在性能和资源消耗之间取得了很好的平衡。

硬件配置要求

跑本地大模型需要什么样的电脑?其实门槛比想象中更低!

内存 (RAM) - 最关键因素

  • • 7B 模型(推荐新手):16GB 内存,量化后仅需 4-6GB
  • • 13B 模型(进阶用户):32GB 内存,量化后需 8-12GB
  • • 30B+ 模型(专业用户):64GB 内存,适合工作站级别配置

GPU 配置(强烈推荐)

  • • NVIDIA RTX 40 系列:
  • • RTX 4060 Ti 16GB:性价比很高,可运行 13B 模型
  • • RTX 4070 Super:12GB 显存,适合 7B-13B 模型
  • • RTX 4090:24GB 显存,可运行 30B+ 大模型
  • • Apple Silicon(优秀选择):
  • • M3/M4 Mac(16GB 统一内存):运行 7B 模型表现良好
  • • M3/M4 Pro(32GB):运行 13B 模型体验流畅
  • • M3/M4 Max(64GB+):可处理 30B+ 模型

CPU 方案(无 GPU 也能用)

  • • AMD Ryzen 9 7950X3D + 32GB RAM:可运行量化 7B 模型
  • • Intel i7-13700K + 32GB RAM:适合轻度使用

性价比推荐

    1. 入门级:16GB 内存的笔记本电脑
    1. 进阶级:RTX 4060 Ti 16GB + 32GB RAM 台式机
    1. 专业级:M4 Max MacBook Pro 或 RTX 4090 工作站

总结:现在只需一台主流笔记本(16GB 内存),就能运行强大的 7B 模型!

Ollama:本地大模型的瑞士军刀

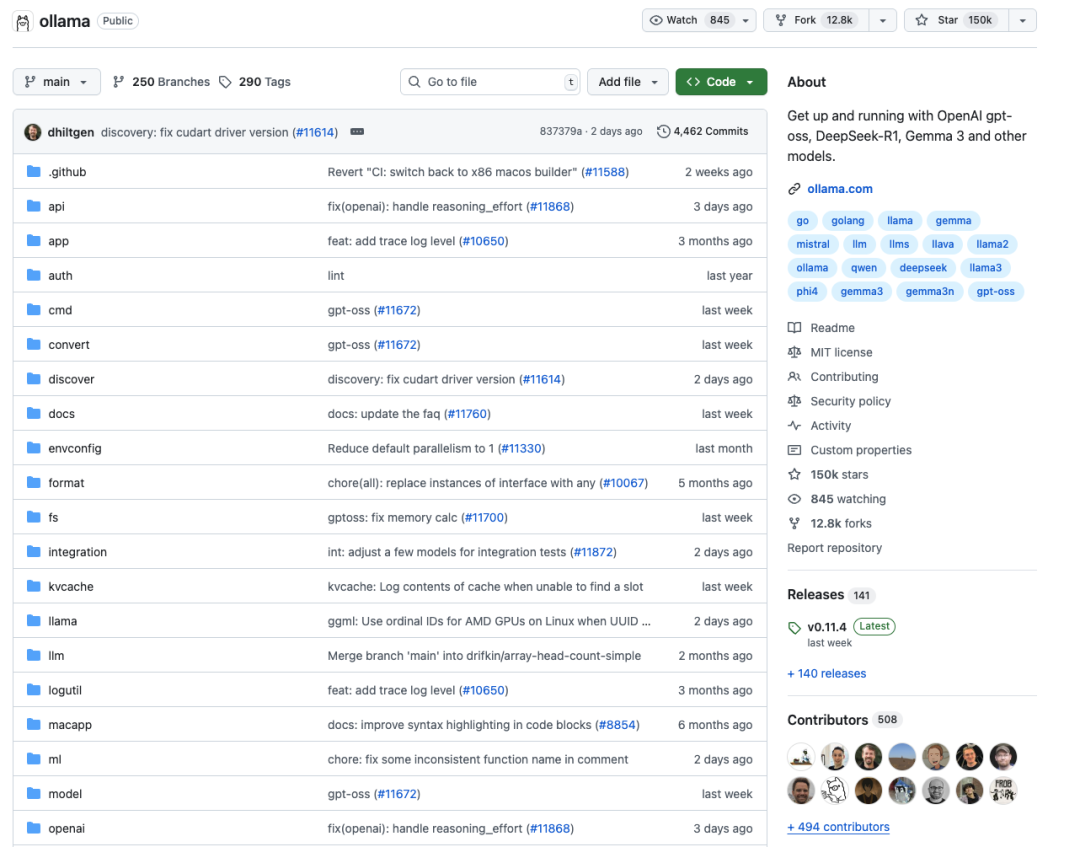
Ollama 是一个开源工具,旨在让你能够在个人电脑上轻松、快速地运行和管理大型语言模型(LLM)。它将复杂的模型配置和运行过程打包成一个简单的命令行工具,让你只需一条命令就能启动并与 Llama 3.1, Mistral, Gemma, Qwen3 等顶级开源模型进行交互。Ollama 的目标是成为本地 AI 开发的基石,让每个人都能轻松利用大模型的力量。

截止目前 Ollama 在 Github 已斩获 150k+ 的 Star,火爆程度可想而知。
核心功能

  • • 一键启动: 只需一条命令(如 ollama run qwen3),即可下载并运行一个完整的语言模型,无需任何复杂的环境配置。
  • • 模型库集成: 官方提供了一个庞大的模型库,包含了社区最流行、最前沿的模型,并且对它们进行了优化,方便用户一键获取。
  • • 跨平台支持: 完美支持 macOS, Windows, 和 Linux,并为 Apple Silicon 和 NVIDIA GPU 提供了深度优化。
  • • 内置 API 服务器: Ollama 会自动在本机 11434 端口创建一个与 OpenAI API 兼容的 REST API 服务。这意味着任何支持 OpenAI API 的应用或代码库,都可以无缝对接到你本地运行的模型,极大地简化了本地 AI 应用的开发。
  • • 轻量化与高效: Ollama 本身非常轻量,它负责管理模型的权重、配置和细节,并利用 llama.cpp 等底层技术高效运行模型,充分发挥硬件性能。

使用场景

  • • 个人 AI 助手: 在本地搭建一个私密的、无需联网的聊天机器人,用于日常问答、写作辅助、编程等。
  • • AI 应用开发与测试: 开发者可以在本地快速测试和迭代集成了大模型的应用程序,无需支付昂贵的 API 调用费用。
  • • 数据隐私与安全: 对于需要处理敏感数据的个人或企业,Ollama 提供了完美的解决方案,所有数据都在本地处理,杜绝了隐私泄露的风险。
  • • 离线环境工作: 在没有网络连接的环境(如飞机上、偏远地区)中,依然可以正常使用强大的 AI 功能。

安装与快速上手

Ollama 的安装过程极其简单,我们以 macOS 为例。

下载安装包

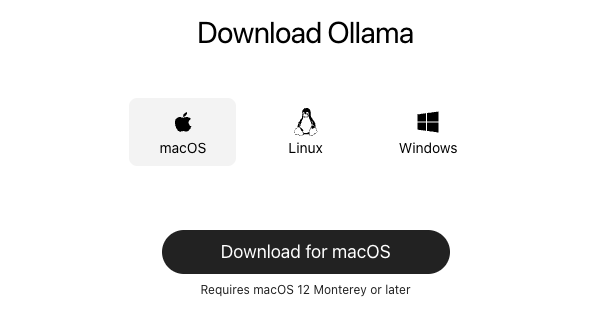
前往 Ollama 官网下载页面,可以看到对 macOS, Linux, Windows 的全面支持。我们选择并下载 macOS 版本,然后双击安装包完成安装。
验证安装

安装完成后,打开终端,输入以下命令:

ollama -v

如果看到类似 ollama version is 0.11.4 的输出,恭喜你,Ollama 已经成功安装!

下载并运行模型

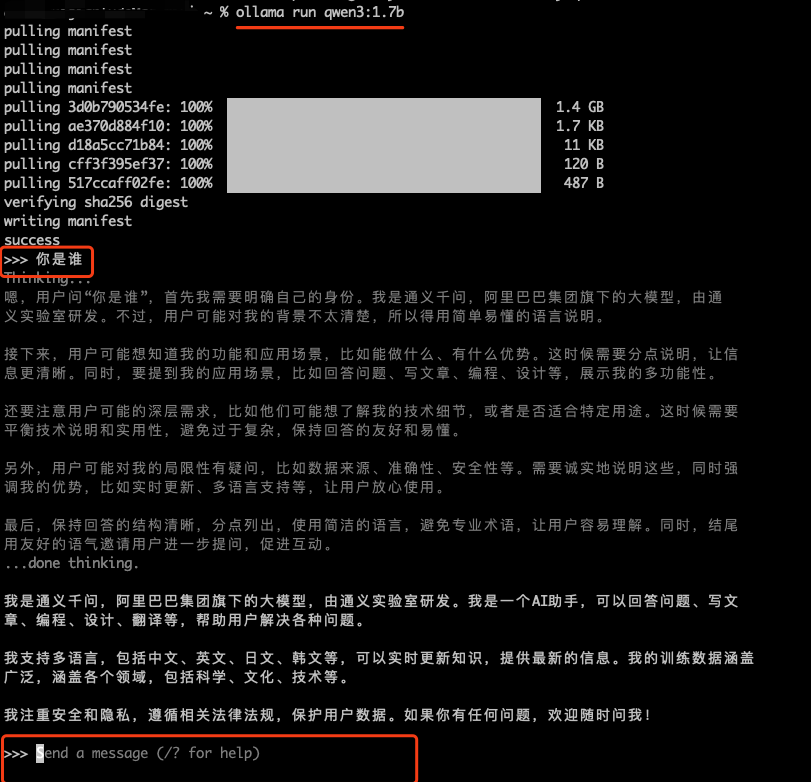
接下来,我们来下载并运行第一个模型。你可以在 Ollama 模型库 找到海量模型。我们选择一个对硬件要求不高的轻量级模型 qwen3:1.7b 来体验。
在终端输入:

ollama run qwen3:1.7b

Ollama 会自动从官方库下载模型并启动。下载完成后,你就可以直接在终端与它对话了!
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

本地如何通过Ollama部署llama3、phi3等本地大模型? 来运行阿里的通译千问大模型,生成内容质量还可以而且速度也很快,(题外:生成的文章如果收录不是很好,最好不要用markdown格式和html格式,直接用文本格式)包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。 阅读详情

相关推荐

私有化部署 Llama3 大模型, 支持 API 访问

原文 https://ducafecat.com/blog/llama3-model-api-local通过 ollama 本地运行 Llama3 大模型其实对我们开发来说很有意义,你可以私有化放服务上了。然后通过 api 访问,来处理我们的业务,比如翻译多语言、总结文章、提取关键字等等。你也可以安装 enchanted 客户端去直接访问这个服务 api 使用。

chenxyuan1tuo的博客 2047

大模型本地部署保姆级教程!三种方法教会你如何部署~

今天分享下关于大模型本地部署的一些基础知识,做一个简单的入门,并科普相关的工具使用。

2401_85373898的博客 6万+

别等官网卡爆!手把手教你打造私人无限量版DeepSeek

当全网程序员都在为DeepSeek官网的加载进度条抓狂时,我悄悄在本地电脑上部署了一个无限量调用的版本。不仅能无限制调用这个顶级AI模型,还能让它联网查资料、调用专属知识库——最关键的是,整个过程不需要任何付费API密钥。

weixin_44626085的博客 875

AI探索实践8 - 本地运行大模型

大模型的本地化运行,是创建企业内部AI应用重要组成部分。选取开源的、对中文支持友好的、开源协议友好的开源大模型可以帮助我们快速建立低成本、高性能的AI应用。通过使用Ollama软件,让我们能够轻松搭建和运行一个本地大模型实例。

专注AI领域的技术研究探索、技术落地 4286

LangSmith实战指南:LLM应用可观测性与调试加速

LLM应用调试难,本质是推理链黑箱化导致的可观测性缺失。LangSmith作为专为大模型设计的语义级追踪工具,通过自动解析prompt、token统计、工具调用、流式响应等关键维度,将原本依赖print和日志拼接的数小时问题定位,压缩至分钟级可复现分析。它填补了基础设施监控(如Datadog)与业务逻辑语义之间的鸿沟,尤其在Agent多步决策、RAG检索、工具编排等复杂场景中,提供可排序trace、可视化执行图谱、Prompt版本管理等工程化能力。对于使用LangChain、LlamaIndex等框架构建智

weixin_34195546的博客 296

本地大模型1:安装部署本地Ollama大模型

对ollama本地大模型的基本使用,下载了llama3.1:8b,可以进行基本的问答,推荐了两篇调用ollama的文章

weixin_74825941的博客 2万+

零基础玩转本地大模型部署,能搜索、能RAG!深山老林没网都可以用,大模型入门到精通,收藏这篇就足够了!

本教程将手把手带你入门,从零开始,手把手教你使用不同的工具来部署本地模型,并实现网页搜索、RAG(检索增强生成)等高级功能。

Y525698136的博客 1109

Python自动化车载测试:5分钟搞定CANoe COM接口调用(附完整代码)

本文详细介绍了如何使用Python快速实现CANoe COM接口调用,完成车载测试自动化。通过实战案例展示ECU信号测试框架搭建,包括环境配置、核心架构解析、信号读写封装及多线程安全方案,帮助开发者5分钟内掌握高效测试技巧。

vv45678的博客 1133

问答系统十年演进

摘要:问答系统十年演进(2015-2025) 2015-2025年,问答系统经历了三大技术范式演进: 抽取式阶段(2015-2018):依赖Bi-LSTM和CRF,从预设文本中提取答案,但无法处理跨文档综合信息。 生成式阶段(2019-2022):Transformer和RAG架构崛起,模型从检索答案转向生成逻辑解释,如ChatGPT。 推理Agent阶段(2025):系统通过思维链(CoT)进行多步推理,结合eBPF优化实时检索,支持多模态交互和内核级安全审计。 2025年的问答系统已从“信息搬运”升级为

jzwspace的专栏 528

从一个过气考渣的角度看LLM智能化测试用例生成

根据业务需求生成测试用例,会涉及到相关上下文的召回、用例生成等场景。除了用例生成之外,也可以考虑应用LLM进行用例评审。因此,本文将涉及以下内容。

software_test010的博客 830

VSCode搭配Keil开发STM32:从环境配置到代码跳转全流程(避坑指南)

本文详细介绍了如何使用VSCode搭配Keil进行STM32开发,从环境配置到代码跳转的全流程指南。通过安装必备插件和正确配置项目文件,开发者可以在VSCode中享受现代编辑器的便捷功能,同时保留Keil的编译调试能力,提升嵌入式开发效率。

weixin_28832121的博客 253

从零本地部署大模型(零基础友好版)

如果是进行只需要跑通模型,至少要保证显卡10G显存并且cuda版本最好高于11.x,如果是需要训练可能需要更大的显存。部署模型有三件事情要做:1.确定本地硬件是否支持需要部署的大模型。2.确定模型需要的依赖。3.下载好模型的权重和配置文件。

cy853043693的博客 1万+

【论文笔记】Beyond Low-frequency Information in Graph Convolutional Networks

文章目录1. Abstract2. Introduction低频和高频信号作用FAGCN怎么设计3. An Experimental Investigation4. Model4.1 filter定义4.2 Aggregation4.3 Problems of signal combination4.4 Spatial vision of FAGCN4.5 系数αijG\alpha_{i j}^{G}αijG​4.6 模型整体框架FAGCN的表达能力实验 本文发表在AAAI-21上 论文地址:https:

Running Snail 5602

我们为什么要用本地大模型?——坤叔的本地大模型入门指南

大模型,在2023年主要称之为大型语言模型(Large Language Models),是一种基于人工智能和机器学习技术构建的先进模型,旨在理解和生成自然语言文本。这些模型通过分析和学习海量的文本数据,掌握语言的结构、语法、语义和上下文等复杂特性,从而能够执行各种语言相关的任务。LLM的能力包括但不限于文本生成、问答、文本摘要、翻译、情感分析等。我们最熟悉的大模型,莫过于CHATGPT。但我们最常用的大模型,未必是CHATGPT。

kaka0722ww的博客 1万+

IAP板卡远程升级(串口网口都可)+Ymodem+AES对bin文件加密+pc软件+板卡相互烧录

还是决定记录一下,毕竟这个东西我也搞了挺久的,遇到一些棘手的,或者是因为我很粗心遇到的问题也和大家分享一下,。 板卡核心是 STM32F103RCT6,256kflash 前言 开始看这个远程升级的时候,我是一头雾水的,原子哥的教程里面也有说到过iap,有了一个大概的了解,我想不明白的是,通过串口下载的方式把hex文件下载到flash,和把bin文件下载到flash难道不是拉一根线,下载一个文件嘛,(初入职场的我并没有考虑到安全这个问题)如果直接将hex文件给到客户那边,风险是非常大...

那可真是太开心了的博客 5371

jlink v9刷固件修改序列号来修复弹窗

jlink v9弹窗警告修复j

weixin_40500627的博客 9367

一文详解几种常见本地大模型个人知识库工具部署、微调及对比选型(文末福利)

近年来,大模型在AI领域崭露头角,成为技术创新的重要驱动力。从AlphaGo的胜利到GPT系列的推出,大模型展现出了强大的语言生成、理解和多任务处理能力,预示着智能化转型的新阶段。

瓦罗兰特顶级C位的博客 6280

FastAPI 高级特性:同异步路由函数、依赖注入与后台任务

在现代 Web 开发中,高效的性能和简洁的代码结构是至关重要的。FastAPI 作为一个现代、快速(高性能)的 Web 框架,凭借其对异步编程的原生支持和直观的依赖注入系统,迅速成为开发者的热门选择。在本文中,将深入探讨 `FastAPI` 中的几个核心概念:同异步函数的区别、`Depends` 依赖以及后台任务。

qq_43629857的博客 203

新手小白如何搭建一个像openai一样的本地大模型(步骤多版本)

Ollama安装大模型1.安装ollama(本教程以win10系统为例)(1)下载地址:https://ollama.com/打开后进入以下下载地址下载windows版本ollama,其它系统选择对应版本如下图:下载后直接运行安装即可,安装好后右下角会显示一个羊驼的小图标(注意:ollama一般默认自动安装在C盘,后期如果下多个大模型,有的同学可能会面临空间不够,这里可以使用我找到的这个方法,如果不需要更改的可以略过此步骤)

zhishi0000的博客 3522

升级最新IDEA版本(2022.1.1)

升级最新IDEA版本(2022.1.1)

软件老王 3万+

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

中文大语言模型 Llama-2 7B(或13B) 本地化部署 (国内云服务器、GPU单卡16GB、中文模型、WEB页面TextUI、简单入门)

nvidia-smi注意 : 使用 nvidia-smi 查看CUDA 版本必须是 11.8。

asdasd的专栏 3万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

本地化部署大语言模型 ChatGLM

ChatGLM-6B 是一个开源的、支持中英双语的对话语言模型,基于 General Language Model (GLM) 架构,具有 62 亿参数。结合模型量化技术,用户可以在消费级的显卡上进行本地部署(INT4 量化级别下最低只需 6GB 显存)。ChatGLM-6B 使用了和 ChatGPT 相似的技术,针对中文问答和对话进行了优化。暂时先这样吧,如果有时间的话就会更新模型微调文章以及抽时间更新GLM130B的部署,实在看不明白就留言,看到我会回复的。路漫漫其修远兮,与君共勉。

Maddie_Mo的博客 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

AI大模型企业应用实战:Prompt让LLM理解知识

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84204413的博客 3212

你想在本地部署大模型吗?本地部署大模型的三种工具

人工智能的发展如火如荼,也让越来越多的人了解到人工智能;而对大部分人来说使用的都是第三方提供的客户端,不论是网页版,还是PC端或移动端。那么,我们怎么在本地部署一款大模型呢?下面就来介绍三种工具。

xx_nm98的博客 4788

本地部署大语言模型全解析:实用工具与操作指南

本地部署大语言模型可以通过多种工具和软件实现,每个工具都有其独特的优势和适用场景。通过上述步骤,您可以在本地环境中高效地运行和管理大语言模型,满足不同的应用需求。

2401_84495872的博客 1932
上一篇: 全网最全:AI产品经理(AI PM)面试题及答案
下一篇: AI未来已来!爆肝整理【生成式AI学习路线图】,小白也能变大神!
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
