使用LLaMA Factory进行大模型微调,大模型入门到精通,收藏这篇就足够了!

快速上手!LLaMa-Factory最新微调实践,轻松实现专属大模型 近日,源2.0开源大模型与LLaMA-Factory框架完成全面适配,用户通过LLaMA-Factory,即可快捷、高效地对不同参数规模的源2.0基础模型进行全量微调及高效微调,轻松实现专属大模型。 阅读详情

还在为大模型微调的高门槛发愁?显卡贵、代码复杂、配置繁琐?

LLaMA Factory 作为一站式大模型微调框架,用一句话解决所有痛点:“让大模型微调像呼吸一样简单” 🚀

LLaMA Factory 是一个用于微调大语言模型 (LLM) 的开源工具包,它提供了一个统一且高效的框架,支持 100 多个 LLM (包括Qwen、LLaMA、ChatGLM、Mistral等)的微调,涵盖了各种训练方法、数据集和先进算法。
大语言模型的微调是一个上手门槛颇高的工作,LLaMA Factory通过提供用户友好的 Web UI 和命令行界面,结合其统一且高效的框架,大幅降低了大模型从微调到测试评估的上手门槛。
✅ 核心优势:

  • 零代码操作:Web UI 可视化界面,新手 3 分钟上手

  • 极致省显存:16GB 显卡即可微调 70B 大模型(QLoRA 技术)

  • 全场景支持:覆盖 100 + 主流模型(LLaMA3/Qwen/ChatGLM 等)

  • 多训练方式:LoRA/QLoRA/ 全参数微调 + 多模态(文本 + 图像 + 音频)

  • 国人维护:中文文档完善,GitHub 星标 52.4k+

🛠️ 第一步:环境准备(3 分钟搞定)

  1. 快速安装

方式1:pip直接安装(推荐)

pip install llamafactory

方式2:源码安装(需自定义功能)

git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git

cd LLaMA-Factory

uv sync --extra torch --extra metrics # 高效安装依赖

  1. 验证安装

llamafactory-cli version # 显示版本即成功

python -c “import torch; print(torch.cuda.is_available())” # 验证GPU可用(输出True)

⚠️ Windows 用户注意:若 GPU 检测失败,需重新安装 CUDA 版本 PyTorch:

pip uninstall torch torchvision

pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126

🚀 两种微调方式:新手 / 进阶全覆盖

🌟 方式 1:Web UI 可视化操作(新手首选)

启动Web界面(自动下载依赖)

llamafactory-cli webui

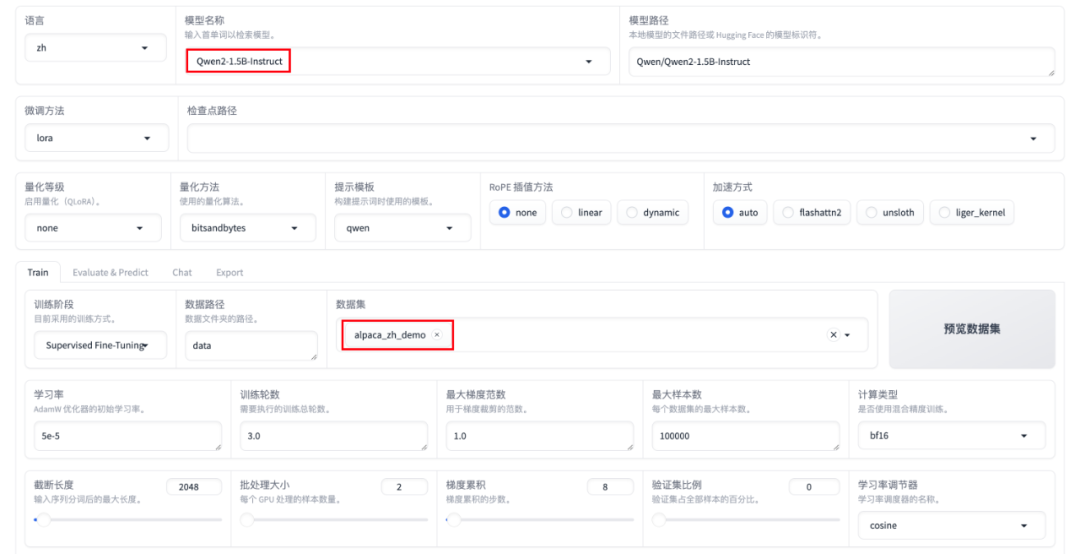
访问 http://localhost:7860 即可看到直观界面,步骤如下:

  1. 模型选择:下拉选择 LLaMA3/Qwen 等模型(自动下载)

  2. 训练方式:默认 LoRA(轻量化省显存)

  3. 数据集配置:

  • 内置数据集:直接勾选 alpaca/identity 等

  • 自定义数据:上传 JSON 文件(格式见下文)

  1. 参数调整(关键):
  • 学习率:1e-4(默认最优值)

  • 批次大小:1(根据显存调整)

  • 梯度累积:8(显存不足时增大)

  1. 点击「开始训练」,实时查看损失曲线 📉

界面结构示意图:

┌─────────────┬─────────────┐

│ 模型选择 │ 训练方式 │

│ • LLaMA3 │ • LoRA │

│ • Qwen │ • 全参数 │

│ • ChatGLM │ • QLoRA │

├─────────────┼─────────────┤

│ 数据集 │ 训练参数 │

│ • alpaca │ • 学习率 │

│ • 自定义 │ • batch_size│

└─────────────┴─────────────┘

⚙️ 方式 2:配置文件训练(进阶用户)

创建 train.yaml 配置文件,灵活定制训练流程:

模型配置

model_name_or_path: meta-llama/Meta-Llama-3-8B-Instruct # 模型名称

trust_remote_code: true # 信任远程代码

训练方法

stage: sft # 监督微调(可选pretrain/rlhf等)

finetuning_type: lora # LoRA轻量化微调

lora_rank: 8 # 控制参数量(越大效果越好但耗显存)

lora_target: all # 作用于所有层

数据集配置

dataset: identity,alpaca_en_demo # 数据集名称(多个用逗号分隔)

template: llama3 # 对话模板(需与模型匹配)

cutoff_len: 2048 # 最大序列长度

训练参数

per_device_train_batch_size: 1

gradient_accumulation_steps: 8

learning_rate: 1.0e-4

num_train_epochs: 3.0

输出配置

output_dir: saves/llama3-8b-lora # 模型保存路径

logging_steps: 10 # 日志打印间隔

启动训练:

llamafactory-cli train train.yaml

📌 实战案例:自定义医疗问答模型

  1. 准备数据集(Alpaca 格式)

创建 medical_data.json,包含 5000 + 医疗问答样本:

[

{

“instruction”: “患者:我最近总是头痛,可能是什么原因?”,

“input”: “”,

“output”: “头痛常见原因:1.紧张性头痛 2.偏头痛 3.颈椎问题 4.睡眠不足 5.眼睛疲劳。建议描述头痛性质、部位、持续时间以便判断。”

},

{

“instruction”: “患者:感冒了应该吃什么药?”,

“input”: “”,

“output”: “普通感冒建议:1.多休息 2.喝温水 3.补充维生素C 4.发热时服用退烧药 5.症状严重及时就医”

}

]

  1. 配置训练文件(medical_train.yaml)

model_name_or_path:qwen/Qwen-7B-Chat# 中文优化模型

stage:sft

finetuning_type:lora

lora_rank:16# 增大秩提升效果

dataset:medical_qa# 自定义数据集名称

template:qwen# 匹配Qwen模型模板

cutoff_len:4096# 支持更长文本

learning_rate:5.0e-5# 稍小学习率避免过拟合

num_train_epochs:5.0

output_dir:saves/qwen-7b-medical-lora

plot_loss:true# 绘制损失曲线

  1. 训练与评估

启动训练

llamafactory-cli train medical_train.yaml

监控训练进度

tensorboard --logdir saves/qwen-7b-medical-lora/runs

评估模型

llamafactory-cli evaluate --model_name_or_path qwen/Qwen-7B-Chat --adapter_path saves/qwen-7b-medical-lora

  1. 效果对比
模型训练方式显存占用训练时间医疗问答准确率
Qwen-7B全参数微调32GB+2 小时82%
Qwen-7BLoRA 微调12GB30 分钟78%

❌ 常见问题解答

  1. 显存不足?
  • 改用 QLoRA(finetuning_type: qlora)

  • 减小 lora_rank 和 per_device_train_batch_size

  • 增大 gradient_accumulation_steps

  1. 数据集格式错误?
  • 确保是 Alpaca/ShareGPT 格式(见下文)

  • 自定义数据集需在 data/data_info.json 中注册

  1. 模型下载失败?
  • 配置 Hugging Face 令牌:huggingface-cli login

  • 使用国内镜像源加速

📚 关键知识点

数据集格式(二选一)

  1. Alpaca 格式(单轮任务):

{

“instruction”:“任务指令”,

“input”:“背景信息(可选)”,

“output”:“正确答案”,

“system”:“系统提示词(可选)”

}

  1. ShareGPT 格式(多轮对话):

{

“conversations”:[

{“from”:“human”,“value”:“你好,我出生于1990年5月15日,我几岁了?”},

{“from”:“gpt”,“value”:“根据计算,你今年35岁了。”}

]

}

支持的训练方式

  • 监督微调(SFT):适合指令遵循、领域适配

  • 预训练(Pretrain):适合知识注入

  • RLHF:适合对齐人类偏好

  • DPO/ORPO:轻量化 RLHF 替代方案

🎯 总结

LLaMA Factory 降低了大模型微调的门槛,无论是新手还是资深开发者,都能快速实现模型定制。关键优势:

  • 零代码 / Web UI 双模式,灵活适配不同需求

  • 16GB 显存即可玩转 70B 大模型

  • 支持中文模型 + 自定义数据集,适配国内场景

现在就动手试试吧!如果遇到问题,欢迎在评论区留言,或参考官方文档:

📖 项目地址:github.com/hiyouga/LLaMA-Factory

📖 中文文档:llamafactory.readthedocs.io/zh-cn/latest

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

Llama-factory详细基础使用说明 对于初入算法的童鞋来说,有的可能还不知道llama-factory是什么,只知道大模型用到了这个框架,这是不行的。LLaMA-Factory 是一个低代码的大规模语言模型(LLM)训练框架,它主要面向研究人员和开发者,旨在简化大型语言模型的微调、评估和部署过程。白话说就是集合了当下LLM领域各种好用的开源或者自研的框架以及工具,进行封装以及优化,简化使用方法,方便大家对大模型进行微调和评估部署等工作,降低了使用难度。包括推理框架vllm等(具体可以看官网哈,下面有地址)易用性 vs. 性能。 阅读详情

相关推荐

微调神器LLaMA-Factory官方保姆级教程来了,从环境搭建到模型训练评估全覆盖

数据集的格式要求在不同的阶段是不同的,本教程以sft阶段的数据集需求,将以系统自带的identity数据集和将自定义的一个商品文案生成数据集为例,介绍数据集的使用。更多详情可以在https://github.com/hiyouga/LLaMA-Factory/blob/main/data/README_zh.md 中找到相关解释。系统目前支持 alpaca 和sharegpt两种数据格式,以alpaca为例,整个数据集是一个json对象的list,具体数据格式为。

lqfarmer的博客 6765

LLaMA-Factory 大模型微调平台

微调是指在已经训练好的大型预训练模型的基础上,进一步训练该模型以适应特定任务或特定领域的数据。尽管完全微调可以对模型的能力进行深度改造,但要带入模型全部参数进行训练,需要消耗大量的算力,且有一定的技术门槛。由于微调需要消耗大量的显存,因此参数规模超过 30B 的大模型往往无法在 32GB 消费级 GPU 上运行,但却可以轻松在拥有 128GB UMA 的 PGX 上随时进行。其中,GGUF 是大模型的存储格式,可以对模型进行高效的压缩,减少模型的大小与内存占用,从而提升模型的推理速度和效率。

烟云的计算 5514

【大模型】使用 LLaMA-Factory 进行大模型微调:从入门到精通

使用 LLaMA-Factory 进行模型微调:从入门到精通

weixin_43988131的博客 1854

LlamaFactory 一键式LLM训练、微调工具介绍与实践

LlamaFactory架构LlamaFactory主要通过Trainer类来实现训练流程,通过设置数据集、模型选型、训练类型、微调超参、模型保存,以及训练状态监控等信息,来开启训练。支持的训练方法支持的训练方法(这里的Pre-Training指的是增量预训练)LlamaFactory和其他框架对比LlamaFactory基于PEFT和TRL进行二次封装,从而可以快速开始SFT和RLHF微调。同时,引入GaLore和Unsloth等方案,能降低训练显存占用。

h1453586413的博客 3906

12 大模型学习——LLaMA-Factory微调

Alpaca 格式由斯坦福大学的研究人员提出,主要用于单轮指令微调任务。针对不同任务,数据集的格式要求不同。应用场景:- 适用于单轮任务,如问答、文本生成、摘要、翻译等。- 结构简洁,任务导向清晰,适合低成本的指令微调。

weixin_54388827的博客 4622

用 LLama-Factory 训练和微调 LLama3,打造你的专属 AI 模型!

微调模型涉及调整预训练或基础模型的参数,使其能够用于特定任务或数据集,从而提升其性能和准确性。这个过程包括为模型提供新的数据,并修改其权重、偏差和某些参数以最小化损失和成本。通过这样做,这个新模型可以在任何新任务或数据集上表现良好,而无需从头开始,从而节省时间和资源。通常,当一个新的大型语言模型(LLM)创建时,它会在一个大型文本数据语料库上进行训练,其中可能包含潜在有害或不良内容。在预训练或初始训练阶段之后,模型会被微调加入安全措施,确保其避免生成有害或不良的响应。然而,这种方法并非完美无缺。

数智笔记 2997

【大模型微调】1.LLaMA-Factory简介和基本使用流程,大模型入门到精通,收藏这篇就足够了!

本文先在 windows 操作系统上,跑通LLaMA-Factory的模型微调过程,为后续探索奠定基础。

Y525698136的博客 756

LLaMa Factory大模型微调

如果有all_proxy的设置,使用下面命令设置为空就行。以Qwen/Qwen2.5-7B-Instruct为例。比如我的数据集没有history,我就把。看看有没有出现下面的all_proxy的设置。,搜相应的模型名字,比如我这里直接搜。微调自我认知+微调特定领域数据集。,使用下面命令查看系统的代理设置。如果数据集没有相应的键,就先去掉。不确定模型的名字的话,打开链接。按Alpaca格式准备好数据集。关于history的部分去掉。,然后得知模型全称是。

laonafahaodange的博客 1480

大模型开发实战:(五)使用 LLaMA Factory 微调与量化模型并部署至 Ollama,大模型入门到精通,收藏这篇就足够了!

LLaMA Factory 是一个开源的全栈大模型微调框架,简化和加速大型语言模型的训练、微调和部署流程。

Y525698136的博客 1647

LLaMA Factory单机微调的实战教程

本文主要介绍了使用LLaMA Factory对大模型进行单机微调的实战教程,希望对学习大语言模型的同学们有所帮助。 文章目录 1. 前言 2. 配置环境 2.1 安装虚拟环境 2.2 安装依赖库 2.3 模型选型与下载 3. 运行代码 3.1 构建训练数据 3.2 修改配置文件 3.3 微调

herosunly的博客 21万+

避坑指南:群晖DSM 7.X挂载NTFS硬盘,为什么你的SATA口不行?从原理到实战一次讲清

本文深入解析群晖DSM 7.X系统挂载NTFS硬盘的底层原理与实战排查方法,揭示SATA接口权限配置的关键参数(如esataportcfg和internalportcfg),并提供安全修改端口配置的详细步骤。针对不同型号群晖NAS的配置差异,给出替代方案与常见故障排查技巧,帮助用户解决NTFS硬盘挂载问题。

weixin_26757925的博客 256

新手教程之使用LLaMa-Factory微调LLaMa3

如果你尝试过微调大模型,你就会知道,大模型的环境配置是非常繁琐的,需要安装大量的第三方库和依赖,甚至需要接入一些框架。 但是大模型微调的方法又是非常类似的,那有没有一种工具可以统一这些操作,让大模型微调变成一个简单易上手的事情,LLaMa-Factory就是为了解决这个问题应运而生

David_house的博客 1万+

Python多进程实战:用BaoStock高效下载股票历史数据的5个优化技巧

本文详细介绍了使用Python多进程技术通过BaoStock高效下载股票历史数据的5个优化技巧。从理解BaoStock的数据获取机制到进程池配置、智能任务分片、异常处理及性能监控,帮助开发者显著提升数据下载效率,特别适合量化交易领域的数据采集需求。

weixin_30369041的博客 458

小白也能微调大模型:LLaMA-Factory使用心得

本文介绍了初学者如何使用LLaMA-Factory进行大模型的微调,包含训练、测试数据集的构建,训练任务相关的参数,训练完成后的测试集上推理等环节

MeetLight 1万+

SAP-ABAP:SAP HANA性能神器FDA:是极速查询的引擎,也是CPU过载的元凶

在SAP S/4HANA的世界里,有一个被ABAP开发者们既爱又怕的特性——Fast Data Access(FDA),它能将性能提升百倍,也能让CPU瞬间飙升。本文将带您全面解剖这一核心机制。

baidu_35680696的博客 849

YOLOv11改进策略【Neck】| 适用关键点检测:PSFM,深层语义融合模块 引入深层与浅层交叉注意力机制,动态建模不同层级的全局语义依赖关系

本文记录的是利用PSFM 模块改进 YOLOv11 的颈部融合部分,专门用于关键点检测。PSFM模块(Profound Semantic Fusion Module,深层语义融合模块) 通过在特征提取网络的深层引入跨模态交叉注意力机制,动态建模红外与可见光特征的全局语义依赖关系。本文将其应用到的颈部部分,融合深层与浅层特征,捕捉长距离语义关联,增强融合特征的判别性与场景理解能力,为检测头提供包含全局上下文的高层语义表示,从而提升模型在复杂场景下的目标检测准确率与语义推理鲁棒性。Rethinking the

Limiiiing的博客 649

LLaMA-Factory部署以及微调大模型

安装成功后,输入python能出现截图表示安装成功。

qq_35594661的博客 1万+

ESP32-IDF开发之旅 基础篇⑨ ESP-IDF的FreeRTOS任务间通信和同步

本文介绍了FreeRTOS任务间通信中的队列机制,重点讲解了队列的创建、发送和接收数据的API使用方法。文章提供了详细的技术说明和示例代码,包括xQueueCreate、xQueueSend、xQueueReceive等核心函数的参数说明和返回值解释。通过一个2生产者+1消费者的实际案例,展示了如何在ESP-IDF环境下使用FreeRTOS队列实现任务间通信。示例中包含了数据发送失败处理和接收数据验证等实用技巧,为开发者提供了可参考的实现模式。

单片机菜鸟哥的博客 427

LLaMA Factory大模型微调秘籍,大模型入门到精通,收藏这篇就足够了!

LLaMA Factory 是一个简单易用且高效的大型语言模型(Large Language Model)训练与微调平台,是一款专为大型语言模型(LLM)微调而设计的工具集。

瓦罗兰特顶级C位的博客 1248

倍福PLC--PERSISTENT断电保持数据和BOOT中各文件对应的解析

将D:\TC3程序\TwinCAT Project146\TwinCAT RT(x86)\Plc 文件夹的中三个替换文件复制到:G:\TwinCAT\3.1\Boot\Plc完成替换,如下图。(2) 找到程序所存的路径,编程电脑的D:\TC3程序\TwinCAT Project146路径下,并选择对应系统平台TwinCAT RT(x86)(3) 控制器断电,拔出内存卡,使用读卡器,在编程电脑中打开:(本次测试读卡器为G盘)(5) 开机完成后,TwinCAT自动运行,当前闪灯频率为50ms。

weixin_41883890的博客 2344

Himall商城ExpressDaDaHelper 取消订单(线上环境)

Himall商城ExpressDaDaHelper 取消订单(线上环境)

GZM888888的博客 399

大模型系列:LLaMA-Factory大模型微调,大模型入门到精通,收藏这篇就足够了!

LLaMA-Factory 作为一个高效、易用的微调工具,为广大开发者提供了极大的便利。适配市场主流开源模型,形成一个功能丰富,适配性好的训练框架。

huang9604的博客 1097

开源数字人、虚拟直播部署教程

对,你无看错,是欧美的。在直播带货案例里,我们把模型导入到ue4,我们给模型在ue4里预设了四个动作(站着、站着说话、坐着、坐着说话),三个表情(平静、开发、愤怒),三个镜头(全局、近矩说话、看显示器播放商品展示)。我们只需要把目标主播的直播给录制下来,提取样本数据,然后训练一个从粉丝的不同刺激的组合,到主播的不同响应方式的多元逻辑回归的数学模型参数即可。

南七小僧的学海无涯 4561

手把手教你快速玩转LLaMA-Factory:大模型微调入门级教程,大模型入门到精通,收藏这篇就足够了!

对于希望尝试大模型训练的同学来说,从 LLaMA-Factory 入手是一个非常不错的选择!在实际工作中,也经常用到 LLaMA-Factory 进行模型训练。

瓦罗兰特顶级C位的博客 1571

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

推荐一款大模型微调神器——LLaMA Factory,大模型入门到精通,收藏这篇就足够了!

。LLaMA Factory应运而生,作为一个开源的大模型训练与推理框架,它以“高效、灵活、易用”为核心,为开发者提供了一站式解决方案。

Y525698136的博客 1143

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

LLaMA-Factory 一键微调大模型,大模型入门到精通,收藏这篇就足够了!

LLaMA-Factory 是南京大学人工智能创新研究院开源的轻量级大语言模型(LLM)微调工具包。它的设计目标很明确:让普通开发者也能低成本地玩转大模型。

Y525698136的博客 928

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

上一篇: 不用云端!Ollama 帮你在笔记本部署Qwen3,保姆级教程
下一篇: 「无需显卡」纯CPU环境也能流畅运行大模型!Llama.cpp本地部署Qwen3-0.6B攻略
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
