


环境配置
在已完成 ChatGLM3 的部署基础上,还需要安装以下依赖包:

同时,我们需要使用到开源词向量模型 Sentence Transformer(HuggingFace 链接名为:sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2),可以将其模型参数以类似于下载 ChatGLM3 模型参数的方式下载到本地 /root/autodl-tmp/sentence-transformer。同时,在本节中,ChatGLM3-6B 的模型参数文件存储在本地 autodl-tmp/ZhipuAI/chatglm3-6b。
知识库搭建
我们选择 Datawhale 的一系列 LLM 开源教程作为语料库来源,包括:
- Self LLM:一个围绕开源大模型、针对国内初学者、基于 AutoDL 平台的中国宝宝专属大模型教程。
- LLM Universe:一个面向小白开发者的大模型应用开发教程,旨在结合个人知识库助手项目,通过一个课程完成大模型开发的重点入门。
- LLM tutorial for Developers:一个面向开发者的 LLM 入门教程,基于吴恩达老师大模型系列课程内容实现。
- So Large LLM:一个大规模预训练语言模型的教程,从数据准备、模型构建、训练策略到模型评估与改进,以及模型在安全、隐私、环境和法律道德方面的方面来提供开源知识。
- Hugging LLM:介绍 ChatGPT 原理、使用和应用,降低使用门槛,让更多感兴趣的非NLP或算法专业人士能够无障碍使用LLM创造价值。
首先我们需要将上述远程开源仓库 Clone 到本地,可以使用以下命令:
# 进入到数据库盘
cd /root/autodl-tmp
# 打开学术资源加速
source /etc/network_turbo
# clone 上述开源仓库
git clone https://github.com/datawhalechina/self-llm.git
git clone https://github.com/datawhalechina/llm-universe.git
git clone https://github.com/datawhalechina/prompt-engineering-for-developers.git
git clone https://github.com/datawhalechina/so-large-lm.git
git clone https://github.com/datawhalechina/hugging-llm.git
# 关闭学术资源加速
unset http_proxy && unset https_proxy


from langchain.text_splitter import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500, chunk_overlap=150)
split_docs = text_splitter.split_documents(docs)
接着我们选用开源词向量模型 Sentence Transformer来进行文本向量化。LangChain 提供了直接引入 HuggingFace 开源社区中的模型进行向量化的接口:
rom langchain.embeddings.huggingface import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(model_name="autodl-tmp/sentence-transformer")
同时,我们选择 Chroma 作为向量数据库,基于上文分块后的文档以及加载的开源向量化模型,将语料加载到指定路径下的向量数据库:
ffrom langchain.vectorstores import Chroma

# 定义持久化路径
persist_directory = 'data_base/vector_db/chroma'
# 加载数据库
vectordb = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory=persist_directory  # 允许我们将persist_directory目录保存到磁盘上
)
# 将加载的向量数据库持久化到磁盘上
vectordb.persist()
将上述代码整合在一起为知识库搭建的脚本:
# 首先导入所需第三方库
from langchain.document_loaders import UnstructuredFileLoader
from langchain.document_loaders import UnstructuredMarkdownLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from tqdm import tqdm
import os

# 获取文件路径函数
def get_files(dir_path):
    # args:dir_path,目标文件夹路径
    file_list = []
    for filepath, dirnames, filenames in os.walk(dir_path):
        # os.walk 函数将递归遍历指定文件夹
        for filename in filenames:
            # 通过后缀名判断文件类型是否满足要求
            if filename.endswith(".md"):
                # 如果满足要求,将其绝对路径加入到结果列表
                file_list.append(os.path.join(filepath, filename))
            elif filename.endswith(".txt"):
                file_list.append(os.path.join(filepath, filename))
    return file_list

# 加载文件函数
def get_text(dir_path):
    # args:dir_path,目标文件夹路径
    # 首先调用上文定义的函数得到目标文件路径列表
    file_lst = get_files(dir_path)
    # docs 存放加载之后的纯文本对象
    docs = []
    # 遍历所有目标文件
    for one_file in tqdm(file_lst):
        file_type = one_file.split('.')[-1]
        if file_type == 'md':
            loader = UnstructuredMarkdownLoader(one_file)
        elif file_type == 'txt':
            loader = UnstructuredFileLoader(one_file)
        else:
            # 如果是不符合条件的文件,直接跳过
            continue
        docs.extend(loader.load())
    return docs

# 目标文件夹
tar_dir = [
    "/root/autodl-tmp/self-llm",
    "/root/autodl-tmp/llm-universe",
    "/root/autodl-tmp/prompt-engineering-for-developers",
    "/root/autodl-tmp/so-large-lm",
    "/root/autodl-tmp/hugging-llm",
]

# 加载目标文件
docs = []
for dir_path in tar_dir:
    docs.extend(get_text(dir_path))

# 对文本进行分块
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500, chunk_overlap=150)
split_docs = text_splitter.split_documents(docs)

# 加载开源词向量模型
embeddings = HuggingFaceEmbeddings(model_name="autodl-tmp/sentence-transformer")

# 构建向量数据库
# 定义持久化路径
persist_directory = 'data_base/vector_db/chroma'
# 加载数据库
vectordb = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory=persist_directory  # 允许我们将persist_directory目录保存到磁盘上
)
# 将加载的向量数据库持久化到磁盘上
vectordb.persist()

from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM

class ChatGLM_LLM(LLM):
    # 基于本地 InternLM 自定义 LLM 类
    tokenizer : AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, model_path :str):
        # model_path: InternLM 模型路径
        # 从本地初始化模型
        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
        self.model = AutoModelForCausalLM.from_pretrained(model_path, trust_remote_code=True).to(torch.bfloat16).cuda()
        self.model = self.model.eval()
        print("完成本地模型的加载")
    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):
        # 重写调用函数
        response, history = self.model.chat(self.tokenizer, prompt , history=[])
        return response

    @property
    def _llm_type(self) -> str:
        return "ChatGLM3-6B"


from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
import os

# 定义 Embeddings
embeddings = HuggingFaceEmbeddings(model_name="autodl-tmp/sentence-transformer")

# 向量数据库持久化路径
persist_directory = 'data_base/vector_db/chroma'

# 加载数据库
vectordb = Chroma(
    persist_directory=persist_directory,
    embedding_function=embeddings
)

from LLM import ChatGLM_LLM
llm = ChatGLM_LLM(model_path = "autodl-tmp/ZhipuAI/chatglm3-6b")
llm.predict("你是谁")

from langchain.prompts import PromptTemplate

# 我们所构造的 Prompt 模板
template = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答案。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
{context}
问题: {question}
有用的回答:"""

# 调用 LangChain 的方法来实例化一个 Template 对象,该对象包含了 context 和 question 两个变量,在实际调用时,这两个变量会被检索到的文档片段和用户提问填充
QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],template=template)
最后,可以调用 LangChain 提供的检索问答链构造函数,基于我们的自定义 LLM、Prompt Template 和向量知识库来构建一个基于 InternLM 的检索问答链:
from langchain.chains import RetrievalQA

qa_chain = RetrievalQA.from_chain_type(llm,retriever=vectordb.as_retriever(),return_source_documents=True,chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})
得到的 qa_chain 对象即可以实现我们的核心功能,即基于 InternLM 模型的专业知识库助手。我们可以对比该检索问答链和纯 LLM 的问答效果:
# 检索问答链回答效果
question = "什么是 Self LLM"
result = qa_chain({"query": question})
print("检索问答链回答 question 的结果:")
print(result["result"])

# 仅 LLM 回答效果
result_2 = llm(question)
print("大模型回答 question 的结果:")
print(result_2)
10
部署 Web Demo
在完成上述核心功能后,我们可以基于 Gradio 框架将其部署到 Web 网页,从而搭建一个小型 Demo,便于测试与使用。
我们首先将上文的代码内容封装为一个返回构建的检索问答链对象的函数,并在启动 Gradio 的第一时间调用该函数得到检索问答链对象,后续直接使用该对象进行问答对话,从而避免重复加载模型:
from langchain.vectorstores import Chroma
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
import osfrom LLM import ChatGLM_LLM
from langchain.prompts import PromptTemplate
from langchain.chains import RetrievalQA

def load_chain():
    # 加载问答链
    # 定义 Embeddings
    embeddings = HuggingFaceEmbeddings(model_name="autodl-tmp/sentence-transformer")

    # 向量数据库持久化路径
    persist_directory = 'data_base/vector_db/chroma'

    # 加载数据库
    vectordb = Chroma(
        persist_directory=persist_directory,  # 允许我们将persist_directory目录保存到磁盘上
        embedding_function=embeddings
    )

    # 加载自定义 LLM
    llm = ChatGLM_LLM(model_path = "autodl-tmp/ZhipuAI/chatglm3-6b")

    # 定义一个 Prompt Template
    template = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答
    案。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
    {context}
    问题: {question}
    有用的回答:"""

    QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],template=template)

    # 运行 chain
    qa_chain = RetrievalQA.from_chain_type(llm,retriever=vectordb.as_retriever(),return_source_documents=True,chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})

    return qa_chain
接着我们定义一个类,该类负责加载并存储检索问答链,并响应 Web 界面里调用检索问答链进行回答的动作:
class Model_center():
    """
    存储检索问答链的对象
    """
    def __init__(self):
        # 构造函数,加载检索问答链
        self.chain = load_chain()
    def qa_chain_self_answer(self, question: str, chat_history: list = []):
        """
        调用问答链进行回答
        """
        if question == None or len(question) < 1:
            return "", chat_history
        try:
            chat_history.append(
                 (question, self.chain({"query": question})["result"]))
            # 将问答结果直接附加到问答历史中,Gradio 会将其展示出来
            return "", chat_history
        except Exception as e:
            return e, chat_history
然后我们只需按照 Gradio 的框架使用方法,实例化一个 Web 界面并将点击动作绑定到上述类的回答方法即可:
import gradio as gr

# 实例化核心功能对象
model_center = Model_center()
# 创建一个 Web 界面
block = gr.Blocks()
with block as demo:
    with gr.Row(equal_height=True):
        with gr.Column(scale=15):
            # 展示的页面标题
            gr.Markdown("""<h1><center>Self LLM</center></h1>
                <center>Self LLM</center>
                """)

    with gr.Row():
        with gr.Column(scale=4):
            # 创建一个聊天机器人对象
            chatbot = gr.Chatbot(height=450, show_copy_button=True)
            # 创建一个文本框组件,用于输入 prompt。
            msg = gr.Textbox(label="Prompt/问题")

            with gr.Row():
                # 创建提交按钮。
                db_wo_his_btn = gr.Button("Chat")
            with gr.Row():
                # 创建一个清除按钮,用于清除聊天机器人组件的内容。
                clear = gr.ClearButton(
                    components=[chatbot], value="Clear console")

        # 设置按钮的点击事件。当点击时,调用上面定义的 qa_chain_self_answer 函数,并传入用户的消息和聊天历史记录,然后更新文本框和聊天机器人组件。
        db_wo_his_btn.click(model_center.qa_chain_self_answer, inputs=[
                            msg, chatbot], outputs=[msg, chatbot])

    gr.Markdown("""提醒:<br>
    1. 初始化数据库时间可能较长,请耐心等待。
    2. 使用中如果出现异常,将会在文本输入框进行展示,请不要惊慌。<br>
    """)
gr.close_all()
# 直接启动
demo.launch()
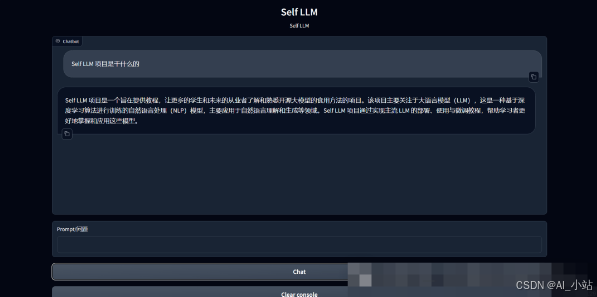
通过将上述代码封装为 run_gradio.py 脚本,直接通过 python 命令运行,即可在本地启动知识库助手的 Web Demo,默认会在 7860 端口运行,使用类似于部署的方式将服务器端口映射到本地端口即可访问:
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

二、AI大模型视频教程

三、AI大模型各大学习书籍

四、AI大模型各大场景实战案例

五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 963


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


