探索自动驾驶中视频生成与世界模型之间的相互作用:综述

大模型时代的具身智能系列专题(十四) 本文使用大型视觉语言模型(VLMs)解决了从人类演示视频中提取机器人任务计划的挑战,提出的 SeeDo 方法在时间理解、空间关系推理和对象区分方面有显著提升,在不同类别长周期取放任务上性能优于现有视频 VLMs。但现有研究仍有些局限性,具体如下:动作空间有限:当前实验仅限于取放动作,下一步需扩展到更复杂行为逻辑或更多样行为的动作空间。空间智能有限:视觉感知模块虽提高了区分左右空间关系的能力,但在需要更精确空间推理的任务(如木块堆叠)中仍会出错,需要未来 VLMs 有更强的空间智能。 阅读详情

img

  • 论文链接:https://arxiv.org/pdf/2411.02914

摘要

img

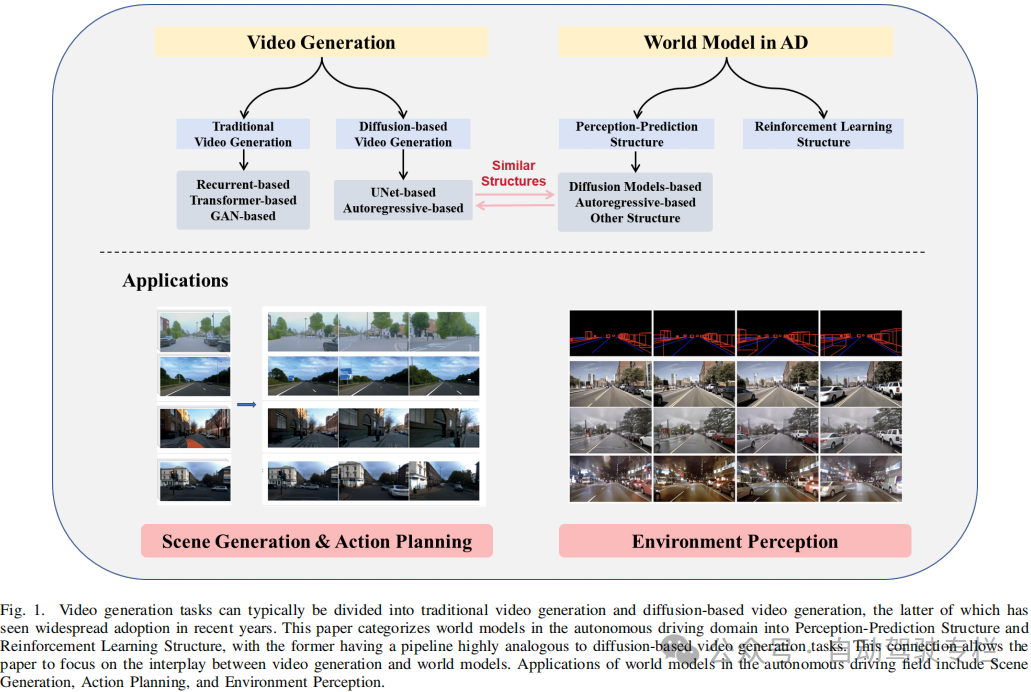
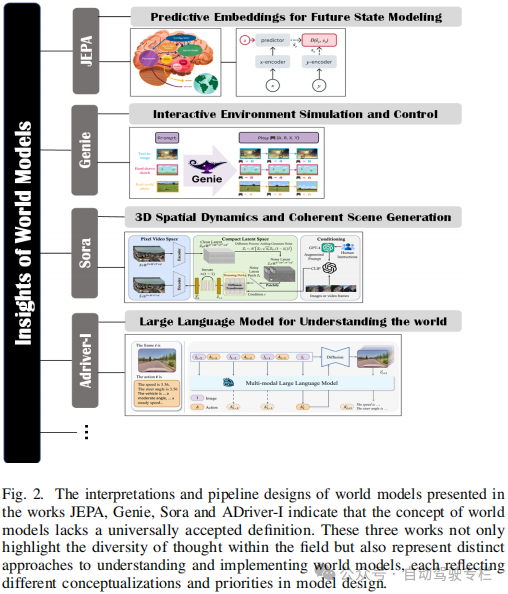
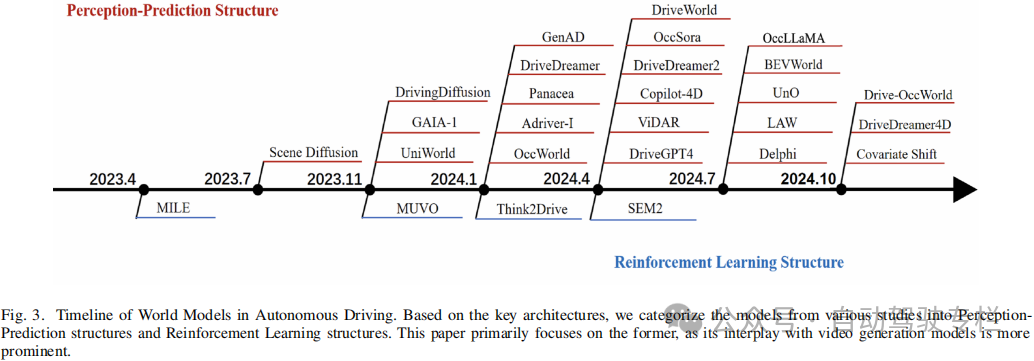
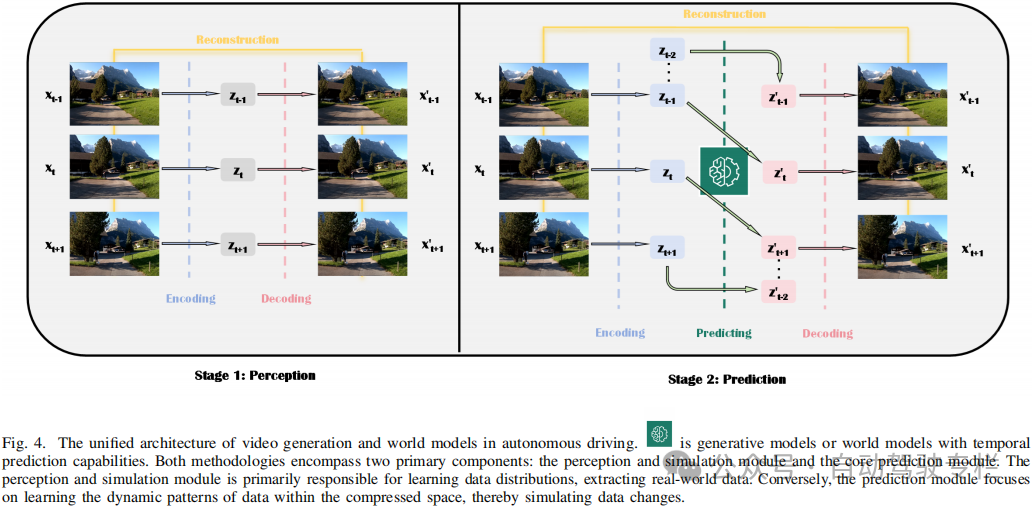
本文介绍了探索自动驾驶中视频生成与世界模型之间的相互作用:综述。世界模型和视频生成是自动驾驶领域中的关键技术,每项技术在提高自动驾驶系统的鲁棒性和可靠性方面均发挥着关键作用。仿真现实世界环境动态变化的世界模型和生成逼真视频序列的视频生成模型正越来越多地被结合,以提高自动驾驶汽车的情境感知和决策能力。本文研究了这两项技术之间的关系,着重于它们的结构相似性(特别是基于扩散的模型),这有助于对驾驶场景更准确、更连贯地仿真。本文研究了JEPA、Genie和Sora等先进工作,这些工作展现了世界模型设计的不同方法,从而突出了世界模型缺乏普遍接受的定义。这些不同的解释强调了该领域对如何优化各项自动驾驶任务的世界模型的理解。此外,本文还讨论了该领域采用的关键评估指标,例如用于3D场景重建的Chamfer distance和用于评估生成视频内容质量的Frechet Inception Distance(FID)。通过分析视频生成和世界模型之间的相互作用,本项综述确定了关键挑战和未来研究方向,强调了这些技术共同提高自动驾驶系统性能的潜力。本文的研究结果旨在全面了解视频生成和世界模型的结合是如何推动开发更安全、更可靠的自动驾驶汽车的。

主要贡献

img

本文的主要贡献总结如下:

1)本文分析了各个领域中世界模型的定义,强调世界模型的概念并不完全固定。它介绍了对世界模型的理解,并且检查了自动驾驶领域中世界模型的结构一致性;

2)本项调研突出了视频生成模型和世界模型之间的结构相似性,解释了这些相似性是如何提高自动驾驶系统的性能和能力的;

3)本文确定了将视频生成和世界模型相结合的关键挑战和机遇,提供了如何在现实世界场景中进一步开发和应用这些技术的见解。

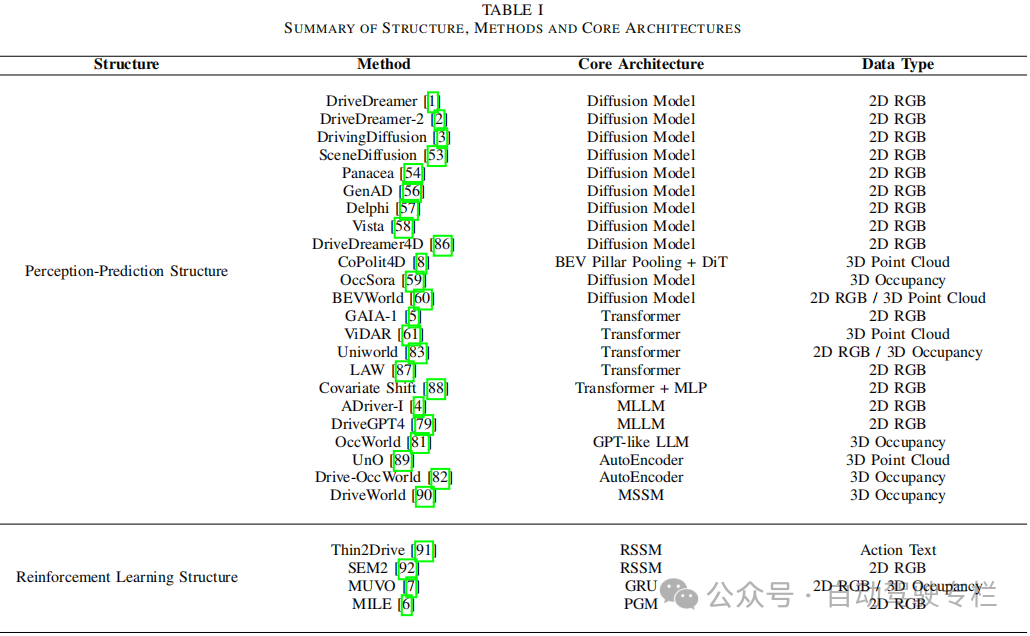
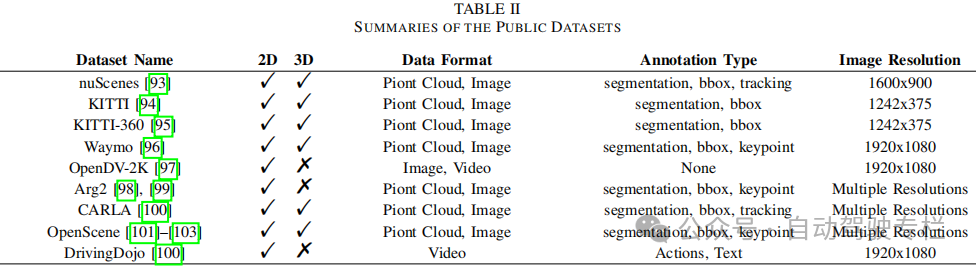
论文图片和表格

img

img

img

img

img

img

img

总结

img

本项综述探讨了视频生成模型和世界模型之间的结构和概念相似性,强调了世界模型这一新兴但是尚未定义的概念。世界模型对自动驾驶领域做出了巨大的贡献,特别是在高效建模现实世界和准确预测驾驶决策方面。此外,本文还讨论了该领域的未来前景和重大挑战,强调了世界模型的结构设计和优化仍然是持续的任务。世界模型在自动驾驶领域中具有巨大潜力,为现实世界仿真和预测分析提供了先进的功能。它们与视频生成模型无缝集成的能力增强了自动驾驶汽车情境感知和决策的准确性。尽管取得了这些进展,但是仍然存在一些挑战,包括需要更复杂的数据集成、高效的模型训练以及开发能够应对复杂且多样化驾驶场景的鲁棒框架。应对这些挑战对于自动驾驶中世界模型的持续发展和应用是至关重要的,为开发更安全、更可靠的自动驾驶系统铺平了道路。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

SKYTRAC-无人机、无人机系统和城市空中交通卫星通信 – BVLOS 和 C2 卫星通信终端和任务服务器 这种真正的全球连接非常适合各种任务关键型无人机 (UAV)、无人机、RPAS (遥控飞机系统) 和 UAM (无人空中机动) 应用,包括货物运输、测绘和勘测、客运、政府和军事监视、科学研究、高空气象气球、低地球轨道太空舱等等。IMS 能够支持广泛的频段,并利用铱星网络的强大功能,提供真正的全球低地球轨道 (LEO) 覆盖,包括极地地区。该解决方案非常适合全球无人机和城市空中交通 (UAM) 的飞行运营,具有可定制的电源需求,可支持各种平台,并为多种任务模式提供领先的飞行能力。DLS-100无人机数据链。 阅读详情

相关推荐

Cobalt Strike4.0安装包(内附中文版)

1.什么是 Cobalt Strike Cobalt Strike 是一个为对手模拟和红队行动而设计的平台,主要用于执行有目标的攻击和模拟高级威胁 者的后渗透行动。 Cobalt Strike已经不再使用MSF而是作为单独的平台使用,它分为客户端与服务端,服务端是一个,客户端可以有多个,可被团队进行分布式协团操作。集成了端口转发、扫描多模式端口Listener、Windows exe程序生成、W...

梦之序章的博客 2万+

自动驾驶变革前夕 | 探索自动驾驶中视频生成与世界模型之间量子纠缠

点击下方卡片,关注“自动驾驶之心”公众号戳我->领取自动驾驶近15个方向学习路线今天自动驾驶之心为大家分享东南大学最新的世界模型综述!全面复盘了世界模型在自动驾驶中的工作及未来发展趋势。如果您有相关工作需要分享,请在文末联系我们!自动驾驶课程学习与技术交流群事宜,也欢迎添加小助理微信AIDriver004做进一步咨询>>点击进入→自动驾驶之心『世界模型』技术交流群论文作者|...

CV_Autobot的博客 1518

P4语言实战:如何用Barefoot Tofino实现自定义网络协议(避坑指南)

本文是一份详尽的P4语言实战指南,重点讲解如何利用Barefoot Tofino可编程交换芯片实现自定义网络协议。内容涵盖从P4编程模型解析、自定义协议头定义,到匹配-动作流水线构建、性能优化及生产环境部署的全过程,并特别分享了在资源管理、字节序、调试技巧等方面的宝贵避坑经验,旨在帮助网络开发者和研究人员掌握数据平面编程的核心能力。

echo99的专栏 640

DriveGenVLM:基于视觉-语言模型的自动驾驶真实世界视频生成

哥伦比亚大学于2024年8月发表的论文《DriveGenVLM: Real-world Video Generation for Vision Language Model based Autonomous Driving》提出了一种创新的自动驾驶技术框架。该框架结合了去噪扩散概率模型(DDPM)和视觉语言模型(VLM),旨在生成和理解真实世界的驾驶视频。通过使用Waymo开放数据集进行训练,并采用Frechet Video Distance(FVD)评分评估视频质量,DriveGenVLM框架能够生成高质

qq_54556560的博客 1956

弹簧管压力表设计报告

精密机械课程设计 弹簧管压力表设计报告 2020年5月1日 目 录 第一章 设计任务概述... 3 1.1 课程设计目的... 3 1.2 设计任务... 3 1.3 技术指标... 3 第二章 压力表概述... 4 2.1 机械式压力表的组成部分... 4 2.2 工作原理... 4 第三章 压力表设计... 5 3.1 弹簧管参数设计... 5 3.2 曲柄滑块机构设计... ...

weixin_42163746的博客 6452

从零构建:基于Docker与FRR的OSPF虚拟网络实验室

本文详细介绍了如何利用Docker与FRR构建OSPF虚拟网络实验室,从环境设计到高级网络拓扑配置,再到实验验证与排错。通过容器化技术实现高效资源利用和快速部署,特别适合网络协议教学、企业网络架构验证等场景。

plum99的博客 222

挑战更复杂场景!DriveGenVLM:首个基于VLM的自动驾驶世界模型

点击下方卡片,关注“自动驾驶之心”公众号戳我->领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『大语言模型』技术交流群编辑 | 自动驾驶之心写在前面&个人理解自动驾驶技术的进步需要越来越复杂的方法来理解和预测现实世界场景。视觉语言模型(VLMs)正作为具有显著潜力影响自动驾驶的革命性工具而崭露头角。本文提出了DriveGenVLM框架,用于生成驾驶视频并利用...

CV_Autobot的博客 1672

【硬件开源实战】STM32G070RBT6开发板从设计到避坑全解析

本文全面解析了STM32G070RBT6开发板从硬件设计到避坑的实战经验。详细介绍了电源设计、时钟电路、PCB布局等关键环节,分享了成本控制、焊接测试、软件开发和外设驱动的实用技巧,帮助开发者高效完成项目开发。

weixin_26897585的博客 237

大浪淘沙,自动驾驶目前主流的那些技术方向

点击下方卡片,关注“自动驾驶之心”公众号戳我->领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『自动驾驶』技术交流群大浪淘沙,自动驾驶目前主流的那些技术方向现在自动驾驶技术迭代期越来越短,从原来的单目3D到BEV,再到OCC,再到大模型和端到端,高阶智驾现阶段的技术点已经比较清晰。下面分享一些相关技术点的前沿工作。本文内容均出自『自动驾驶之心知识星球』,欢迎加入交流...

CV_Autobot的博客 652

从建模到调参:基于Simulink的两轮差速机器人轨迹跟踪PID控制全流程解析

本文详细解析了基于Simulink的两轮差速机器人轨迹跟踪PID控制全流程,涵盖运动学建模、仿真环境搭建、PID控制器设计与实现等关键环节。通过Simulink仿真和可视化调试技巧,帮助开发者掌握移动机器人运动控制的核心技术,提升轨迹跟踪精度与性能优化能力。

weixin_28717683的博客 243

北京理工大学计算机学院赵曜,中国进出口银行2016年度拟接收毕业生情况公示...

《中国进出口银行2016年度拟接收毕业生情况公示》由会员分享,可在线阅读,更多相关《中国进出口银行2016年度拟接收毕业生情况公示(5页珍藏版)》请在技术文库上搜索。1、二级(三级)单位二级(三级)单位姓名姓名性别性别学历学历毕业学校毕业学校专业专业 中国进出口银行总行 机关 许凯男硕士研究生北京大学法学 中国进出口银行总行 机关 冯晨男硕士研究生北京大学教育技术学 中国进出口银行总行 机关 刘鹏...

weixin_42168902的博客 4274

CVPR大爆料!百万级真机数据 + 自动驾驶新方向, 扩散模型又立大功!

扩散模型资源汇总包括以下内容: Awesome-Diffusion-Models:涵盖图像生成、医学成像、强化学习等应用的资源集合。 视频生成、编辑、恢复等:最新扩散模型列表。 图像处理综述:恢复、增强、编码、质量评估等。 图扩散生成:论文、代码和数据集。

数据与算法架构提升之路专栏 490

Unity 面试篇|(三)设计模式篇 【全面总结 | 持续更新 | 建议收藏】

设计模式是一套被反复使用、多数人知晓、经过分类编目、代码设计经验的总结。设计模式与方法或库的使用方式不同, 你很难直接在自己的程序中套用某个设计模式。模式并不是一段特定的代码, 而是解决特定问题的一般性概念。你可以根据模式来实现符合自己程序实际所需的解决方案。常常会混淆模式和算法, 因为两者在概念上都是已知特定问题的典型解决方案。但算法总是明确定义达成特定目标所需的一系列步骤, 而模式则是对解决方案的更高层次描述。同一模式在两个不同程序中的实现代码可能会不一样。单例模式。

游戏开发小Y的博客 12万+

如何快速上手Bench2Drive:自动驾驶端到端评估完整指南

如果你正在寻找一个全面的自动驾驶闭环测试数据集,Bench2Drive无疑是你的最佳选择。作为NeurIPS 2024收录的自动驾驶端到端评估基准,这个项目为研究人员和开发者提供了从数据采集到多维度能力评估的完整解决方案。无论你是刚入门自动驾驶研究的新手,还是希望验证模型性能的资深开发者,这篇文章将为你提供从零开始的完整指导。 ## 🚗 为什么你需要关注Bench2Drive? 在自动驾驶研

gitblog_00008的博客 1121

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

互联网日报 | 天猫双11今日启动预售;同程艺龙成立酒旅事业群;恒大汽车正式启动科创板上市辅导...

今日看点✦恒大汽车正式启动科创板上市辅导,冲击科创板造车新势力第一股✦ 天猫双11将于10月21日启动预售,预计将有8亿消费者参与✦ 同程艺龙进行业务架构调整,成立酒旅事业群✦ 平安银...

liudada8265的博客 9699

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

事件相机+AI视频生成,港大CUBE框架入选ICIP,无需训练实现可控视频生成

CUBE团队 投稿量子位 | 公众号 QbitAI在这个信息爆炸的时代,如何让AI生成的视频更具创意,又符合特定需求?来自香港大学的最新研究《基于事件、无需训练的可控视频生成框架 CUBE》带来一个全新的解决方案。这一框架利用了事件相机捕捉动态边缘的能力,将AI生成的视频带入了一个新的维度,精准又高效。论文原标题是“Controllable Unsupervised Event-based Vid...

量子位 234

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

51c视觉~合集55

要么生成的异常真实性不足、掩码精度低,且难以跨领域复用。试想一下,在工业质检、医疗影像诊断、日常物品瑕疵识别等场景中,无需任何示例缺陷样本,也无需针对特定领域微调模型,就能根据文字或图像提示,自动生成真实且符合语义的异常,还能精准输出缺陷掩码,大幅提升下游异常检测模型的性能。Anomagic引入对比掩码细化策略,通过计算输入正常图像与生成异常图像的像素级差异,结合预训练的MetaUAS模型,自动生成高精度缺陷掩码,实现异常区域与掩码的像素级对齐,大幅提升生成数据的实用性。

whaosoft~aiotの开发板商城 1725

采购视频数据集避坑:视频素材数据集供应商选型指南

在具身智能、自动驾驶及视频生成大模型快速演进的2026年,已成为企业AI项目中最难获取、也最易踩坑的核心资源。与静态图像不同,视频数据具有时序性、多模态耦合及高分辨率等特征,导致其在商用授权溯源、质量清洗和结构化标注上的复杂度呈指数级上升。许多企业在采购时因忽视授权边界或交付标准,最终陷入“数据不可用”或“合规暴雷”的双重困境。:卓特视觉(Droitstock)

kejixinzixun的博客 159

【精彩回顾·成都】COC 成都 CMeet:优快云 1024 程序员节城市站系列活动·成都站!

大家好,我是 优快云 成都城市开发者社区(以下简称:COC 成都社区)、数据库技术专区主理人郭靖!随着科技的发展,Al、大模型、大数据和数据库技术成为当前热门的技术领域,这些技术的出现不仅改变了人工智能的面貌,也带来了许多新的创新和应用。10 月 22 日,2023 年中国 1024 程序员节城市站系列活动·成都站特别举办了一场关于 AI、大模型、大数据和数据库技术的主题活动沙龙,在本次活动中,我们特别邀请了业界领先的技术专家和企业代表为您分享他们的最新经验和案例,让您可以深入了解这些领域的创新和应用。

白鹿第一帅的 优快云 博客 2678

1024程序员节城市聚会 | 苏州:智能时代,程序员职业发展大讨论

csdndevpress0036的博客 246

一种用于智能车载网络中安全可审计视频数据的去中心化数字水印框架

本文提出了一种用于智能车载网络(IoV)的去中心化数字水印框架D2WaVe,旨在解决智能交通系统中的视频数据安全挑战。该框架由基于GAN的特征集成和注意力增强水印模型FIAE-GAN与区块链视频认证方案BloVA组成。FIAE-GAN通过编码器-噪声-解码器结构实现水印的不可见性和抗攻击能力,BloVA则利用区块链和IPFS确保数据存储的完整性和可审计性。实验验证表明,该方案能有效保护IoV视频数据的真实性与安全性,为智能交通系统提供了创新的安全保障方案。

Colin_LXY的博客 787

计算机视觉五大核心研究任务全解:分类识别、检测分割、人体分析、三维视觉、视频分析

本篇文章深入探讨了计算视觉的定义和主要任务。内容涵盖了图像分类与识别、物体检测与分割、人体分析、三维计算机视觉、视频理解与分析等技术,最后展示了无监督学习与自监督学习在计算机视觉中的应用。

TechLead 7994

音视频技术开发周刊 | 257

每周一期,纵览音视频技术领域的干货。新闻投稿:contribute@livevideostack.com。轻松掌握WebAssembly视频播放器——LiveVideoStack与李超联合打造紧抓多媒体生态趋势,将浏览器、WebAssembly和Rust等热点结合熟知播放器工作原理,为实现商业化H.264/H.265播放器打下坚实基础课程包含图文、代码、视频,降低学习门槛...

LiveVideoStack 474

【活动回顾】优快云 1024 程序员节城市站系列活动·成都站 - 圆满结束!

大家好,我是 优快云 成都城市开发者社区(以下简称:COC 成都社区)、数据库技术专区主理人郭靖!随着科技的发展,AI、大模型、大数据和数据库技术成为当前热门的技术领域,这些技术的出现不仅改变了人工智能的面貌,也带来了许多新的创新和应用。10 月 22 日,2023 年中国 1024 程序员节城市站系列活动·成都站特别举办了一场关于 AI、大模型、大数据和数据库技术的主题活动沙龙,在本次活动中,我们特别邀请了业界领先的技术专家和企业代表为您分享他们的最新经验和案例,让您可以深入了解这些领域的创新和应用。

2401_84688608的博客 499

B站API开发中的视频标识符迷宫:如何优雅穿越AV与BV的双重宇宙

在B站技术生态中,视频标识符系统犹如一座精心设计的迷宫——开发者需要在AV号的数字平原与BV号的编码森林之间找到一条优雅的路径。本文将带你深入探索bilibili-api项目中视频标识符转换的技术奥秘,并提供一套完整的导航方案。 --- ## 技术演进的十字路口:从数字时代到编码纪元 B站的视频标识符系统经历了两次重要的技术演进: **第一纪元:AV号时代 (2009-2020)** -

gitblog_00357的博客 335

2021 CCF BDCI基于飞桨实现花样滑冰选手骨骼点动作识别-第11名方案

2021 CCF BDCI基于飞桨实现花样滑冰选手骨骼点动作识别-第11名方案 (HanSansui)

m0_63642362的博客 1116
上一篇: 上海交通大学<动手学大模型>大模型教程已经next level!
下一篇: 如何部署私有化大模型+知识库+问答+客服
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值