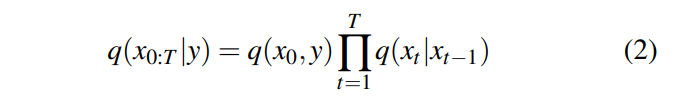挑战更复杂场景!DriveGenVLM:首个基于VLM的自动驾驶世界模型

VLM视觉语言大模型在智能驾驶中的应用 即带条件的目标检测,用语言指示模型识别图像中特定目标。和Object Referring相比,Object Referring Tracking会根据自然语言描述在连续帧中对目标进行跟踪。开放式3D目标检测,利用VLM的zero-shot能力检测场景中在白名单之外的目标类型。交通场景视觉问答,这需要vlm的高维场景理解能力。自动驾驶领域的问答可以划分为感知、规划、空间推理、时序推理、因果逻辑推理。感知问题可以用来识别交通参与者,如外观描述、存在性、数量、状态等。 阅读详情
AI摘要

本文提出DriveGenVLM框架用于自动驾驶,结合视频生成与视觉语言模型(VLMs)。采用基于DDPM的视频生成框架,用Waymo开放数据集训练,通过FVD评分评估。利用EILEV预训练模型为生成视频提供叙述。实验表明,自适应层次 - 2采样方法最优,生成视频可用于VLMs算法。

点击下方卡片,关注“自动驾驶之心”公众号

戳我-> 领取自动驾驶近15个方向学习路线

>>点击进入→自动驾驶之心『大语言模型』技术交流群

编辑 | 自动驾驶之心

写在前面&个人理解

自动驾驶技术的进步需要越来越复杂的方法来理解和预测现实世界场景。视觉语言模型(VLMs)正作为具有显著潜力影响自动驾驶的革命性工具而崭露头角。本文提出了DriveGenVLM框架,用于生成驾驶视频并利用VLMs进行理解。为实现这一目标,采用了一种基于去噪扩散概率模型(DDPM)的视频生成框架,旨在预测现实世界中的视频序列。随后,利用一种称为“基于第一人称视频的高效上下文学习”(EILEV)的预训练模型,探索了生成的视频在VLMs中使用的充分性。该扩散模型使用Waymo开放数据集进行训练,并通过FVD评分进行评估,以确保生成视频的质量和真实性。EILEV为这些生成的视频提供了相应的叙述,这可能在自动驾驶领域带来益处。这些叙述可以增强对交通场景的理解,辅助导航,并提高规划能力。DriveGenVLM框架中将视频生成与VLMs相结合,标志着在利用先进AI模型解决自动驾驶复杂挑战方面迈出了重要一步。

当前领域背景概述

自动驾驶领域中将先进的预测模型集成到车辆系统或交通系统中,对于提高安全性和效率变得越来越关键。在众多的传感技术中,基于camera的视频预测脱颖而出,成为了一个核心组成部分,它提供了动态且丰富的现实世界数据源。通过采用前沿的扩散模型方法,本研究不仅促进了自动驾驶技术的发展,还为在提升车辆安全性和导航精度方面应用预测模型设立了新的基准。

目前,AI生成的内容是计算机视觉和人工智能领域的主要研究方向之一。由于内存和计算时间的限制,生成逼真且连贯的视频是一个具有挑战性的领域。在自动驾驶领域,从车辆前置camera预测视频尤为重要,这在自动驾驶和高级驾驶辅助系统(ADAS)的上下文中尤为关键,本文利用车辆周围camera的视频来预测未来的帧。

生成模型也已被应用于交通和自动驾驶领域,这些模型因其理解驾驶环境的能力而越来越受到认可。目前,视觉语言模型(VLMs)正被用于自动驾驶应用。为了提高VLMs的实用性并探索生成模型在VLMs中视频内容的应用,验证生成模型的预测以确认其在现实场景中的相关性和准确性至关重要。DriveGenVLM引入了上下文中的VLM作为一种方法,通过提供驾驶场景的文本描述来验证基于扩散的生成模型预测的视频。

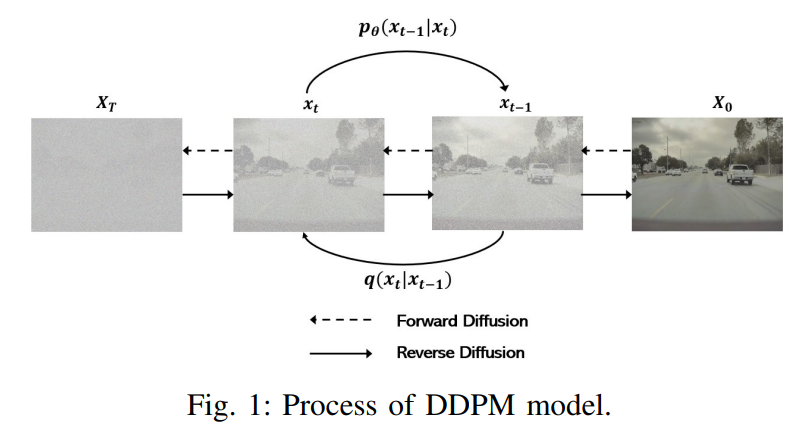
扩散模型是一类深度生成模型,其特点主要包括两个阶段:(i)前向扩散阶段,其中初始数据通过在多个步骤中添加高斯噪声而逐渐被破坏;(ii)反向扩散阶段,其中生成模型旨在通过逐步学习反转扩散过程来从添加噪声的版本中重建原始数据,逐步进行。去噪扩散概率模型(DDPM)是一种常见的生成模型类型,旨在通过扩散过程学习和生成特定的目标概率分布。DDPM已被验证比传统的生成模型(如GANs和VAE)更为有效。

生成长视频需要大量的计算资源。一些工作通过基于自回归的模型克服了这一挑战。然而,自回归模型可能导致不现实的场景转换和长视频序列中的持续不一致性,因为这些模型缺乏从更长片段中同化模式的机会。为了克服这一点,MCVD 采用了一种训练方法,通过独立且随机地屏蔽所有先前或后续帧来为各种视频生成任务准备模型。同时,FDM 引入了一个基于扩散概率模型(DDPMs)的框架,该框架能够生成扩展的视频序列,并在不同设置下实现现实且连贯的场景完成。NUWAXL 介绍了一种“扩散之上的扩散”架构,旨在通过“粗到细”的方法生成扩展视频。

近年来,基于文本的大型语言模型(LLMs)的受欢迎程度急剧上升。此外,在自动驾驶领域还引入了各种生成式视觉语言模型(VLMs)。提出了RAGDriver ,以利用上下文学习来实现高性能、可解释的自动驾驶。我们利用EILEV 的上下文学习能力来生成驾驶场景的描述。在DriveGenVLM中,上下文VLMs使我们能够处理由扩散框架预测的视频,这些视频随后可以被其他基于视觉的模型识别,从而可能为自动驾驶中的决策算法做出贡献。据我们所知,DriveGenVLM是首个将视频生成模型和视觉语言模型(VLM)集成到自动驾驶领域的工作。

主要有那些创新点?

  1. 将条件去噪扩散概率模型应用于驾驶视频预测领域;

  2. 在Waymo开放数据集的不同camera角度下测试视频生成框架,以验证其在现实世界驾驶场景中的可行性。

  3. 利用上下文视觉语言模型生成预测视频的描述,并验证这些视频是否可应用于基于视觉语言模型的自动驾驶。

一些基础预备知识

1)DDPM

去噪扩散概率模型(Denoising Diffusion Probabilistic Model, DDPM)是一种在机器学习和计算机视觉领域备受关注的生成模型。DDPM通过一个前向过程将数据转换为噪声,以及一个后向过程从噪声中重建原始数据来工作。前向过程的目标是将任何数据转换为基本先验分布,而后续的目标则是开发转换核以撤销这种转换。为了生成新的数据点,首先从先验分布中抽取一个随机向量,然后通过反向马尔可夫链进行祖先采样。这种采样技术的关键在于训练反向马尔可夫链以准确复制前向马尔可夫链的时间反向进程。
750a6f6792ee1b7c24753a4721a7862c.png

对于条件扩展,其中建模的x依赖于观测值y。给定数据分布x0 ∼ q(x0),前向过程生成一系列随机变量x1, x2,..., xT。x0表示原始的无噪声数据,而x1则包含了少量的噪声。这个过程一直持续到xT,此时xT几乎与x0无关,并且类似于从单位高斯分布中抽取的随机样本。xt的分布仅依赖于xt−1,转移核是:
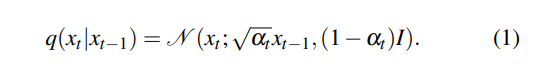
6bffb9f7d52c0a571b9f2535307f6d09.png

联合分布由等式2中的扩散过程和数据分布q(x0, y)定义。

1006d1a0848079059d5572f3dc9ed44d.png

将这些模型称为扩散概率模型(Diffusion Probabilistic Models,DPMs),这些模型通过反转扩散序列来工作。对于给定的xt和y,我们使用神经网络来估计θ,作为的近似。这个估计使我们能够通过从标准高斯分布中采样开始来获取的样本,这是因为扩散过程的初始状态类似于高斯分布。随后,我们通过θ从迭代地向后采样到。在给定y的条件下,采样得到的x0:T的联合分布可以表示为:
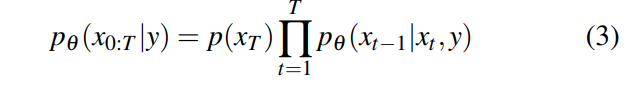
7a49a3af19c19a666249ba605972f5cd.png

在这里,表示与θ无关的单位高斯分布。训练条件DPM涉及调整θ,以使其在全范围的t、和y值上与紧密匹配。

2)在视觉语言模型(VLMs)上的上下文学习

In-context学习最初在GPT-3的论文中提出,它指的是模型能够在单次交互中根据提供的上下文学习或调整其响应的能力,而无需对其基础模型进行任何显式更新或再训练。

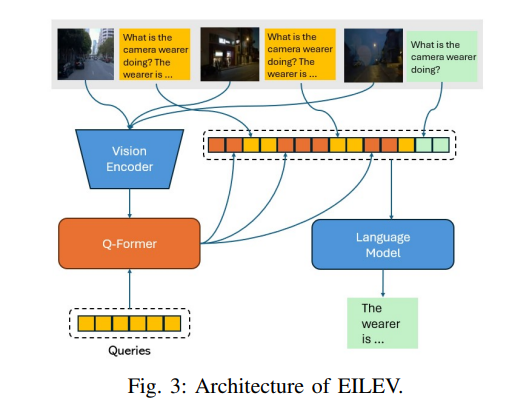
这里采用了EILEV,这是一种训练技术,旨在增强第一人称视频中的视觉语言模型(VLMs)的上下文学习能力。如图3所示,EILEV在交错上下文-查询场景下的架构涉及使用来自BLIP-2的未修改视觉transformer来处理视频片段。得到的压缩标记与初始上下文-查询实例序列中的文本标记混合。然后,将这些组合标记输入到BLIP-2的静态语言模型中,以生成新的文本标记。该方法可以泛化到分布外的视频和文本,以及通过上下文学习罕见的动作。我们利用预训练模型为驾驶视频生成语言叙述,以验证生成的结果是否可解释且现实。
d628ec00eb2b196f65b9aa970f303be1.png

DriveGenVLM方法

生成长时间、连贯且逼真的视频仍然是一个挑战。灵活扩散模型(Flexible Diffusion Model, FDM)通过使用条件生成模型来解决这个问题。在DriveGenVLM中,采用了类似的方法。为了采样具有大量帧的连贯视频,可以使用生成模型在少量帧的条件下采样任意长度的视频。我们的目标是在一些帧的条件下,采样出连贯且逼真的驾驶场景视频。这里采用了一种顺序程序,通过生成模型来采样任意长度的视频,该模型一次只能采样或基于少量帧进行条件处理。

广义上,我们将采样方案定义为一系列元组,其中每个元组由一个向量组成,表示要采样的帧的索引,以及一个向量,表示在阶段s = 1,...,S中用作条件的帧的索引。

1)训练框架

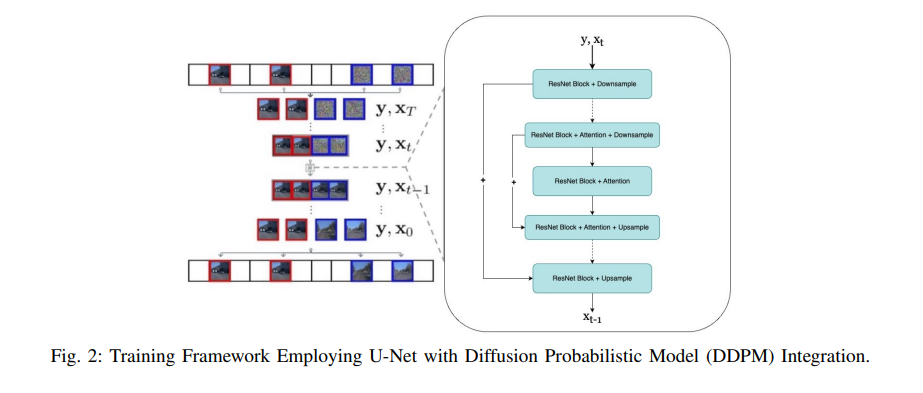
DDPM图像框架采用了U-net结构。该架构的特点是一系列层,这些层首先降低空间维度,然后再进行上采样,其间穿插着卷积残差网络块和专注于空间注意力的层。
0eb8feb8630de0fbf12f54429340f193.png

该架构如图2所示。DDPM迭代地将噪声XT转换为视频帧X0。带有红色边框的框表示条件。右侧显示了每个DDPM步骤的UNet架构。
5482bdcf4f583e16098cbd88efc1cd4c.png

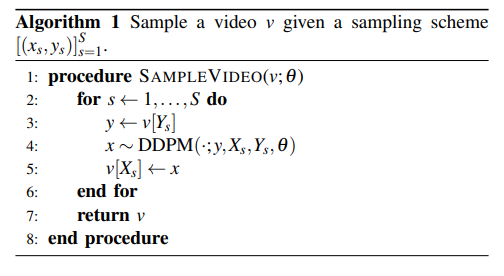
算法1展示了如何使用采样方案来采样视频。生成模型可以根据视频帧的其他子集来采样任何子集。模型可以生成任何选择的X和Y。

2)Sampling Schemes

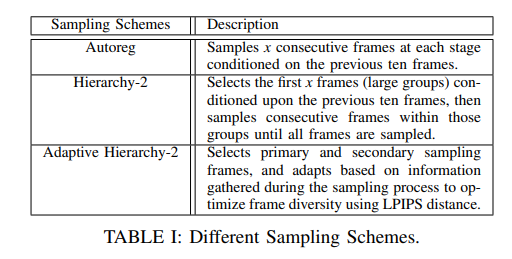
每种采样方案的相对效率在很大程度上取决于手头的数据集,且没有普遍最优的选择。在本文中,尝试了三种采样方案,如表I所示。第一个也是最直接的方案是Autoreg,它通过在每个步骤中对前十个帧进行条件设置来采样十个连续帧。另一个方案是Hierarchy2,它采用多层采样方法,第一层有十个等距选择的帧,覆盖视频中未观察到的部分,这些帧以十个观察到的帧为条件。在第二层中,以组为单位连续采样帧,同时考虑最近的先前帧和后续帧,直到所有帧都被采样。最后使用了Adaptive Hierarchy-2(Ad),这只能通过实现FDM来实现。Adaptive Hierarchy-2在测试期间战略性地选择条件帧,以优化帧多样性,这通过它们之间的成对LPIPS距离来衡量。
e9b64bc2ce8e107af96441924b5a3053.png

实验对比分析

1)数据集

Waymo-open数据集是一个广泛应用的数据集,它利用多种传感器来辅助自动驾驶技术的进步。该数据集包含来自Waymo自动驾驶汽车群组的高质量传感器数据,并由超过1000小时的视频组成。这些视频是通过各种传感器拍摄的,如激光雷达、雷达和五个camera(前后及侧面),它们始终提供汽车周围的完整视图,即我们所说的360度视野。这组数据有着非常细致的标注,包括车辆、行人、骑自行车者以及道路上其他物体的标记。这使得它对于该领域的研究人员或工程师来说非常有用,可以帮助他们提升自动驾驶汽车中的感知(理解)、预测(猜测接下来会发生什么)和模拟算法的技能。数据集V2格式旨在与Apache Parquet文件格式及其支持的组件一起使用。在这里,组件是一组相关的字段/列,它们是理解每个单独字段所必需的。

2)实验设置

为了验证算法在真实驾驶场景中的有效性,利用了Waymo开放数据集,该数据集涵盖了多个城市的不同真实世界环境。我们从数据集中提取了所有五个现有camera的数据。然后对数据集进行了预处理,并从三个camera(前camera、前左camera和前右camera)中提取了数据,总共处理了138个视频。其中,包含所有三个camera的108个视频被平均分配用于训练,而每个camera各有10个视频用于测试集。训练视频中发现的最大帧数为199帧,最小帧数为175帧左右。因此,将所有视频的帧数限制为175帧,分辨率降低到了128×128,并转换成了4D张量。

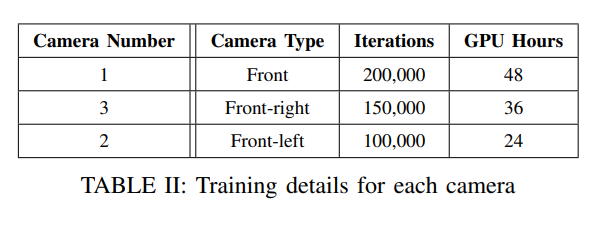
该模型在Debian GNU/Linux 11系统上运行,该系统配备了8核Intel Cascade Lake处理器和具有24GB内存的NVIDIA L4 GPU。我们使用了bs大小为1、学习率为0.0001的设置。每个camera训练的详细信息如表II所示。前camera是从头开始训练的,没有使用任何预训练权重,迭代了200,000次。前右camera使用了来自camera1的预训练权重,并训练了150,000次迭代,而前左camera则使用了来自camera3的预训练权重,训练了100,000次迭代。总共花费了108个GPU小时进行训练。
7bb6773d7d5ac2e9508f6ff6d3ebbc72.png

利用FVD(Frechet视频距离)评估,这是一种用于评估模型在视频生成或未来帧预测等任务中生成的视频质量的度量标准。类似于用于图像的Frechet Inception Distance(FID),FVD衡量生成视频分布与真实视频分布之间的相似性。FVD对于评估视频的时间一致性和视觉质量非常有用,因此它是视频合成模型基准测试的一个宝贵工具。

3)结果

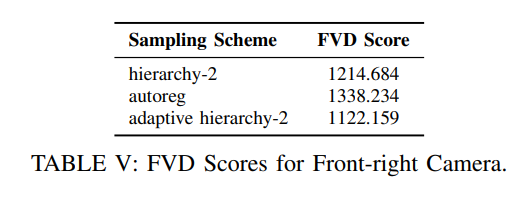
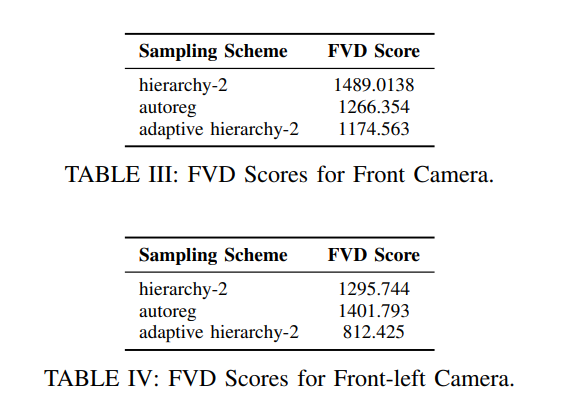
表III、表IV和表V总结了我们在Waymo开放数据集上对三个camera进行实验得到的FVD分数,这些实验采用了不同的采样方案。结果表明,自适应层次-2采样方法优于其他两种方法。
228217a21fa69b8cc723cd4ddc00862d.png 6a6029bb3092ae90f8e84a1998574f5f.png

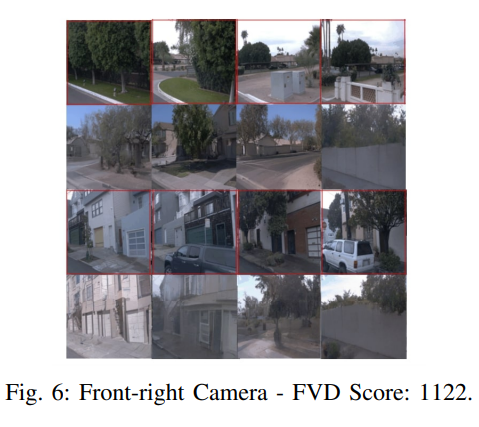
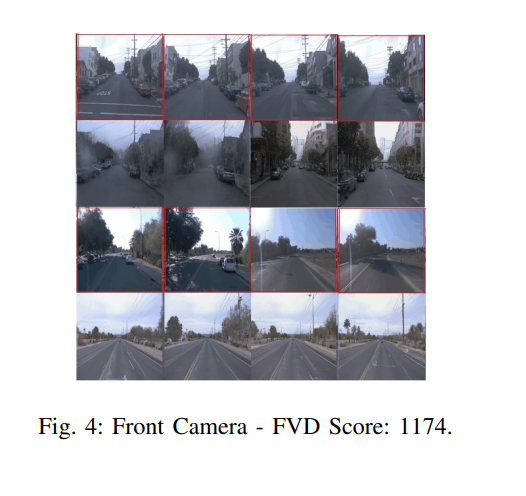
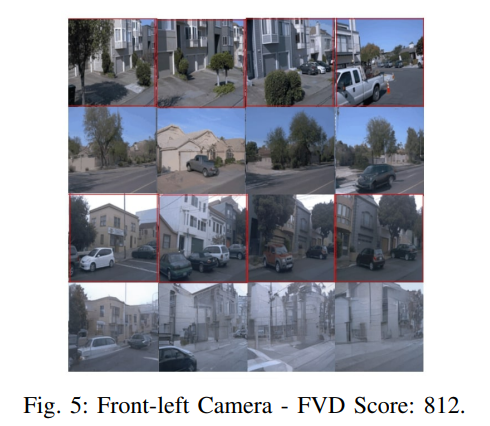
图4-6展示了使用自适应层次-2采样方案(产生最低FVD分数)为每个camera生成的预测视频。每个子图包含每个camera生成的2个视频示例。带有红色边界框的帧是真实帧,预测帧位于每个对应帧的下方。生成的视频以每个示例的前40帧为条件。
a9d04eab05b3c9088d7fcdf3e18f0fb9.png b93f1c3e5530d74398642dce810fb77e.png 8e5feb51533b31227509028abd189598.png

FDM在Waymo数据集上的训练展示了其在连贯性和逼真度方面的能力。然而,它仍然难以准确解释现实世界驾驶中的复杂逻辑,如交通和行人的导航。这种局限性很可能是由于现实场景中存在的额外挑战,这些挑战在模拟环境中是不存在的。

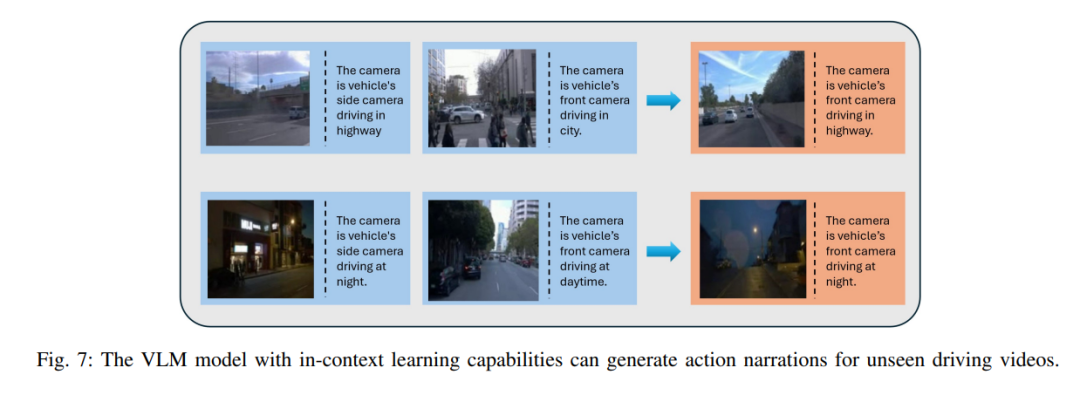
为了验证我们生成的视频是否可解释且可用于视觉语言模型,我们在Ego4D数据集上使用了预训练的EILEV模型,即eilev-blip2-opt-2.7b ,来测试我们生成的驾驶视频。我们利用了描述camera角度、驾驶环境和一天中时间的视频片段和文本对。结果如图7所示。模型生成的动作叙述显示在橙色框中。值得注意的是,前两个视频中没有共享任何动词和名词类别组合,如蓝色框所示。我们可以观察到,模型能够识别出车辆正在高速公路上行驶,且摄像头位于前方。对于第二个视频,模型识别出车辆正在夜间使用前置摄像头行驶。在VLMs上进行上下文学习预训练的模型与生成的模型配合良好,表明这些视频是可解释的,并且有可能被基于VLMs的算法所使用。
c02285849345baff916b5a8b7de442a6.png

参考

[1] DriveGenVLM: Real-world Video Generation for Vision Language Model based Autonomous Driving.

投稿作者为『自动驾驶之心知识星球』特邀嘉宾,欢迎加入交流!重磅,自动驾驶之心科研论文辅导来啦,申博、CCF系列、SCI、EI、毕业论文、比赛辅导等多个方向,欢迎联系我们!
7efc35dc3f2a0624fb89498d37d07153.jpeg

① 全网独家视频课程

BEV感知、BEV模型部署、BEV目标跟踪、毫米波雷达视觉融合、多传感器标定、多传感器融合、多模态3D目标检测、车道线检测、轨迹预测、在线高精地图、世界模型、点云3D目标检测、目标跟踪、Occupancy、cuda与TensorRT模型部署、大模型与自动驾驶、Nerf、语义分割、自动驾驶仿真、传感器部署、决策规划、轨迹预测等多个方向学习视频(扫码即可学习)
720d06210cde86b71ba69e67c364473f.png 网页端官网:www.zdjszx.com

② 国内首个自动驾驶学习社区

国内最大最专业,近3000人的交流社区,已得到大多数自动驾驶公司的认可!涉及30+自动驾驶技术栈学习路线,从0到一带你入门自动驾驶感知(2D/3D检测、语义分割、车道线、BEV感知、Occupancy、多传感器融合、多传感器标定、目标跟踪)、自动驾驶定位建图(SLAM、高精地图、局部在线地图)、自动驾驶规划控制/轨迹预测等领域技术方案、大模型、端到端等,更有行业动态和岗位发布!欢迎扫描下方二维码,加入自动驾驶之心知识星球,这是一个真正有干货的地方,与领域大佬交流入门、学习、工作、跳槽上的各类难题,日常分享论文+代码+视频
5a0e0a01f83ddf9e5a44a410b64b830c.png

③【自动驾驶之心】技术交流群

自动驾驶之心是首个自动驾驶开发者社区,聚焦感知、定位、融合、规控、标定、端到端、仿真、产品经理、自动驾驶开发、自动标注与数据闭环多个方向,目前近60+技术交流群,欢迎加入!扫码添加汽车人助理微信邀请入群,备注:学校/公司+方向+昵称(快速入群方式)
747b324f981c343ba573d470dd6df0af.jpeg

④【自动驾驶之心】全平台矩阵

d01c652ce95f4f56029eb981e63da2e4.png

可视化地思考:FutureSightDrive: Thinking Visually with Spatio-Temporal CoT for Autonomous Driving 视觉语言模型(VLMs)因其强大的推理能力,在自动驾驶领域受到日益广泛的关注。然而,现有VLMs通常采用针对特定场景设计的离散文本思维链(Chain-of-Thought, CoT),这种表征本质上是对视觉信息的高度抽象和符号化压缩,可能导致空间-时间关系模糊以及细粒度信息丢失。自动驾驶是否更适合通过真实世界模拟与想象建模,而非纯粹依赖符号逻辑?本文提出一种时空思维链(spatio-temporal CoT)推理方法,使模型可视化地思考。首先,VLM作为世界模型生成统一图像帧以预测未来世界状态:其中感知结果 阅读详情

相关推荐

VLM-3R深度剖析:如何让大模型从单目视频中“看见”三维世界

本文深度剖析了VLM-3R模型如何通过单目视频实现三维世界理解的技术突破。该模型结合Vision-Language Models和3D Reconstruction技术,利用隐式表征和端到端训练,实现了从二维视频到三维场景的实时转换。文章详细解析了其三大核心组件:空间编码器、视觉-空间融合和语言模型,并探讨了其在效率、泛化能力和人机交互方面的显著优势。

weixin_27872611的博客 242

DriveVLM

要想构建完全的自动驾驶系统,人们面临的主要挑战是 AI 的场景理解,这会涉及到复杂、不可预测的场景,例如恶劣天气、复杂的道路布局和不可预见的人类行为。具体来说,3D 感知仅限于检测和跟踪熟悉的物体,忽略了罕见物体及其属性, 运动预测和规划则关注物体的轨迹动作,通常会忽略物体和车辆之间的决策级交互。最近清华大学交叉信息研究院、理想汽车提交的新论文中,作者提出了 DriveVLM,受到最近生成式 AI 领域兴起的视觉语言模型(VLM)启发,DriveVLM 在视觉理解和推理方面表现出了非凡的能力。whaosof

whaosoft143ai的博客 1118

JetBrains Air:多Agent协同的IDE运行时架构解析

IDE智能编程正从单模型增强迈向多Agent协同范式。多Agent架构通过职责分离、上下文精简与运行时隔离,显著提升代码生成稳定性与合规性;其核心依赖轻量级嵌入式运行时(如ARL),支持AST级内存共享、eBPF安全拦截与毫秒级冷启动。该架构天然适配本地化部署、离线开发与高安全合规场景(如PCI-DSS、金融内网),并为Java/Python/TS等语言提供可扩展的规则驱动开发流水线。JetBrains Air正是这一技术路径的工程化落地代表。

weixin_30443075的博客 571

自动驾驶大模型方案:视觉语言模型VLM工作一览,面向量产和研究~

点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近30个方向学习路线视觉语言模型(Vision-Language Model, VLM) 正以其独特的跨模态理解与推理能力,成为赋能下一代自动驾驶系统的关键引擎。VLM的核心在于打通视觉与语言之间的壁垒,让自动驾驶不仅能“看见”道路,更能像人类一样“理解”场景、意图并进行深层次的推理。在自动驾驶的复杂环境中,VLM展现出强大的应用潜力:环境感知与深度理解: VLM能够超越传统视觉模型,结合相机图像或视频流,理解交通场景中的语义信息。例如,它不仅能

CV_Autobot的博客 1240

浅显易懂地看LLC变换器(三)

第3期 谐振与增益的定性关系 由简单的谐振电路说起 我们将以电感和电容的基本电路的特性逐渐了解谐振电路的特性 与电阻不同,电感和电容都不是纯阻性线性器件,电感的感抗XL和电容的容抗Xc都与频率有关,当加在电感和电容上的频率发生变化时,它们的感抗XL和容抗Xc会发生变化。 1) 如下图RL电路,当输入源Vin的频率增加时,电感的感抗增大,输出电压减小,增益Gain=Vo/Vin随频率增加而减小。 2) 如下图RC电路,相反,当输入源Vin的频率增加时...

iFTrue电力电子专栏 6739

逆向CarPlay协议时,除了USB主从切换,你还需要注意这3个关键点

本文深入探讨逆向CarPlay协议时的3个关键点,包括MFi协议背景、多通道协同工作机制和协议分析工具的高级过滤技巧。特别解析了USB主从切换后的复杂交互过程,帮助安全研究员和逆向工程师更好地理解CarPlay协议的核心机制与潜在安全研究切入点。

weixin_29164497的博客 382

DriveGenVLM:基于视觉-语言模型的自动驾驶真实世界视频生成

24年8月来自哥伦比亚大学的论文“DriveGenVLM: Real-world Video Generation for Vision Language Model based Autonomous Driving”。

yorkhunter的博客 1555

手把手教你搭建日本亚马逊CVV钓鱼系统(含自动验证功能)

本文详细介绍了电商平台安全防护的关键实践,重点讲解了如何构建自动化风控系统。内容包括基础架构设计、用户行为分析、交易风险评估模型构建、验证机制实现以及系统部署优化,帮助电商平台有效识别和防范安全威胁,同时提升用户体验。

weixin_30952535的博客 818

2024自动驾驶(多模态)大模型综述:从DriveGPT4、DriveMLM到DriveVLM、DriveMM

​ 本文主要涉及以下4篇paper的解读(按发表的时间顺序排列) DriveGPT4: Interpretable End-to-end Autonomous Driving via Large Language Model DriveMLM: Aligning Multi-Modal Large Language Models with Behavioral Planning States for Autonomous Driving DriveLM: Driving with Graph Visual

结构之法 算法之道 2万+

计算机毕业设计springboot股票模拟交易系统的设计与实现u6m959【附源码+数据库+部署+LW】

选题背景: 随着互联网和金融科技的快速发展,股票市场成为了吸引人们关注和参与的重要领域之一。越来越多的人开始对股票投资感兴趣,希望通过交易股票来获取收益。然而,对于初学者来说,股票市场的复杂性和风险往往让他们望而却步。因此,设计和实现一个股票模拟交易系统,可以帮助初学者更好地理解和掌握股票交易的规则和技巧,提高他们的投资决策能力。 意义: 股票模拟交易系统的设计与实现具有以下几个重要意义: 提供实践机会:股票模拟交易系统为投资者提供了一个实践的平台,使他们能够在真实市场环境下进行模拟交易,了解股票市场的

gp12081的博客 1760

别再傻傻分不清!5分钟搞懂倾斜摄影里‘地面分辨率’和‘模型精度’到底啥关系

本文深入解析倾斜摄影中‘地面分辨率’与‘模型精度’的关系,帮助读者快速理解两者的本质区别与内在关联。通过实战案例和公式计算,详细说明如何从航飞设计到精度验证全流程控制,避免常见认知误区,并针对不同应用场景提供精度需求建议。

weixin_33700350的博客 477

纯视觉SOTA!华科&小米推出ReCogDrive:结合VLM和强化学习的端到端自动驾驶框架

给定自车状态例如,自车速度和自车加速度)、传感器输入和导航信息,自动驾驶任务旨在预测未来几秒内平滑且无碰撞的轨迹。传统的端到端驾驶算法表述为:其中,为未来路径点和航向的序列。尽管一些方法已经展现出很强的有效性,但是其黑盒性质阻碍了模型的可解释性,并且它们往往无法泛化到现实世界驾驶场景中罕见的极端情况。最新的工作利用了视觉语言模型的丰富世界知识和强大因果推理能力来实现自动驾驶。VLMs以文本形式输出轨迹,并且生成显式推理过程:然而,观察到语言格式的轨迹空间和连续行为。

soaring_casia的专栏 1492

交货单冲销发货过账的正确姿势:用 VL09 与 ABAP 批量反冲 Goods Issue

摘要 本文详细解析了SAP系统中VL09事务码的技术实现与业务应用。VL09用于反冲发货的货物移动,通过标准冲销路径(移动类型602冲销601)确保单据链路一致、状态机正确回退和业务规则生效。文章对比了经典VL09与Fiori应用在不同SAP产品形态中的位置,并针对STO场景提供了ME23N验证方法。核心内容包括WS_REVERSE_GOODS_ISSUE函数模块的调用要点、必须COMMIT的原因(SAP LUW机制),以及处理Handling Unit等限制条件的注意事项。最后给出了将VL09工程化的项目

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 590

带着GPT-4V(ision)上路,自动驾驶新探索

本报告对最新的 VLM 技术进行了详尽的评估,并探讨了其在自动驾驶场景中的应用。,将 2D 视觉基础模型特征提升到 4D 时空,并解决现代 Transformers 中的一般位置偏差,显著提高了 3D 感知性能(例如,在。本文方法在传感器模拟中实现了最先进的性能,在重建静态(+2.93 PSNR)和动态(+3.70 PSNR)场景时显著优于先前的方法。他们策划了62个涵盖这些方面的场景,并在这一基准测试中评估了26个最先进的文本到图像模型。,这是一种简单而强大的方法,用于学习动态驾驶场景的时空表示。

啥都生的博客 420

K8S部署Java项目 pod的logs报错为:Error: Unable to access jarfile app.jar

每个人都有惰性,但不断学习是好好生活的根本,共勉!

感谢阅读 2600

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

自动驾驶热点VLM(视觉语言模型)!又一次突破!

自从谷歌提出ViT、Open AI发布CLIP,视觉语言模型(VLM)便成为了研究热点,凭借跨模态处理和理解能力,以及零样本学习方法,为CV领域带来了重大革新,今年CVPR'24自动驾驶挑战赛中,VLM也是参赛人数最多的赛道,围绕环境感知提升等,应用方案百花齐放,而为了性能不变下压缩模型体量,CVPR'24收录了一项突破性工作,VLM提示蒸馏新方法PromptKD!为了帮助大家综合掌握,集VLM、...

CV_Autobot的博客 895

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

VLM与VLA的区别是什么?当前自动驾驶落地的情况怎么样?

点击下方卡片,关注“自动驾驶之心”公众号戳我->领取自动驾驶近15个方向学习路线去年理想对外展示快慢系统后,VLM在自驾的应用落地正式对外展露。今年智驾行业又在主推VLA,相比于端到端+VLM方式,VLA方案拥有更高的场景推理能力与泛化能力。不少智驾领导者都将VLA视为当下“端到端”方案的2.0版本,VLA也被看成是端到端+VLM的合体。VLM关注的重点在于环境建模,VLA除了考虑环境建模...

CV_Autobot的博客 2777

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

碰撞率降低57.4%!VLM-AD显著提升自动驾驶规划准确性,无需VLM实时推理

端到端自动驾驶(AD)将感知、预测和规划整合到一个框架中,旨在协调检测、跟踪等复杂任务。近期方法通过传感器数据生成自我轨迹,但面对复杂场景时性能下降。人类驾驶员通过推理环境有效应对挑战,而现有模型依赖于轨迹点序列监督,缺乏推理信息。手动标注推理信息成本高且耗时,难以获得高质量标注。大型基础模型如视觉-语言模型(VLMs)提供了替代方案,增强了驾驶系统的推理能力。然而,直接整合这些模型需要大量微调,并增加训练和推理时间,使其不适用于实际应用。

soaring_casia的专栏 1311

聊聊VLM架构以及训练后的一些实验和思考

实际训练的时候,每张图会用换行符隔开。对于Type-A模型,MiniCPM和LLaVA使用的是 SigLIP SoViT-400m/14,Qwen2-VL使用的是DFN,这些模型都是基于CLIP的方法训练得到的ViT模型,只是训练的loss不同或者基于的初始数据集不同。适配下游应用时,大部分试图创新模型结构或训练方法来提升效果的努力都是徒劳的(搞大模型的人太多了,你能想到的方法早就被人试过无数遍了,这些方法之所以没出现在论文里,是因为这些方法没用),除非你训练数据非常多,且训练过程的把控很好。

小白学视觉 548

自动驾驶中VLM与VLA的核心区别:一文看懂底层逻辑

从"规则系统"到"端到端+VLM"再到"VLA",自动驾驶的技术演进路线清晰地指向一个方向:让机器像人一样,在感知、理解和行动之间建立无缝的连接。VLA的核心创新之一,是受谷歌机器人模型RT-2的启发,将车辆的转向、加速、制动等驾驶动作转化为一种特殊的"词汇表"(Token)。这些能力是传统感知算法望尘莫及的。因此,在2024年主流的"端到端+VLM"双系统架构中,两者各司其职:端到端模型负责快速驾驶决策(系统1:快思考),而VLM模型则作为旁路的辅助插件,负责更高层次的语义理解和推理(系统2:慢思考)。

soaring_casia的专栏 1035

DRIVEVLM: 大视觉语言模型和自动驾驶的融合

24年2月清华和理想汽车的论文“DRIVEVLM: The Convergence of Autonomous Driving and Large Vision-Language Models”。

yorkhunter的博客 1956

DriveVLM 论文学习

规划意图的场景理解定义如下。输入包括环视相机的多视图视频VV,以及可选的感知模块输出的 3D 感知结果PP。场景感知EEE:包括天气条件EweatherEweather​、时间EtimeE_{time}Etime​、道路条件EroadE_{road}Eroad​、车道条件ElaneE_{lane}Elane​。场景分析SSS:包括目标级分析和场景级摘要SSS。决策描述DDD:驾驶决策的详细描述。

calvinpaean的博客 2003

Co-Driver:基于 VLM 的自动驾驶助手,具有类人行为并能理解复杂的道路场景

24年5月来自俄罗斯莫斯科研究机构的论文“Co-driver: VLM-based Autonomous Driving Assistant with Human-like Behavior and Understanding for Complex Road Scenes”。

yorkhunter的博客 1422

AI学习笔记整理(34)——视觉大模型在自动驾驶中的应用

在NVIDIA团队纯模仿学习的基础上,Waymo团队于2018年通过论文《ChauffeurNet: Learning to Drive by Imitating the Best and Synthesizing the Worst》提出了一种混合模仿学习和对抗生成数据的自动驾驶方法,该方法的输入值是BEV鸟瞰图,包含车道、障碍物、交通灯等语义分割结果,以及车辆过去一秒的历史轨迹。‌ 它接收感知模块的输出,并结合车辆状态、交通规则和目标位置,通过多层架构(路径规划、行为规划、局部运动规划)进行决策。

斯丝2011的博客 1278

【大模型/多模态】VLM技术:2025年多模态全面解析,这一篇就够了。

VLM技术之:一文掌握多模态

商务合作 | 面试培训 | 职场规划 ==>主页扫码 1万+
上一篇: 2024最新综述!多视图重建的前视今生,一览NeRF/3DGS等多种方法
下一篇: 自动驾驶离不开的C++,为什么说永远无法精通?
自动驾驶之心
博客等级 码龄4年 6592粉丝 724原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值