如何使用大型语言模型(LLMs)自动检测BOLA漏洞

容器安全终极防御指南:从漏洞扫描到内核级防护(含CVE-2024-危机应对) 🔥基于Docker最新runsc漏洞分析,手把手构建企业级容器安全体系! 阅读详情

写在前面的话

这篇文章介绍了我们对一种名为 BOLABuster 的方法所进行的研究,该方法使用大型语言模型 (LLM) 来检测对象级授权损坏(BOLA)漏洞。通过大规模自动化 BOLA 检测,我们将在识别开源项目中的这些漏洞方面取得令人鼓舞的结果。

在这里插入图片描述

BOLA 是现代 API 和 Web 应用程序中广泛存在且可能非常严重的漏洞。虽然手动利用 BOLA 漏洞通常很简单,但自动识别新的 BOLA 却很困难,原因如下:

1、应用程序逻辑的复杂性;

2、输入参数的多样性;

3、现代 Web 应用程序的状态特性;

由于这些原因,模糊测试和静态分析等传统方法无法有效检测 BOLA,因此手动检测成为标准方法。

为了应对这些挑战,我们利用 LLM 的推理和生成功能来自动执行传统上手动完成的任务。这些任务包括:

1、了解应用程序逻辑;

2、识别端点依赖关系;

3、生成测试用例并解释测试结果;

通过将 LLM 与启发式方法相结合,我们的方法可以实现大规模的全自动 BOLA 检测。虽然我们的研究还处于早期阶段,但我们已经成功发现了内部和开源项目中的不少 BOLA 漏洞。其中包括以下漏洞:

1、Grafana (CVE-2024-1313)

2、Harbor (CVE-2024-22278)

3、Easy!Appointments (CVE-2023-3285 至 CVE-2023-3290 和CVE-2023-38047 至 CVE-2023-38055);

自动化 BOLA 检测的挑战

正如之前的研究所揭露的那样,当 API 应用程序的后端无法验证用户是否具有访问、修改或删除对象的正确权限时,就会发生 BOLA。

下面展示了一个简单的 BOLA 示例。在这个医疗应用中,患者可以使用下面这个API 来访问医生就诊记录:

api.clinic[.]site/get_history?visit_id=XXXX

每位患者只能访问自己的医疗记录。但是,如果服务器未能正确验证此逻辑,恶意患者可能会操纵请求中的visit_id参数来访问其他患者的数据。下图显示了恶意 API 调用中的这种操作:

在这里插入图片描述

尽管 BOLA 的概念很简单,但自动化检测却面临巨大挑战。与其他常见漏洞(例如 SQL 注入、跨站点脚本 (XSS) 和缓冲区溢出)不同,静态应用程序安全测试 ( SAST ) 和动态应用程序安全测试 ( DAST ) 等安全测试工具无法有效识别 BOLA。这些工具依赖于已知的漏洞模式和行为,而这些模式和行为并不适用于 BOLA。目前尚无用于检测 BOLA 的自动化工具。

此外,目前还没有开发框架可以帮助开发人员预防 BOLA。因此,需要审计 BOLA 的安全团队必须手动审查应用程序并创建自定义测试用例。一些技术挑战加剧了自动化 BOLA 检测的难度:

1、复杂的授权机制:现代 API 应用程序通常具有复杂的授权机制,涉及多个角色、资源类型和操作。这种复杂性使审计人员难以确定应允许用户对特定资源执行哪些操作。

2、有状态属性:大多数现代 Web 应用程序都是有状态的,这意味着每个 API 调用都可以更改应用程序的状态并影响其他 API 调用的结果。换句话说,调用一个 API 端点的响应取决于其他 API 端点的执行结果。这种复杂的逻辑通常内置于 Web 界面中,用于指导最终用户与应用程序进行正确的交互。但是,自动从 API 规范中逆向工程逻辑并跟踪应用程序状态并不容易。

3、缺乏漏洞指标:BOLA 是一种逻辑错误,没有编译器或 SAST 工具可以识别的已知模式。在运行时,BOLA 不会触发任何错误或表现出揭示问题的特定行为。成功利用的输入和输出通常会导致状态代码为 200 的成功请求,并且它们不包含任何可疑的有效负载,因此很难发现漏洞。

4、上下文相关输入:BOLA 测试涉及操纵 API 端点的输入参数以识别漏洞。此过程需要精确定位引用敏感数据的参数并为参数提供有效值以运行测试。我们完全依赖 API 规范来了解每个端点的功能和参数,因此很难确定端点是否会泄露或操纵敏感数据。确定目标端点及其参数后,下一步是向这些端点发送请求并观察其行为。确定测试的特定参数值很困难,因为只有映射到系统中现有对象的值才能触发 BOLA。使用传统的模糊测试技术自动生成此类有效载荷既具有挑战性又无效。

BOLABuster:人工智能辅助 BOLA 检测

鉴于生成式人工智能 (Gen-AI) 的最新进展以及自动化 BOLA 检测的挑战,我们决定通过开发 BOLABuster 来解决人工智能问题。BOLABuster 方法利用 LLM 的推理能力来理解 API 应用程序并自动执行以前手动且耗时的 BOLA 检测任务。

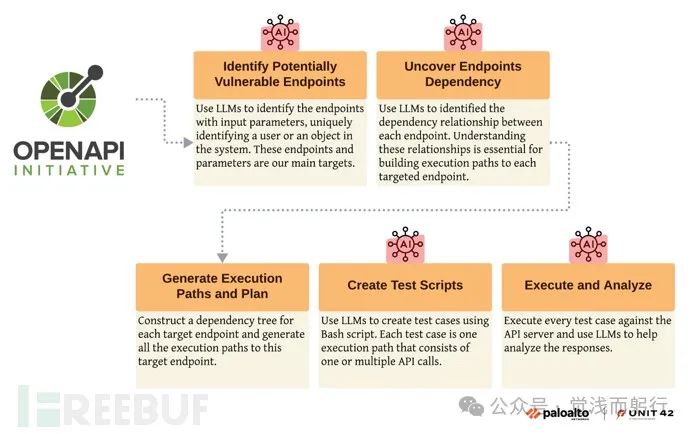
BOLABuster 的算法如下图所示,仅需要目标 API 应用程序的 API 规范作为输入。BOLABuster 根据 API 规范生成所有测试用例,BOLABuster 目前支持OpenAPI 规范 3,这是最广泛采用的 API 规范格式:
图片

BOLABuster 方法涉及到的五个主要阶段

识别潜在易受攻击的端点 (PVE)

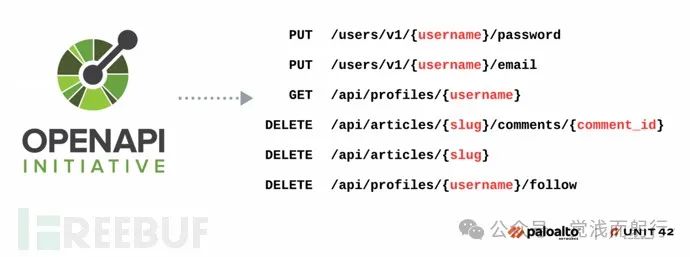
我们方法论的第一阶段是识别可能易受 BOLA 攻击的 API 端点。我们重点关注经过身份验证的端点,这些端点具有唯一标识系统中数据对象的输入参数,例如username、email、teamId、invoiceId和visitId。如果后端无法验证授权逻辑,则具有这些参数的端点可能易受 BOLA 攻击。

AI 可协助分析每个端点的功能和参数,以确定哪些端点引用或返回敏感数据。下图显示了一组可能存在漏洞的端点:
图片

发现端点依赖关系

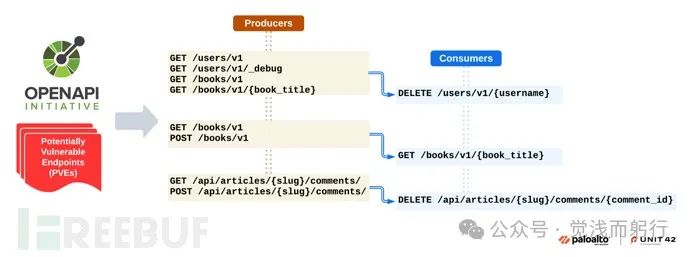
此阶段分析应用程序逻辑以发现 API 端点之间的依赖关系。由于现代 Web 应用程序的状态特性,在测试之前了解 API 端点的先决条件至关重要。例如,要测试购物车应用程序的结帐 API,必须先将商品添加到购物车。此操作需要知道itemId和customerId。

我们将为其他端点输出所需参数的端点归类为生产者,将摄取这些参数的端点归类为消费者,如下图所示。每个端点都可以同时充当生产者和消费者,AI 协助分析每个端点的功能和参数,以确定一个端点是否可以输出另一个端点输入所需的值:
图片

生成执行路径和测试计划

此阶段使用前两个阶段的输出为每个 PVE 构建依赖关系树。每个节点代表一个 API 端点,从父节点到子节点的每条边代表一种依赖关系,其中父节点是消费者,子节点是生产者。每棵依赖关系树的根都是一个 PVE,从每个叶节点到根的路径代表一条可以到达 PVE 的执行路径。然后,我们为每个执行路径创建一个测试计划,该计划由所有 PVE 的执行路径及其 API 调用组成。下图显示了具有四条执行路径的依赖关系树的示例:

在这里插入图片描述

创建测试脚本

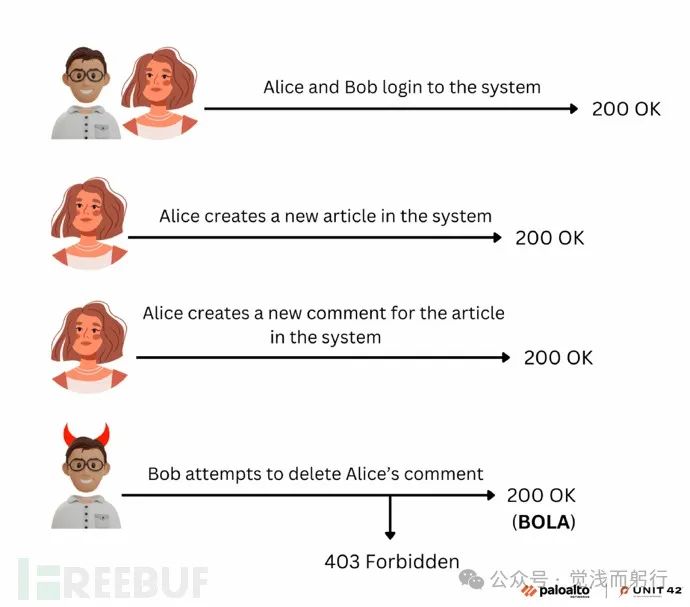
此阶段使用 LLM 将每个执行路径转换为可执行的 bash 脚本。每个脚本都会对目标服务器进行一系列 API 调用,从登录以检索身份验证令牌开始,到调用 PVE 结束。每个测试脚本至少涉及两个经过身份验证的用户,其中一个用户尝试访问另一个用户的数据。如果一个用户可以成功访问或操纵另一个用户的数据,则表明存在 BOLA。下图演示了 BOLA 测试的高级示例,测试涉及两个用户 Alice 和 Bob,他们登录系统并接收唯一的身份验证令牌。Alice 在系统中创建了一篇文章,并对这篇文章发表了评论。然后将文章和评论的标识符传递给 Bob。然后 Bob 尝试执行未经授权的操作 - 试图删除 Alice 的评论。如果操作成功,则表明存在潜在的 BOLA:
图片

执行计划并分析

在此阶段,BOLABuster 针对目标 API 服务器执行测试脚本,然后分析响应以确定 PVE 是否容易受到 BOLA 攻击。我们自动化用户注册、用户登录和令牌刷新流程,以确保每个测试计划不间断地执行。

BOLABuster 按照特定顺序运行同一 PVE 的测试用例,以最大程度地减少它们之间的依赖关系。例如,我们避免让一个测试用例删除另一个测试用例需要的对象。

本质上,我们确保执行路径内除对 PVE 的调用之外的所有 API 调用均成功。此调用的结果应表明 PVE 是否容易受到 BOLA 攻击。

排序算法确保在应用程序进行任何访问尝试之前,已填充必要的数据。BOLABuster 将包含更新或删除用户或资源等操作的测试脚本安排在执行序列的末尾,以防止尝试获取已删除或已修改的资源。

每个测试计划的日志和输出均由 AI 分析。当 AI 认为某个端点存在漏洞时,人工会验证结果以评估 PVE 在应用环境中的影响。

虽然我们利用人工智能实现尽可能多的任务自动化,但人工验证仍然必不可少。我们的实验表明,人工反馈可以不断提高人工智能的准确性和可靠性。

总结

我们的研究表明,人工智能在彻底改变漏洞检测和安全研究方面具有巨大潜力。通过利用 LLM 来自动执行以前手动且耗时的任务,我们证明了人工智能可以充当可靠的助手。这不仅适用于编写代码,还适用于调试和识别漏洞。

尽管我们的研究仍处于早期阶段,但其影响深远。我们为 BOLA 检测开发的算法可以扩展到识别其他类型的漏洞,为漏洞研究开辟新的途径。随着人工智能技术的不断发展,我们预计类似的方法将使一系列以前不切实际或不可能实现的安全研究计划成为可能。

值得注意的是,这项技术可能是一把双刃剑。虽然防御者可以使用人工智能来增强其安全措施,但对手可以利用同一技术更快地发现零日漏洞并升级网络攻击。

以人工智能对抗人工智能的理念从未如此重要,因为我们努力用更智能、更精确的人工智能驱动解决方案战胜对手。网络安全界必须保持警惕,积极主动地制定战略,以应对人工智能带来的潜在威胁。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

大模型在代码缺陷检测领域的应用实践 例如,对于复杂的代码结构和大规模的代码库,大模型的训练和推理成本较高;一些大型软件公司纷纷推出基于大模型的代码缺陷检测服务,为企业提供更加精准和高效的缺陷检测服务。其中最具代表性的是DeepCode和SonarQube等工具,它们基于深度学习技术对代码进行自动扫描和缺陷检测,大大提高了代码质量。通过训练大规模的神经网络模型,可以学习到代码中潜在的缺陷模式,从而实现对代码缺陷的自动检测。随着代码规模的扩大和复杂度的增加,传统的代码缺陷检测方法已经难以满足需求。的出现为代码缺陷检测领域带来了新的解决方案。 阅读详情

相关推荐

⼤模型在⽹络安全⽅⾯的应⽤汇总

这些应⽤不仅展⽰了LLMs在⾼效识别和减轻软件漏洞威胁⽅⾯的卓越能⼒,为⾃动化安全分析⼯具的未来发展提供了宝贵的参考和启⽰,⽽且通过LLMs强⼤的上下⽂分析能⼒,⽹络安全专业⼈员能够更早地应对潜在威胁,显著降低被利⽤的⻛险。另⼀个LLMs⼤显⾝⼿的领域是内容审核。由GPT-3.5-turbo驱动的⼊侵检测系统HuntGPT使⽤LLMs来识别⽹络流量中的模式,并以可理解的格式提供检测到的威胁,该系统在认证信息安全经理(CISM)实践考试中取得了超过80%的成功率,显⽰出在指导安全决策⽅⾯的潜⼒。

INSBUG的博客 1135

9-harbor2.2.1-harbor2.13.0之间版本对比及cve漏洞影响

CVE-2020-13794 CVE-2020-13788 CVE-2019-3990 CVE-2019-19030 CVE-2019-19029:影响 Harbor 1.7.、1.8.、1.9.* 版本,1.8.6 和 1.9.3 版本也受影响。通过用户组进行 SQL 注入,具有项目管理功能的用户可利用此漏洞从底层数据库读取机密信息或进行权限提升。 CVE-2019-19026:影响 Harbor 1.7.、1.8.、1.9.* 版本,1.8.6 和 1.9.3 版本也受影响。Harbor API 的 q

xuebo1129927648的博客 516

大模型驱动的智能代码漏洞检测

大模型驱动的智能代码漏洞检测 关键词:大模型,智能代码漏洞检测,深度学习,漏洞特征提取,代码安全 摘要: 本文将深入探讨大模型驱动的智能代码漏洞检测技术。首先,介绍大模型的基本原理和特点,然后讲解漏洞特征提取的方法及其优缺点。接下来,通过具体

AI天才研究院 1553

Linux随记(十四)

【代码】Linux随记(十四)

Nightwish5的博客 2449

如何在离线的电脑上部署一个本地Deepseek(使用ollama)

例如,如果您的显卡显存为 16GB,官方推荐使用 32b 大小的 DeepSeek 模型。请根据您的硬件配置选择适合的模型版本,以获得最佳性能。首先我们需要将ollama和chatbox的安装包,Deepseek模型文件通过U盘或者光盘的形式导入到这台不能联网的电脑上。按照时间排序,找到最大的那个文件,就是gguf格式的模型,复制出来,改名为qwen2.5-coder0.5b.gguf。:基于开源模型(如 QWEN 和 LLAMA)微调,参数量从 1.5B 到 70B 不等,适合本地硬件部署。

qq_41854911的博客 1万+

手把手教你用TUSB2E22中继器实现eUSB2与USB 2.0互转(附实测数据对比)

本文详细介绍了如何利用TUSB2E22中继器实现eUSB2与USB 2.0的高效互转,包括技术背景、硬件设计要点、信号完整性测试方法及故障排查策略。通过实测数据对比,展示了TUSB2E22在信号延迟、功耗和眼图性能上的显著优势,为工程师提供了实用的工程方案。

weixin_29199873的博客 283

提升权限_【预警通告】Harbor权限提升漏洞安全预警通告

点击箭头处“蓝色字”,关注我们哦!!尊敬的客户:Harbor是一款开源的可信云镜像仓库。主要用于镜像上传、更新、存储和维护。常用于与CI/CD配合管理Docker镜像。Harbor 1.7.6之前版本和Harbor 1.8.3之前版本中的core/api/user.go文件存在安全漏洞。若开放注册功能,攻击者可利用该漏洞创建admin账户。奇安信安全监测与响应中心将持续关注该漏洞进展,并...

weixin_36027743的博客 502

基于phpstudy搭建pikachu靶场

一、phpstudy下载安装配置 phpstudy介绍 简单介绍一下phpstudy,详细请参考百度解读。pikachu是基于PHP环境搭建的,需要数据库支持,所以装pikachu之前需要先安装它需要的环境,就像你养鱼需要给它提供水环境一样。安装phpstudy能满足pikachu的需求,所以先安装phpstudy。 phpStudy是一个PHP调试环境的程序集成包。该程序包集成最新的Apache+PHP+MySQL+phpMyAdmin+ZendOptimizer,一次性安装,无须配置即可使用,是

ptxybird的博客 1万+

2024年Windows Wi-Fi漏洞CVE-2024-30078深度技术剖析:远程代码执行风险与应对策略

在2024年发现的Windows Wi-Fi驱动漏洞CVE-2024-30078,对用户构成了严重的安全风险。该漏洞允许攻击者实现远程代码执行(RCE),可能导致未授权访问、数据泄露和系统被完全控制。攻击者可以通过向同一网络范围内的受害者设备发送特制的Wi-Fi数据包来利用此漏洞。该漏洞因其高达8.8的CVSS评分而凸显其严重性。

分享技术点滴 403

MATLABGUI读取文件并将路径显示在文本框中

MATLABGUI读取文件并将路径显示在文本框中

m0_50305149的博客 2650

从零开始:用Neo4j构建你的第一个知识图谱(附完整代码示例)

本文提供了一份从零开始的Neo4j知识图谱构建实战指南。通过一个“经典科幻电影宇宙”的具体案例,手把手教你安装环境、设计图谱模式,并使用Cypher查询语言完成节点与关系的创建、数据查询及可视化,帮助你快速掌握自下而上构建知识图谱的核心技能。

weixin_29053073的博客 471

CVE-2024-22252、CVE-2024-22253、CVE-2024-22254(1),腾讯网络安全面试题

二、影响和修正版本虽然 Broadcom 在安全公告中未提及生命周期结束的产品,但由于这些漏洞的严重性,Broadcom 已向客户提供扩展支持 ESXi 6.7 ()、6.5 (和的补丁三、解决方案升级到已修复漏洞的版本。

m0_60666841的博客 722

SAP_SD模块路径及运输功能后台配置简介

后台路径:SPRO—后勤执行—装运—基本发运功能—定义路线—定义传输模式根据实际运输过程运输地理的类型:海运、公路运输、空运后台路径:SPRO—后勤执行—装运—基本发运功能—定义路线—定义发运类型根据实际运输过程运输方式:汽车、卡车、火车、轮船、飞机后台路径:SPRO—后勤执行—装运—基本发运功能—路径—定义路线—定义运输连接点指在运输过程中需要中转的地区可以维护中转地区的停留的时间后台路径:SPRO—后勤执行—装运—基本发运功能—路径—定义路线—定义路径和阶段。

我小时候很黑的博客 1397

VMware vCenter Server CVE-2024-22274:认证远程代码执行漏洞

CVE-2024-22274 是一个影响 VMware vCenter Server 的远程代码执行漏洞,允许具有 vCenter 管理权限的恶意攻击者在底层操作系统上运行任意命令。该漏洞的严重性评分为 CVSS v3 基础分数 7.2,属于重要级别​ (Tenable®)​​ ()​。

weixin_65409651的博客 846

基于STM32设计的智能家居控制系统(华为云)_363

本项目设计并实现了一种基于STM32的智能家居控制系统,融合了语音识别、远程控制、环境监测与安全报警等功能。系统以STM32F103C8T6单片机为核心控制器,集成ESP8266 Wi-Fi模块实现与华为云IOT物联网平台的数据交互,采用MQTT协议进行通信。用户可通过语音识别模块控制风扇、空调、窗帘、卧室灯、客厅灯和电视等家电的开关操作,同时也可通过Android手机APP或Windows电脑上位机进行远程控制。系统还具备温湿度、光照强度、烟雾浓度和火焰检测功能,当检测到异常情况时,自动触发蜂鸣器报警并向

881

YOLOv11改进 - C3k2融合 | C3k2融合融合WDBB宽度多样分支模块(Width Diverse Branch Block)通过多尺度分支增强特征表征能力

本文着眼于灰度图像目标检测所面临的挑战,提出了增强型目标检测网络 YOLO - MIF,该网络整合了多种多信息融合策略以对 YOLOv8 网络进行改进。文章开篇介绍了一种可创建伪多通道灰度图像的技术,此技术能增加网络的通道信息,同时缓解潜在的图像噪声与虚焦模糊问题。随后运用网络结构重新参数化技术,在不增加推断时间的情况下提升网络的检测性能。此外,引入了一种新颖的解耦式检测头,增强了模型处理灰度图像时的表现能力。

魔改工程师的博客 770

CVE-2024-23897 JenKins任意文件读取漏洞复现

还有兄弟不知道网络安全面试可以提前刷题吗?费时一周整理的160+网络安全面试题,金九银十,做网络安全面试里的显眼包!王岚嵚工程师面试题(附答案),只能帮兄弟们到这儿了!如果你能答对70%,找一个安全工作,问题不大。对于有1-3年工作经验,想要跳槽的朋友来说,也是很好的温习资料!【完整版领取方式在文末!!

2401_83974590的博客 880

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

大型语言模型面临的漏洞和安全威胁

在深入探讨漏洞之前,了解大型语言模型是什么以及它们为何变得如此流行是有帮助的。LLM是一类人工智能系统,它们在大量文本语料库上进行训练,能够生成非常类似人类的文本,并进行自然对话。现代LLM如OpenAI的GPT-3包含超过1750亿个参数,比以前的模型高出几个数量级。它们使用基于变换器的神经网络架构,擅长处理文本和语音等序列。这些模型的巨大规模,结合先进的深度学习技术,使它们在语言任务上达到最先进的性能。文本生成:LLM可以自动完成句子,撰写文章,总结长篇文章,甚至创作小说。

DUT_LYH 2001

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

人工智能大模型在代码安全审查方面落地研究

随着信息技术的飞速发展,软件在各个领域的应用越来越广泛,其安全性也日益受到重视。在软件开发过程中,代码安全审查是确保软件安全性的重要环节。然而,传统的以人工为主的代码安全审查方式已经难以适应快节奏、敏捷模式的软件开发流程。尽管目前市场上有众多成熟的安全扫描工具可供选择,但其扫描结果误报率较高,难以在开发流水线中实现准确无误的自动化扫描,仍需花费大量人力资源手动排除工具误报,且排误准确率在很大程度上依赖于安全人员的个人技能。

2401_85343303的博客 1372

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

详解大模型四类漏洞

大语言模型(LLM)的漏洞,分为安全与访问控制、合规与法律、信任与安全、品牌四大类。具体包括注入攻击、知识产权侵权、有害内容、错误信息等多种风险。

ybdesire的专栏 1261

adpater

Adapter相当于一个数据源, Adapter接口定义了如下方法: public abstract void registerDataSetObserver (DataSetObserver observer)  Adapter表示一个数据源,这个数据源是有可能发生变化的,比如增加了数据、删除了数据、修改了数据,当数据发生变化的时候,它要通知相应的AdapterView

weixin_39388156的博客 983

【综述】大规模语言模型用于漏洞检测与修复:文献综述与未来研究方向

介绍了软件漏洞的危害性及自动化检测和修复的必要性。传统方法存在误报率高、难以应对多样化漏洞的问题。LLM因其在自然语言和软件工程任务中的成功,成为提升漏洞检测与修复效率的重要工具。

weixin_42016744的博客 2668

大模型在代码安全检测中的应用

例如,检测SQL注入漏洞时,模型可识别变量拼接的潜在风险,即使变量命名或函数用法多样,也能通过上下文判断数据流是否安全134。例如,先由模型提取关键代码模式,再用规则库验证变量来源,结合两者的优势降低误报率18。腾讯混元大模型优化后,漏洞检出率从26%提升至95%,日均检测300+风险案例,显著优于传统静态分析工具(耗时20分钟以上且无法处理片段代码)148。结合代码摘要、符号执行等技术,实现漏洞检测与修复的一体化,并探索多模态信息(如代码注释、文档)增强上下文理解67。:大模型可能生成无依据的漏洞判断。

zxy98的专栏 1146

「大模型」检测「大模型」缺陷,从错误中高效学习

来源:内容来自:GLM 技术团队第一个在通用任务上系统探索 LLM 缺陷发掘过程的框架。大语言模型(LLM)的一丝缺陷,可能会直接导致实际部署生产中的严重隐患。尽管 LLM 的功能越来越强大,但它们仍然存在不易察觉的缺陷,比如在执行指令或编码任务时出现错误。因此,系统地识别并解决 LLM 的缺陷,对于提升 LLM 的性能和可靠性至关重要。然而,现有的识别 LLM 缺陷的方法均存在明显的不足。人工检...

人工智能学家 899

网络安全新前沿:利用大模型进行复杂威胁检测与响应

利用大模型进行复杂威胁检测与响应是网络安全领域的新前沿。模型优化:继续优化大模型,提高检测准确率和效率。跨领域学习:将大模型应用于其他网络安全领域,如物联网安全、个人设备安全等。实时检测:实现实时检测和响应,提高网络安全防御能力。数据隐私:在训练大模型时,需要处理和保护用户数据隐私。模型解释性:提高大模型的解释性,使其更易于理解和信任。资源消耗:大模型训练和推理需要大量计算资源,如何高效利用资源是一个挑战。

DUT_LYH 2577

AI 时代的安全暗战:大模型安全漏洞攻防与防御体系构建

在人工智能技术高速发展的今天,以 ChatGPT、文心一言为代表的大语言模型(LLM)已广泛应用于内容创作、智能客服、数据分析等多个领域。然而,随着 AI 应用的深度渗透,其背后隐藏的安全风险也逐渐暴露。2024 年某知名 AI 企业因模型数据泄露导致用户隐私信息外流,2025 年初的 “Prompt 注入攻击” 事件更是引发行业震动。本文将深入剖析 AI 时代信息技术安全面临的全新挑战,结合典型漏洞攻防案例,系统阐述大模型安全防御体系的构建策略,助力技术从业者筑牢数字安全防线。

2301_81916023的博客 852
上一篇: 探究大模型微调 Lora 的不同形态(上篇): AdaLora、 AsLora、 PiSSA、 DoRA
下一篇: OpenAI o1模型揭秘:通过LLMs学习推理能力
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


