多模态大模型的最优预训练范式

【万字长文】多模态预训练模型研究进展 从2018年Bert横空出世以后,以预训练模型为基石的各个领域百花齐放,多模态预训练模型也是在这样一个背景下诞生的,具体大概是从2019年开始涌现的。在传统NLP单模态模型中,表征学习的发展较为完善,但在多模态,由于高质量标注数据集的限制,少样本学习以及零样本学习是研究的重点。基于Transformer结构的多模态预训练模型,通过海量无标注数据进行预训练,然后使用少量有标注数据进行微调即可。通常多模态分为:一般是人类看到是实物,声音甚至味道都是一种模态信息。以下介绍将基于最常用的语言视觉多模态(Langua 阅读详情

ChatDev——大语言模型驱动的多智能体协作与演化

视频号
图片

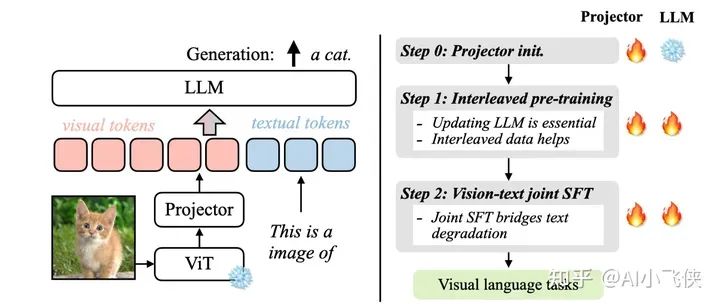
目前主流的多模态大模型的训练基本都是分为预训练和微调两阶段来进行的。

预训练阶段是为了让大语言模型(LLM)具有理解视觉信息的能力,也可以认为是将视觉特征空间对齐到文本空间。

微调阶段就是使用特定领域的数据,通过全量参数或者 LoRA这种参数高效的方法微调,让模型熟悉特定领域的知识。

VILA 这篇文章的研究重点就是从模型架构,数据构造,训练策略三个角度出发,找到一个最优的预训练方法。

在这里插入图片描述

主要结论

  • • 在预训练阶段冻结 LLM,在 zero-shot上的性能可以达到最优。但如果需要上下文学习的能力,需要在预训练阶段放开 LLM 的参数;
  • • 图片文本相互交叉的预训练数据比较有利于训练,单纯的图片文本对并不是最优的;
  • • 在指令微调阶段,将纯文本指令数据混杂到图片-文本数据中,不仅能缓解纯文本任务性能的下降,而且能提高视觉、语言模型(VLM)任务的准确率。
图片

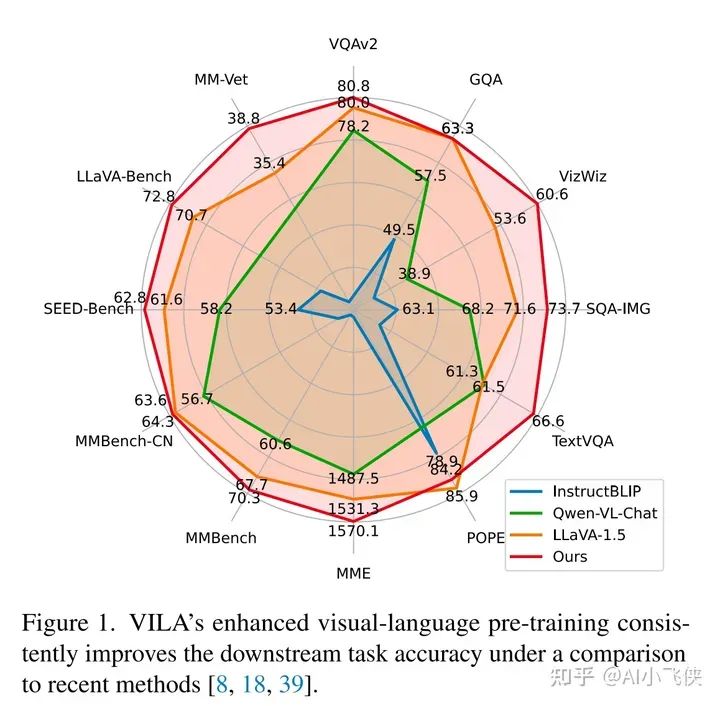
相比较于 LLaVA1.5而言,VILA 几乎实现了全面的超越。

预训练VLM

更新LLM 是至关重要的
图片

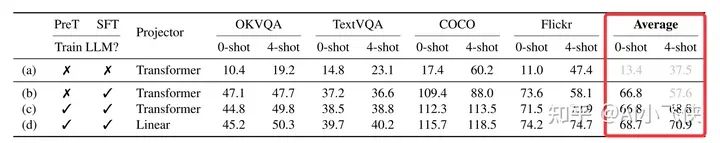
  • • 预训练阶段是否放开 LLM,在 zero-shot上的性能完全一样。但是在 4-shot测试中,预训练阶段放开 LLM 能提高 11%,说明预训练放开 LLM 能极大提高模型的上下文学习能力;
  • • Projector结构为 Linear 明显优于 Transformer层的堆叠,作者猜测是因为简单的 Linear 能促使 LLM 学习更多处理视觉信息的能力,从而导致更好的泛化性能。

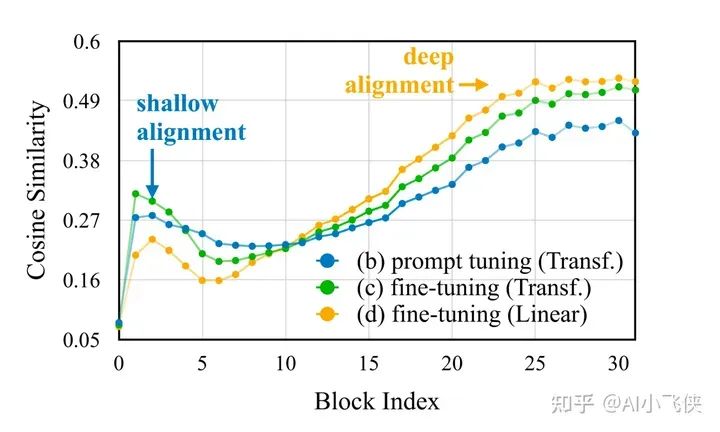
深层 embedding 对齐假设

作者猜测,之所以微调 LLM 很关键,是因为在深层的隐空间中对齐图像和文本信息是非常重要的。
图片

相互交叉的视觉语言语料库能帮助预训练

选择预训练数据

在这里插入图片描述

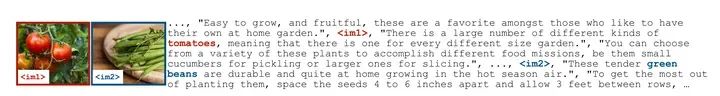
  • • MMC4 是图片文本相互交叉的数据集,平均每个样本对应 4 张图片,每张图片对应 122.5 个 tokens;
  • • COYO 是图文对数据集,文本部分都比较短,每张图片对应 22.7 个 tokens;
  • • 训练的时候每个数据集根据 CLIP特征的相似度选择 25M 张图片;

交叉数据是至关重要的
图片

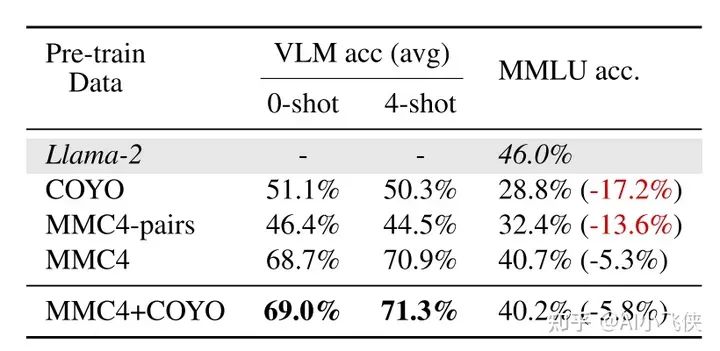
  • • 使用图文对数据集 COYO 训练之后,LLama2的文本能力遭到灾难性遗忘,纯文本准确率(MMLU)下降 17.2%;
  • • 使用图文交叉数据集 MMC4 训练之后,纯文本能力相较于原始的 Llama2仅仅下降 5.3%,多模态能力相较于 COYO 训练的模型得到极大提升,在 0-shot测试中提升 17%;

相互交叉的数据构成很重要,而不是因为文本分布

MMC4 数据集中文本长度较长,文本数据比较接近于纯文本数据的分布,可能是这个原因导致在纯文本任务中表现较好。

为了排除是因为 MMC4 文本较长导致的在MMLU 上结果较好,作者将 MMCU 改成图文对数据MMC4-pair。

MMC4:<txt1><im1><txt2><txt3><im2><txt4>
MMC4-pair: <im1><txt2>, <im2><txt4>
  • • MMC4-pairs在纯文本任务MMLU上稍微减小了 COYO 的性能下降,这可能是因为较长的文本;
  • • MMC4-pairs相较于 COYO 在多模态任务上结果变得更差,这可能是因为MMC4-pairs数据中图片和文本没有很强的匹配关系;
图片

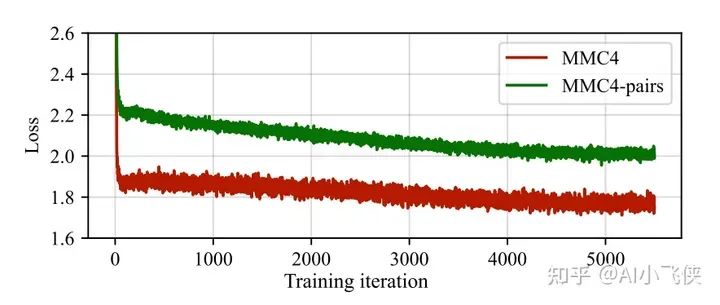
  • • MMC4相较于 MMC4-pair在训练过程中损失更低,这表明完整的文本分割提高了更多的信息;
图片

  • • 综合上面的分析可以得出结论:相互交叉的数据允许模型去选择图片相关的信息,不会更多强迫模型去学习不相关的文本建模。

数据混合提高预训练

  • • 在混合了 MMC4 和 COYO 后,在多模型任务中模型进一步获得了提高。

结合有监督微调(SFT)后恢复了LLM的下降

即使在预训练的数据中混合了图片文本相互交杂的数据,但纯文本任务还是有 5% 的下降。

这个问题可以在预训练的时候添加文本数据来解决,但是纯文本数据的比例又很难去确定。

作者发现,纯文本能力并没有遗忘,只是暂时隐藏了。只要在微调的时候添加了一点纯文本数据,就能完全恢复 LLM 在纯文本任务上的能力。

联合有监督微调
图片

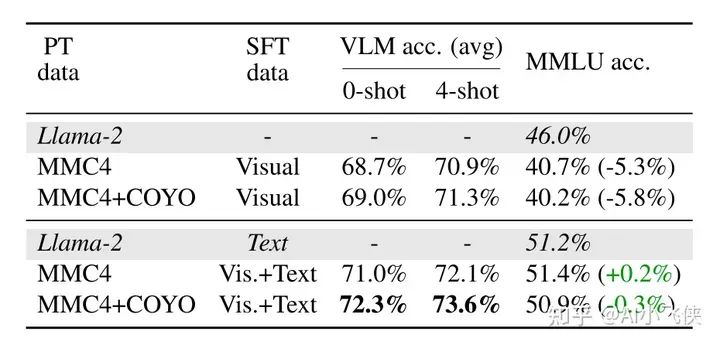
  • • 一般的多模态大模型在微调阶段只使用视觉语言数据,这会导致纯文本任务性能的下降;
  • • 作者在 FLAN 中采样 1M纯文本指令数据,混杂在多模态数据集中微调模型;
  • • 结果表明,这种方法不仅完全恢复了 LLM 的纯文本能力,而且也进一步提高了模型在多模态任务中的能力;
  • • 这可能是因为纯文本数据提高了模型的指令跟随能力,这个能力对于多模态任务也很重要。
    ​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

多模态预训练模型学习 一、什么是预训练? 目前随着数据量爆炸式的增长,靠人工去标注更多数据是非常昂贵,并且也不太现实的。因此预训练的方式就出现了,也逐渐成为了一种主流的方法。那到底什么是预训练呢?简单地说,预训练就是:“使用尽可能多的训练数据,从中提取出尽可能多的共性特征,从而能让模型对特定任务的学习负担变轻。” 预训练将学习分成了两步: 1)首先将大量低成本收集的训练数据放在一起,经过某种预训方法去学习其中的共性知识 ; 2)然后,再使用相关特定域的少量标注数据进行微调,模型就可以从共性知识出发,学习这些特定领域数据的 阅读详情

相关推荐

从零开始理解SOTA:AI领域最新技术趋势与未来发展方向

本文深入解读了AI领域的SOTA(State-of-the-Art)概念,它不仅是技术性能的巅峰,更是驱动人工智能发展的核心竞争与评估机制。文章梳理了从特征工程到多模态大模型的SOTA演进史,分析了当前大语言模型、多模态理解等前沿赛道,并展望了未来向综合性能、数据价值与架构创新平衡的发展方向。

weixin_29310631的博客 280

多模态预训练模型综述

前言2021年诺贝尔生理学、医学奖揭晓,获奖者是戴维·朱利叶斯(DavidJulius)和阿代姆·帕塔博蒂安(Ardem Patapoutian),表彰他们在“发现温度和触觉感受器”方面作...

Kaiyuan_sjtu的博客 1万+

一文读懂「PTMs , Pre-training models」预训练模型

预训练模型是指在大规模数据集上预先进行训练的神经网络模型,通常在通用任务上学习到的特征可以被迁移到其他特定任务中。预训练模型的思想是利用大规模数据的信息来初始化模型参数,然后通过微调或迁移学习,将模型适应在特定的目标任务上。即在训练结束时结果比较好的一组权重值,研究人员分享出来供其他人使用。我们可以在github上找到许多具有权重的库。

女王の专属领地 6066

多模态基础大模型-预训练解决方案 2024

多模态预训练大模型架构与 GPT 和 BERT 类似,也是基于自注意力机制 Transformer 深度学习模型,其最大特点是模型的输入由单一模态的文本拓展到文本、语音、图像、视频等多个模态数据同时作为输入。多模态大模型主要指输入包括两种及以上模态的、参数量大于亿级的深度学习网络模型。单模态大模型主要是指模型输入只包括一种模态(如只包括语音、图像或文本)的、大规模参数量的深度神经网络模型。

python12345678_的博客 2135

具有I2S输出的多模数字麦克风ICS-43434咪头LR引脚接地或电源WS接LRCLK

ICS-43434 是一款数字 IS 输出底部收音孔麦克风。完整的 ICS-43434 解决方案包括 MEMS 传感器、信号调理、模数转换器、抽取和抗混叠滤波器、电源管理以及行业标准的 24 位 12S 接口。12S 接口允许 ICS-43434 直接连接到数字处理器,例如 DSP 和微控制器,而无需系统中的音频编解码器。

易板 5664

工业质检新利器:手把手教你用AD-DINOv3实现零样本缺陷检测(附MVTec AD实战)

本文详细介绍了AD-DINOv3框架在工业质检中的应用,通过零样本异常检测技术解决传统方法的标注成本高和泛化能力弱问题。文章包含技术原理解析、MVTec AD数据集实战部署、模型训练流程及工业部署优化技巧,帮助读者快速掌握这一创新技术。

seed的博客 764

Intern-S2-Preview-397B性能深度测评:通用任务与科学任务双冠王

Intern-S2-Preview-397B是一款功能强大的多模态基础模型,专为科学智能和长周期智能体设计。它在预训练、强化学习任务覆盖和交互式智能体环境三个关键维度进行了扩展,通过结合新的视觉语言预训练范式、大规模多任务强化学习和长周期智能体强化学习,在通用推理、科学问题解决和智能体能力方面实现了质的飞跃。 ## 模型核心优势:三大突破性特征 ### 全新预训练范式 通过视觉预训练,Inte

gitblog_00759的博客 685

台积电技术研发实力

台积电技术研发实力 台积电在半导体行业的地位毋庸置疑。他们究竟有多强大,大部分读者了解得可能非常片面。从最新公布的2019年财报里,看看台积电的真正实力。 一、台积电在市场上的地位 根据公司财报,台积公司在先进制程技术、特殊制程技术,以及先进封装技术的发展上持续领先全球集成电路制造服务领域,2019年的市场占有率为52%。台积公司总体营收以地区划分(主要依据客户营运总部所在地),来自北美市场的营收占台积公司总体营收的60%、日本与中国大陆以外的亚太市场占9%、中国大陆市场占20%、欧洲、中东及非洲市场占6

吴建明wujianming_110117 1901

一场技术范式的持续演进:快速掌握大模型基础

本文系统梳理了人工智能从规则驱动到数据驱动、从机器学习与深度学习走向大模型时代的技术演进路径,重点阐释了大模型产生的背景、训练流程及其“好用”的本质原因。文章从预训练、监督微调与人类反馈强化学习等工程视角,解析大模型能力形成机制,并进一步总结其核心特征与主要类型,包括大语言模型与多模态大模型。通过对统一交互范式、能力编排与产业落地的分析,文章指出:大模型正在从单一技术能力,演变为支撑企业与产业智能化的新一代基础设施。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 5万+

Altium Designer操作技巧(1)——原理图中如何批量替换元器件?

《AltiumDesigner批量替换元器件技巧分享》摘要:本文介绍了两种在AltiumDesigner中批量替换元器件的实用方法。方法一通过“查找相似对象”功能,可精准匹配并批量修改器件参数;方法二利用ActiveBOM功能,在BOM表中直观操作器件替换,推荐使用第二种方法可使BOM管理更高效。这些技巧能有效减少物料种类、降低贴装成本,特别适用于电阻电容等常用器件的批量替换。关注公众号获取更多电子设计技巧。

u012526819的博客 2582

Lossless-Claw 插件实战:告别上下文截断,让 OpenClaw 永不遗忘

本文介绍了OpenClaw的Lossless-Claw插件,这是一个基于LCM论文的DAG摘要系统,能有效解决上下文截断问题。文章包含10个部分,从插件原理到实操指南: 核心原理:通过DAG结构持久化存储所有原始消息,将旧消息分块摘要并形成层级结构,保持上下文在模型Token限制内。 性能优势:在OOLONG基准测试中得分74.8,优于Claude Code的70.3,尤其在长上下文场景表现更佳。 功能特点: 提供lcm_grep、lcm_describe等工具主动回忆历史 摘要始终链接回原文,实现真正无损

u014798858的博客 2617

预训练语音大模型技术演进与应用全景解析

本文系统解析了预训练语音大模型的技术演进与应用全景。从wav2vec 2.0、HuBERT到Data2Vec和Whisper,模型通过自监督学习从海量无标签语音数据中学习通用表征,彻底改变了语音识别、情感分析等下游任务的开发范式。文章深入剖析了各代模型的核心技术逻辑,并提供了实战选型与微调指南,展现了该技术如何降低门槛、拓宽应用边界。

weixin_29053577的博客 259

遥感图像融合实战:5分钟搞懂全色与多光谱图像如何提升分辨率(附Python代码)

本文通过实战案例,详细解析了如何利用全色锐化技术融合全色与多光谱遥感图像,以提升图像分辨率。文章深入浅出地介绍了核心概念、环境配置、经典GS融合算法的Python代码实现,并对比了不同算法的优劣,最后提供了效果评估方法与实战陷阱分析,帮助读者快速掌握遥感图像融合的关键技术。

weixin_29041195的博客 394

OFA-PT:统一多模态预训练模型的Prompt微调

Prompt微调已成为模型微调的新范式,并在自然语言预训练甚至视觉预训练中取得了成功。参数高效的Prompt微调方法通过优化soft embedding并保持预训练模型冻结,在计算成本低和几乎无性能损失方面展现出优势。在本研究中,我们探索了Prompt微调在多模态预训练模型中的迁移。具体来说,我们通过在每一层添加一串可学习的embedding,并在下游任务中仅优化这些可学习embedding,从而在一个统一的序列到序列预训练模型上实现Prompt微调。

1168

高速PCB设计中的一些常用规则

目前,高速PCB产品设计中,高速接口的应用日益普及,对于复杂的设计而言,高速走线就如同“蜘蛛网”一样密布在PCB各处,因此,在进行PCB检查及评审时,必要的高速PCB设计经验法则及规则是工程师开展工作必不可少的知识储备。

一只豌豆象的博客 3415

Android/Linux驱动开发:使用dev_dbg进行设备驱动调试

在本文中,我们将介绍如何使用dev_dbg宏和相关的函数来进行设备驱动调试。函数在该目录下创建了一个名为"debug"的debugfs文件。在这些函数中,您可以执行与您的设备驱动相关的调试操作。函数在该目录下创建了一个名为"debug"的debugfs文件。在这些函数中,您可以执行与您的设备驱动相关的调试操作。的结构体指针,其中包含了我们定义的文件操作函数。的结构体指针,其中包含了我们定义的文件操作函数。在上面的示例中,我们首先通过调用。在上面的示例中,我们定义了。在上面的示例中,我们定义了。

ByteKnight的博客 372

大模型发展史:预训练范式、算力约束与工业落地的三重演进

大模型并非单纯由算法突破驱动,而是预训练范式、硬件算力与工业落地需求深度耦合演化的结果。从Transformer对GPU并行能力的适配,到MLM与Decoder-only架构的任务-部署协同设计,再到RMSNorm、RoPE、Sliding Window等技术选择,本质都是在显存、延迟、稳定性等工程约束下寻求最优解。这些决策深刻影响微调收敛性、推理首token延迟与长文本建模能力。当前开源模型(如Llama系列)和量化方案(如AWQ)的流行,正是工业界用真实业务数据反向塑造算法演进的明证。本文聚焦预训练范式

weixin_33139275的博客 276

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

大模型训练阶段全解析:从单一预训练到三阶段框架!

文章介绍了大模型训练阶段的演变过程,从早期单一预训练到现在的预训练+中期训练+后训练三阶段框架。预训练构建通用能力基座,中期训练实现通用到专项平稳过渡,后训练对齐人类需求并优化专项性能。多阶段框架解决了能力分层、数据效率、训练风险和应用场景复杂化等问题,是技术可行性与应用需求双向奔赴的结果。

libaiup的博客 1137

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型十年演进

摘要 2015-2025年是大模型发展的黄金十年,经历了从学术萌芽到通用人工智能雏形、从海外垄断到国产自主可控、从单模态到多模态融合的演进过程。Transformer架构的诞生和ChatGPT的发布推动了大模型两次范式革命。这十年可分为四个阶段:启蒙萌芽期(2015-2017)以词嵌入预训练为主;突破扩散期(2018-2020)确立了预训练范式;范式重构期(2021-2023)ChatGPT引爆通用大模型;普惠成熟期(2024-2025)将实现端云协同和垂直行业落地。中国大模型从跟随发展到自主创新,国产化率

jzwspace的专栏 1234

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

下一代“多模态大模型+端到端”架构 Senna:开创智驾决策规划全新范式

本文通过对特斯拉Autopilot技术的深入剖析,探讨了车载计算平台所面临的技术挑战以及未来的发展趋势。接着,我们重点探讨了车载计算平台在硬件架构、软件算法以及数据处理等方面所面临的挑战,并分析了这些挑战对自动驾驶技术发展的影响。最后,我们展望了车载计算平台的未来发展趋势,包括更高性能的计算硬件、更优化的软件算法以及更智能的数据处理技术等。通过本文的阐述,读者将能够更深入地了解特斯拉Autopilot的技术内涵,以及车载计算平台在自动驾驶领域的发展趋势和挑战。

人无远虑,必有近忧 1142

OpenClaw多语言多模态预训练技术解析

多语言预训练和多模态学习是当前AI大模型发展的关键技术方向。多语言预训练通过让模型接触不同语言的相同概念表达,帮助建立跨语言的语义理解能力,提升模型的抽象表征和迁移学习性能。多模态预训练则整合文本、图像等多种数据形式,使模型获得更接近人类的多感官认知能力。这两种技术在OpenClaw模型中得到结合应用,采用类似XLM-R和BEiT-3的混合架构,并针对中文特性进行优化。工程实现中需解决数据配比、模态对齐、训练策略等挑战,通过动态采样、对比学习等方法提升效果。这类技术可广泛应用于机器翻译、跨模态检索等场景,是

anchang7456的博客 356

InternVL3-8B 训练策略全揭秘:从原生多模态预训练到 MPO 优化

想搞懂多模态大模型是如何炼成的?本文将为你全面揭秘 **InternVL3-8B 训练策略**:从颠覆传统的原生多模态预训练(Native Multimodal Pre-Training),到监督微调(SFT)、混合偏好优化(MPO),再到测试时扩展(Test-Time Scaling),一步步拆解这套让开源模型逼近 GPT-4V 的完整训练流水线。无需编程基础,读完你就能看懂大模型的"成长之路"

gitblog_00513的博客 1103

大模型本地化失效根因与强化预训练解决方案

大语言模型(LLM)在本地部署后出现答非所问、逻辑断裂等‘失语症’,本质是预训练阶段语义颗粒度粗放与现实世界映射断裂所致。其核心原理在于传统训练范式缺乏对上下文锚定、低质量输入鲁棒性、业务规则约束及物理环境感知的建模能力。技术价值体现在通过强化预训练(RPT)将反馈机制前移至预训练阶段,实现结构一致性、事实锚定与交互适应的联合优化;结合四步监听架构,使本地智能体具备语境感知、意图解构、多模态响应与闭环验证能力。典型应用场景覆盖制造业故障诊断、医疗辅助决策与边缘智能客服,尤其适用于方言识别、噪声语音理解、高湿

dy_f的专栏 620

LeCun&谢赛宁团队新作:多模态预训练的探索

实验表明,模型的物理预测能力主要来自通用的多模态预训练(如视频数据),而不是依赖特定领域的数据。基于这样一个观察:语言与视觉是互补的,且多模态预训练能够显著提升视觉问答(VQA)能力,团队进一步探索:在不对模型架构做任何修改的情况下,多模态模型是否可以扩展到「世界建模(world modeling)」任务。而实验结果表明,模型确实会形成明显的「专家专门化」现象,具体来说:一部分专家主要处理文本 token,另一部分专家主要处理视觉 token,而且这种分工是自动形成的,并不需要任何显式的模态标签或约束。

阿木寺的博客 74
上一篇: 大白话说什么是“MLLM”多模态大语言模型
下一篇: 大语言模型(LLM)如何更好地继续预训练(Continue PreTraining)
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值