大白话说什么是“MLLM”多模态大语言模型

qwen_vl_utils代码分析 这是图像尺寸调整的因数,图像的高度和宽度都将被调整为28的倍数。:图像的最小像素数,确保图像不小于特定大小。:图像的最大像素数,限制图像的最大尺寸,防止过大的图像占用过多内存。:图像的最大宽高比,用于防止过度拉伸或压缩的图像。:视频帧的最小像素数。:视频帧的最大像素数。:视频帧数需要是此因数的倍数。FPS = 2.0:默认的视频采样帧率。:视频采样的最小帧数。:视频采样的最大帧数。:从环境变量中获取视频的总像素数,如果未设置,则默认使用,并将其转换为整数。这是对视频输入尺寸的限制。 阅读详情
AI摘要

本文介绍了MLLM多模态大语言模型,解释其概念及产生原因,阐述核心架构包括LLM大语言模型、模态模型等组件,还说明了训练过程如预训练、指令微调等。此外,给出实操演练示例,并分享了AI大模型学习资料和商业化落地方案。

1. 什么是MLLM多模态大语言模型

1.1 先来思考一个问题

如果上传了一张图片,并向大模型提问。“图片中绿色框框中的人是谁?”

大模型回答:“那是波多野吉衣老师”

请问,大模型是怎么做到的?

我们用常规的思路来想一下,难道是:

第一步:先对图片进行目标检测,先把绿色框的内容剪切出来;

第二步:在剪切后的图片中,把人脸标记出来,并读取其landmark转为向量;

第三步:在人脸向量库中进行比对,以便于确定其身份。

整套流程下来,需要用到目标检测,人脸识别,向量存储与比对。最重要的是,还得让人脸识别模型“阅片无数”不然他是不会认识波多野结衣老师的。

但其实,多模态大模型并不是这样处理的。所谓的多模态其实可以理解就是多种数据类型,包括但不限于图片,视频,音频等。它的工作模式并不是将原来的CV模型和NLP模型,通过MultiStage的方式简单粗暴的组合在一起。而是一个端到端的思维。

1.2 为什么会有多模态大语言模型
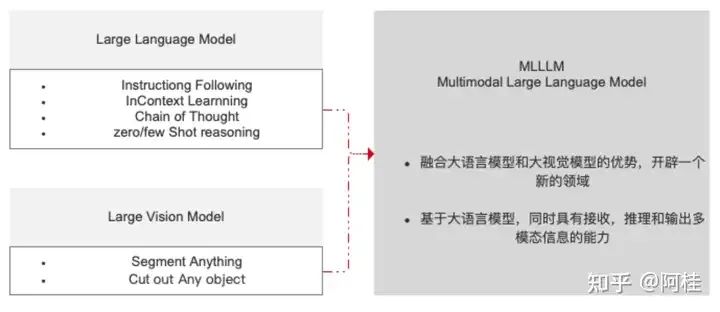
图片

如上图所示,大语言模型有很多好处,例如指令跟随,上下文学习,思维链,少样本学习能力等。但是大语言模型天生就不是为视觉服务的,在所有的训练过程中也没有图像解释相关的数据输入。因此它天生就缺少“视觉”能力。所以,在这里我们把他比喻为知识渊博,逻辑推理能力超强,智商爆表的“瞎子”。

同时,大视觉模型也很牛逼。他可以识别&切分万事万物,但缺少逻辑推理能力。同样,这里我们也可以把它比喻成会火眼金睛的“傻子”。

为了更好的完成各类实际场景的任务,VL模型(多模态的一种,视觉&语言)就应运而生。一个“知识渊博的瞎子”&一个“火眼金睛的傻子”组合。但却实实在在的融合了两大优势,开辟了一个新的领域。

PS:我之前写过一篇基于YOLOv8目标检测,来完成物流行业人车合照的文章。当时就提出,一个完整的物流车辆人车合照流程,应该包括“目标检测(识别 人,车,车牌)”+“OCR识别(识别车牌号)”+“车牌号比对(COR识别结果与系统中登记的车牌是否一致)”+“人脸识别及比对(与驾驶证头像比对,判断是否为同一人)”这几项。

但是由于当时时间有限,只是做了“目标检测(识别 人,车,车牌)”+“OCR识别(识别车牌号)”+“车牌号比对(COR识别结果与系统中登记的车牌是否一致)”,并且还是分段调用实现的。

但,就在最近。阿里云发布了最新的Qwen-VL-Max 多模态模型。该多模态大模型理论上就可以一站式解决我上说的人车合照自动检测全部流程。

目前我这边也在测试中,如果后续有一个比较理想的结果也会跟大家分享一下整体操作的流程。
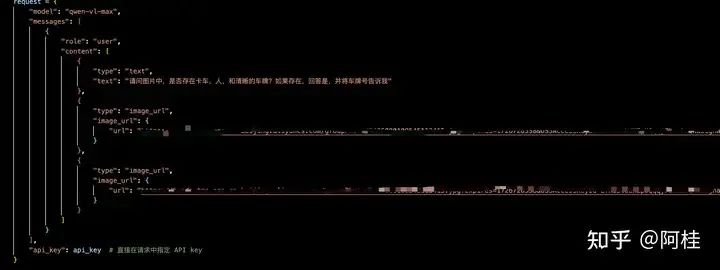
图片阿里云也提供官方的调用模版,我这边最近也在测试整体准确率

通过我上边举的“瞎子”&“傻子”的例子,再结合我遇到的人车合照自动检测的实际应用场景。希望可以帮您更好的理解MLLM。

2. MLLM多模态大语言模型的核心架构
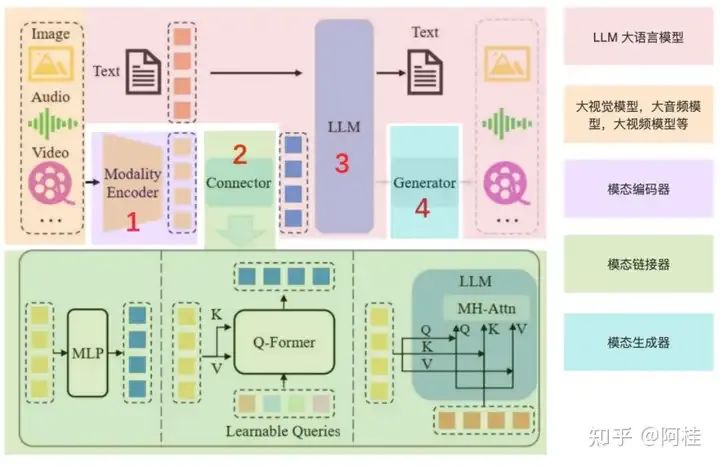
图片MLLM架构全景说明图

先说一下,这张图怎么去看能更方便你去理解MLLM的架构。

首先,原图是没有上图层的颜色覆盖的。这些颜色的图层覆盖,是我为了更好的理解自己添加上去的。

那么接下我们一个一个的说:

2.1 LLM大语言模型(浅粉色)

其本质就是传统的LLM,例如ChatGPT,Qwen等等。还是将文本进行向量化进行大模型,大模型输出文本结果。无论是你什么模态,大部分都是依托于大语言模型的。所以这就是为什么,我前边一直在叫MLLM为“多模态大语言模型”。

2.2 模态模型(浅黄色)& 模态编码器(浅粉色)

本来他们应该是一起的,但是了能单独的解释清楚“模态编码器”的 作用,所以在最开始的时候我选择单独标注。

其实这两个东西就是“探头模型”(大视觉,大音频等模型)的自身。

例如,一个视觉大模型。一张image输入,他本来就会调用自身的encoder进行特征抽取的,以便于后续的使用。

但是要注意,这里抽取出来的特征向量是视觉语义下的!!!

2.3 模态连接器(浅绿色)

如2.2中所说,模态模型和模态编码器输出的向量往往并不是文本语义的向量。这是需要一个连接器,你也可以理解你出国住宾馆用的插头转换器。作用是将非文本语义的特征向量转换成文本语义的特征向量。也就是将已经得到视觉或音频特征向量,转换成一个LLM(大语言模型)可以读懂的向量。

这样,这些特征就可以进入LLM了。

这里再说一下,常用的连接器有三种类型,我们可以大概了解一下:

  • • 基于投影的连接器:这种连接器将编码器输出的特征投影到与LLM的词嵌入相同的维度空间, 使得特征可以直接与文本令牌一起被 LLM处理
  • • 基于查询的连接器:这种连接器使用一组可学习的查询令牌来动态地从编码器输出的特征中提取信息。
  • • 基于融合的连接器:这种连接器在LLM内部实现特征级别的融合,允许文本特征和视觉特征在模型内部进行更深入的交互和整合。

2.4 模态生成器(蓝绿色)

简单来说是,根据语义生成对应的视频,音频,或者图像内容。

即,能够处理和生成特定类型数据(模态)的组件。通常用于将一种模态的信息转换为另一种模态,或者是在给定某种模态的输入时生成相应的输出。

说白话就是,我输入了一张波多野吉衣的图片,并要求大模型给我基于这张图片中的女人生成一段向我求婚的视频。那么就需要模态生成器,将输出转化为视频形式。

最后,我们来看一个多模态大语言模型,在处理任务时的一个流程示意图:
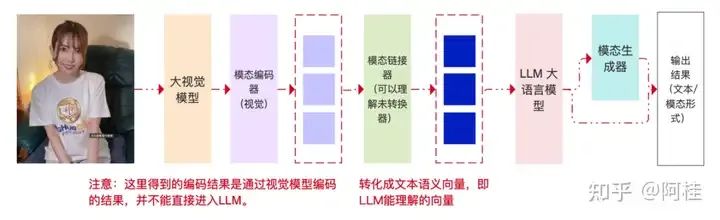
图片

通过上图,能更明显的说明了一个事实:多模态 不等于 多阶段处理!!!而是一种端到端的思想!!!

3. MLLM多模态大语言模型的训练

3.1 PT-预训练

让模型通过大量的未标注数据进行学习,从而获得对多种模态数据的理解能力和泛化能力。预训练的目标是使模型学会如何从不同的数据类型中提取有用的信息,并理解这些信息之间的关联。

其核心的本质是训练模态编码器。对齐不同的模态,提供世界知识。

训练的数据模版为:
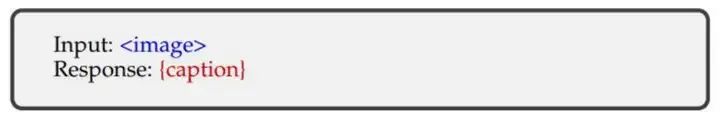
图片MLLM预选练数据模板

其训练的本质,其实就是一个看图说话的过程。

图片

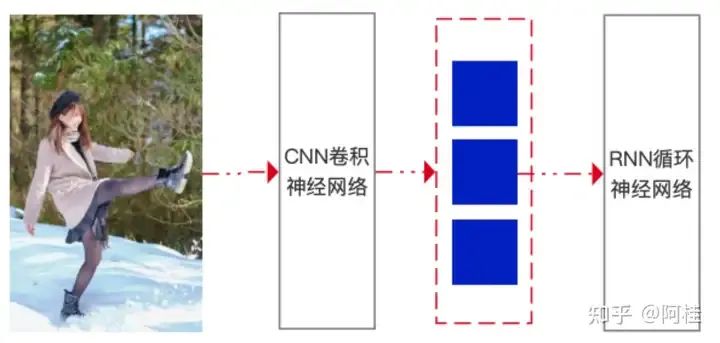
以上图为例,Input:Respnose:{波多野结衣老师大冬天穿着黑丝袜在雪地里玩耍}

通过CNN进行图像数据处理,能够提取图像中的特征,如边缘、纹理等。经过CNN处理后,图像被转换为一系列的特征表示,这些特征通常以向量的形式存在,如图中红色虚线框内的蓝色矩形块。提取到的特征向量被输入到循环神经网络能够理解特征之间的顺序关系,从而生成有意义的文本输出。

最终训练完成后,在我输入这张图像以后,大模型可以通过训练得到最佳的 W和B,输出我想要的这句话。

3.2 SFT-指令微调

虽然预训练可以让模型获得广泛的知识和技能,但为了适应具体的下游任务,通常还需要一个微调的过程。在这个阶段,模型会在带有标签的数据上进一步训练,以便更好地执行特定任务,如图像分类、文本生成等。

可以让模型更好地理解用户的指令并完成所需的任务 。

提升整体泛化能力,和少(零)样本推理能力。

训练的数据模版为:
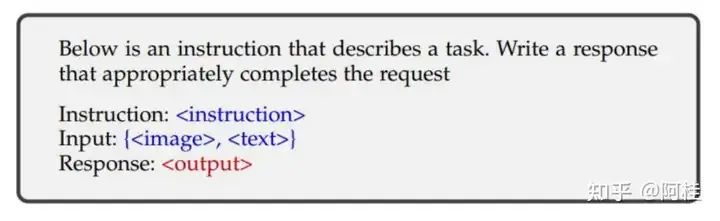
图片MLLM指令微调的数据模板

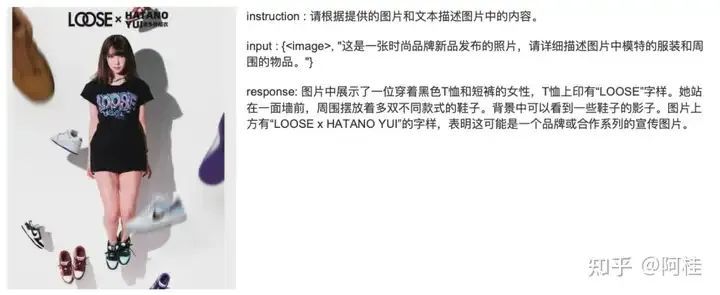
  • • instruction : 任务的描述
  • • input : image一张图像,text 一段描述的文本
  • • response: 提问的的输出

例如:

图片

3.3 RLHF - 偏好对齐微调

  • • 对齐特定的人类偏好
  • • 基于人类反馈的强化学习 RLHF
  • • 直接偏好优化 DPO

与大语言模型的对齐微调,没有区别。就不在赘述了(主要是,我没怎么接触这块内容,不敢胡说)

4. MLLM的实操演练

前置说明:

体验平台:model scope 魔搭社区

体验模型:qwen/Qwen2-VL-2B-Instruct 2024年8月末发布的多模态模型

踩坑说明:由于我在写这篇文章时,该系列模型刚刚发布2B,7B,72B版本以及GPTQ的量化版本。整个环境依赖和与langchain的兼容还没有完善的很好。因此实际在魔搭上操作,可能会因为环境的相关依赖或版本冲突问题卡住。所以这里我指给大家做一个调用示例,供大家理解。
在这里插入图片描述

当然,魔搭官网上也提供了不用qwen-vl-utils工具包的使用方法。具体可以在魔搭社区查阅相关资料。

#需要安装最近的torchvision
! pip install -U torch torchvision

# 通过transfromer 引入多分词器和autoprocessor(是一个类似于AutoTokenizer的类,但它不仅限于文本处理,还可以处理其他类型的输入,比如图像。)
from transformers import AutoTokenizer, AutoProcessor
from qwen_vl_utils import process_vision_info
# 通过 transfromer 引入Qwen2VLForConditionalGeneration
from transformers import Qwen2VLForConditionalGeneration

注意:from transformers import Qwen2VLForConditionalGeneration 时可能会报错,我推测是在model scope的jupyter notebook中能引入的transformers不是最新的,并不包含Qwen2VLForConditionalGeneration。

因此,我的处理方式是,通过git clone将transformers下载至本地,然后压缩在上传至model scope的jupyter notebook。之后就是解压,进入到transformers的文件夹中,执行sudo pip install e。

但后变化的,应该逐步优化的,这里应该是直接from transformers import Qwen2VLForConditionalGeneration引入即可。

#设置设备类型
device = "cuda"
#设置模型的地址
model_id = "Qwen2-VL-2B-Instruct"
#加载模型
model = Qwen2VLForConditionalGeneration.from_pretrained(
    pretrained_model_name_or_path = model_id,    
    torch_dtype="auto",    
    device_map="auto"
)
# 初始化一个处理器对象processor,AutoProcessor是一个自动选择合适的处理器类的辅助类,它会根据模型目录的内容选择正确的处理器
processor = AutoProcessor.from_pretrained(model_id)

# 视觉的token默认范围是4到16384。可以根据需要设置 min_pixels 和 max_pixels
min_pixels = 256*28*28
max_pixels = 1280*28*28
#初始化一个特定的处理器实例,用于处理来自Qwen/Qwen2-VL-2B-Instruct预训练模型的数据,并设置了最小和最大像素数限制。 
processor = AutoProcessor.from_pretrained("Qwen/Qwen2-VL-2B-Instruct", min_pixels=min_pixels, max_pixels=max_pixels)
#定义了一个消息列表messages,其中包含一个字典,字典中有一个图像类型的元素和一个文本类型的元素,指示模型需要描述这张图像。
messages = [
    {     
        "role": "user",        
        "content": [       
            {           
                 "type": "image",                
                 "image": "https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen-VL/assets/demo.jpeg",            
            },            
            {"type": "text", "text": "Describe this image."},        
        ],   
    }
]

# 推理前的准备
text = processor.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
#调用一个函数process_vision_info来从消息中提取图像和视频输入。在这个例子中,我们只处理图像。
image_inputs, video_inputs = process_vision_info(messages)
#使用processor来处理文本、图像和视频输入,并将它们转换为适合模型输入的格式。padding=True意味着所有的输入都将被填充到相同的长度,return_tensors="pt"则表示返回PyTorch张量。
inputs = processor(
    text=[text],    
    images=image_inputs,    
    videos=video_inputs,    
    padding=True,    
    return_tensors="pt",
)
#将输入数据移动到CUDA设备上,以便利用GPU进行加速计算。
inputs = inputs.to("cuda")

# 推理生成输出

#使用模型生成新的标记序列,max_new_tokens=128表示最多生成128个新标记。
generated_ids = model.generate(**inputs, max_new_tokens=128)

#从生成的ID中移除输入ID部分,只保留新生成的部分
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
#解码生成的ID序列,转换成人类可读的文本形式。skip_special_tokens=True表示解码时不包括特殊标记,clean_up_tokenization_spaces=False表示不解码时去除多余的空格。
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
#打印出解码后的文本,即模型对图像的描述。
print(output_text)

注意:以上代码,仅是为了大家可以更好理解一下什么是多模态大语言模型,以及其核心架构和工作原理。具体调用示例,请以model scope上的相关示例为准。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

一文读懂「MLLM,Multimodal Large Language Model」多模态大语言模型 模态是事物的一种表现形式,多模态通常包含两个或者两个以上的模态形式,是从多个视角出发对事物进行描述。生活中常见多 模态表示,例如传感器的数据不仅仅包含文字、图像,还可以包括与之匹配的温度、深度信息等。使用多模态数据能够使得事物呈现更加立体、全面,多模态研究成为当前研究重要方面,在情感分析、机器翻译、自然语言处理 和生物医药前沿方向取得重大突破。MLLM通常以大语言模型(Large Language Model,LLM)为基础,融入其它非文本的模态信息,完成各种多模态任务。MLLM定义为“ 阅读详情

相关推荐

AIGC(MLLM、VLM、LLM、SD)系列——论文解读目录

AIGC(MLLM、VLM、LLM、SD)系列,论文解读目录。快速找到你想要的论文。

TigerZ*的博客 8489

从LLM到MLLM,多模态大规模语言模型KOSMOS-1赋予了语言模型看见世界的能力

来自:机器之心在 NLP 领域,大规模语言模型(LLM)已经成功地在各种自然语言任务中充当通用接口。只要我们能够将输入和输出转换为文本,就能使得基于 LLM 的接口完成一个任务。举例而言,对于摘要任务,我们能够将文档输入到语言模型,语言模型就可以生成摘要。尽管 LLM 在 NLP 任务中取得了成功的应用,但研究人员仍努力将其原生地用于图像和音频等多模态数据。作为智能的基本组成部分,多模态感知是实现...

zenRRan的博客 4634

Win11下Android模拟器报HAXM未安装?三步搞定虚拟化配置(附终端命令)

本文详细解析了Win11下Android模拟器HAXM报错的解决方案,从虚拟化配置到终端命令实战。通过检查BIOS设置、调整Windows功能及执行PowerShell命令,三步搞定虚拟化配置问题,有效提升模拟器性能。特别针对Win11与HAXM的兼容性问题提供了专业指导。

weixin_29215815的博客 143

NLM、LLM、MLLM概述

自然语言处理( Natural Language Processing, NLP)是计算机科学领域与人工智能领域中的一个重要方向。它研究能实现人与计算机之间用自然语言进行有效通信的各种理论和方法。自然语言处理是一门融语言学、计算机科学、数学于一体的科学。因此,这一领域的研究将涉及自然语言,即人们日常使用的语言,所以它与语言学的研究有着密切的联系,但又有重要的区别。自然语言处理并不是一般地研究自然语言,而在于研制能有效地实现自然语言通信的计算机系统,特别是其中的软件系统。因而它是计算机科学的一部分。

Admans的专栏 3953

目标检测数据集 第069期-基于yolo标注格式的玻璃清洁状态检测数据集(含免费分享)

但这类技术的落地,离不开大量标注规范、场景丰富的数据集作为算法训练的支撑,玻璃清洁状态检测数据集的出现,正是为了满足这一市场与技术需求。在高校与科研机构的计算机视觉研究中,该数据集可作为基础研究素材,用于探索物体状态识别的算法优化方向,比如针对玻璃这类透明物体的检测算法改进,或是小样本场景下的状态识别研究。通过摄像头采集车窗、挡风玻璃的图像,算法自动检测玻璃清洁度,若识别到脏污影响视线,及时提醒运维人员清洁,避免因玻璃脏污引发的安全事故,提升交通出行的安全性。

深度学习算法工程师,专注于前沿算法研究与实战应用。在这里,我将分享深度学习领域的实战经验、优质数据集资源以及最新论文解读与精度分析,旨在与广大技术爱好者共同探索人工智能的奥秘,助力技术成长与创新。 128

产生式系统的完整示例——医疗诊断系统(附python代码)

发烧(Fever)、咳嗽(Cough)、皮疹(Rash)、喉咙痛(SoreThroat)、头痛(Headache)、流涕(RunnyNose)、呼吸困难(ShortnessOfBreath)、白细胞计数高(HighWBC)、接触流感患者(ContactFlu)、接触麻疹患者(ContactMeasles)。(2)若规则库中存在尚未使用过的规则,而且它的前提(前件)可与综合数据库中的已知事实匹配,则转第(3)步;(3)执行当前选中的规则,并对该规则做上标记,把该规则执行后得到的结论送入综合数据库中。

搏博的专栏 1701

大白话讲解:多模态大模型综述,通俗易懂!

多模态大型语言模型(Multimodal Large Language Models, MLLM)的出现是建立在大型语言模型(Large Language Models, LLM)和大型视觉模型(Large Vision Models, LVM)领域不断突破的基础上的。这里给大家总结了多模态大模型的结构,训练,评估方法以及幻觉问题的解决办法,通俗易懂!!

2401_85328934的博客 3304

SAP Parallel Accounting(平行分类账业务)配置及操作手册【适用于多国家会计准则】

在SAP系统中,分类账(Ledger)是用于会计核算的核心概念,它允许企业根据不同的会计原则和货币进行财务记录。定义分类账是配置平行账(Parallel Accounting)的第一步。分类账的创建:通过事务代码OX18可以创建新的分类账。通常,一个SAP系统会有一个主分类账(如0L),它代表法定会计和实时传输至管理会计(CO)的账本。分类账属性:在创建分类账时,需要定义其属性,如会计年度变式、货币、会计原则等。这些属性将决定分类账的核算规则和适用性。

数字化2025 4617

大白话讲解:多模态大模型综述,通俗易懂!_大模型综述类 ppt

多模态大型语言模型(Multimodal Large Language Models, MLLM)的出现是建立在大型语言模型(Large Language Models, LLM)和大型视觉模型(Large Vision Models, LVM)领域不断突破的基础上的。这里给大家总结了多模态大模型的结构,训练,评估方法以及幻觉问题的解决办法,通俗易懂!!

2401_85116933的博客 1148

HALCON实战:用两个工业相机实现无缝大视野拼接(附完整代码与避坑指南)

本文详细介绍了使用HALCON软件实现双工业相机图像无缝拼接的完整解决方案,涵盖硬件配置、相机标定、坐标系转换和图像拼接等关键步骤。通过高精度标定和矩阵变换技术,可构建大视野检测系统,适用于液晶面板、PCB等工业检测场景,显著提升检测效率和精度。

weixin_29050513的博客 191

解密携程风控:user-dun算法中的自定义base64与多模式加密机制剖析

本文深入剖析了携程旅行APP风控核心组件libduncode.so中的user-dun算法。文章重点解密了其采用的自定义Base64编码机制与多模式加密选择逻辑,并详细阐述了如何通过动态分析与静态还原,理解算法与设备指纹的深度绑定关系,为逆向分析类似混淆加固的风控算法提供了系统的方法论。

weixin_29323049的博客 340

3 步选对多模态大模型:MLLM 选型与评测落地指南

开源和闭源的多模态大模型(MLLM)已有上百个,挨个试一遍不现实。这篇文章带你走一遍 Awesome-Multimodal-Large-Language-Models 资源库:先看它是什么,再讲 MLLM 选型怎么按场景挑,最后用 5 分钟跑通多模态评测,并给出落地时最容易踩的坑。 ## 📦 第一步:看懂这个多模态大模型资源库 这个仓库由 NJU-MiG 团队维护,内容分三大板块,先记住"它

gitblog_00415的博客 231

c++ mysql_init 返回无效指针_C++操作MYSQL遇到的一些问题

首先 我使用的是 vcpkg上面是我装的一些库《大大安利vcpkg 安装时一定要使用powershell进行编译装上vcpkg后装ligmariadb这个库,这个对Mysql操作还是挺方便的,然后说一下 在装库时碰到的一些问题1.网络问题1.参考了一下 github上的答案 将下载失败的url拷下来 自己下 然后再重新开始安装《vcpkg在安装时每一个需要下载的 都会提供url-仔细找,2.这个问...

weixin_32176627的博客 680

多模态大模型(理解)入门看这一篇就好了(非常详细)从零基础入门到精通,收藏这篇就够了

还记得当年在爱丁堡大学死磕NLU(自然语言理解)的时候,Keller教授给出的定义吗?输入是自然语言,输出是计算机能理解的结构化信息。现在,风水轮流转,轮到多模态大模型(MLLM)了。简单粗暴地说,MLLM就是把NLU的输入升级成等等,但输出还是结构化信息(通常是文本)。这就像给AI加了个“眼睛”,让它不仅仅能“听懂”人话,还能“看懂”世界。当下最火的,莫过于多模态大模型:它是 Multimodality Understanding 与 LLM (Large Language Model) 的激情碰撞。

Javachichi的博客 967

Go语言全面解析:从入门到精通

Go语言是由Google开发的一种静态类型、编译型编程语言,具有简洁、高效、安全的特点。它特别适合高并发服务、云原生应用和网络编程等场景。Go采用Goroutine和Channel实现轻量级并发,性能接近C/C++。与其他语言相比,Go语法更简洁但类型更严格,编译速度快且跨平台支持好。虽然Go支持多种设计模式和编程范式,但其面向对象实现方式与传统语言不同。标准库丰富且拥有Gin、GORM等企业级框架。核心语法包括包管理、变量声明、函数定义、流程控制等,适合构建高性能后端服务和系统工具。

博哥哥的博客 4925

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

多模态大模型怎么选:四大主流 MLLM 能力对比与选型指南

想让一部两小时的发布会视频自动分章、把关键事件打点标注、再顺手生成摘要?这正是多模态大模型(MLLM)能解决的事情。借助一站式 MLLM 资源库 Awesome-Multimodal-Large-Language-Models,本文以"长视频打点"这个真实需求为线索,从概念、评判维度、数据对比到动手实操,带你完成一次完整的选型。 ## 长视频打点:检验多模态大模型的一道实景题 ### 为什么长

gitblog_02298的博客 364

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【必收藏】大模型完全指南:从LLM到多模态模型的入门详解

【必收藏】大模型完全指南:从LLM到多模态模型的入门详解

xxue345678的博客 1439

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

【大白话讲论文】OpenHelix:“综述+开源+双系统”的VLA模型

摘要(150字) 本文系统研究了双系统视觉-语言-动作(VLA)模型的设计与性能,提出统一评估框架DP-VLA。实验发现:1)双系统架构在动态场景中显著优于单系统;2)MLLM微调+CLIP损失效果最佳;3)Prompt Tuning在语言泛化任务中表现突出;4)Projector预对齐对模型集成至关重要;5)异步步长对性能影响微弱,因潜在向量主要编码指令语义而非环境变化。研究揭示了当前VLA模型的局限性,并为未来设计提供了实证依据。代码已开源。

啦啦啦啦啦 1381

程序员必看:大模型技术全面解析,从LLM到多模态模型,建议收藏学习

本文全面介绍大模型基础知识,包括大语言模型(LLM)的定义、架构与核心能力,视觉基础模型的主流架构与应用,语音大模型的多任务处理能力,多模态大模型(MLLM)的跨模态处理技术,以及推理大模型的能力增强方法。文章详细解析了GPT系列、Llama系列、Qwen系列等代表性工作,为读者提供从基础概念到实际应用的完整技术路径,帮助系统理解大模型技术体系。

kaka0722ww的博客 880

CLIP、ViLT 与 LLaVA:多模态模型是如何看图说话的?

这三种模型可以形成一条多模态的发展路径:模型图文处理方式能力优点不足CLIP图文分开编码 + 对比学习图文检索、匹配训练数据丰富、表现稳定不会说话,只能匹配ViLT图文融合 + Transformer图文匹配、分类模型轻巧、统一结构图像理解能力弱,不生成语言LLaVA图像理解 + LLM生成图像问答、对话能看图说话、回答灵活拼接结构、效率较低至此,我们大致初步讲清楚了多模态的历史发展,以及从能力角度和痛点来进行还原与分析。目前多模态的发展也是很快的,例如。

ox180x的博客 1665

300篇文献浓缩成一张图:这篇TMLR综述把“多模态省算力“这件事讲成了三层楼

综述开篇的判断很直接:多模态的效率问题不是"单模态效率问题加一个模态"那么简单。单模态优化的是同质数据流,多模态要编排的是语义密度、分辨率、时间动态都不一样的异构信号——图像 token 冗余高、文本 token 语义密、音频流又细又长,三种东西塞进同一个 Transformer,冗余的分布是完全不均匀的。作者把瓶颈拆成了两条任务线。理解任务的开销集中在低复杂度编码器和跨模态对齐上;生成任务则额外背上自回归解码和去 token 化(detokenization)的包袱。理解贵在"进去",生成贵在"出来"

寸先生的AI道路 235

大模型究竟是个啥?都有哪些技术领域,面向小白的深度好文!

点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近30个方向学习路线很多刚入门大模型的小伙伴往往一头雾水,不知道大模型是个啥?什么LLM、VLM、MLLM、推理大模型,这些名词熟悉又陌生,今天星球内部的这篇文章就从大白话的角度给大家讲解一下~大语言模型(Large Language Model,LLM)是基于海量文本数据训练的深度学习模型,其核心能力在于理解并生成自然语言文本。这类模型通过在大规模数据集上进行预训练,学习语言的统计规律、语义关联以及世界知识,从而能够完成各种语言相关任务。LLM

CV_Autobot的博客 313

从零开始(大白话)认知大模型--AI2.0新宠儿_怎么和小白说大模型

定义大模型是大家看科幻片里面的仿生人(人造人)的大脑,它是仿生人学习整个世界的知识形成的具有感知、认识的大脑,能够进行预测和决策,专业点说法就是大模型是一个具有大规模参数量的初始网络结构在载体芯片上对世界上的庞大数据进行学习,最终形成的一个高度浓缩了海量知识的高级网络结构,类似于新生儿对世界无知的大脑通过不断学习,发育为拥有大量社会知识的成人大脑。大模型低级目标是特征提取,高级目标是世界模型。

优快云_224022的博客 1043

从零开始(大白话)认知大模型--AI2.0新宠儿

定义大模型是大家看科幻片里面的仿生人(人造人)的大脑,它是仿生人学习整个世界的知识形成的具有感知、认识的大脑,能够进行预测和决策,专业点说法就是大模型是一个具有大规模参数量的初始网络结构在载体芯片上对世界上的庞大数据进行学习,最终形成的一个高度浓缩了海量知识的高级网络结构,类似于新生儿对世界无知的大脑通过不断学习,发育为拥有大量社会知识的成人大脑。大模型低级目标是特征提取,高级目标是世界模型。

jiushi26的博客 1325

揭秘InternVL3_5-14B训练原理:级联强化学习MPO+GSPO如何提升多模态推理

InternVL3_5-14B 是 InternVL3.5 家族的 14B 级开源多模态大模型(MLLM),总参数量约 15.1B,由 0.3B 视觉编码器 + Qwen3-14B 语言模型构成。它最大的看点是**级联强化学习(Cascade RL)**:先用离线强化学习算法 **MPO** 打基础,再用在线强化学习算法 **GSPO** 精调,两阶段"由粗到细"显著提升 MMMU、MathVis

gitblog_00375的博客 473
上一篇: 0基础搭建本地私有知识库,给 GPT 插上翅膀,有手就行
下一篇: 多模态大模型的最优预训练范式
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值