


小白程序员必看:轻松入门大模型,附收藏学习资源包!
本文以通俗易懂的方式解析大语言模型的原理,从“是什么”“如何工作”到“程序员如何应用”,帮助零基础小白理解大模型的运作逻辑,并推荐收藏实用学习资源,助力技术升级。大模型通过海量文本学习语言规律,靠“猜词”生成连贯内容,其“大”在于学习材料与参数规模庞大,应用场景广泛,是程序员提升竞争力的关键技术。
前阵子和一位从未接触过计算机领域的朋友闲聊,聊到我日常深耕的技术方向时,他饶有兴致地追问:“经常听人说GPT、大模型,它们到底是怎么干活的?” 这句话点醒了我——如今大模型早已渗透生活、办公甚至编程场景,但很多人(包括刚入门的程序员、零基础小白)都只停留在“知道它有用”,却对其底层逻辑一知半解,满心好奇却无从下手。
声明一下:我本身并非大语言模型领域的专职研究者,更多是从“实用科普”角度,结合自身技术积累拆解知识点,以下内容若有疏漏,欢迎各位程序员大佬、技术爱好者留言指正、交流探讨,共同进步。
现在我们打开手机查天气、让AI生成接口文档、用智能助手调试简单代码,甚至闲下来和AI唠几句解闷时,很少会意识到,背后帮我们“摸清需求、输出有效答案”的“隐形帮手”,大概率就是大语言模型。从智能音箱的语音回复,到办公软件里一键生成的会议纪要,再到程序员常用的代码注释生成、bug排查辅助,这些看似“懂你所想、高效省心”的功能,本质上都离不开大语言模型的支撑。
但不少人(尤其是小白和刚入门的程序员)都会有这样的疑惑:这个“会聊天、能办事、还能写代码”的技术到底是什么?它没有真正的“大脑”,怎么就能听懂人话、读懂需求,还能像人一样流畅表达、甚至输出可用代码呢?
今天就抛开复杂的专业术语,从“大语言模型是什么”“核心原理咋回事”“它是怎么学本事的”“程序员能用到哪些场景”这几个角度,用最通俗的话拆解到底,哪怕没有计算机基础、刚接触编程,也能轻松看明白,收藏起来慢慢学,再也不用被“大模型”的专业门槛劝退!
1、大语言模型是什么?
简单讲,大语言模型就是一个“精通语言的超级学霸”。它这辈子就专注两件事:一是“听懂你说啥”,比如你问“附近有好吃的面馆吗”,它能get到你想找用餐地点的需求;二是“说你能懂的话”,比如回复“街角那家老面馆味道不错,主打牛肉面,今天人应该不多~”,语气自然得像朋友推荐。
你可以把它想象成一个“会说话的智能机器人”,但它没有真正的“大脑”——既没有神经细胞,也没有思考能力,它的“核心”其实是计算机里一套复杂的程序,再加上海量数据“喂”出来的经验。这个“学霸”最牛的地方在于,它“学东西的速度”和“记规律的能力”,远远超过了人类。

2、大语言模型的核心原理
大语言模型能“干活”,靠的是两步走:第一步,像小孩学说话一样“疯狂读材料”;第二步,靠“猜下一个词该啥样”,慢慢学会“说人话”。
1 像小孩学说话一样“疯狂读材料”
咱们小时候学说话,是靠听爸妈聊天、看动画片、听老师讲课,慢慢记住“哪个词该跟哪个词搭”“一句话该怎么说才顺”。大语言模型学语言的逻辑,和这一模一样——只不过它的“学习资料”多到吓人。
它会把互联网上能找到的文本几乎“读”个遍:从百年前的经典书籍、每天更新的新闻报道,到普通人的聊天记录、网络小说,甚至程序员写的代码(如果需要学编程的话)……这些材料加起来,能有几千亿甚至几万亿个词,相当于把从地球堆到月球的“超级图书馆”里的书,全读了一遍。
读这些材料的时候,它会悄悄记下语言的规律:比如“月亮”后面常跟“圆”“亮”“挂在天上”,不会跟“跑步”“吃饭”;“我喝水”是对的,“水喝我”是错的(这是语法规律);“开心”和“快乐”意思差不多,“胖”和“瘦”是反着的(这是语义规律)。就像小孩记住“妈妈抱”是对的,“抱妈妈”有时候不对一样,它也会把这些“规矩”刻在自己的程序里。
2 靠“猜下一个词该啥样”,慢慢学会“说人话”
咱们跟人聊天时,其实一直在“猜”——猜对方接下来会说啥,也猜自己下一句该说啥。比如你跟朋友说“周末我打算去______”,朋友大概率会猜到你可能说“爬山”“逛街”“看电影”。大语言模型的核心本事,就是把这种“猜测”做到了极致,它所有的“表达”,本质上都是在“预测下一个词该是什么”。
举个例子:你问“推荐一首适合雨天听的歌”,它会这么“琢磨”:首先看“推荐一首适合雨天听的______”,根据之前读的材料,它知道这里大概率是“歌”(但你已经说了“歌”,所以接着想);然后想“雨天听的歌”通常跟什么有关?可能是“温柔”“舒缓”“治愈”“有点小情绪”;再从记过的歌里,找符合这些感觉的,比如《雨一直下》《小幸运》(雨天听也很有氛围);最后把这些想法组织成句子:“雨天适合听舒缓治愈的歌,比如《小幸运》,旋律轻轻的,配上雨声特别舒服~”。
它说的每一句话,都是一个词一个词“猜”出来的,而且会根据前面说过的内容(也就是“上下文”)调整猜测——比如前面提到“雨天”,后面就不会推荐“阳光总在风雨后”这种太“燃”的歌,确保句子连贯、符合你的需求。

3、大语言模型的学习过程
前面说了大语言模型的核心原理,那在计算机里,它具体是怎么“学本事”的呢?其实它的学习逻辑,跟咱们上学、做题、进步差不多——只不过它的“老师”是数据,“作业”是计算,“进步”靠调整程序里的“小开关”。
1 、学习前的准备:搭好“基础大脑框架”
在开始学之前,工程师会先给模型搭一个“空的大脑”——这是一个叫“神经网络”的数学结构,你可以把它想象成一个超级复杂的“电子拼图”:里面有无数个“小零件”(专业叫“神经元”),这些零件之间用“细线”(专业叫“参数”)连在一起。
这个框架的作用,就像人类的大脑结构:宝宝出生时就有大脑,但里面啥知识都没有,得靠后天学;模型的神经网络也一样,一开始所有“细线”的连接强度(也就是参数的数值)都是随机的——就像刚出生的宝宝不会说话、不会走路,得通过学习慢慢调整“大脑里的连接”。
2 、“上课”:把海量文本拆成“数字”喂进去
模型的“学习材料”是互联网上的海量文本,相当于给它请了无数个“老师”,让它没日没夜地“听课、看书”。但它跟咱们不一样,咱们能直接读文字,它只能“懂数字”,所以得先把文本“翻译”成它能理解的“数字语言”:
第一步,给每个词贴“数字标签”。比如“早安”对应一个特定的数字,“咖啡”对应另一个数字,所有词最终都会变成一串数字(专业叫“词向量”)——就像给每个汉字编了个“身份证号”,模型看到数字,就知道对应的是哪个词。
第二步,一段一段“喂”给模型。比如把“早上喝杯咖啡很提神”这句话,先变成一串数字,再输入到神经网络里。这时候,里面的“小零件”和“细线”就会开始工作,分析这些数字之间的关系。这一步不是让模型“背下来”这句话,而是让它通过无数句话,慢慢摸透“早上”常跟“咖啡”“提神”搭,“喝”后面常跟“咖啡”“水”这类规律。
3 、“做题”:靠“填空题”纠错,越练越准
学了一段时间后,模型就得“做题检验”了——这一步是它进步的关键,专业叫“训练”。过程有点像老师布置“填空题”,让它反复练,错了就改,直到做对为止。
具体怎么操作呢?首先“老师出题”:从学习材料里挑一句话,比如“夏天吃西瓜最______”,故意把最后一个词(比如“爽”)删掉,只给模型看“夏天吃西瓜最”;然后“模型答题”:它根据之前学的规律,猜空格处可能是“爽”“解渴”“甜”,还会给每个词打个分,比如猜“爽”的概率是80%,“解渴”是15%;接着“对答案、找错误”:老师告诉它“正确答案是‘爽’”,如果模型猜“爽”的概率只有60%,就说明它还没学透;最后“调整‘细线’纠错”:模型会反过来调整神经网络里“细线”的连接强度——比如让“夏天吃西瓜最”和“爽”的连接更紧密,下次再遇到类似题目,猜“爽”的概率就能更高。
这个“出题-答题-纠错-调整”的过程,会重复几百万、几千万次,直到模型猜词的准确率越来越高,几乎能做到“看到前面的词,就知道后面该接啥”。
4、 “升级”:从懂“简单搭配”到懂“复杂逻辑”
随着训练次数越来越多,模型会慢慢掌握更复杂的语言规律:从一开始的“词和词怎么搭”,到后来的“一句话该怎么说才符合语法”;从能理解“字面意思”(比如“苹果是水果”),到能看懂“语境里的意思”(比如“他买了个苹果,能拍照还能玩游戏”,知道这里的“苹果”是手机);甚至能理解简单的逻辑推理,比如你说“我今天没带伞,外面下雨了”,它能猜到你可能需要“借伞”或“等雨停”。
这就像咱们从“认识字”到“读懂短文”,再到“能理解文章里的深层意思”——模型通过海量训练,把无数细碎的语言规律,都“刻”进了神经网络的“细线”(参数)里。
5、 “毕业上岗”:先考试,合格了再干活
等模型猜词的准确率高到一定程度,工程师就会拿一套“它没学过的题”(也就是全新的文本)给它做“毕业考试”。如果它能准确理解这些新文本的意思,还能生成符合逻辑的回答,就算“考试合格”,可以正式“上岗”,帮用户查天气、写文案、聊天了。
但它的学习并没有就此结束——上线后,工程师还会根据用户的反馈,偶尔给它“补补课”(专业叫“微调”)。比如很多用户说“它推荐的餐厅总不对”,工程师就会用更多“餐厅推荐”相关的文本,让它再练一遍,慢慢调整,让它更懂大家的需求。
4、最后聊聊:为啥叫“大”语言模型?
前面说了这么多,可能有人会问:“为啥要加个‘大’字?小模型不行吗?”其实“大”正是它比早期语言模型厉害的关键,主要体现在两个方面:
一方面是“学的材料大”。早期的语言模型,可能只学了几亿个词——相当于读了几百本畅销书;而现在的大模型,学的词有几万亿个,相当于把人类几千年积累的文字(从古代的诗词歌赋,到现在的网络热词“绝绝子”“躺平”)都读了一遍。材料越多,它见过的语言规律就越全,比如既能理解“举头望明月”的古典意境,也能get到“这届网友太有才了”的网络语境。
另一方面是“参数规模大”。你可以把“参数”想象成模型的“记忆细胞”——参数越多,它能记住的语言细节就越细。早期的语言模型,参数可能只有几百万;而现在的大模型,参数有几百亿甚至几千亿个。比如,小模型可能只知道“苹果是一种甜的水果”;但大模型还能记住“苹果也是手机品牌”“‘吃苹果’在某些语境里是‘考试通过’的意思”(比如有人说“科目二吃了个苹果,稳过”)——因为它见过足够多的例子,能分清不同场景下的不同含义。
总结一下:大语言模型其实就是个“靠海量阅读记规律、靠猜下一个词说人话”的“超级学霸”。它先靠工程师搭好“大脑框架”,再通过“读”几万亿个词学规律,接着用“填空题”反复练、反复改,最后通过“毕业考试”上岗干活。它的“聪明”,本质上是靠“做了万亿道题”练出来的——虽然它不知道“为什么这么说才对”,但它知道“这么说最符合人类的语言习惯”。
## 最后
近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!
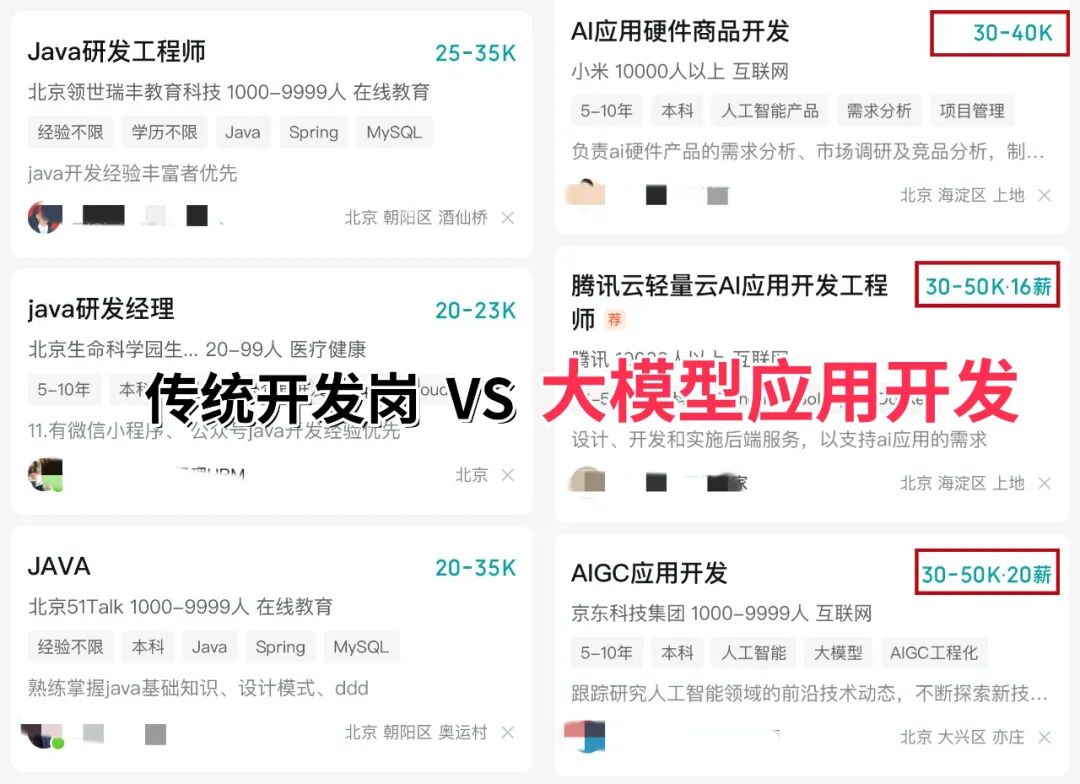
业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验,借行业风口实现职业翻盘!
深知技术人入门大模型时容易走弯路,我特意整理了一套全网最全最细的大模型零基础学习礼包,涵盖入门思维导图、经典书籍手册、从入门到进阶的实战视频、可直接运行的项目源码等核心内容。这份资料无需付费,免费分享给所有想入局AI大模型的朋友!
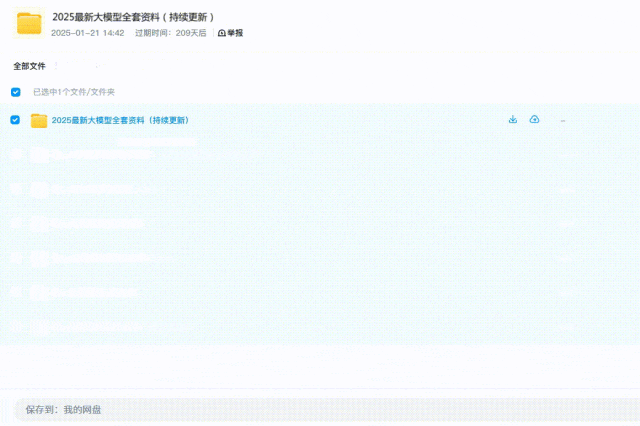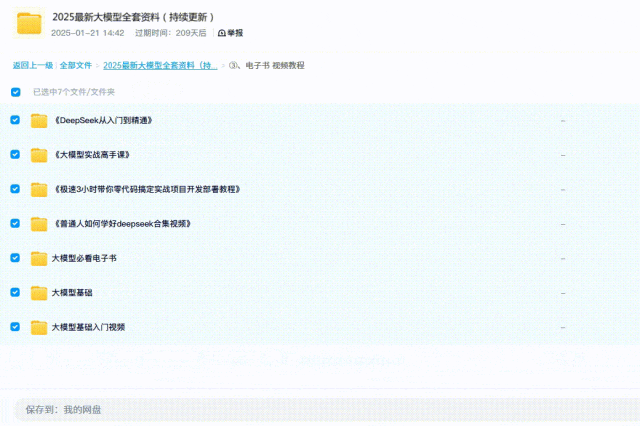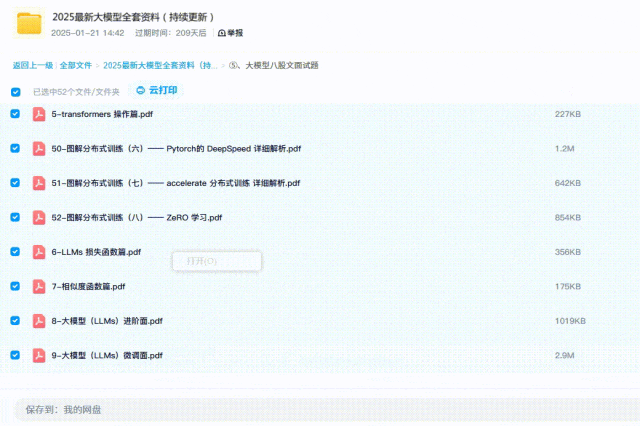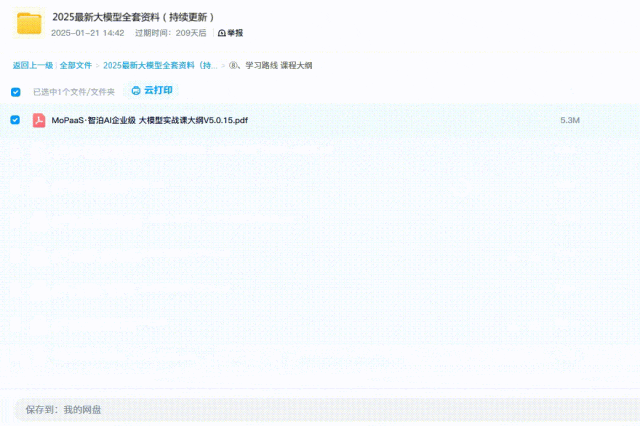
👇👇扫码免费领取全部内容👇👇
部分资料展示
1、 AI大模型学习路线图
2、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
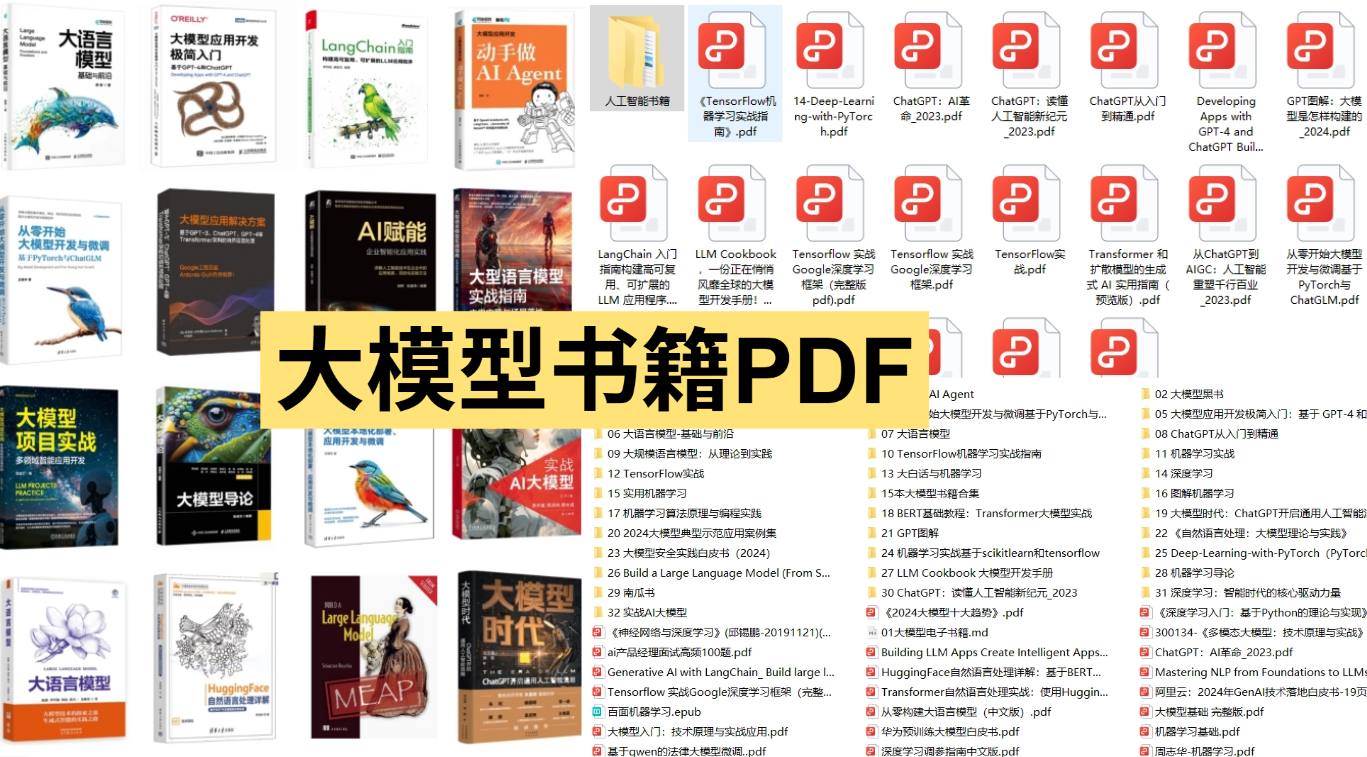
3、 大模型学习书籍&文档
4、 AI大模型最新行业报告
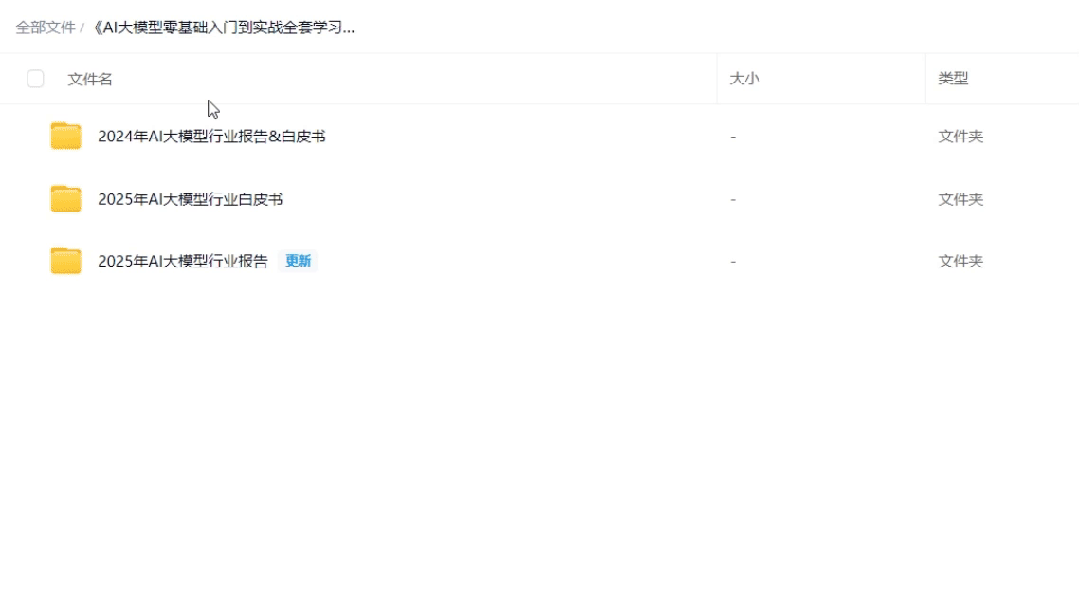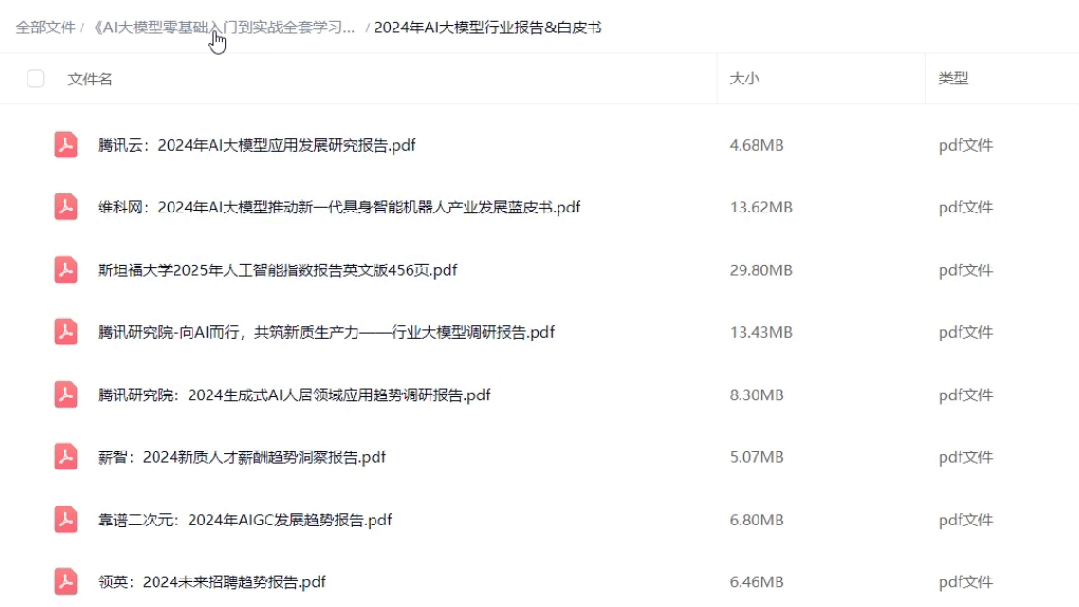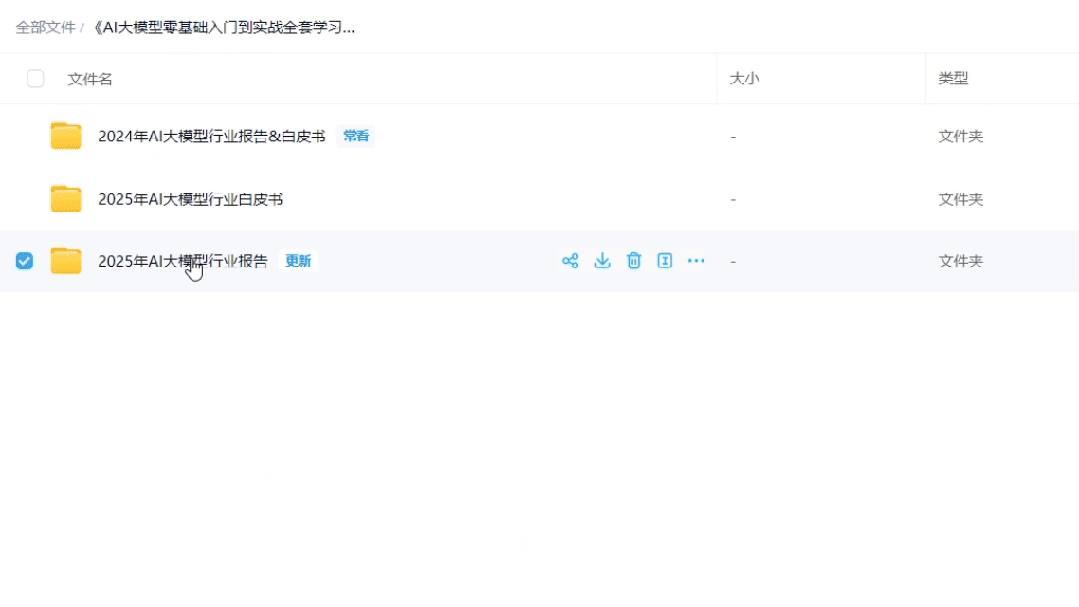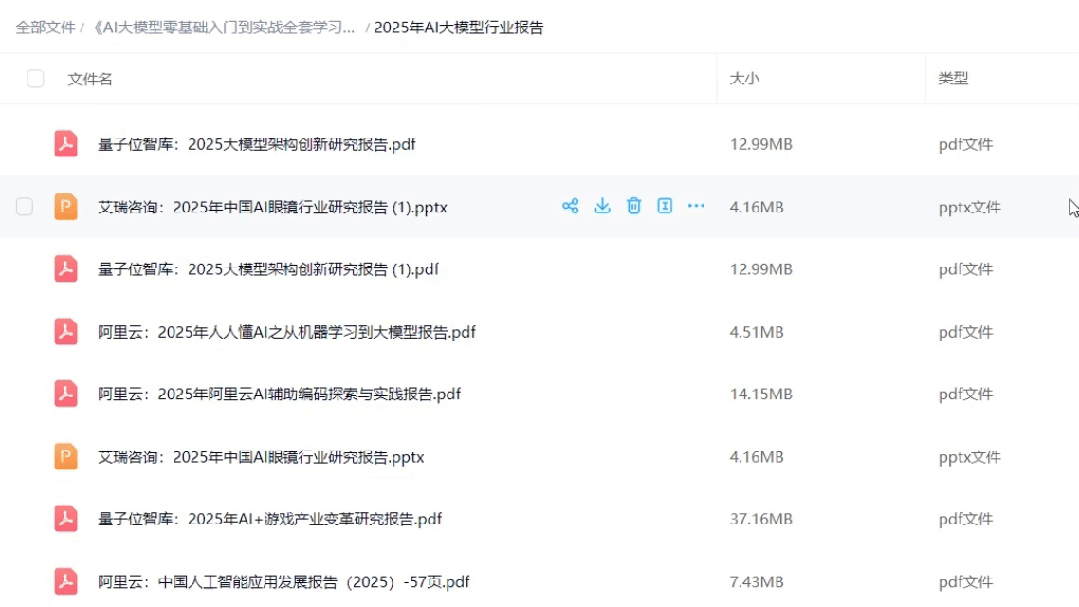
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
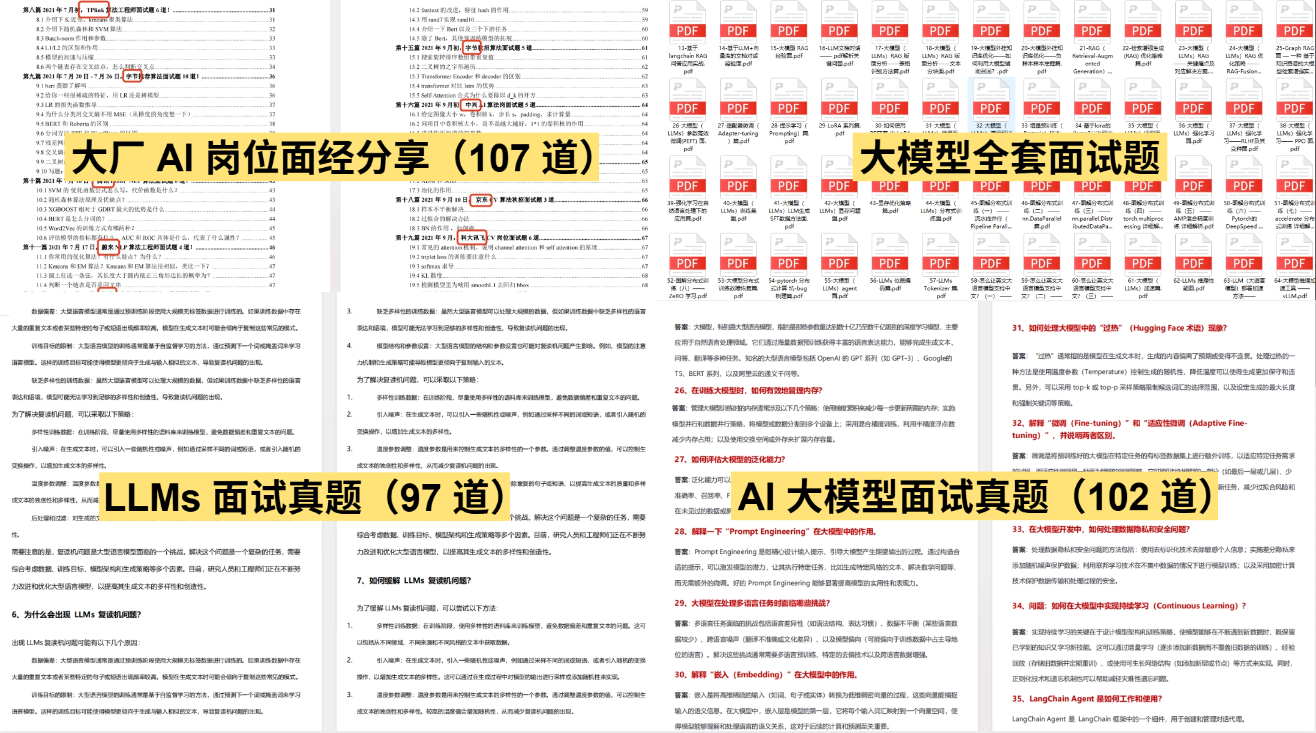
5、大模型大厂面试真题
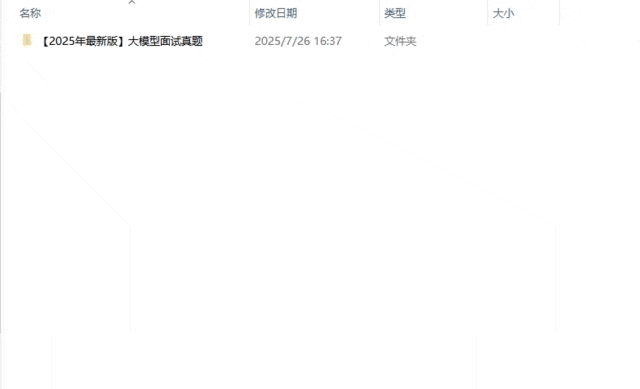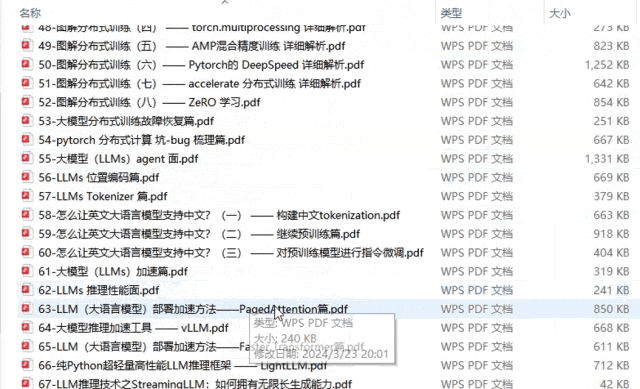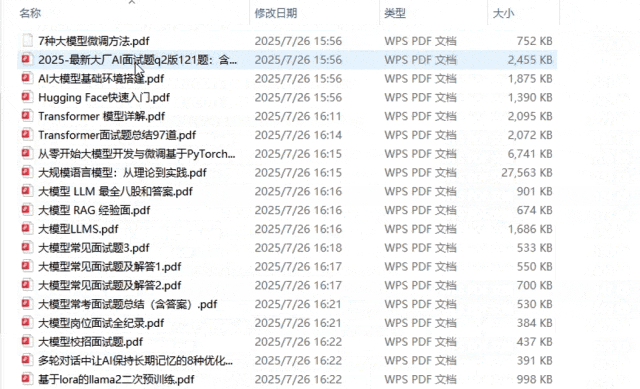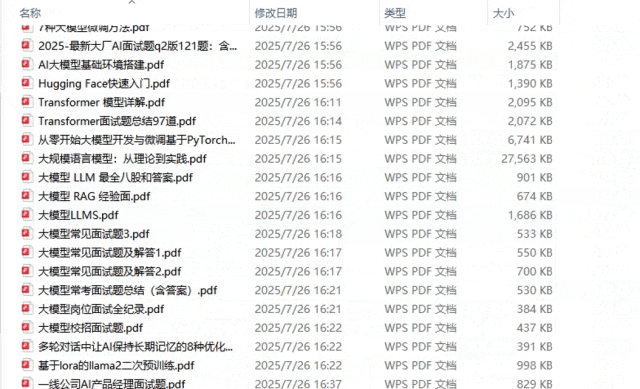
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。
6、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
- 👇👇扫码免费领取全部内容👇👇
这些资料真的有用吗?
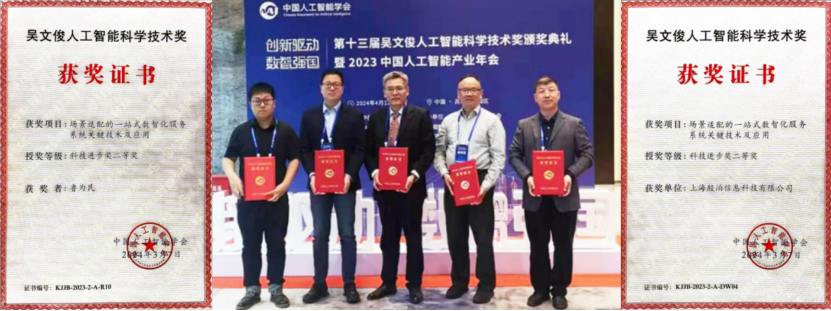
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 890


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


