一文搞懂AI大模型算力之GPU的概念、工作原理

GPU介绍和入门知识整理 GPU入门介绍知识 阅读详情

近几个月,几乎每个行业的小伙伴都了解到了ChatGPT的可怕能力。你知道么,ChatGPT之所以如此厉害,是因为它用到了几万张NVIDA Tesla A100显卡做AI推理和图形计算。

本文就简单分享下GPU的相关内容,欢迎阅读。

GPU是什么?

GPU的英文全称Graphics Processing Unit,图形处理单元。

说直白一点:GPU是一款专门的图形处理芯片,做图形渲染、数值分析、金融分析、密码破解,以及其他数学计算与几何运算的。GPU可以在PC、工作站、游戏主机、手机、平板等多种智能终端设备上运行。

GPU和显卡的关系,就像是CPU和主板的关系。前者是显卡的心脏,后者是主板的心脏。有些小伙伴会把GPU和显卡当成一个东西,其实还有些差别的,显卡不仅包括GPU,还有一些显存、VRM稳压模块、MRAM芯片、总线、风扇、外围设备接口等等。
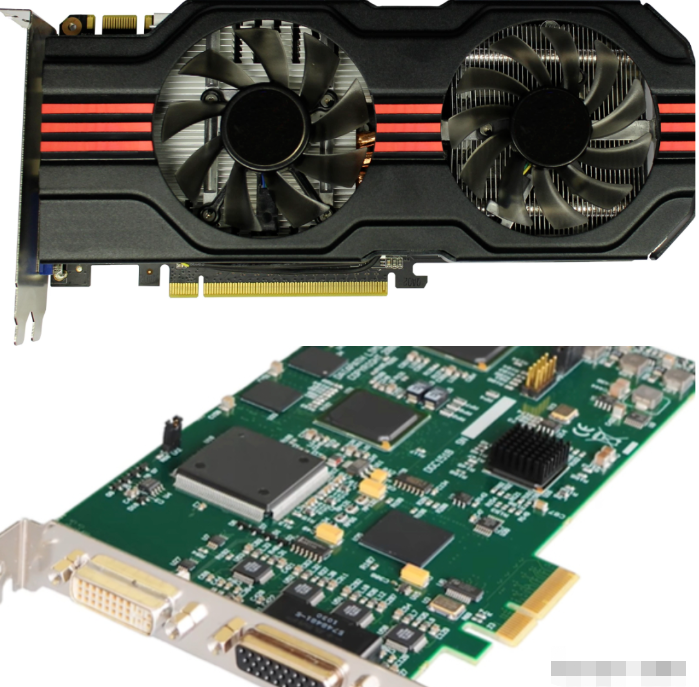
在这里插入图片描述

GPU和CPU谁最强呢?

这个其实不好说,好点的GPU内部的晶体管数量可以超过CPU,CPU的强项是做逻辑运算,GPU的强项是做数学运算和图形渲染。这就ChatGPT用大量高性能显卡做AI推理的原因。

接下来,我们做个简单的对比。

  • 结构组成不同

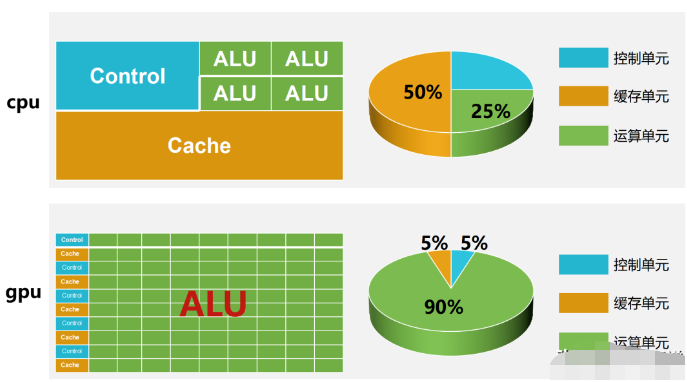
CPU和GPU都是运算的处理器,在架构组成上都包括3个部分:运算单元ALU、控制单元Control和缓存单元Cache。

但是,三者的组成比例却相差很大。

在CPU中缓存单元大概占50%,控制单元25%,运算单元25%;

在GPU中缓存单元大概占5%,控制单元5%,运算单元90%。
在这里插入图片描述

结构组成上的巨大差异说明:CPU的运算能力更加均衡,但是不适合做大量的运算;GPU更适合做大量运算。

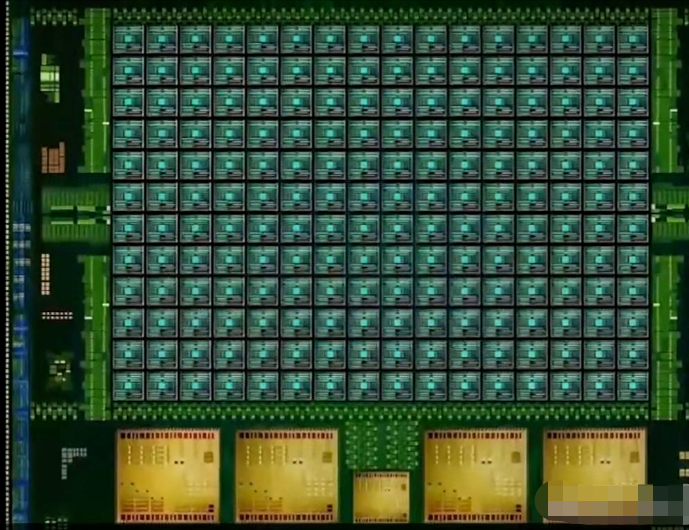
这倒不是说GPU更牛X,实际上GPU更像是一大群工厂流水线上的工人,适合做大量的简单运算,很复杂的搞不了。但是简单的事情做得非常快,比CPU要快得多。

相比GPU,CPU更像是技术专家,可以做复杂的运算,比如逻辑运算、响应用户请求、网络通信等。但是因为ALU占比较少、内核少,所以适合做相对少量的复杂运算。
在这里插入图片描述

  • 缓存不同

在CPU里面,大概50%是缓存单元,并且是四级缓存结构;而在GPU中,缓存是一级或者二级的。

  • 浮点运算方式不同

CPU性能更加注重线程的性能,在控制部分做的事情较多,这样做就是为了确保控制指令不能中断,在浮点计算上功耗少。

相较于CPU,GPU的结构更为简单,基本上它也只做单精度或双精度浮点运算。GPU的运算速度更快,吞吐量也更高。

  • 响应方式不同

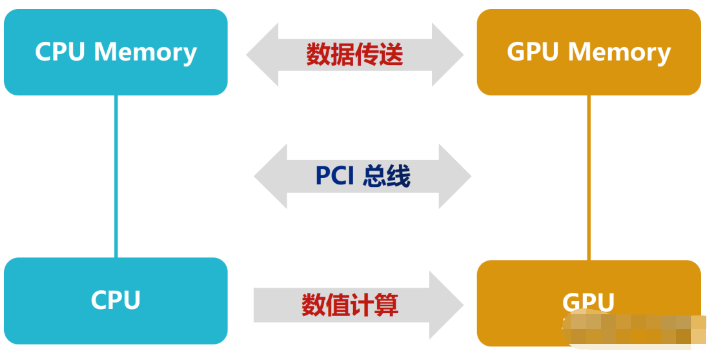
CPU基本上是实时响应,采用多级缓存来保障多个任务的响应速度。

GPU往往采用的是批处理的机制,即:任务先排好队,挨个处理。
在这里插入图片描述

GPU对于图形处理

我们假设在实时渲染中,一帧1080*720P的图片,那么这张图就有大概777600个像素点。如果按照最基本的24帧/秒的帧率计算。1秒钟就要求计算机处理18662400个,即:1866.24万个像素点。

这还是高清的情况下,如果是1090*1080、2K、4K甚至8K的视频渲染,可想而知,这个计算量是何其巨大。尤其是在像游戏这样的实时渲染场景下,显然仅仅依靠CPU渲染是会超时的。

实际上,在屏幕中显示的三维物体都要经过多重的坐标变换,并且物体的表面会受到环境中各种光线的影响,呈现不同的颜色和阴影。这就包括了光线的漫射、折射、透射、散射等。
在这里插入图片描述

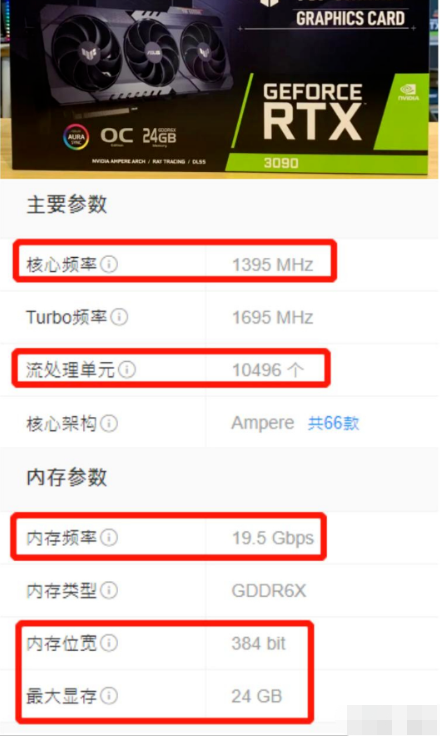
接下来,我们以英伟达NVIDIA RTX3090 为例,看下GPU是如何进行渲染的。

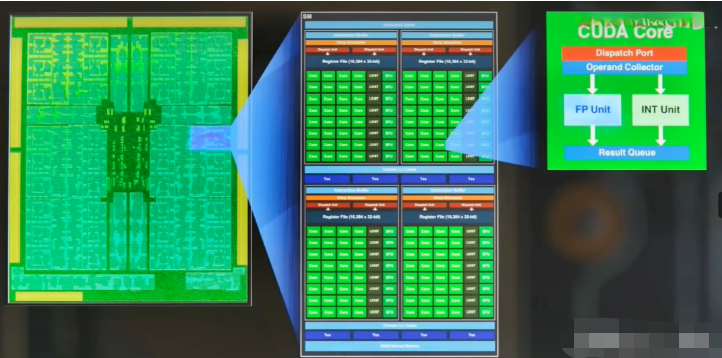
RTX3090的流式多处理器有10496个,每个内核都有具备整数运算和浮点运算的部分,还有用于在操作数中排队和收集结果的部分。

所谓流式多处理器可以认为是一个独立的任务处理单元,也可以认为一颗GPU包含了10496个CPU同时处理各个图片处理任务。
在这里插入图片描述

我们就可以通过算法和程序,对1秒钟18662400个像素点的整体任务进行切割分片,让10496颗处理器并行计算。

这样的话,每个处理器负责大概每秒处理18662400/10496,即1778个像素点的渲染任务就行了。

如下图所示,在GPU中会划分为多个流式处理区,每个处理区包含数百个内核,每个内核相当于一颗简化版的CPU,具备整数运算和浮点运算的功能,以及排队和结果收集功能。
在这里插入图片描述

注意,除了流处理器CUDA以外,影响GPU性能的还有

  1. 核心频率:频率越高,性能越强、功耗也越高。

  2. 显示位宽:单位是bit,位宽决定了显卡同时可以处理的数据量,越大越好。

  3. 显存容量:显存容量越大,代表能缓存的数据就越多。

  4. 显存频率:单位是MHz或bps,显存频率越高,图形数据传输速度就越快。

总结

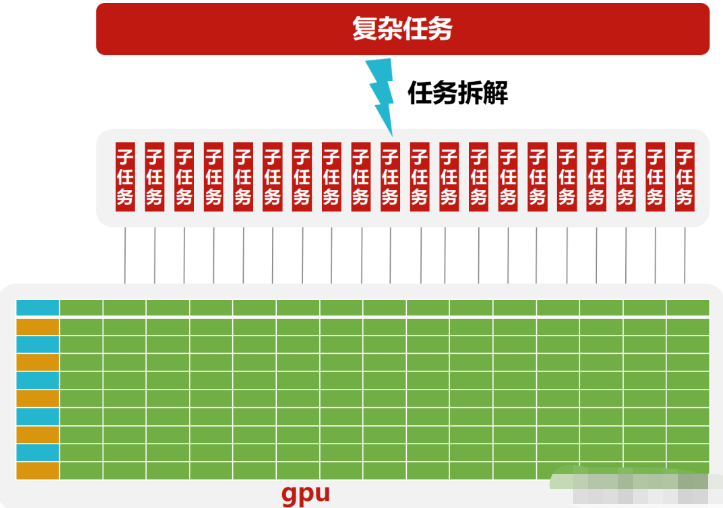
一言以蔽之,GPU不管是处理图形渲染、数值分析,还是处理AI推理。底层逻辑都是将极为繁重的数学进行任务拆解,化繁为简。

然后,利用GPU多流处理器的机制,将大量的运算拆解为一个个小的、简单的运算,并行处理。我们也可以认为一个GPU就是一个集群,里面每个流处理器都是一颗CPU,这样就容易理解了。
在这里插入图片描述

以上是关于GPU概念、工作原理的简要介绍。说是简单,其实在图形处理方面,还有很多深层次的处理逻辑没有展开,比如像素位置变换、三角原理等等。感兴趣的小伙伴可以深入研究下。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【硬件知识】从零开始认识GPU GPU(图形处理器)的发展史是一段充满创新与变革的历程,它不仅改变了计算机图形显示的方式,还推动了高性能计算、人工智能等多个领域的发展。以下是GPU发展史的概述及其中的一些趣闻。GPU发展史早期发展阶段起源:GPU的起源可以追溯到早期的图形显示控制器,如IBM在1981年发布的IBM 5150个人电脑中的黑白显示适配器和彩色图形适配器。这些设备虽然简单,但为后续的图形处理器发展奠定了基础。2D图形加速。 阅读详情

相关推荐

大模型的前世今生

在大模型之前的人工智能,属于弱人工智能,你可以把它理解为它就是一个专才,它是服务于某个专业领域的一个技术人员。即使是强者如阿尔法狗,它是在这个地球上最强的一个下围棋的智能体。但是它除了围棋之外,其他领域依旧是一个小白。但大模型是一个通才。因为它接受了大量的各种领域的数据训练,像语文、数学、围棋等等,ChatGPT也在两个月的时间突破了一亿的用户,也超过了之前tiktok 9个月创下的记录。那为什么它在这个时间点横空出世呢?

python122_的博客 1348

什么是GPU?GPU与CPU之间的区别,GPU大揭秘!

GPU架构

weixin_64043217的博客 1万+

一文让非技术宅读懂为什么AI更“喜欢”GPU而不是CPU?

2022年开始的各种AI的大规模应用为什么这么强烈GPU而不是CPU呢?本文以极简的语言让非技术宅们也能读懂AI为什么这么“喜欢”GPU而不是传统的CPU。

打造全国最全的AI Agent开发知识领域的博客 9039

人工智能入门第一篇:简单理解GPU和CPU

一直以来,我对CPU和GPU的概念都不太理解,明明CPU就是可以负责一切的计算活动,为啥还需要GPU呢,可以这样理解,CPU可以类比成一个大学的教授,GPU可以类比成1万个小学生,如果是计算复杂的运算,1千个小学生比不过1个大学教授,但是如果计算一千个十以内加减法,肯定是小学生胜。电脑的画面是有成千上万个像素点组成的,每一个点的实时颜色和亮度都需要单独计算,一个CPU通常只有几核,一个GPU可以有几千几万核,让他去处理图形运算能大大解放CPU的压力。

qq_36344652的博客 4282

量化策略分享 | MA超进化:LLT低延迟趋势线

移动平均线(MA)是我们技术分析中常用的一种趋势跟踪指标,但在使用的时候你是否也会有这样的烦恼:交易信号延迟太久,或者交易信号太频繁了!延迟性和平滑性问题似乎是不可兼得的“鱼和熊掌”。 针对这个问题,广发证券基于通信领域的滤波器原理,在《短线择时策略研究之三:低延迟趋势线与交易性择时》中创造性构建了:LLT低延迟趋势线(Low-lag Trendline)。 LLT低延迟趋势线是一种二阶滤波器,阶数相对适宜,相比MA、EMA等均线指标能够降低延迟,同时增强在低频部分的输出信号。 当然,..

量化交易研究 5314

2026年AI技能进阶指南:从提示词工程到智能体开发实战

提示词工程作为AI时代的基础沟通技能,其核心原理是通过系统化的交互方法论实现与大模型的高效对话。这项技术通过明确性、具体性和可操作性的设计原则,显著提升了AI生成内容的质量和实用性。在工程实践层面,提示词工程已经发展出角色扮演、步骤分解等成熟模式,广泛应用于代码生成、技术方案设计等场景。随着AI智能体开发的兴起,提示词工程进一步演化为定义智能体身份认知和行为规范的系统接口设计,成为构建自主AI系统的关键技术基础。掌握从基础提示词到智能体开发的完整技能栈,能够帮助开发者在AI技术浪潮中保持核心竞争力。

weixin_33139275的博客 333

深入解析AI大模型算力与GPU的工作原理

GPU最初用于加速图形渲染,但其强大的并行计算能力使其成为AI计算的主力军。与传统的CPU相比,GPU具备更多的处理核心和更高的内存带宽,非常适合处理深度学习中的大规模矩阵运算。

m0_65134936的博客 1936

ISP调试工程师相关面试问题_001

Qualcomm、MTK等ISP pipeline的框架原理及算法原理,还有调试经验。

notgoodenouf的博客 3552

算力之困,大模型何解?

互联网企业选择大模型合作伙伴之时,首要考虑的因素是算力。大模型本身就是巨量参数“力大砖飞”的结晶,也就是说大模型与大算力密不可分。发展到今天,国内的大模型在对话层面,已经与GPT-3.5接近,但在复杂指令层面与GPT-3.5或是GPT-4有着很大的差距。专家们预测,明年二季度末或三季度初,国内会涌现一批能力逼近GPT-4的大模型,届时中国不必再跟着OpenAI和谷歌的路径行走,而创造中国独特的打法。

2401_84494441的博客 1365

以太网物理层协议整理(2)-万兆以太网

在万兆以太网标准化过程中,IEEE和10GEA(万兆以太网联盟)是两个最重要的组织。 万兆以太网标准和规范都比较繁多,在标准方面,首先有2002年的IEEE 802.3ae,后来也不断有新的万兆以太网规范推出,如2006年的IEEE 802.3an标准(10GBase-T)就推出了基于双绞铜线的万兆以太网规范,同样的IEEE 802.3aq标准推出了基于光纤的10GBase-LRM;2007年的

NowOrNever 3万+

Windows: 深入剖析pip install SSLError与SSL模块缺失的根源及系统级修复

本文深入分析Windows系统下pip install SSLError与SSL模块缺失的根本原因,提供系统级修复方案。从Python安装包缺失SSL支持、OpenSSL库冲突到环境变量配置问题,详细讲解四大成因及对应的解决方案,包括重新安装Python、手动修复OpenSSL依赖等实用技巧,帮助开发者彻底解决HTTPS连接问题。

weixin_28595749的博客 459

一文读懂什么是GPU算力平台!

GPU算力平台是一种基于图形处理器(Graphics Processing Unit,GPU)的计算平台,它利用GPU的高性能并行计算能力来加速复杂数学运算和大规模数据处理。GPU作为专为并行处理设计的硬件,拥有数千个处理核心,能够同时处理大量数据,远超传统中央处理器(CPU)的处理能力。

ToB行业资讯站 1638

TCP Reno/CUBIC 拥塞控制算法对比:从 Tahoe 到 BBR 的 4 种核心策略演进

本文深入解析了TCP拥塞控制算法的演进历程,从经典的Tahoe、Reno到现代的CUBIC和BBR,详细对比了4种核心策略的实现机制与性能差异。通过分析拥塞窗口、流量控制等关键技术,揭示了不同算法在高带宽延迟网络中的优化方向,为网络协议栈优化提供理论依据和实践指导。

weixin_33725239的博客 443

AI大模型算力核心:GPU概念与工作原理全解析

一言以蔽之,GPU不管是处理图形渲染、数值分析,还是处理AI推理。底层逻辑都是将极为繁重的数学进行任务拆解,化繁为简。然后,利用GPU多流处理器的机制,将大量的运算拆解为一个个小的、简单的运算,并行处理。我们也可以认为一个GPU就是一个集群,里面每个流处理器都是一颗CPU,这样就容易理解了。以上是关于GPU概念、工作原理的简要介绍。说是简单,其实在图形处理方面,还有很多深层次的处理逻辑没有展开,比如像素位置变换、三角原理等等。感兴趣的小伙伴可以深入研究下。​。

2401_84495872的博客 1460

全球最大光伏电池缺陷异常检测数据集PVELAD【发布】

下载地址 1:GitHub - binyisu/PVEL-AD 下载地址 2:http://aihebut.com/col.jsp?id=118 下载地址 3:NAVEDownload 竞赛测试系统:Photovoltaic cell anomaly detection | Kaggle 一、简介 PVEL-AD 数据集又叫做EL2021数据集是用于对光伏电池异常缺陷检测方法进行基准测试的数据集,重点是光伏电池工业检测。PVEL-AD包含 36,543 张具有各种内部缺陷和异构背...

苏打水的杯子的博客 2万+

【2025最新】Multisim 14.3超详细安装步骤 【附安装包+永久+汉化】|Multisim 14.3

嗨,小伙伴们!是不是一直在找可靠的multisim下载安装教程?今天就给大家带来超详细的2025年Multisim 14.3安装全攻略!这款电路仿真神器绝对是学电子、做电路设计的必备工具!很多朋友后台留言说安装时各种报错、汉化失败,所以我决定出一期零基础、保姆级的教程,从下载到安装再到汉化,全部一步到位搞定!按照我的步骤来,包你顺利安装不出错!!!通过本教程,相信大家已经成功安装并配置好了Multisim 14.3。这款电路仿真神器能帮你设计和测试各种电路,从简单的LED闪烁到复杂的信号处理电路都不在话下。

pythonpapaxia的博客 8万+

一文读懂人工智能与大模型(附核心案例)

核心观点:基于机器学习与神经网络的才是现代AI的主流(传统规则系统只是“自动化”而非“智能”)。数据:AI的“养料”高质量:干净、标注准确(如医疗影像标注)多样性:覆盖各种场景(如不同光照下的人脸)代表性:反映真实世界分布(避免数据偏见)程序员痛点:数据清洗、增强、管理(常用工具:Pandas, OpenCV, SQL)模型:AI的“大脑算法”从数据中学习规律(如分类、回归、生成)核心架构:神经网络(CNN, RNN, Transformer)程序员日常:调参侠 ()、炼丹师(训练模型)、模型部署 (Ten

zhaoyi_he的博客 1022

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

【AI大模型接入SDK】人工智能发展历史 & AI相关岗位 & AI能否取代程序员

🎬 艾莉丝的简介:图灵机是艾伦・图灵 1936 年在《论可计算数及其在判定问题上的应用》中提出的抽象计算模型,由无限长纸带、读写头、状态转移规则构成,可以模拟任意算法的计算流程,是现代计算机与可计算性理论的理论根基。图灵机属于数学抽象模型,并非物理硬件。1943 年沃伦・麦卡洛克、沃尔特・皮茨提出 MP 人工神经元模型,是神经网络与深度学习的底层基础。工作原理:MP 神经元仅支持线性可分问题,无法处理异或这类非线性问题,这也是早期神经网络发展受限的根源。1950 年艾伦・图灵发表《计算机器与智能》提出图灵

艾莉丝努力练剑的博客,感谢大家一直以来的对艾莉丝的支持和鼓励,uu们如果对C/C++方向感兴趣的话,可以通过艾莉丝主页的微信名片加艾莉丝的好友,和努力练剑的艾莉丝一起加油! 6207

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

大模型算力

80G 的显存是一个高带宽的内存,L2 Cache 大小为 40M,所有 SM 共享同一个 L2 Cache,L1 Cache 大小为 192kB,每个 SM 拥有自己独立的 Cache,同样每个 SM 拥有自己独立的 Register,每个寄存器大小为 256 kB,因为总共有 108 个 SM 流处理器,因此寄存器总共的大小是 27MB,L1 Cache 总共的大小是 20 MB。在真正计算的时候,希望缓存的数据能够尽快的去用完,然后读取下一批数据,此时时候就会遇到时延(Lentency)的问题。

weixin_44245188的博客 1715

一文带你了解火遍全网的“AI大模型”

在聊到AI的时候,我们都离不开“大模型”这三个字。AI大模型已经完全融入了各个领域,也融入了我们的生活,它好像无所不在、无所不能。百度李彦宏说 :大模型改变世界;360周鸿祎说:大模型是新时代“发电厂”;李开复博士说:AI大模型是不能错过的历史机遇;……那么,究竟什么是大模型?今天我想和你深度聊聊,从概念到技术,从发展到未来,讲大模型剖析透彻,更好地看清未来方向。欢迎和我链接,一起探讨大模型的更多可能性。《中国AI大模型发展白皮书研究报告》

Python_cocola的博客 1800

AI大模型聪明背后的秘密!一文讲清其工作原理!

这篇文章以通俗易懂的语言介绍了大模型的基本概念、特点和工作原理。文章解释了大模型的定义及其三大特点:庞大的参数量、海量的训练数据和超强的计算能力;详细阐述了基于条件概率的预测原理;深入探讨了Transformer架构、预训练与微调、Token化等核心技术。同时介绍了智泊AI提供的AI大模型课程,帮助学习者成为大模型时代的抢手人才。

m0_74942241的博客 747

一文看懂AI大模型:开启智能新时代的“魔法盒子”,大模型从入门到精通,收藏这篇就够了

AI 大模型,全称人工智能大模型,是指拥有超大规模参数(通常在十亿个以上 )、复杂计算结构的机器学习模型。

瓦罗兰特顶级C位的博客 1625

为什么 AI 需要 GPU:面向无代码初学者的算力指南

当今 AI 技术快速发展的时代,GPU(图形处理单元)已成为人工智能计算的基石。对于许多刚开始接触 AI 技术的初学者而言,他们可能会疑惑:为什么 AI 需要 GPU?为什么不能只使用传统的 CPU?本文将深入探讨这些问题,为无代码初学者提供一份全面的算力指南。

shaozheng0503的博客 1772

为什么GPU比CPU更适合人工智能计算?

在最近的Hot Chips演讲中,NVIDIA首席科学家Bill Dally详细描述了过去十年中单个GPU在AI推理方面性能的惊人增长,达到了1000倍的扩展,为了跟上这个优化进度,GPU系统通过协同应对各种挑战。为了满足AI模型不断变化的需求,NVIDIA 的工程师已经优化了 GPU 内核,最新的 GPU 包括 Tensor Core,其功能比第一代设计强大 60 倍,用于处理矩阵数学神经网络。就其本身而言,GPU 包含数千个内核,微型计算器并行工作,以切开构成 AI 模型的数学。

ai2nv的博客 1020
上一篇: 李彦宏最新演讲:为什么大型模型即将改变世界?
下一篇: 医疗AI更精准?顶刊新研究揭示大模型在CPU上的应用现状!
AI大模型_学习君
博客等级 码龄3年 6138粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
