Langchain+LLM打造私域知识库

RAG实操教程: langchain+Milvus向量数据库创建你的本地知识库 本文主要是 Milvus 向量数据实战总结。LLM 痛点以及解决方案RAG 是什么,为什么选用RAG。langchain文档加载器,chat model文档拆分的注意点,chat model区别。chat 示例代码。 阅读详情

img

相信玩LLM的同学都已经听过Langchain这个框架了,LangChain-Chatchat (原Langchain-ChatGLM) :基于 ChatGLM 等大语言模型与 Langchain 等应用框架实现,开源、可离线部署的检索增强生成(RAG)大模型知识库项目。

通过langchain可以实现基于本地知识库的问答应用,langchain支持开源 LLM 与 Embedding 模型,可实现全部使用开源模型离线私有部署,对数据更加安全。也支持 OpenAI GPT API 的调用,可以作为网站或者APP的后端使用。如果自己电脑无法部署LLM模型也没关系,langchain也支持调用远程LLM,只要把相应LLM的key配置好即可。

实现原理

市面上绝大部分知识库都是 LangChain + LLM + embedding 这一套,实现原理如下,加载文件 -> 读取文本 -> 文本分割 -> 文本向量化 -> 问句向量化 -> 在文本向量中匹配出与问句向量最相似的top k个 -> 匹配出的文本作为上下文和问题一起添加到 prompt 中 -> 提交给 LLM 生成回答。在这里,可以把LLM当成一个自然语言问答的引擎,能够针对知识库做定向的回答。如果用户的提问在知识库中找不到,就会调用LLM自身的回答。

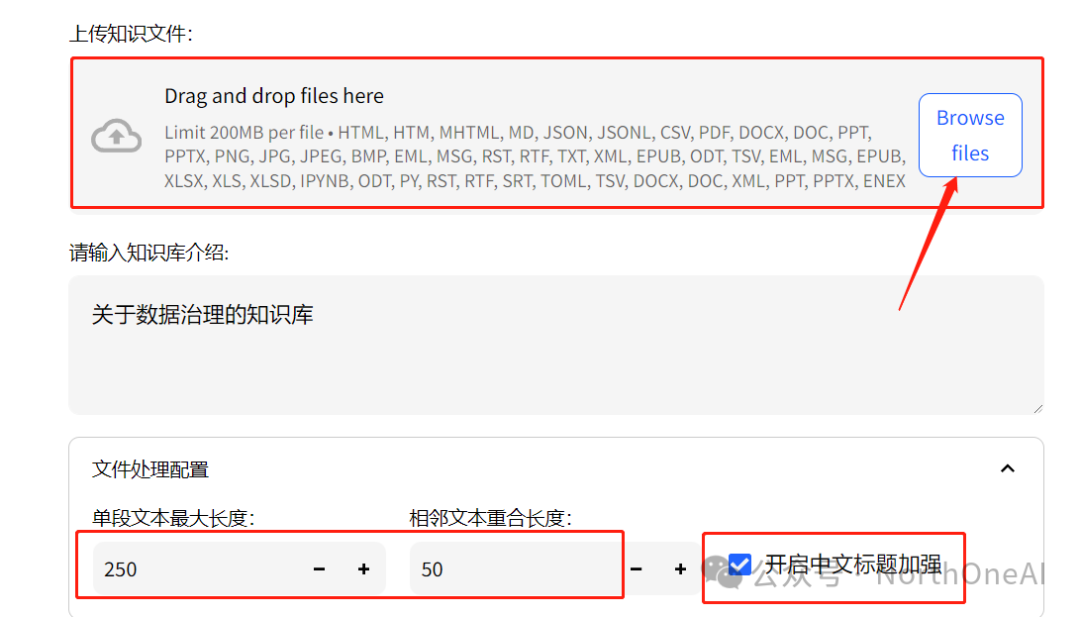
在创建知识库文档的上传页面,可以看到LangChain几乎支持所有能承载内容的文件形式,包括图片。从office文档,到电子书,html网页,每个文档不大于200M即可。

img

安装流程

0.确认CUDA版本和显卡显存

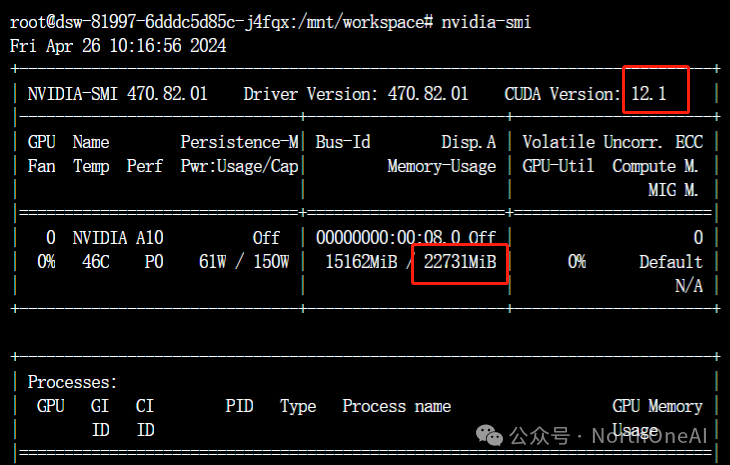
如果本地部署LLM,我们要把CUDA升级到至少12.1的版本,同时显存越大越好,根据我的经验,至少16G,不然可能无法加载模型。

命令行下执行nvidia-smi,查看CUDA的版本
img

如果CUDA版本不够,升级CUDA,

登录英伟达官网,根据操作指引找到适合自己的驱动,更新CUDA,以下是我的乌班图22.04,A10显卡的更新包。大家找到自己的也是类似的。

wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.0-1_all.deb

sudo dpkg -i cuda-keyring_1.0-1_all.deb

sudo apt-get update

sudo apt-get -y install cuda

CUDA升级完后在执行命令确认一下版本。

1.下载代码:

git clone https://kkgithub.com/chatchat-space/Langchain-Chatchat.git

git clone https://gitclone.com/github.com/chatchat-space/Langchain-Chatchat.git

当然也可以去github下载,但是因为访问问题,我这里直接放国内的镜像站,如果不想用git下载,文末有我上传网盘的地址可直接下载。

这2个镜像站推荐大家也收藏一下。

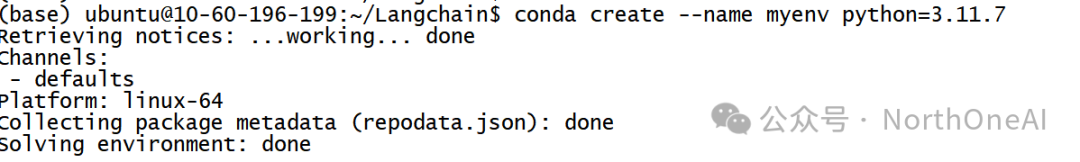
2.创建虚拟环境:
img

conda create --name myenv python=3.11.7

代码的readme里推荐用3.11.7,我们就装这个版本的虚拟环境。

3.激活虚拟环境,进入源代码根目录安装依赖

conda activate myenv

注意替换成自己的虚拟环境名字

然后cd到源代码的根目录,用pip安装依赖

先更新pip,这里都用阿里云的源

pip install -i https://mirrors.aliyun.com/pypi/simple --upgrade pip

下载依赖

pip install -i https://mirrors.aliyun.com/pypi/simple -r requirements.txt

pip install -i https://mirrors.aliyun.com/pypi/simple -r requirements_api.txt

pip install -i https://mirrors.aliyun.com/pypi/simple -r requirements_webui.txt

第一个比较费时间,后面2个会快一些,根据我的经验,如果下载速度100K/S左右,三个全部下载完大概需要1个多小时,第一个能占据80%的时间。

4.下载模型

这里我们本地部署,所以在进行第三步的同时,我们可以同时下载模型,这样更节省时间,需要2个模型,一个LLM模型,一个Embedding模型。

下载模型推荐魔塔:https://www.modelscope.cn/home

首先给git安装大文件下载支持

git lfs install

Embedding模型我们用text2vec-base-chinese,

下载地址:git-lfs clone https://www.modelscope.cn/Jerry0/text2vec-base-chinese.git

LLM模型我们选chatglm2-6b,当然也可以换别的。

下载地址:

git-lfs clone https://www.modelscope.cn/ZhipuAI/chatglm2-6b.git

这2个模型都下载好后,把它们放在一个目录里,目录地址没关系,不用和源代码放一个目录。

我是放在 /mnt/workspace/models/ 目录下的

img

5.复制配置文件

pip的依赖全部安装完后,可以执行这一步:

在源代码根目录下执行:

python copy_config_example.py

然后在根目录下会出现一个 config 目录,cd到这个目录里,稍微修改一下配置保存即可。

找到

MODEL_ROOT_PATH = “/mnt/workspace/models/”

这里配置一下模型根目录,我的就是 “/mnt/workspace/models/”

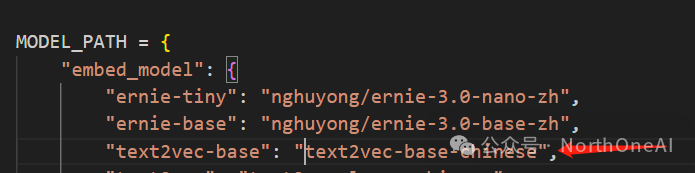
然后配置

EMBEDDING_MODEL = “text2vec-base-chinese”

再配置

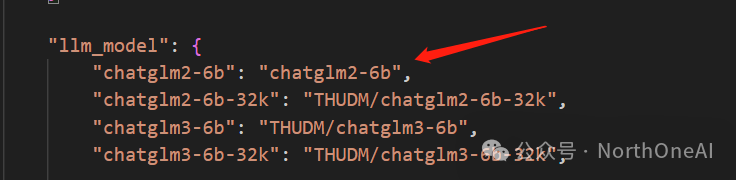
LLM_MODELS = [“chatglm2-6b”, “zhipu-api”, “openai-api”]

最后配置MODEL_PATH,改成自己使用的,确保value和之前配置的path拼起来能找到模型即可。
img

img

这样就配置好了。

6.启动

在源代码根目录执行

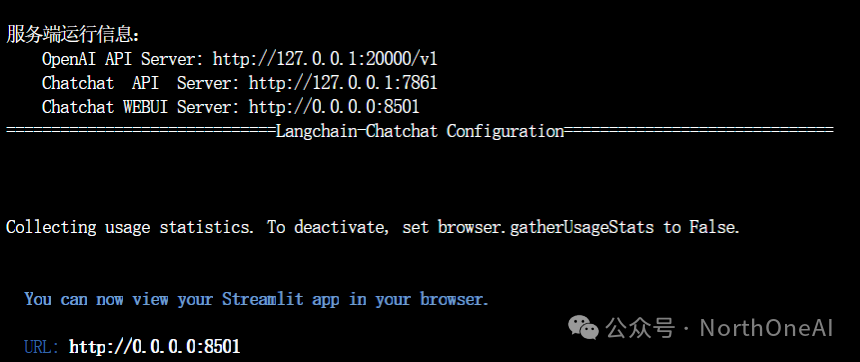
python startup.py --all-webui

注意这里是前台启动,远程访问要打开防火墙8501端口,出现下图就启动成功了,可以看到作为后台API服务器的地址,以及webui地址,我们在浏览器里用webui地址访问,本地就是localhost。
img


感受一下

img

左边可以选择LLM对话还是知识库对话,或者基于搜索引擎对话。

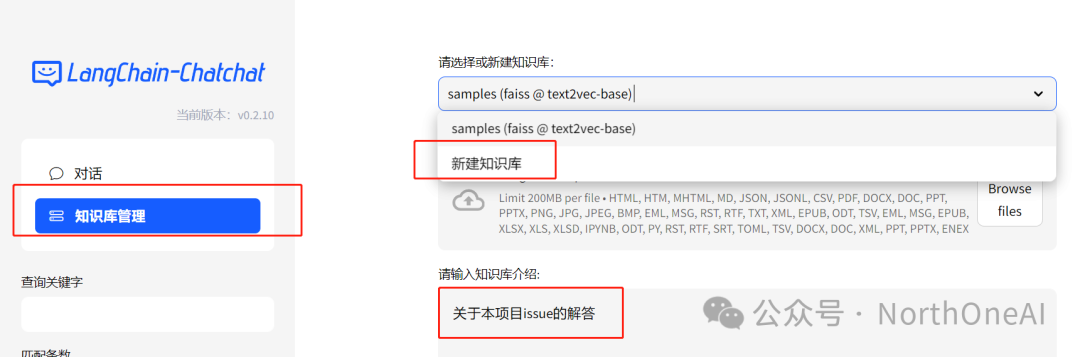
我们可以先创建知识库,点击知识库管理,
img

新建一个知识库,上传文档,

img

把开启中文标题加强勾上,然后在左边选择和知识库对话即可。其他一些功能大家就自己摸索吧。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【ChatGPT】打造你的私域知识库的聊天机器人:ChatGPT+LangChain+LlamaIndex 本文探讨了如何构建定制的DevSecOps知识库聊天机器人。这只是一个demo。利用LlamaIndex和LangChain构建应用程序,通过私有数据利用LLMs的潜力很大。References私域知识库的聊天机器人:ChatGPT+LangChain+LlamaIndex。 阅读详情

相关推荐

对LSTM中每个batch都初始化隐含层的理解

不知道有没有人和我有一样疑惑 在LSTM相关的代码中,为什么每个batch都会将隐藏层重新初始化, 这样不会把以前训练出来的参数丢掉吗?? 比如 代码来自GitHub 看了一些解释是h与c是状态,不是参数,每个batch中都需要初始化为0,LSTM 中的参数是W,b。 网络中训练的是参数,不是状态。 说真的。。。当时我没怎么看懂。。。 咨询了实验室的师兄后,我有了自己的理解 产生误解的主要原因是我对RNN和LSTM的结构理解不深入,我们通常看到RNN结构图基本都是这样的 ...

Chauncey_Wang的博客 5910

langchain +RAG 构建私域知识库

LLM的只是可能不是实时的LLM可能不知道你私有的领域/业务知识。

m0_65621281的博客 1006

步进电机梯形加减速算法的实现

步进电机梯形加减速算法的实现

m0_69251699的博客 1318

LLM预备知识、工具篇——LLM+LangChain+web UI的架构解析

LLM(fastchat)+Langchain+Gradio/Streamlit各种框架基础点

lucky_chaichai的博客 1万+

若依Vue整合积木报表实战:Token安全校验全流程解析

本文详细解析了在若依Vue后台系统中安全集成积木报表的全流程,重点阐述了Token安全校验的核心机制。通过前端菜单配置、Token传递、后端权限拦截及自定义Token服务实现,构建了一套完整的企业级报表访问安全防线,确保核心业务数据的安全可控。

t8u9v0的博客 578

2025年一篇解决Windows11安装医学图像处理工具-FSL(各种问题解决,过程详细,小白轻松安装)

2025年一篇帮你解决FSl安装所有问题,包括环境安装、使用说明、常见问题,过程简单易懂,小白轻松安装。

weixin_52145255的博客 2524

deepseek 私域知识库搭建(小白教程)

使用 Streamlit,您可以轻松为 RAG 智能体创建交互式聊天界面。以下是一个简单的 Python 示例,展示如何构建 DeepSeek RAG 聊天机器人。安装超时可以使用下面的方式进行安装。

guofei_ok的博客 1109

从零做出可发布的2D冒险游戏!Unity全流程实战指南:从资源搭建到打包发布,新手也能跟着做

项目配置→资源导入→核心模块开发→关卡设计→调试→打包发布;玩家控制→敌人AI→道具系统→UI系统→游戏管理器→音效系统;新手开发重点:先实现核心玩法(移动、跳跃、攻击),再补充UI、音效、存档等辅助功能;调试是关键:每实现一个功能就测试,避免最后一堆bug难以定位。从零做一款完整的2D冒险游戏,能快速提升你的Unity综合能力——不仅能掌握C#编程、2D物理、UI系统,还能理解游戏开发的完整流程。先做出基础版,再慢慢迭代优化,你会发现游戏开发并没有想象中那么难。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1176

如何快速、免费搭建一个独属自己的个人知识库?(框架、要点)看完这一篇你就懂了!!

AI大模型层出不穷,不知大家使用的感受怎么样。 作为码字一员,最大的感受是,AI大模型正在批量制造垃圾,反过来垃圾又在污染AI语料库,如此反复。 “如果数据源、参考源是垃圾,得到的也只能是垃圾。” 那么,如何控制数据源、参考源?

2401_85325557的博客 2458

手把手入门YOLO到改进优化教程 | 【P1基础篇】YOLOv8网络架构原理

本节先来学习基础知识,以YOLOv8进行讲解入门, 拿YOLOv8入手掌握YOLO的底层逻辑 ,也可以基于此来轻松学习后面更新的YOLO系列 (大部分YOLO版本的核心思想一致,更新是基于旧版本做结构升级、优化策略,学习成本会越来越低)。

嵌入式阿齐Archie 2万+

你的小龙虾 OpenClaw 还很笨?快给它装上这几个核心技能(OpenClaw 必装skills整理)

🦞 刚装小龙虾OpenClaw? 本文分享一些OpenClaw必装技能,从视觉理解到智能学习,让它从“会聊天”变“会干活” 🚀

XiaoqiangClub的博客 870

基于LangChain+LLM的本地知识库问答:从企业单文档问答到批量文档问答

本文则侧重讲解 1 什么是LangChain及langchain的整体组成架构 2 解读langchain-ChatGLM项目的关键源码,不只是把它当做一个工具使用,因为对工具的原理更了解,则对工具的使用更顺畅 3 langchain-ChatGLM项目的升级版langchain-chatchat

结构之法 算法之道 13万+

【HALCON工业视觉应用探索】02. C# + Halcon铸件毛刺机器人打磨引导:点云处理从实验室到工业现场的全流程落地

摘要:铸件毛刺的自动化打磨是机械制造领域的重要难题,其随机性(高度0.1-3mm)和复杂工况导致人工打磨效率低(3分钟/件)、工伤率高。本文基于Halcon 24.11与.NET 6,构建了一套点云处理方案:通过线激光扫描仪获取三维点云,经预处理、毛刺检测、路径规划三大模块,引导机器人完成打磨。虚拟实验测试显示,对高度>1mm的毛刺检出率达100%,定位误差±0.08mm,但工业现场受油污、粉尘影响,性能降至检出率68-75%、处理时间>45秒。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 1128

一文了解:langchain打造垂域的大模型Agent

ChatGPT之所以强大,在于其识识别能力、上下文理解能力,以及内容生成能力,打开了通用人工智能的大门。垂域模型发展之路大型语言模型(llm)是指能够生成与人类语言非常相似的文本并以自然方式理解提示的机器学习模型。这些模型使用广泛的数据集进行训练,这些数据集包括书籍、文章、网站和其他来源。通过分析数据中的统计模式,LLM可以预测给定输入后最可能出现的单词或短语。对于AIGC这个赛道来说,算力、算法、数据都是促使它优化的主要因素,而GPT技术的迭代升级,将大数据的重要性放到了一个空前的位置。在大算力、大投资、

zyjwjck的博客 2067

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

基于 InternLM 和 LangChain 搭建你的知识库

基于 InternLM 和 LangChain 搭建你的知识库

zcgai的博客 1928

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

基于LangChain+ChatGLM 部署本地私有化知识库

随着人工智能技术的不断发展,越来越多的企业和机构开始认识到知识库的重要性。知识库不仅能够集中管理大量的信息和数据,还能通过智能检索和推理功能,为用户提供准确、高效的知识服务。

2301_81888214的博客 1486

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

LangChain:打造自己的LLM应用

随着LLM的技术发展,其在业务上的应用越来越关键,通过LangChain大大降低了LLM应用开发的门槛。本文通过介绍LangChain是什么,LangChain的核心组件以及LangChain在实际场景下的使用方式,希望帮助大家能快速上手LLM应用的开发。

Langchain的博客 1438

【亲测免费】 打造你的专属知识库:Langchain+LLM本地知识库问答系统

打造你的专属知识库:Langchain+LLM本地知识库问答系统 【下载地址】开源代码项目LangchainLLM本地知识库问答系统 本项目是一个高效的问答系统,通过集成LangChain框架与强大的语言模型如ChatGLM-6B系列,实现了在本地部署的知识库问答功能。旨在帮助用户利用本地存储的各类文档(txt、docx...

gitblog_09770的博客 533

LangChain实战:从原型到生产,动手打造 LLM 应用 书籍推荐!

LangChain实战:从原型到生产,动手打造 LLM 应用 书籍推荐!

2301_81940605的博客 2223

LLM - 使用 Langchain 实现本地 Naive RAG

LLM 基于 Python Langchain 构建本地知识库。

BITDDD小栈 2743

用通俗易懂的方式讲解大模型:基于 LangChain 和 ChatGLM2 打造自有知识库问答系统

添加知识库文档步骤如下:先选新建知识库输入知识库名字,点击“添加至知识选项”上传文件,完了后点击“上传文件并加载知识库”然后就可以基于这个知识库进行问答了,操作十分简单。本文介绍了 GPU 服务器的选型,ChatGLM2 和 Langchain-ChatGLM 的部署和使用,如果想要了解更多关于 Langchain-ChatGLM 的实现原理,可以在他们 GitHub 仓库中查看更多的信息。如果你想打造属于自身业务的问答系统,可以参考本文的方法,希望可以帮助到你。

2301_78285120的博客 4323

LangChain-Chatchat:基于LangChain和ChatGLM2-6B构建本地离线私有化知识库

自从去年GPT模型火爆以来,降低了很多个人和企业进入人工智能领域的门槛,对于大模型尤其是开源的大模型国内应该比较受关注和期待,毕竟高额的成本也能将不少人阻挡在门外,其次,大家都希望在产品中集成LLM的能力,结合业务来落地智能化应用,提升产品的竞争力,最直接的应用就是构建知识库。

FrenzyTechAI的博客 5886

基于 InternLM 和 Langchain 搭建你的知识库

llm.predict("你是谁")# 我们所构造的 Prompt 模板template = """使用以下上下文来回答用户的问题。如果你不知道答案,就说你不知道。总是使用中文回答。问题: {question}可参考的上下文:···{context}···如果给定的上下文无法让你做出回答,请回答你不知道。有用的回答:"""

Y2483490891的博客 1547

基于internLM和LangChain的知识库搭建

文章来源于internLM训练营的课程,B站有相应视频。知识时效性受限:如何让LLM能够获取最新的知识专业能力有限:如何打造垂直领域的大模型(关注点)定制化成本太高:如何打造个人专属的LLM 应用和的开发范式RAG(检索增强生成) VS Finetune(微调):RAG通过外挂一个知识库来优先匹配出对应问题的文档知识,然后把文档和问题一同交给大模型来处理。以此来提高大模型的知识储备。RAG优点:低成本、RAG缺点:受基座模型的影响很大、单次回答知识有限。

2301_77641278的博客 879
上一篇: 揭秘 Transformer 内部原理:八问八答全解析!
下一篇: 大模型笔记 | 基于llama3.1 搭建知识库检索
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值