【大模型】GLM4-9B-chat Lora 微调

GLM-4-9b-chat 大模型的安装,微调,构建自己的数据集 教你把大模型调成自己的“小狗狗” 阅读详情
AI摘要

本文介绍基于transformers、peft等框架对LLaMA3-8B-Instruct模型进行Lora微调的方法,包括环境准备、配置、模型下载、指令集构建等步骤。还分享了大模型学习经验,提供AGI大模型系统学习路线、视频教程、学习书籍和实战案例等资料。

本节我们简要介绍如何基于 transformers、peft 等框架,对 LLaMA3-8B-Instruct 模型进行 Lora 微调。Lora 是一种高效微调方法,深入了解其原理可参见博客:知乎|深入浅出 Lora。

这个教程会在同目录下给大家提供一个 nodebook 文件,来让大家更好的学习。

环境准备

在 Autodl 平台中租赁一个 3090 等 24G 显存的显卡机器,如下图所示镜像选择 PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1。
接下来打开刚刚租用服务器的 JupyterLab,并且打开其中的终端开始环境配置、模型下载和运行演示。
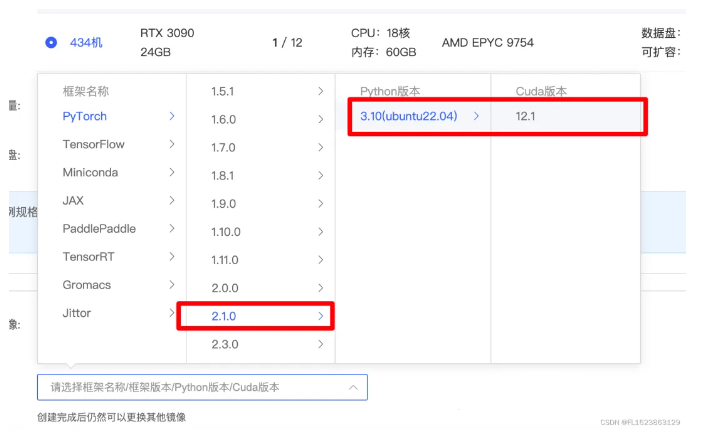
在这里插入图片描述

环境配置

在完成基本环境配置和本地模型部署的情况下,你还需要安装一些第三方库,可以使用以下命令:
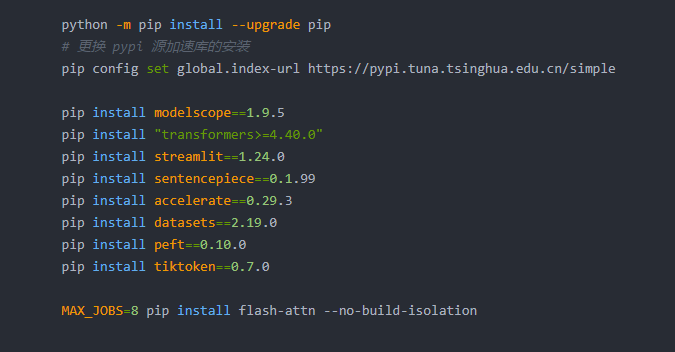
在这里插入图片描述

注意:flash-attn 安装会比较慢,大概需要十几分钟。

在本节教程里,我们将微调数据集放置在根目录 /dataset。

模型下载

使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。

在 /root/autodl-tmp 路径下新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python /root/autodl-tmp/model_download.py 执行下载。

import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os

model_dir = snapshot_download('ZhipuAI/glm-4-9b-chat', cache_dir='/root/autodl-tmp/glm-4-9b-chat', revision='master')

指令集构建

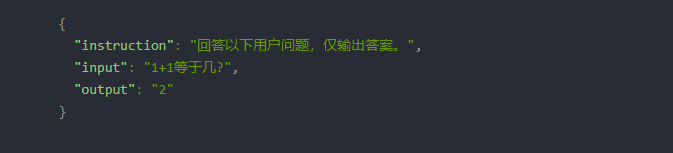
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
在这里插入图片描述

其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。

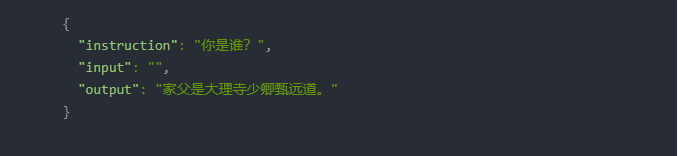
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:
在这里插入图片描述

我们所构造的全部指令数据集在根目录下。

数据格式化

Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:

def process_func(example):
    MAX_LENGTH = 384    
    input_ids, attention_mask, labels = [], [], []    
    instruction = tokenizer((f"[gMASK]<sop><|system|>\n假设你是皇帝身边的女人--甄嬛。<|user|>\n"
                            f"{example['instruction']+example['input']}<|assistant|>\n"                            
                            ),                             
                            add_special_tokens=False)    
    response = tokenizer(f"{example['output']}", add_special_tokens=False)    
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]    
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1    
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]      
    if len(input_ids) > MAX_LENGTH:  # 做一个截断      
        input_ids = input_ids[:MAX_LENGTH]        
        attention_mask = attention_mask[:MAX_LENGTH]        
        labels = labels[:MAX_LENGTH]

GLM4-9B-chat 采用的Prompt Template格式如下:

[gMASK]<sop><|system|> 
假设你是皇帝身边的女人--甄嬛。<|user|> 
小姐,别的秀女都在求中选,唯有咱们小姐想被撂牌子,菩萨一定记得真真儿的——<|assistant|> 
嘘——都说许愿说破是不灵的。<|endoftext|>

加载 tokenizer 和半精度模型

模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。

tokenizer = AutoTokenizer.from_pretrained('/root/autodl-tmp/glm-4-9b-chat/ZhipuAI/glm-4-9b-chat', use_fast=False, trust_remote_code=True)

model = AutoModelForCausalLM.from_pretrained('/root/autodl-tmp/glm-4-9b-chat/ZhipuAI/glm-4-9b-chat', device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True)

定义 LoraConfig

LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。

  • task_type:模型类型
  • target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
  • r:lora的秩,具体可以看Lora原理
  • lora_alpha:Lora alaph,具体作用参见 Lora 原理

Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是lora_alpha/r, 在这个LoraConfig中缩放就是 4 倍。

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,     
    target_modules=["query_key_value", "dense", "dense_h_to_4h", "dense_4h_to_h"],  # 现存问题只微调部分演示即可    
    inference_mode=False, # 训练模式    
    r=8, # Lora 秩    
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理    
    lora_dropout=0.1# Dropout 比例
)

自定义 TrainingArguments 参数

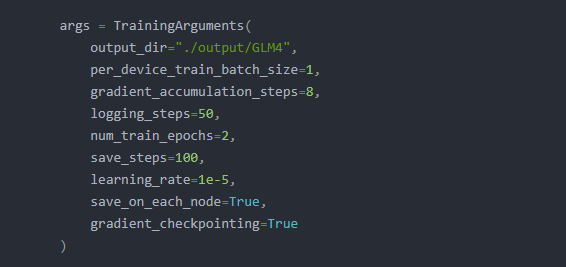
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。

  • output_dir:模型的输出路径
  • per_device_train_batch_size:顾名思义 batch_size
  • gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
  • logging_steps:多少步,输出一次log
  • num_train_epochs:顾名思义 epoch
  • gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
在这里插入图片描述

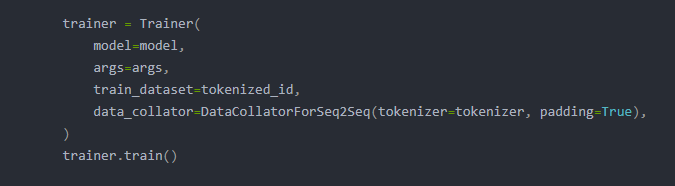
使用 Trainer 训练

在这里插入图片描述

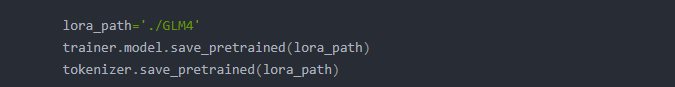
保存 lora 权重

在这里插入图片描述

加载 lora 权重推理

训练好了之后可以使用如下方式加载lora权重进行推理:

from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

mode_path = '/root/autodl-tmp/glm-4-9b-chat/ZhipuAI/glm-4-9b-chat'
lora_path = './GLM4_lora'

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(mode_path, trust_remote_code=True)

# 加载模型
model = AutoModelForCausalLM.from_pretrained(mode_path, device_map="auto",torch_dtype=torch.bfloat16, trust_remote_code=True).eval()

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path)

prompt = "你是谁?"
inputs = tokenizer.apply_chat_template([{"role": "user", "content": "假设你是皇帝身边的女人--甄嬛。"},{"role": "user", "content": prompt}],
                                       add_generation_prompt=True,                                       
                                       tokenize=True,                                       
                                       return_tensors="pt",                                       
                                       return_dict=True                                       
                                       ).to('cuda')


gen_kwargs = {"max_length": 2500, "do_sample": True, "top_k": 1}
with torch.no_grad():
    outputs = model.generate(**inputs, **gen_kwargs)    
    outputs = outputs[:, inputs['input_ids'].shape[1]:]    
    print(tokenizer.decode(outputs[0], skip_special_tokens=True))

完整脚本参考:
https://github.com/datawhalechina/self-llm/blob/master/GLM-4/05-GLM-4-9B-chat%20Lora%20%E5%BE%AE%E8%B0%83.ipynb
img

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

超详细的glm-4微调过程和代码之最强落地经验总结 智谱AI的GLM-4系列模型是2024年推出的新一代大型语言模型,具有显著的性能提升,接近GPT-4的水平。 GLM-4模型具备多项先进特性,包括强大的多模态处理能力和支持更长上下文输入的能力。 微调技术对于GLM-4模型尤为重要,因为它允许模型在保留广泛知识和语言理解能力的同时,学习特定场景或行业的专业语言习惯、术语和要求。 GLM-4模型提供了多种微调方法,包括LoRA、sift等轻量级微调技术,这些技术可以在不显著增加模型参数量的前提下,有效地调整模型权重以适应下游任务。 阅读详情

相关推荐

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs

这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner)

DataLearnerAI 8571

【机器学习】GLM4-9B-Chat大模型/GLM-4V-9B多模态大模型概述、原理及推理实战

本文首先对GLM4-9B的模型特点及原理进行介绍,接着分别对GLM4-9B-Chat语言大模型和GLM-4V-9B多模态大模型进行代码实践。排了很多坑,推荐阅读和收藏。

人工智能领域博客 1万+

【GLM-4微调实战】GLM-4-9B-Chat模型之Lora微调实战

在人工智能的广阔天地里,深度学习模型的微调技术扮演着至关重要的角色。它使我们能够根据特定任务的需求,对预训练模型进行精细调整,从而获得更优的性能表现。本文将深入探讨如何针对GLM-4-9B-Chat模型实施Lora微调,期待在特定领域中实现更高的准确度和效率。

寻道AI,探索AI无限可能! 5355

智谱AI GLM4开源!快速上手体验

GLM-4-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源版本。在语义、数学、推理、代码和知识等多方面的数据集测评中,GLM-4-9B 及其人类偏好对齐的版本 GLM-4-9B-Chat 均表现出较高的性能。GLM-4-9B 模型具备了更强大的推理性能、更长的上下文处理能力、多语言、多模态和 All Tools 等突出能力。

IT大头的博客 4359

弹簧管压力表设计报告

精密机械课程设计 弹簧管压力表设计报告 2020年5月1日 目 录 第一章 设计任务概述... 3 1.1 课程设计目的... 3 1.2 设计任务... 3 1.3 技术指标... 3 第二章 压力表概述... 4 2.1 机械式压力表的组成部分... 4 2.2 工作原理... 4 第三章 压力表设计... 5 3.1 弹簧管参数设计... 5 3.2 曲柄滑块机构设计... ...

weixin_42163746的博客 6452

RocketMQ5.3.0-control-多 Master 多 Salve-异步复制-集群搭建

RocketMQ5.3.0-control-多 Master 多 Salve-异步复制-集群搭建(详细文档)

m0_52369979的博客 731

[大模型]GLM4-9B-chat Lora 微调

LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。task_type:模型类型:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。rlora的秩,具体可以看Lora原理lora_alphaLora alaph,具体作用参见Lora原理Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是, 在这个LoraConfig中缩放就是 4 倍。

FL1623863129的博客 4439

电商产品组合策略:引流品与利润品的实战方法论

在电商运营中,产品组合策略是提升流量转化与利润增长的核心技术。其基本原理是通过数据化选品构建产品矩阵,利用引流品吸引用户流量,再通过利润品实现商业变现。这种策略不仅能优化广告投放的ROAS(广告投入产出比),还能显著提升客单价。技术实现上需要结合Google Analytics等工具进行归因分析,并运用动态库存管理模型控制风险。该方案特别适用于Amazon、Shopify等电商平台,能有效解决跨境电商业内流量获取与利润创造的平衡难题。通过实战案例可见,合理的产品组合可使客单价提升30-50%,是电商运营必备

weixin_42522009的博客 350

用GLM4-9B-Chat和LoRA微调,我让大模型学会了从新闻里精准“抓取”人名地名

本文详细介绍了如何利用GLM4-9B-Chat大模型和LoRA微调技术,构建高精度的新闻实体提取工具。通过命名实体识别(NER)技术,模型能够从新闻文本中准确抓取人名、地名、机构名等关键信息,显著提升信息提取效率。文章还提供了硬件配置、数据准备、微调步骤及业务系统集成方案,帮助开发者快速实现应用落地。

weixin_29183637的博客 415

计算机视觉-深度学习图像检测方法梳理

计算机视觉-深度学习图像检测方法梳理 由于之后要转方向啦,趁这段时间整理手中硕士研究方向的一些阅读笔记,这是一篇关于计算机视觉的基础知识梳理 先搞清一些小知识点 首先我们要弄清楚图像分类、目标定位、语义分割、实例分割的区别 a. 图像分类 :给定一张输入图像,图像分类任务旨在判断该图像所属类别; b. 目标定位 :在图像分类的基础上,我们还想知道图像中的目标具体在图像的什么位置,通常是以包围盒的(bounding box)形式; c. 语义分割 :语义分割是目标检测更进阶的任务,目标检测只需要框出每个目

qq_41662991的博客 9953

c转c++——蓝桥杯

在这里,`int &i` 表示 `i` 是一个整型的引用变量,而不是一个拷贝,这意味着在循环中对 `i` 的修改会影响到数组 `arr` 中对应位置的值。arr则是需要遍历的数组。一、为啥要转C++:之前只学过C语言,然后为了蓝桥杯苦哈哈敲了C好久,偶然听了别人的意见去看了一下C++后发现简直太香了——C++不像C要把底层逻辑自己敲出来,而是可以直接调用STL函数库(比如排序,C语言可能要敲个几十行代码C++直接用调用sort函数就可以了),而且C++完全兼容C语言,里面的语法全部可以用C替换。

smwymzqbyl的博客 2045

Python 医疗领域大模型微调,LLMs在医疗领域的lora微调,医疗领域问答大模型微调训练,大模型在医疗领域的SFT,基于glm-4-9b-chat在医疗领域的指令微调(一)

Python 医疗领域大模型微调,LLMs在医疗领域的lora微调,医疗领域问答大模型微调训练,大模型在医疗领域的SFT,基于glm-4-9b-chat在医疗领域的指令微调

L_goodboy的博客 635

如何免费快速的部署一个自用免VIP的自动追剧工具!NAS新玩法!豆瓣与迅雷结合,轻松实现自动下载电影自动追剧功能(支持Windows,群晖nas,飞牛nas,软路由,服务器等Docker快速部署)

追剧党狂喜!豆瓣追剧神器,自动添加云盘,自动下载,微信通知,一键搞定!

XiaoqiangClub的博客 4582

Python 医疗领域大模型微调,LLMs在医疗领域的lora微调,医疗领域问答大模型微调训练,大模型在医疗领域的SFT,基于glm-4-9b-chat在医疗领域的指令微调(二)

Python 医疗领域大模型微调,LLMs在医疗领域的lora微调,医疗领域问答大模型微调训练,大模型在医疗领域的SFT,基于glm-4-9b-chat在医疗领域的指令微调

L_goodboy的博客 332

示波器核心参数选型指南:带宽、采样率与嵌入式调试实战

示波器是电子工程师进行信号观测与故障诊断的基础仪器,其性能由带宽、采样率、通道数、存储深度、触发系统和探头特性共同决定。带宽定义高频响应边界,需遵循5倍法则以保障数字信号上升沿测量精度;采样率则依据奈奎斯特定理并结合工程冗余(通常≥2.5×带宽)实现可靠时域重建。二者协同影响信号完整性评估能力,尤其在UART、I²C、SPI等嵌入式总线调试中至关重要。高存储深度支持长时捕获与毛刺定位,智能触发与硬件协议解码进一步将波形分析升维至语义级。本文围绕真实嵌入式场景,解析参数间的耦合关系与典型误用陷阱。

weixin_42588877的博客 91

18、改进的LSTM用于污染物浓度预测

本文探讨了改进的长短期记忆网络(MLSTM)在空气污染预测中的应用,重点分析了其对印度泰米尔纳德邦五个城市(金奈、塞勒姆、哥印拜陀、马杜赖和图蒂科林)的PM2.5、PM10、SO2和NO2四种污染物浓度的预测效果。通过与传统LSTM模型的对比实验,结果显示MLSTM在预测准确性和执行效率方面均优于LSTM。研究结果表明,MLSTM在空气质量预测领域具有较高的应用潜力,可为环境保护和空气质量管理提供有力支持。

j0k1l2m3n的博客 175

GLM-4-9B-Chat-1M开源大模型部署:vLLM支持LoRA微调的完整环境配置

本文介绍了如何在星图GPU平台上一键自动化部署【vllm】glm-4-9b-chat-1m镜像,快速搭建支持1M上下文长度的大语言模型服务。该镜像可高效处理长文本对话任务,适用于智能客服、多轮问答等场景,结合vLLM推理引擎显著提升生成效率与响应速度。

weixin_28913879的博客 354

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

【收藏】零基础玩转LLama-Factory:从入门到LoRA模型微调实战指南

本文详细介绍了LLama-Factory开源框架的使用方法,以增强GLM-4-9B-Chat模型的脑筋急转弯能力为例,演示了LoRA模型的微调过程。内容涵盖环境准备、模型选择、数据集准备、训练参数设置、训练执行、效果测试及模型导出等全流程。该框架提供预制组件和模板,支持多种语言模型和训练方法,让用户无需从零开始即可训练自己的语言模型,特别适合小白和程序员快速入门大模型微调。

嘴巴吃糖了 1110

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

使用LLaMA-Factory快速训练自己的专用大模型,大模型入门到精通,收藏这篇就足够了!

LLama-Factory 还支持多种框架和数据集,这意味着你可以根据项目需求灵活选择,把精力集中在真正重要的事情上——创造价值。

DEVELOPERAA的博客 547

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

讲一下GLM-4-9B-chat的显存占用计算

模型权重(量化决定)运行临时开销表格数值是最小配置的实测值,权重做了模型优化,叠加极小动态显存默认20GB是正常对话配置,权重无优化+全量动态显存。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 306

GLM-4-9B-Chat-1M定制化:训练LoRA适配特定领域任务

本文介绍了如何在星图GPU平台上自动化部署🤖 GLM-4-9B-Chat-1M - 本地百万长文本大模型镜像,并训练LoRA适配器以定制化模型。通过该平台,用户可低成本、高效率地微调模型,使其在特定领域(如法律、金融文档分析)中具备专家级的长文本理解和生成能力,从而满足专业场景的精准需求。

weixin_42613017的博客 339

AI大模型应用实战:使用LLaMA-Factory快速训练自己的专用大模型

本文聊聊 LLama-Factory,它是一个开源框架,这里头可以找到一系列预制的组件和模板,让你不用从零开始,就能训练出自己的语言模型(微调)。不管是聊天机器人,还是文章生成器,甚至是问答系统,都能搞定。而且,LLama-Factory 还支持多种框架和数据集,这意味着你可以根据项目需求灵活选择,把精力集中在真正重要的事情上——创造价值。使用LLama-Factory,常见的就是训练LoRA模型,增强模型在某方面的生成能力。本教程将以增强 GLM-4-9B-Chat 模型的脑筋急转弯能力为例,演示LoRA

python12222_的博客 1323

使用LLaMA-Factory快速训练自己的专用大模型

本文聊聊 LLama-Factory,它是一个开源框架,这里头可以找到一系列预制的组件和模板,让你不用从零开始,就能训练出自己的语言模型(微调)。不管是聊天机器人,还是文章生成器,甚至是问答系统,都能搞定。而且,LLama-Factory 还支持多种框架和数据集,这意味着你可以根据项目需求灵活选择,把精力集中在真正重要的事情上——创造价值。使用LLama-Factory,常见的就是训练LoRA模型,增强模型在某方面的生成能力。

python12345678_的博客 2086

用GLM4-9B-Chat微调做个中文实体识别小助手:从数据集处理到LoRA实战避坑

本文详细介绍了如何基于GLM4-9B-Chat大模型进行LoRA微调,打造一个高效的中文实体识别(NER)助手。从数据集处理、模型微调策略到产品化部署,提供了完整的实战指南,特别针对中文场景下的特殊挑战如实体边界模糊和领域适应问题,给出了优化方案和避坑建议。

weixin_26821003的博客 314
上一篇: 几种Word Embedding技术详解
下一篇: 斯坦福大学人工智能图书馆收藏的这本大模型黑书到底有何魔力?
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值