大模型编码提效笑靥如花,刨根问底有几朵?

第8.1节 满足构网要求的功率器件与散热设计 摘要: 构网型变流器的功率器件选型与散热设计面临严苛要求,需综合考虑过载能力、暂态应力与可靠性。IGBT模块选型需重点评估电压/电流等级、损耗特性及结温波动,而SiC MOSFET虽具有高频低损耗优势,但面临栅极可靠性等挑战。散热设计需采用液冷等先进技术控制结温波动,并通过电热应力仿真和寿命预测实现可靠性优化。系统化选型流程需结合规范要求、工况谱分析和实测验证,为构网型变流器提供坚实的物理基础。 阅读详情
大模型兴起以来,风起云涌,卖卡的、卖数据的、卖模型的、卖应用的、卖知识变现的。。。各种推手暗流涌动,轮流登场,特别是在软件开发领域,更是风起云涌,甚至有人提出大模型替代程序员的说法,那可是把焦虑感贩卖得满满的,恨不得把韭菜连根一把割光。
尽管割韭菜的刀法各不相同,但是万变不离其宗,任何新技术、新方法、新平台本质看从内往外分都会分为:功能核、边界、广告三部分。

大模型编程也不例外,从目前各家实践来说,大模型在编码提效上确实有效,但是广告成分也挺高。

既然是提效,一定要目标牵引。

在目标设定上,大家谈的最多是第一性原理,目标能不能量化?目标跟业界对标怎么样?目标所处的位置具体在哪?目标可以分解成哪些部分?目标每一部分是怎么来的?

下面我们从上述维度看看大模型软件开发提效的目标和度量手段到底有多少。

首先我们先统一语言:

1、编码提效率=大模型编码节省时长/总编码时长

2、代码采纳率=git提交代码中大模型生成的代码/git提交代码\*100%

_通过莱文斯坦相似度(0.9)比较获取该数据。_

3、通用知识折算率=通用知识占比+私域知识占比\*私域知识转化率

接着,我们通过采用内部5个项目一个季度的穿刺数据来分析,其中采样数据满足:

1、项目要求百人以上

2、能够端到端交付

3、包含c/c++、java、python、go、scala、js/ts等主流编程语言

4、穿刺代码和模块通过业务剥离的方式,传递给大模型处理的仅包含通用知识。

编码提效率和代码采纳率:

chatGPT3.5

代码采纳率

大模型编码提效率(节省开发时间占比)

项目1

64%

42%

项目2

67%

35%

项目3

41%

23%

项目4

34%

46%

平均

51.50%

36.50%

从数据看,通用知识的代码采纳率可以达到51.5%,同百度2023年6月份的采纳率数据对比看:
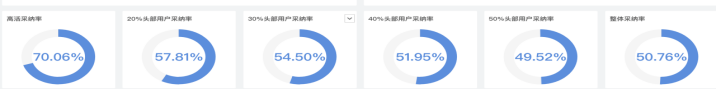
我们的数据跟百度数据基本接近,相对靠谱。  

通用知识折算率

还有一个问题,我们实际真正大规模使用大模型编程时,需要生成的代码课时需要同时包含通用知识和私域知识,这将对采纳率和节省时间这两个数据造成一定的折扣,下面我们就分析这通用知识在真正系统中的占比:
项目模块大模型类型私域代码占比私域知识代码转化率
项目1模块1chatGPT3.550%30%
项目2模块2chatGPT3.530%20%
项目3模块3chatGPT3.530%30%
项目4模块4chatGPT3.530%30%
项目5模块5chatGPT3.520%30%
项目6模块6chatGPT3.510%10%
项目7模块7chatGPT410%10%
这块数据不好统计,我们针对主要项目的核心模块进行了分析和统计,可以看出私域知识最高占比50%,也就是说通用知识占比不低于50%。  

又可以看出私域代码转化率最高30%,我们按30%进行估算,根据通用知识折算率=通用知识占比+私域知识占比\*私域知识转化率=50%+50%\*30%=65%。  

模型折算率

还需要解决一个问题,我们穿刺时使用的chatgpt3.5,开发人员大规模使用时是自研的编码大模型,chatgpt3.5取得的效果能否在自研大模型上获得对应呢? 

23年12月chatGPT3.5 (135b)humaneval@1评分65%,当前内部大模型 (70b)humaneval@1评分75%,考虑内部大模型语义理解力不如chatGPT3.5,但是编程能力略升,加上内部大模型增量预训练全部的私域代码和文档,加上我们实际评测(私域代码评测集通过率35%,大于chatGPT的20%),在内部编码能力这个单点上,基本可以认为内部大模型和chatGPT相当,即模型折算率=1。

开发工时占比

另外,软件编码在整个软件研发工作量占比是多少呢?

从若干项目实际研发数据(细节不便展示)统计分析,编码阶段占比30.77%,考虑到开发阶段还有其他一些工作,比如详设、验收测试、集成测试、环境搭建、版本联调等,根据我们的经验,真正编码自测试大概占三分之二的时间,这里我们取编码阶段在整个项目周期的工时占比为20%。

tips:

这个值其实影响因素挺多的:  

1、是否为成熟项目?  

成熟项目代码变化较少,需求,设计和开发波及影响分析和验证工作量占比会较高。  

2、是否为大型项目  

我们都知道,软件开发本质是开发人员大规模手工协作的一种工作方式,所以项目规模越大,协同和对齐的点越多,造成集成工作量越大,从而导致编码的工作量占比降低。  

一般大型项目(纯业务代码百万行以上,框架和开源组件不计算在内)开发阶段工时占比30-40%;

小型项目一般能在50%或以上。  

3、是不是强依赖硬件或三方平台

如果强依赖硬件和三方平台,所谓强依赖是指依赖点特别多,依赖程度大。

其中,

依赖点指的是API、数据类型,还包括隐形知识等。

 依赖程度指被依赖方微变更对依赖方波及影响大。举个例子,比较桥梁某个桥墩断了,桥虽然不安全了,但还是能够勉强通行。如果一条高速路路面塌陷,交通基本就断绝了,我们可以说路面比桥墩依赖程度大。

强依赖加上没有做好很好的依赖解偶和mock框架,那反复集成的成本会高很多,也会造成编码在整个研发过程中工时占比过低。

提效延迟因子

还需要考虑一个问题,即提效延迟因子,即对全年来说,提效斜率如下分布:

1.起步阶段

一季度是方法推广、工具开发、基础设施建设、人员能力提升等。

2.加速阶段

二季度开始高速提升

3.高产阶段

三季度真正到了高产期

4.持续阶段

四季度需求和交付相对较少

简化考虑下,从全年看,头尾提效斜率较平缓,2-3季度是高产期。全年提效延迟因子简化成0.5。

相应提效指标如下:  

1、开发阶段提效率=编码提效率*通用知识折算率*模型折算率*延迟因子=36.5%*65%*100%*50%=11%左右,挑战15%。

2、全年开发人员提效率=开发工时占比*开发阶段提效=2.2%*11%=2.2%左右,挑战5%。

3、新增代码累计采纳率=穿刺代码采纳率*通用知识折算率*延迟因子=51.5%*65%*50%=16.5%,这是对应2.2%的采纳率,要达到整体提效5%,采纳率挑战33%(这个指标一定不能用来考核,否则开发人员会有各种各样的优化方式,甚至超过80%都毫不费力)。

综上,大模型在软件开发提效上有效果,但是效果既不像大家想的这么小,也不像大家想得这么大。我们实际测算(大规模成熟嵌入式开发类型项目中)在开发阶段挑战15%,在全流程中调整5%,与之对应代码采纳率挑战33%而已。

当然,对应上万开发人员的组织来说,开发阶段提效15%,开发阶段也有1500人的对应的效果,软件开发主要成本不就是人员吗,还是挺可观的。

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

大模型在电力交易功率预测中的应用:短期,超短期,中长期的完整解决方案代码详解 本文介绍了基于大模型的电力交易功率预测系统,该系统覆盖超短期(15分钟-1小时)、短期(1-6小时)和中长期(1天-1月)三个时间尺度。文章详细阐述了数据准备与特征工程,包括多源数据集成和特征重要性分析。在模型构建方面,采用了Temporal Fusion Transformer (TFT)模型进行超短期预测,Informer模型进行短期预测,以及N-HiTS模型进行中长期预测。此外,文章还探讨了概率预测与风险分析,并介绍了模型部署与交易策略集成的实现。最后,文章总结了系统的贡献,并展望了未来发展方向,如市 阅读详情

相关推荐

Windows下Python安装geopandas全攻略:解决GDAL依赖问题的5个关键步骤

本文详细解析了在Windows系统下安装Python地理空间分析库geopandas时,如何有效解决其核心依赖GDAL的编译难题。文章提供了五个关键步骤,包括理解依赖关系、获取预编译wheel文件、顺序安装及环境验证,旨在帮助用户绕过复杂的C++编译环境,顺利完成geopandas的安装部署。

weixin_28221501的博客 285

2026主流编码大模型全景盘点:对应厂商、核心能力与开发者选型指南

2026年的编码大模型,已经从单纯的「代码补全工具」进化为「全流程工程智能体」,未来会进一步向轻量化、本地化、安全合规、自动化DevOps方向发展。闭源模型持续攻坚性能天花板,开源模型不断降低使用门槛,国产模型则依托本土化优势持续抢占市场,对于开发者而言,按需选型、结合自身工作流使用,才能最大化发挥AI编码助手的价值,真正实现高效编程。

安全渗透Hacker的博客 2672

【回归预测】GRNN广义回归神经网络-MATLAB

广义回归神经网络(GRNN)是一种基于径向基函数(RBF)的神经网络模型,主要用于非线性回归任务。与传统的回归分析方法相比,GRNN具有更强的非线性映射能力和学习速度,能够快速逼近复杂的非线性关系。输入层、模式层、求和层和输出层。输入层接收输入数据,模式层通过径向基函数将输入映射到高维空间,求和层对模式层的输出进行加权求和,最后输出层生成预测结果。GRNN的核心思想是利用高斯核函数计算输入与训练样本之间的相似度,然后根据相似度加权平均得到预测值。

2303_77200324的博客 1091

48个代码大模型汇总,涵盖原始、改进、专用、微调4大类

具有强大的表达能力和复杂性,可以处理各种自然语言任务,包括文本分类、问答、对话等。这些模型通常基于深度学习架构,如Transformer,并使用预训练目标(如语言建模)进行训练。在对大量代码数据的学习和训练过程中,代码大模型能够提升代码编写的效率和质量,辅助代码理解和决策,在代码生成、代码补全、代码解释、代码纠错以及单元测试等任务中都表现出十分出色的能力。为了帮大家深入掌握代码大模型的发展历程和挑战,我这次整理了相关的48个模型。

学姐带你玩AI的博客 5700

Windows如何使用Anaconda 3进行keras环境的配置

** Windows如何使用Anaconda 3进行keras环境的配置 搭建Keras环境* Anaconda3如何安装keras,主要包括下面三步: 1.安装mingw libpython 2.安装theano 3.安装keras 若你还没有按装anaconda,赶紧下载安装吧! 下载途径有两个 (1)Anaconda版本为Anaconda 4.4.0,对应的python版本为3.6,附上An...

Lance_liangliang的博客 1601

CentOS 7 常用命令大全

CentOS中Linux命令

m0_63075763的博客 2018

大模型辅助需求代码开发:如何提升核心编码任务生成效果

大模型在解释代码、回答代码问题、写单元测试等方面表现不错,但这些还只是辅助任务,真实项目需求开发中的设计及实现任务才是核心任务,而这方面尚未有成熟的方法和好的效果。一些 AI Developer 工具能够演示从零创建小应用的能力,但放到真实项目中几乎寸步难行。

HUANGXIN9898的博客 1313

10、现代统计方法:趋势面分析、薄板样条与广义线性模型

本文系统介绍了空间预测建模中的三种现代统计方法:趋势面分析(TSA)、薄板样条(TPS)和广义线性模型(GLM)。详细阐述了每种方法的原理、实现步骤、参数优化与预测评估,并结合R语言代码示例展示了在实际数据中的应用。文章还提供了方法对比流程图与土壤湿度预测案例,帮助读者根据数据特征选择合适模型,提升空间预测的准确性与可靠性。

play7的博客 157

研发效能中的AI度量与度量AI

思码逸从 2018 年开始,就一直专注于研发效能度量这件事。在过往的时间里,我们服务了大量客户,因此收获了最多来自客户的实践和案例。可以说,在国内这个领域中,我们算得上是标志性团队了。当然,这年头成为“标志”也不是很难,毕竟一年一年过去,好多友商都不见了 :)

simayi2018的博客 1892

pip install mysql出现error: subprocess - exited-with-error的解决方案

本文主要介绍了pip install mysql出现error: subprocess - exited-with-error的解决方案,希望能对使用mysql的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 5万+

第三篇:NVIDIA cuOpt Python API 详解:LP、QP、MILP 建模与求解,附核心术语名词解释

NVIDIA cuOpt是一款GPU加速的优化求解库,支持LP、QP、MILP和路径优化问题。本文详细介绍了其Python API使用方法,包括核心类Problem的变量定义、约束添加、目标设置和求解配置,并提供了术语解释。cuOpt通过GPU并行计算大幅提升大规模优化问题的求解效率,支持多种求解算法和参数配置,适用于需要高性能计算的优化场景。安装方式包含pip和Docker两种,验证安装后即可快速开始建模求解。

算法工程师 236

AI大模型对比

避坑指南:不要迷信参数量最大的模型(如千亿/万亿参数),在编码领域,经过高质量代码语料微调的中等参数模型(如DeepSeek-Coder, Qwen-Coder)往往比通用大模型表现更好,且速度更快、成本更低。对于写代码、Debug、重构、单元测试,2026年的趋势是“模型 + IDE插件 + Agent”的组合。2026年增长最快的国产AI IDE,深度适配中文环境,内置了字节自研模型+DeepSeek,免费且速度极快,非常适合国内开发者。如果你主要在国内开发,注重中文理解和免费/低成本:首选。

weixin_45351117的博客 647

Windows11上pip安装IsaacSim5.1.0与IsaacLab

本文详细介绍了CUDA Toolkit 12.8.0、IsaacSim和IsaacLab的安装过程。首先从NVIDIA官网下载并安装CUDA Toolkit 12.8.0,然后通过miniforge创建conda环境(env_isaacsim)安装IsaacSim相关Python包,解决了Windows长路径问题。成功运行IsaacSim后,克隆IsaacLab仓库并完成安装验证,最后通过创建空场景测试环境配置。整个安装过程包含详细的命令行操作和问题解决方法,为机器人仿真开发环境搭建提供了完整指导。

拥抱具身智能,昇腾Ascend C 378

大模型编程实测:如何hold住复杂、跨语言代码需求?

这是开发者的黄金时刻,也是全世界程序员的一次机会,大模型将技术的潜力推向了全新的高度,重新定义了开发者的角色以及数字经济的前景。而对于开发者来说,趁手的开发工具是高质高效完成开发任务的前提,从腾讯混元大模型评测能看出 AI 大模型的实力已经不容小觑,如何利用大模型加速抽象复杂、甚至跨语言的项目研发,提升研发效率,值得每位开发者重视。以腾讯混元大模型为例,我们从腾讯混元大模型的更新日志中了解到,腾讯混元团队收集了大规模的编程语料,通过不同语言、不同应用领域代码的学习,不断完善模型对编程语义的理解。

优快云资讯 514

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

大模型(5)——编码器(Encoder)、解码器(Decoder)

编码器是“理解者”,擅长从数据中提取抽象特征;解码器是“生成者”,擅长基于上下文创造新内容;两者协作可处理复杂任务(如翻译、对话),而独立设计则针对特定场景优化(如GPT纯生成、BERT纯理解)。现代大模型(如LLaMA、PaLM)常采用解码器-only架构,因其生成能力更适配通用任务,而编码器-解码器架构在需精确对齐输入输出的场景(如翻译)中仍不可替代。

jiaomongjun的博客 3507

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

智能编码在前端研发的创新应用

今天主要想分享一些关于大模型如何协助我们进行前端编码的实践。首先,让我们以一个前端开发的实例开始。通常,当需要实现一个新的前端功能时,我们会收到相关的背景和需求描述。

阿里巴巴云原生的博客 810

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型用到的位置编码汇总(面试)

大模型的外推性问题是指大模型在训练时和预测时的输入长度不一致,导致模型的泛化能力下降的问题。在目前的大模型中,一般指的是超出预训练设置的上下文长度时,依旧保持良好推理效果的能力。

刘文凯的博客 2729

AI大模型Transformer架构之编码器(Encoder)和解码器(Decoder),看到就是赚到!!

“ Transformer编码器的作用是特征提取,而解码器的作用是特征重建 ” 像很多人一样,一直在奇怪Transformer架构经过多层编码和解码之后就能处理输入数据并生成新的数据;所以,今天我们就来深入了解一下Transformer的编码器。

Gaga246的博客 1260

对话AIGCode创始人:只有从底层训模型,才能真正释放Coding生产力

对话AIGCode创始人:只有从底层训模型,才能真正释放Coding生产力 原创Founder ParkFounder Park2024年11月21日 19:22北京 Copilot 正成为 AI 代码产品的主力军。 Github Copilot、Cursor、MarsCode、通义灵码等,AI 代码生成提升了程序员的生产力,正在加速软件行业的生产效率和供给能力。 但有一家公司想更进一步,不只是 Copilot,而是 Autopilot。他们想彻底改变软件的生产模式,完全释放软件市场的供

AI生成式技术曾小健 1337

阿里云通义AI大模型编码助手:通义灵码,支持VS Code、JetBrains等主流IDE(对标github copilot)

通义灵码,是阿里云出品的一款基于通义大模型的智能编码辅助工具,提供行级/函数级实时续写、自然语言生成代码、单元测试生成、代码注释生成、代码解释、研发智能问答、异常报错排查等能力,并针对阿里云 SDK/OpenAPI 的使用场景调优,助力开发者高效、流畅的编码。兼容 Visual Studio Code (vscode)、JetBrains IDEs 等主流 IDE;

u012964600的博客 5720

大模型是基于Transformer的基础架构,那Transformer的编码和解码,不是大模型必须具备的吗?为什么说bert是用的编码器,chatgpt用的解码器?

Transformers 的基本架构包括编码器(Encoder)和解码器(Decoder),这两个组件通常在序列到序列(Seq2Seq)任务中一起使用,如机器翻译。Bert 和 GPT 不是序列到序列模型,它们在不同的任务上有着不同的使用方式,因此它们分别使用了 Transformers 架构的编码器和解码器部分。BERT 使用了 Transformer 架构中的编码器部分,但不使用解码器。总结一下,BERT 和 GPT 分别针对不同的任务和目标,采用了 Transformer 架构的编码器和解码器部分。

chunmiao3032的专栏 1414

大模型Java编码能力评估

从数据集来看,目前大模型支持更多还是函数级别。涉及不到类层面。因此,Java 语言的评估模型是不是需要优化?

wenxueliu的博客 1285

小白也能看懂 | 大模型的6个评估指标

近年来,随着深度学习技术的飞速发展,大型神经网络模型如BERT、GPT-3等已经成为自然语言处理、计算机视觉、语音识别等领域的重要工具。这些模型之所以称为"大型",是因为它们通常包含数十亿甚至数千亿的参数,比以往的模型要庞大得多。然而,模型的规模庞大并不总是意味着性能更好,因此我们需要一套有效的方法来评估这些大型神经网络的性能。本文将探讨为什么要评估大型神经网络模型,以及如何使用一系列关键指标来评估它们。在深度学习领域,大型神经网络模型已经成为各种应用的核心。

zhishi0000的博客 6153

蓝桥杯C++竞赛:如何借助AI技术提升编程效率与创造力

开发AI智能应用,就下载InsCode AI IDE,一键接入DeepSeek-R1满血版大模型! 蓝桥杯C++竞赛:如何借助AI技术提升编程效率与创造力 引言 蓝桥杯C++竞赛作为全国范围内影响力最大的程序设计比赛之一,吸引了大量高校学生参与。随着人工智能技术的飞速发展,AI工具在编程领域的应用也日益广泛。本文将探讨如何利用智能化工具和大模型API,在蓝桥杯C++竞赛中提升编程效率、激发创意,并...

MoonbeamRaven28的博客 1241

简单编码方式构建大模型知识库

知识库构建需要一个大模型这里选用ollama可以选用qwen2模型,其次我们需要知识的检索跟知识的排序,部署xinference平台。图中的流程几乎都在调用http,只是做简单的逻辑梳理就能通过编码的方式来构建了知识库,在此基础上我们可以更加深入的进行业务调整。本文只用到http相互调用来构建知识库。只需要简单的python基础。embedding就是向量,转成向量后的数据可以保存到数据库中,通过编码的方式如faiss来进行向量查询来比对最相似的,如下代码就是通过模拟一组数据然后通过向量进行查询。

u013220851的博客 2101

代码大模型与软件工程的产品标品之路 | 新程序员

【导读】随着人工智能的快速发展,代码大模型逐渐成为软件工程领域的研究热点。代码大模型利用大量数据进行训练,可以在很大程度上提高开发人员的工作效率,降低开发成本。本文作者对代码大模型在软件工程领域的应用前景进行了深入探索,并带来了落地及产品的标品化建设经验。本文出自2024 全球软件研发技术大会中的演讲,同时收录于《新程序员 008》。《新程序员 008》聚焦于大模型对软件开发的全面支撑,囊括 D...

AI科技大本营 6130
上一篇: 大模型时代还不理解自注意力?这篇文章教你从头写代码实现
下一篇: 不是哥们,真有人拿 AI 来面试啊?
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值