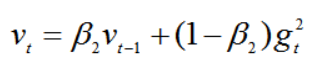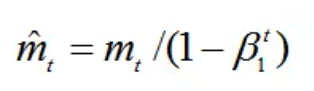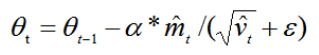大模型面经——大模型训练中出现loss突刺的原因和解决方法详解

大模型常见面试题及解答2 大模型相关术语解答,以及常见面试题与解答 阅读详情
AI摘要

本文深入探讨大模型训练中出现loss突刺的原因及其解决方法。详细分析了Adam优化器特性与梯度更新机制,解释为何大规模模型更容易遭遇loss突刺,并提供了多种应对策略。

大模型面经——大模型训练中出现loss突刺的原因和解决方法详解

本篇主要介绍大模型训练时出现loss突刺(loss spike)的原因与解决方案。

需要先说明一下,其实在参数量级较少(6B~7B)的情况下出现小的loss波动是很正常的,这里的loss spike指的是大参数量级(100B以上)的大模型在预训练过程中loss暴涨的情况。

本篇是大模型训练微调实践经验最后一篇,该系列其他文小伙伴们也可以了解一下。

下面是本文的快捷目录。

一、大模型训练突刺是什么

二、大模型训练为什么会出现loss突刺

三、大模型训练出现loss 突刺怎么解决?

一、大模型训练突刺是什么

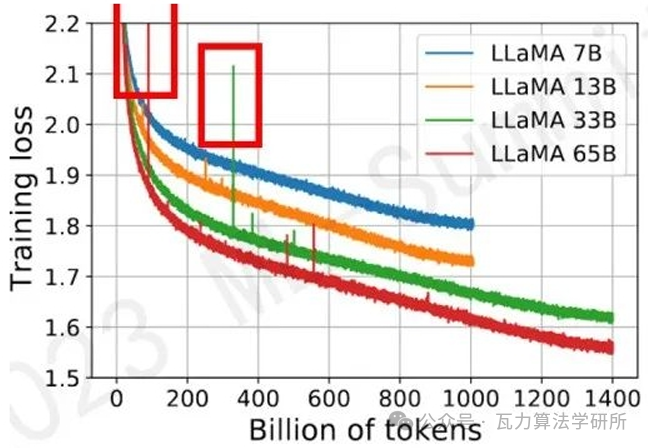
loss spike指的是大模型(100B以上)在预训练过程中出现的loss突然暴涨的情况。如下图
图片

图中训练过程中红框中突然上涨的loss尖峰就是loss突刺(loss spike);

当出现这种情况以后,模型需要很长时间才能再次回到spike之前的状态(论文中称为pre-explosion),更严重的情况就是loss 再也没办法回来了,即模型再也无法收敛。

PaLM和GLM130b之前的解决办法是找到loss spike之前最近的checkpoint,更换之后的训练样本来避免loss spike的出现。

二、大模型训练为什么会出现loss突刺

首先讲结论:

loss spike的出现与梯度更新幅度,优化器中ε 大小,batch大小这三个条件密切相关:

大模型训练中使用Adam优化器,造成梯度变化与更新参数变化不满足独立性,浅层参数长时间不更新,并且大模型训练中batch太大,后期梯度更新又趋于平稳导致的Loss spike。

下面具体来讲讲为什么。

1. Adam优化器原理

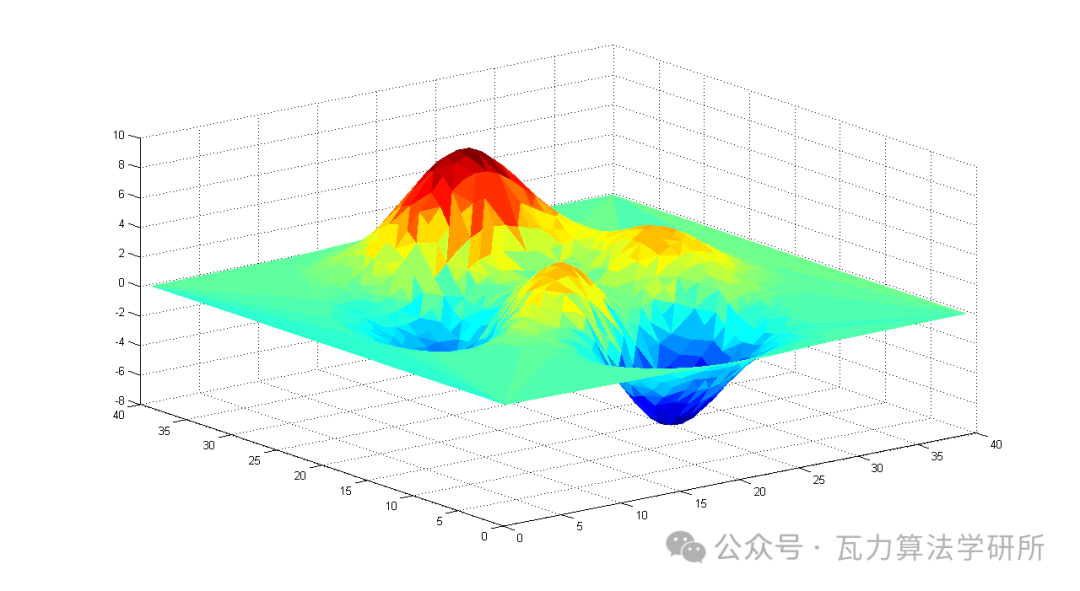
吴恩达老师说过,梯度下降(Gradient Descent)就好比一个人想从高山上奔跑到山谷最低点,用最快的方式(steepest)奔向最低的位置(minimum)。优化器就是让梯度下降走得更顺利最终达到我们期望的目的地的工具。
图片

Adam优化器,结合AdaGrad和RMSProp两种优化器的优点。

其对梯度的一阶矩估计(First Moment Estimation,即梯度的均值)和二阶矩估计(Second Moment Estimation,即梯度的未中心化的方差)进行综合考虑,计算出更新步长。

我们来具体看一下更新规则。

已知t时间步的梯度为
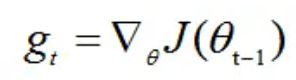
图片

  • 首先,计算梯度的指数移动平均数,m0 初始化为0。

这里类似于Momentum算法,需要综合考虑之前时间步的梯度动量。
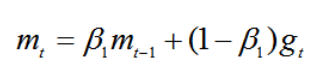
图片

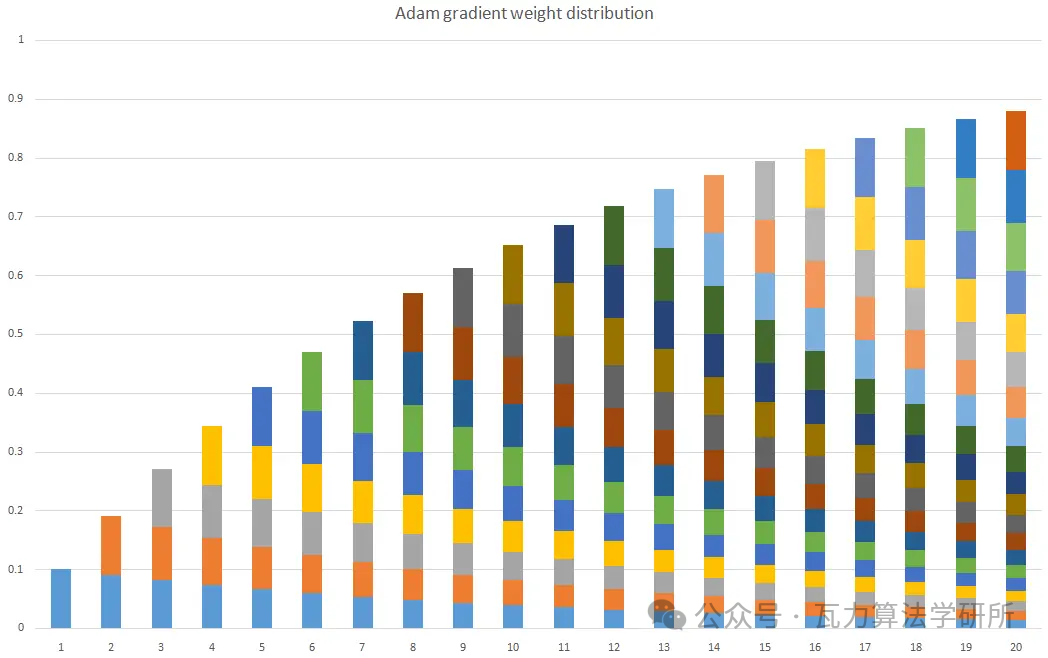
β1 系数为指数衰减率,控制权重分配(动量与当前梯度),通常取接近于1的值;默认为0.9。

下图简单展示出时间步1~20时,各个时间步的梯度随着时间的累积占比情况。
图片

  • 其次,计算梯度平方的指数移动平均数,v0初始化为0。

图片

β2 系数为指数衰减率,控制之前的梯度平方的影响情况;类似于RMSProp算法,对梯度平方进行加权均值。默认为0.999。

  • 第三,对梯度均值mt进行偏差纠正

图片

这里是由于m0初始化为0,在训练初期阶段会导致mt偏向于0;所以,此处需要对梯度均值mt进行偏差纠正,降低偏差对训练初期的影响。

  • 第四,与m0 类似,因为v0初始化为0导致训练初始阶段vt 偏向0,对其进行纠正。
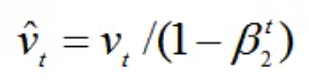
图片

  • 第五,更新参数,初始的学习率α乘以梯度均值与梯度方差的平方根之比。

图片

表达式中,默认学习率α=0.001,ε=10^-8,避免除数变为0。

由表达式可以看出,对更新的步长计算,能够从梯度均值及梯度平方两个角度进行自适应地调节,而不是直接由当前梯度决定。

2. 原因解释

可以看出来,Adam算法本质是牛顿下降法的一个迭代逼近。

图片

整个过程看上去是很优美的,但收敛过程并没有想象中顺利。

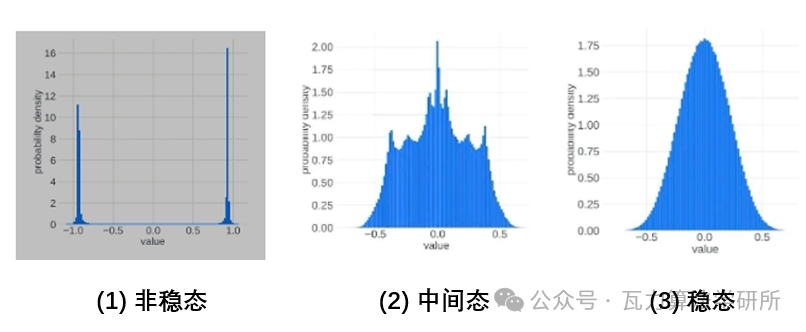
我们来预设一个理想的ut更新参数的变化趋势:

在t=1的初始状态时,u1集中在+1,-1附近;
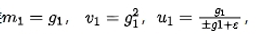
图片

训练到最后时,模型会收敛到某个最优点,此时un集中在0附近。

也就是说,更新参数变化过程可以想象成一个两端(非稳态)向中间(稳态)收拢的过程。

实际观察到的现象也是如此,见下图
图片

进入正态分布的稳态之后,理想的更新参数变化趋势应该是方差越来越小,所有更新参数逐渐向0靠近。

理论上应该是一个单向的过程,即稳定的单峰状态(unimodal)不会再次进入非稳定的双峰状态 (bimodal),但事实并非如此,更新参数会再次进入非稳定的双峰状态。

理论总结:从中心极限定理(可以结合道尔顿板实验理解)出发,随机事件的叠加进入单峰的正态分布的必要条件之一是各个随机事件事件之间应该是相互独立的,但是梯度变化以及更新参数的变化并不能特别好的满足独立性这一条件,易导致更新参数振荡,loss spike出现以及loss 不收敛。

另外loss spike也跟模型训练时浅层参数长期不更新有关,下面我们对loss spike出现前后的模型变化进行分析:

1)当前模型处在稳态(健康状态),即单峰的正态分布状态,并且梯度值 |gt|>>ε,此时loss平稳,训练过程正常;

2)模型浅层(embedding层)梯度|g|<<ε,这一般是由于训练一段时间之后,浅层的语义知识表示此时一般已经学习得较好。但此时深层网络(对应复杂任务)的梯度更新还是相对较大;

3)一段时间浅层(embedding层)梯度 |gt| << ε 之后会导致 |mt| << ε, ε。此时vt趋于0。因此导致浅层参数得不到更新(也对应于上述参数更新事件不独立的原因)

4)此时虽然浅层(embedding层)参数长时间不更新,但是深层的参数依然一直在更新。长时间这样的状态之后,batch之间的样本分布变化可能就会直接导致浅层(embedding层)再次出现较大的梯度变化,变成双峰的非稳定状态;

这里需要补充两个点:

  • 为什么小模型不会出现这种情况?

小模型函数空间小,无法捕获样本的分布变化,越大规模的模型对样本之间不同维度的特征分布变化越敏感

  • 为什么更换样本重新训练有可能会减少Loss spike的出现频率?

本质上就是选择分布变化较小的样本,减小浅层梯度变换幅度

5)这个阶段模型处于非稳态,梯度变化幅度较大,每一次的梯度变化和更新参数变化事件之间又出现了一定的独立性,因此经过一定的时间之后模型有可能再次进入稳态,loss再次回到之前的状态,也可能直接飞了再也无法收敛。

最后我们用比较简单的话总结一下,

loss spike本质原因是梯度变化以及更新参数的变化并不能特别好的满足独立性,导致随机事件的叠加难以按照理想状态进入单峰的正态分布;

表现出来就是浅层网络参数突然进入到了之前长时间不在的状态;并与模型深层参数当前的状态形成了连锁反应造成了模型进入非稳态;一般情况即使出现loss spike也会自动回复到正常状态,但也有概率可能模型直接没法收敛。

三、大模型训练出现loss 突刺怎么解决?

这里给一些参考,大家也可以再自己发挥想一想。

\1. 更换batch样本 :常规方法,但是成本比较高

\2. 减小learning rate:治标不治本,对更新参数的非稳态没有做改进

\3. 重新定义在vt=0时候的值

根据公式
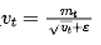
图片

可以减小ε大小,或者直接设置ε为0,

\4. 把浅层梯度直接乘一个缩放系数来减小浅层梯度更新值

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
大模型(LLMs)微调篇 大模型(LLMs)微调面涵盖了从显存需求到优化器选择等多个方面。全参数微调需16-20倍模型大小的显存。SFT后模型“变傻”因数据量少和领域知识灌注不当。指令微调数据应具代表性、适量且平衡。领域模型Continue PreTrain需高质量数据,如技术标准文档。通用能力下降可通过混合通用数据缓解。MIP(Multi-Task Instruction PreTraining)可提升预训练知识量。SFT基座模型选择取决于资源。领域评测集需选择题和开放题结合。词表扩增主要提升解码效率。训练自定义大模型分两阶段:领 阅读详情

相关推荐

MoE(Mixture of Experts)架构实战:稀疏激活大模型训练指南

尽管MoE在成本与性能平衡上取得突破,路由策略优化、训练稳定性、跨平台一致性仍是待攻克的核心难题。随着DeepSeek-V2、蚂蚁LingMoE、华为Pangu Ultra等模型的实践验证,中国团队在MoE领域已形成从框架(Megatron-Core)、算法(COMET)到硬件(昇腾)的完整技术栈。实战建议:初学者可从MiniCPM-MoE-8x2B等轻量模型入手,使用阿里开源的工具链快速启动训练,逐步掌握细粒度专家划分与动态路由调优技巧。让天下没有难训的大模型——MoE正将这一愿景变为现实。

datacanvas2426的博客 1969

大模型面经:大模型训练中出现的问题及详解

根据公式可以减小ε大小,或者直接设置ε为0。

python123456_的博客 1654

神经网络模型loss不收敛、不下降问题汇总

一、模型不收敛 主要有以下几个原因: 1.learning rate设大了会带来跑飞(loss突然一直很大)的问题 这个是新手最常见的情况——为啥网络跑着跑着看着要收敛了结果突然飞了呢?可能性最大的原因是你用了relu作为激活函数的同时使用了softmax或者带有exp的函数做分类层的loss函数。当某一次训练传到最后一层的时候,某一节点激活过度(比如100),那么exp(100)=Inf,发...

科研学习笔记! 2万+

大模型对齐中的各种loss讲解

从这篇文章开始,我会不定期分享利用 OpenRLHF 学习 RLHF 的一些心得。我平常读代码喜欢开门见山,直接去看 loss 函数是什么形式,再去理解代码的其他环节,所以就从 loss 开始分享吧。

qkh1234567的博客 2261

大语言模型与多模态大模型loss计算

如果看了我前面文章,想必你基本对整个代码有了更深认识。实际上,大多大模型都是使用huggingface搭建,而大多LORA训练也是调用PEFT库。然而,LLaVA代码却没有相关VIT模型训练内容,也没有不同组合训练。而我也是想探索单独使用vit的lora训练、单独使用llm的lora训练或全都使用会有什么效果呢?因此,本篇文章将探索LLaVA如何按需构建LORA训练,我会给出如何构建参数与修改源码,也会给出我实验结果。

weixin_38252409的博客 1847

15-loss 突刺实战手册:训练突然“起飞“,怎么定位、怎么救、怎么防

loss 突刺实战手册:训练突然"起飞",怎么定位、怎么救、怎么防

weixin_43860634的博客 16

大模型训练突刺是什么_大模型训练为什么会出现loss突刺 _大模型训练出现loss 突刺怎么解决?

根据公式可以减小ε大小,或者直接设置ε为0,\4.

2401_85375151的博客 944

LLM - Llama 3 的 Pre/Post Training 阶段 Loss 以及 logits 和 logps 概念

Llama 3 是 Meta 公司发布的开源大型语言模型,包括具有 80 亿和 700 亿参数的预训练和指令微调的语言模型,支持广泛的应用场景。在多个行业标准基准测试中展示了最先进的性能,特别是在推理、代码生成和指令遵循方面表现出色,超过了同等规模的商业模型。

AGI 2281

大模型训练loss突刺原因和解决办法

原文链接:https://zhuanlan.zhihu.com/p/675421518最近阅读了《A Theory on Adam Instability in Large-Scale Machine Learning 》这篇论文。比较全面的阐述了100B以上的大模型预训练中出现loss spike的原因(loss 突然大幅度上涨),并介绍了一些可能的解决办法。论文写的非常精彩,但整体上有点散和深...

zenRRan的博客 7341

三、大模型(LLMs)微调面

• 34 在预训练阶段,若模型训练文本时不包含标记,而在后续预测阶段却添加了标记;或者相反,训练阶段加入了。• 6 领域模型Continue PreTrain ,如何 让模型在预训练过程中就学习到更多的知识?• 25 微调大模型时,如果 batch size 设置太小 会出现什么问题?• 26 微调大模型时,如果 batch size 设置太大 会出现什么问题?• 5 领域数据训练后,通用能力往往会有所下降,如何缓解模型遗忘通用能力?• 15 想让模型学习某个领域或行业的知识,是应该预训练还是应该微调?

weixin_51988935的博客 437

阿里云大模型ACP认证模拟考试(一)

摘要:在阿里云大模型高级工程师 ACP 认证暂无真题题库的现状下,模拟题具有重要意义。其依照真实考试设计,涵盖题型、题量与分值分布,助力考生熟悉考试框架,合理分配答题时间精力,提升效率。同时,模拟题紧扣官方课程,能帮助考生精准定位知识盲点,如大模型架构原理和通义千问应用实践等重点内容,以便针对性完善知识体系。此外,通过练习模拟题,考生可掌握不同题型的解题思维与技巧,快速洞察复杂题目本质,提高答题准确率。

davidkorhenn的博客 4743

大模型训练loss突然暴涨?不要慌...

首先介绍一下什么是 loss spike: loss spike 指的是预训练过程中,尤其容易在大模型(100B 以上)预训练过程中出现的 loss 突然暴涨的情况。

Android23333的博客 2250

VMD-CNN-BiLSTM-Attention预测模型 —— 数学模型介绍&完整实例代码

想解决电力负荷预测中的非线性、非平稳难题?这篇博客介绍了一种创新混合模型,结合变分模态分解(VMD)和CNN-BiLSTM-Attention深度学习架构,实现超高精度预测! ✨ 核心亮点: ✅ VMD分解:有效分离复杂负荷信号,提取关键频率特征 ✅ 混合深度学习:CNN捕捉局部模式 + BiLSTM学习长时序依赖 + 注意力机制聚焦关键时段 ✅ 端到端优化:从数据预处理(滑动窗口、归一化)到模型训练(MSE损失+Adam优化),完整流程公开! ✅ 工业级评估:提供MSE、MAE、MAPE、R²多指标验证

qq_42924330的博客 1653

535B大模型公开训练全记录:代码、数据与Loss曲线解析

大模型预训练通常被视为黑盒,最终指标背后隐藏着数据配比、学习率调度、稳定性处理等大量工程细节。当535B参数级模型将三个月的训练全程公开,代码、数据与Loss变化实时可见,这为研究者和开发者提供了极稀缺的观察样本。从数据处理流水线到分布式训练容错,从日志监控到损失曲线分析,这些方法论均可迁移至小规模训练任务。理解Loss曲线中的尖峰与平台期,掌握数据清洗与质量过滤的优先级,部署完善的断点续训与显存监控机制——这些才是大模型训练工程落地的关键。本文以该公开项目为引,拆解从训练日志到性能优化的通用实践路径,帮助

weixin_34221276的博客 449

ubuntu打实时内核补丁教程以及安装后显卡驱动问题解决方法

在ubuntu20.04上安装成功,亲测有效 目录ubuntu打实时内核补丁教程1、下载实时内核2、解压和打补丁(patch)3、安装依赖和编译安装4、修改一些文件,便于之后切换内核5、重启电脑实时内核版本下安装nvidia显卡驱动的问题1、先切换回之前的内核(非实时)版本2、重装之前内核(非实时)版本下的显卡驱动3、切换回实时内核(按照上面的步骤)4、在实时内核下安装显卡驱动 ubuntu打实时内核补丁教程 安装目标系统:ubuntu20.04 电脑配置:i9,2080ti 1、下载实时内核 打开终端,输

weixin_39275295的博客 7996

全网最详细单细胞保姆级分析教程(一) ---pbmc

通过观察热图,可以了解不同细胞在主成分上的分布情况,以及主成分与细胞特征之间的关系。数据归一化是数据分析中的常见步骤,旨在消除数据集中不同特征之间的量纲差异,并使它们在相同的尺度上进行比较。函数会根据指定的主成分维度计算数据点之间的距离,并找到每个数据点的邻居。函数会根据数据点之间的相似性将其分组到不同的聚类中。数据缩放是数据分析中的常见步骤,旨在将数据的特征值调整到相似的范围,以避免某些特征对分析结果的过度影响。通过可视化维度载荷,可以了解哪些特征对主成分的形成起到了重要作用,以及不同特征之间的相关性。

ZxVSaccount的博客 6707

大模型面试:大模型微调面试

一般 n B的模型,最低需要 16-20 n G的显存。(cpu offload基本不开的情况下)vicuna-7B为例,官方样例配置为 4*A100 40G,测试了一下确实能占满显存。128,max length 2048)当然训练时用了FSDP、梯度累积、梯度检查点等方式降显存。SFT的重点在于激发大模型的能力,SFT的数据量一般也就是万恶之源alpaca数据集的52k量级,相比于预训练的数据还是太少了。。,即使在多语言场景下也能有不错表现。。应该;。(比如:数百个)否则可能会;万),。

EnjoyEDU的博客 1328

SIWAVE+ADS提取PCB走线寄生参数

本文将介绍一种很适合PCB走线提取寄生电感等参数的方法,即是通过SIWAVE将PCB走线的S参数提取出来,再通过ADS将S参数转换成电感、电容值。

sinat_15150363的博客 1765

【收藏必学】大模型微调技术详解:测试开发人员面试通关宝典

文章介绍大模型微调35个经典面试问题与技术解读,针对测试开发人员如何应对AI测试领域的大模型微调需求。内容包括显存计算、SFT注意事项、数据构建、领域训练和模型评测等专业知识。强调测试开发需关注模型评估、数据管理和训练监控等方向,这些已成为AI时代核心竞争力。最后推荐相关学习课程。

2401_85325726的博客 1199

VHDL六层电梯控制器及仿真

六层电梯电梯 设计要求:设计一个六层电梯控制系统要求有超载、关门中断、提前关门清除报警信电梯外人的上升请求信号,电梯外人的下降请求信号, 电梯外人上升请求信号显示电梯外人下降请求信号显示到达楼层信号 设计思路:输入有clk时钟信号(频率为2Hz) full,deng,quick,clr超载、关门中断、提前关门清除报警c_u1,c_u2,c_u3,c_u4,c_u5电梯外人的上升请求c_d2,c_d3,c_d4,c_d5,c_d6 电梯外人的下降请求 d1,d2,d3,d4,d5,d6电梯内人的...

QQ_778132974的博客 1709

R语言dplyr包recode函数、recode_factor函数数值或因子替换实战

R语言dplyr包recode函数、recode_factor函数数值或因子替换实战 目录 R语言dplyr包recode函数、recode_factor函数数值或因子替换实战 #导入dplyr包 #recode函数进行数值替换 #recode_factor函数对因子变量进行替换 #导入dplyr包 install.packages("dplyr") # Install & load dplyr library("dpl.

data+scenario+science+insight 1590

35个大模型微调面试问题详解,小白也能轻松掌握,建议收藏!

本文针对测试开发人员整理了大模型微调的35个核心面试问题,涵盖显存需求、SFT数据构建、训练方法、模型评估等关键技术。内容包含中文模型训练经验、batch size设置、优化器选择等实用技巧,强调大模型微调可拆解为监控、测试、优化等环节。文章指出,AI已渗透测试领域,测试开发人员需掌握微调机制、预训练逻辑等知识,构建质量评测集、分析训练日志等能力正成为AI时代的核心竞争力。通过系统学习大模型技术,测试人员可把握职业发展新机遇。

2401_84494441的博客 563

使用STM32实现简单的语音识别

此外,还需要将计算机的音频输出连接到外部音频放大器上,以便将测试语音播放到MAX9814麦克风模块。运行STM32代码后,系统将开始采集语音数据,并在采集完成后调用Python脚本进行MFCC特征提取。在本案例中,我们将使用STM32F4开发板、MAX9814麦克风模块和MFCC特征提取算法来实现语音识别。通过这个案例,我们可以了解到如何结合STM32开发板和Python实现语音识别,并可以根据需要进行相关扩展和优化。现在,我们可以编译和烧录STM32代码到开发板中,并准备好测试语音文件。

吃不胖. 1473

训练大模型,终于可以“既要又要还要”了

综合而言,Pangu Ultra MoE 展示了稀疏大模型在极大参数规模下实现高稳定性、高效率与高可部署性的可行路径,为 MoE 类架构在实际系统中的大规模落地提供了切实参考与经验范式。

HUANGXIN9898的博客 1130

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

上一篇: 最新综述详解ChatGPT大模型的5个高效训练方法
下一篇: Transformer 实现图像标注
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值