大模型训练loss突然暴涨?不要慌...

大模型常见面试题及解答2 大模型相关术语解答,以及常见面试题与解答 阅读详情
AI摘要

本文基于论文《A Theory on Adam Instability in Large-Scale Machine Learning》,系统分析100B级以上大模型预训练中loss spike(突刺)现象:即loss突然大幅上涨,导致收敛中断或失败。核心归因于Adam优化器在非独立梯度更新下的不稳定性,尤其在浅层参数冻结、大batch后期等场景易触发双峰振荡。文中提出从优化器调参、梯度独立性增强及checkpoint回滚等工业可行解法。

前言

最近阅读了《A Theory on Adam Instability in Large-Scale Machine Learning 》这篇论文。

比较全面的阐述了 100B 以上的大模型预训练中出现 loss spike 的原因(loss 突然大幅度上涨),并介绍了一些可能的解决办法。

论文写的非常精彩,但整体上有点散和深,我尝试着站在工业立场上把它串一下。

1、突刺是什么

首先介绍一下什么是 loss spike: loss spike 指的是预训练过程中,尤其容易在大模型(100B 以上)预训练过程中出现的 loss 突然暴涨的情况。

如图所示模型训练过程中红框中突然上涨的 loss 尖峰 loss spike 的现象会导致一系列的问题发生。
譬如模型需要很长时间才能再次回到 spike 之前的状态(论文中称为 pre-explosion),或者更严重的就是 loss 再也无法 drop back down,即模型再也无法收敛。

PaLM 和 GLM130b 之前的解决办法是找到 loss spike 之前最近的 checkpoint,更换之后的训练样本来避免 loss spike 的出现。

2、突刺成因分析

这篇论文(以下称本文)对 loss spike 的出现原因做了十分详细的分析,最后认为预训练使用的 Adam 优化器是导致这个现象出现的重要原因之一。

首先回顾一下 Adam 优化器的结构(这里介绍的是较为传统的 Adam 优化器,现在 nlp 任务更偏向于使用带有正则化项的 Adamw 变体):

本文首先对 Adam 的有效性做了论述,其本质在于证明了 Adam 优化过程是对牛顿下降法(二阶导)的一个有效逼近。

因此在收敛速度上大幅度领先传统 SGD(一阶导),证明过程不做赘述,可以参考本文和 Adam 系列相关论文。

Adam 算法是牛顿下降法的一个迭代逼近:

一切显得十分完美,但是理想很丰满,现实很骨感,收敛过程并不是一帆风顺的。

非稳态

中间态

稳态

进入正态分布的稳态之后,理想的更新参数变化趋势应该是方差越来越小,所有更新参数逐渐向 0 靠近。

这应该是一个单向的过程,即稳定的单峰状态(unimodal)不会再次进入非稳定的双峰状态(bimodal),但事实并非如此,更新参数会再次进入非稳定的双峰状态。

本文在理论层面做了研究和解释,从中心极限定理(可以结合道尔顿板实验理解)出发,认为随机事件的叠加进入单峰的正态分布的必要条件之一是各个随机事件事件之间应该是相互独立的。

但是梯度变化以及更新参数的变化并不能特别好的满足独立性这一条件,而这一点恰恰是导致更新参数振荡,loss spike 出现以及 loss 不收敛的重要原因之一。

造成梯度变化不独立的原因:

  • 浅层参数长时间不更新‍

  • batch 太大,后期梯度更新趋于平稳

上述的理论有些晦涩,本文作者可能也了解这一点,之后开始直接点题,结合实验观察抛出了重要现象和结论。

本文作者对 loss spike 出现时模型的前后变化做了仔细拆解,发现下列一系列连续现象的出现导致了 loss spike:

3、突刺解法

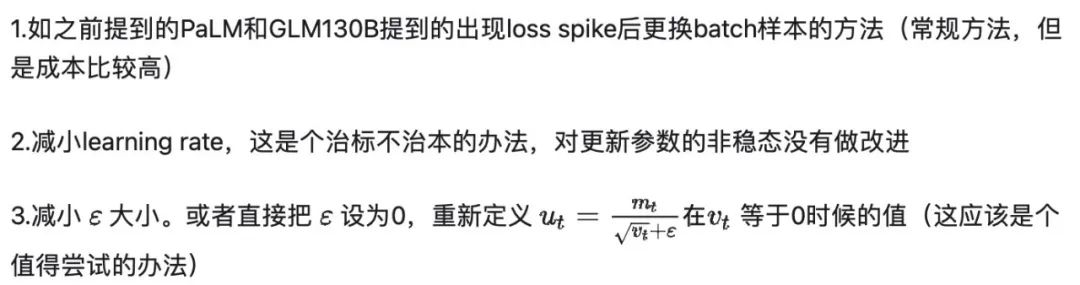
本文最后提到了防止 loss spike 出现的一些方法:
另外假设我们能一次性加载所有样本进行训练(实际上不可能做到),是否还会出现 loss spike 的现象。‍

最后的最后

感谢你们的阅读和喜欢,我收藏了很多技术干货,可以共享给喜欢我文章的朋友们,如果你肯花时间沉下心去学习,它们一定能帮到你。

因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。作为一个普通人,无法全部学完,所以我们在提升技术的时候,首先需要明确一个目标,然后制定好完整的计划,同时找到好的学习方法,这样才能更快的提升自己。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

大模型知识脑图

为了成为更好的 AI大模型 开发者,这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

经典书籍阅读

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。

在这里插入图片描述

实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

面试资料

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下

在这里插入图片描述

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

【机器学习】loss损失讨论 值需要设置成比 'Validation Error 开始上升 ’ 的值更小,1/2 处甚至更小,结果更优”,所以我仔细观察了下没有加 Flooding 模型损失值变化图,大概在 loss 为 0.75 到 1.0 左右的时候开始出现过拟合现象,因此我又分别设置了。一般来说,我们是用训练集来训练模型,但希望的是验证机的损失越小越好,而正常来说训练集的损失降到一定值后,验证集的损失就会开始上升,因此没必要把训练集的损失降低到 0。了,也就是说一开始就把梯度惩罚给加了进去,这样能提升模型的泛化性能吗? 阅读详情

相关推荐

神经网络模型loss不收敛、不下降问题汇总

一、模型不收敛 主要有以下几个原因: 1.learning rate设大了会带来跑飞(loss突然一直很大)的问题 这个是新手最常见的情况——为啥网络跑着跑着看着要收敛了结果突然飞了呢?可能性最大的原因是你用了relu作为激活函数的同时使用了softmax或者带有exp的函数做分类层的loss函数。当某一次训练传到最后一层的时候,某一节点激活过度(比如100),那么exp(100)=Inf,发...

科研学习笔记! 2万+

训练过程loss突然增大可能的原因

训练样本是否 shuffle 过,如果没shuffle 可能你之前都拟合一些近似的样本 误差很小,然后在一个 batch 中突然拟合了一个和之前差异很大的样本 如果使用了 adam,通常对这种情况会处理的好一点,adam的两个 ema参数可以调整试试,可以快进你的 迭代速度,把他们调大一些,快进的速度为 1/(1-lambda)。 使用adam 了解了数据集的迭代特性后建议切换回到 SGD,通过...

weixin_42365324的博客 3万+

STGCN+YOLOV8行为分类

使用关节点追踪网络获取关节点数据,以yolo-v8网络为例,获取2D关节点数据。此次实验采用KTH动作识别数据集,包含人步行、慢跑、跑步、拳击、挥手和拍手等动作。

SDADASDAF的博客 3892

深度学习模型训练快收敛时loss值突然暴增现象

自己深度学习模型训练快收敛时loss值突然暴增,我就记录下来了各个参数数值和梯度,并绘制了曲线图,供大家参考

周志超的博客 8923

阿里云一键登录Java后端实战:5分钟搞定号码认证服务集成(附完整代码)

本文详细介绍了如何在Java后端项目中快速集成阿里云号码认证服务(PNVS),实现高效、安全的一键登录功能。文章从核心架构、安全机制解析入手,提供了完整的Maven依赖配置、服务端环境准备、核心业务逻辑实现(包括Token验证、用户处理、异常降级)以及生产环境下的性能优化、监控与部署方案,并附有可直接使用的完整代码示例。

p1q2r的博客 845

CGNS快速入门到实战(二):VS配置调用CGNS静态链接库

CGNS快速入门到实战这一系列分成三篇文章展开叙述,具体有:(一)CGNS静态链接库编译;(二)VS配置调用CGNS静态链接库;(三)CGNS文件及案例展示。本篇文章重点讲述VS配置调用CGNS静态链接库。

ahang_99的博客 2618

大模型训练突刺是什么_大模型训练为什么会出现loss突刺 _大模型训练出现loss 突刺怎么解决?

根据公式可以减小ε大小,或者直接设置ε为0,\4.

2401_85375151的博客 944

ESP-01S使用micropython,利用Thonny烧写固件

在家舒服的太久了,想学习点新的东西,这次看上了ESP8266系列的联网设备,想自己做点小玩意出来耍耍,下面跟我一起来学习吧。本篇主要记录固件的烧写及测试。Thonny下载链接不算难,但是网上资源较少。也是提醒自己不要忘记这个步骤,记录一下,也分享给和我一样开始接触的小伙伴,加油加油,万事开头难。

weixin_43422072的博客 1693

大模型面经——大模型训练中出现loss突刺的原因和解决方法详解

根据公式可以减小ε大小,或者直接设置ε为0,\4.

python1222_的博客 3891

1 四种防反接电路——multisim仿真

摘要:防反接电路可防止电源反接损坏器件,主要有四种方案:1)二极管串联(低成本,适用小电流);2)整流桥(无极性输入,但效率低);3)保险丝+稳压管(低损耗但需更换);4)MOS管方案(大电流、高效率,主流选择)。选型需考虑电流、压降和成本,MOS管因其低导通电阻(毫欧级)成为大电流应用的首选。口诀:"小电流二极管,大电流用MOS"可快速指导设计。

XU157303764的博客 1572

Open3D 曲率下采样

曲率下采样是一种基于几何特征的点云处理技术,通过计算每个点的曲率来判断其所在位置的局部表面特征,从而进行选择性保留。曲率的计算通常基于点的法向量和其邻域点的分布。

纵马踏花向自由 841

大模型面经:大模型训练中出现的问题及详解

根据公式可以减小ε大小,或者直接设置ε为0。

python123456_的博客 1153

小梅哥Xilinx FPGA学习笔记15——基于SPI接口的ADC芯片驱动

ADC(Analog to Digital Conver),通常是指一个将转变为数字信号(二进制表示的离散信号)的转换器。先将输入模拟电压转换成时间或频率,再把中间量转换成数字量双积分型 ADC,先对输入采样电压和基准电压进行两次积分,获得与采样电压平均值成正比的时间间隔,同时用计数器对标准时钟脉冲计数。抗干扰能力强,稳定性好,但转换速度低。①并联比较型 ADC,采用各量级同时并行比较,各位输出码也是同时并行产生,转换速度快。缺点是成本高、功耗大。

m0_51430584的博客 5504

大模型训练loss突刺原因和解决办法

原文链接:https://zhuanlan.zhihu.com/p/675421518最近阅读了《A Theory on Adam Instability in Large-Scale Machine Learning 》这篇论文。比较全面的阐述了100B以上的大模型预训练中出现loss spike的原因(loss 突然大幅度上涨),并介绍了一些可能的解决办法。论文写的非常精彩,但整体上有点散和深...

zenRRan的博客 7341

2024年12月中国电子学会青少年软件编程(Python)等级考试试卷(五级)答案 + 解析

2024年12月中国电子学会青少年软件编程(Python)等级考试试卷(五级)答案 + 解析

伶俐角少儿编程 484

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

训练稳定性技巧_梯度裁剪Loss_Spike处理

大模型训练最怕“看起来跑得好好的,突然 loss 尖峰、NaN、梯度爆炸,然后几天算力白跑”。训练稳定性不是玄学调参,而是围绕学习率、梯度范数、混合精度、数据 batch、mask、checkpoint 和分布式状态建立监控与恢复机制

倔强的石头的博客 1万+

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型训练别只盯Loss:多维生命体征监控实战指南

在深度学习与大模型微调中,Loss 下降并不等于模型真实变好,它只是反映整体误差的粗粒度信号,无法揭示数据分布漂移、梯度爆炸、表征塌缩或注意力头死亡等隐患。真正可靠的训练监控应借鉴内科诊断思路,从数据侧困惑度与标签噪声、梯度范数与更新比例、表征奇异值与注意力熵、行为侧幻觉率与上下文遵循、以及部署侧缓存命中率等多个维度建立“生命体征”体系。本文以工程实践为导向,讲解各指标的计算方法、合理阈值与异常排查动作,并给出 vLLM 缓存优化、LoRA 微调踩坑实录等实操经验,帮助读者在训练全链路中及时发现隐性故障,提

weixin_29035147的博客 218

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

深度学习训练快收敛时loss突然暴增:诱因分析与排查指南

在深度学习模型训练中,损失函数的收敛过程往往并非平滑直线,而是伴随噪声波动。当模型逼近最优解时,mini-batch随机梯度下降的噪声比例相对增大,加上损失函数地形在局部最优附近趋于狭长,学习率、数据分布、优化器状态等微小扰动都可能被放大,导致训练后期loss出现异常尖峰。这种现象与过拟合引发的验证集损失上升有本质区别,需要从优化数值层面排查。常见诱因包括学习率未及时衰减、脏数据在后期主导梯度、自定义损失函数数值不稳、混合精度下FP16溢出、优化器动量惯性干扰以及数据顺序固定等。工程上可通过记录梯度范数、回

weixin_34268169的博客 366

Unsloth训练监控技巧:实时查看loss与性能指标

本文介绍了如何在星图GPU平台上自动化部署unsloth镜像,高效开展大语言模型微调训练。通过内置日志解析、GPU内存监控与自定义回调等轻量级方案,开发者可实时跟踪loss变化、显存占用及吞吐性能,典型应用于Llama系列模型的指令微调任务。

weixin_30951515的博客 323

模型训练原理(一):别急着学 Transformer:所谓“训练大模型”,其实就是把一堆数字一点点改对

本文深入浅出地阐述了大模型训练的核心机制,指出初学者常因过早关注Transformer架构而忽略更基础的训练原理。文章通过单参数模型示例,揭示了机器学习本质是参数优化过程:模型通过计算预测结果与真实值的差异(Loss),利用梯度(Gradient)确定参数调整方向,配合学习率(Learning Rate)完成参数更新(Parameter Update)。这一过程在数十亿参数的大模型中同样适用,只是通过反向传播(Backpropagation)实现误差责任的分布式分配。

w1345360200的博客 442

27届大模型面试准备(五十):大模型训练稳定性与容错工程——从 loss spike 到弹性训练

前面几十篇把模型结构、后训练(A16)、分布式训练(A17)、量化(A19)、推理优化(A25/A30)讲透了。但有一个工程现实常被论文忽略:大模型训练动辄上千卡、跑几周,过程中一定会出事——loss 突然尖刺(loss spike)、数值溢出变 NaN、某个节点掉线、数据里混了脏样本。能不能把训练"稳稳跑完",是大规模预训练岗的底线能力,比"架构多新"更被雇主看重。

thesky123456的博客 454

大语言模型训练的纯数字原理:从token到loss的量化工程

大语言模型训练本质上是受硬件物理约束与数学精度限制的量化工程,而非玄学‘炼丹’。其核心在于将注意力机制、Embedding维度、Attention矩阵规模、FFN计算量、Cross-Entropy Loss等抽象概念,全部映射为可测量、可推演、带单位的技术参数——如d_model=1024(决定显存与FLOPs)、max_position_embeddings=8192(触发O(n²)显存爆炸)、loss=2.103(对应perplexity≈8.52及token预测准确率11.7%)。这些数字直接定义算力

weixin_29053383的博客 146

显存瓶颈被打破!大模型训练的黑科技来了,带宽不再制约大模型训练

2023又到年底,回望这大模型狂飙突进的一年,从 ChatGPT 问世技惊四座到 AI Agent 火热浪潮汹涌,从 GPT-4 问鼎天下睥睨群雄到当下大模型百花齐放百家争鸣……短短一年,大模型就赋予了我们最接近未来“智能时代”的狂热想象,各种技术喷薄而出各类行业应用泉涌而下,哪怕是最近这短短一个月,我们都可以看到诸如谷歌的 Gemini,微软的Phi-2,Mistral AI的Mixtral等等模型,而这一批又一批的大模型来来去去。

夕小瑶科技说 1246

大模型训练全流程实战:从预训练到RLHF对齐的工程指南

大模型训练本质是分阶段的流水线工程,涵盖预训练、监督微调、奖励建模与强化学习对齐。预训练通过自回归语言建模让模型学习语言统计规律,SFT和RLHF则教会模型按人类期望回应。分布式训练策略如数据并行、模型并行与流水线并行解决了显存和算力瓶颈,DeepSpeed和Megatron-LM是主流框架。这些技术支撑了从基座模型到对话助手的转化,广泛应用于智能问答、内容生成和代码辅助等场景。理解GPU集群配置、数据清洗和训练监控等工程细节,是成功训练大模型的关键。

weixin_42548816的博客 255

MindSpore Transformers训练实时监控:用Callback+Matplotlib绘制loss曲线

在深度学习模型训练中,如何实时观察模型收敛状态是每个工程师都会遇到的难题。loss曲线、学习率、梯度范数等指标直接反映了训练过程的健康状况,但仅靠终端日志难以捕捉瞬时变化。通过训练回调机制,在每一步结束时采集关键指标,并借助Matplotlib动态绘制曲线,可以构建轻量级的实时可视化方案。这种方案不依赖重型工具,适合单机多卡场景,能快速定位loss震荡、学习率跳变、梯度爆炸等问题。本文从训练监控的核心指标出发,给出了一套基于MindSpore Transformers的完整实现,涵盖曲线平滑、自动告警与日志

weixin_32487557的博客 294
上一篇: 阿里内部380页《从零开始大模型开发与微调基于PyTorch与ChatGLM》学习笔记,学到就是赚到!!
下一篇: 新书分享|ChatGLM3大模型本地化部署、应用开发与微调(附PDF)
Agent学习路线
博客等级 码龄6年 1万+粉丝 1903原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值