免费时代到来!价格战带领AI大模型走出商业化困局?

【JAVA】接入讯飞星火的Spark Lite,实现AI问答 目前市面上AI产品也是数不胜数,今天我们就来接入讯飞的Spark Lite 阅读详情

电子发烧友网报道(文/梁浩斌)大模型厂商彻底疯狂!电商618大促刚刚开始,大模型厂商就开始轮番疯狂降价。每千Tokens的价格,从过去几分钱,再下降一个数量级至几厘,甚至还有直接开放大模型全面免费试用。

大模型进入免费时代

5月21日,阿里云宣布通义千问4款商业化模型和5款开源模型大降价,其中GPT-4级别的主力模型Qwen-Long价格直降97%,从此前API输入0.02元/千Tokens,降价至0.0005元/千Tokens;API输出从0.02元/千Tokens,也降了90%到0.002元/千Tokens。

图片

Token在自然语言处理中是指文本被分割成的最小单元或标记,通常1个中文词语、英文单词、数字、符号计为 1 个Token,由于不同模型采用的分词器不同,同一段文字可能分成不同数量的Tokens,比如在某个模型中,“使用者”被分为一个Tokens,但“大模型”就被分为“大”和“模型”两个Tokens。粗略估算,1Tokens可以理解为相当于1.5个中文汉字。

然而就在上午通义千问降价之后,下午百度言简意赅,在公众号上发文宣布:文心大模型两大主力模型全面免费,立即生效!

图片

这次免费的两大主力模型分别是ERNIE Speed和ERNIE Lite,上下文长度均支持8K、128K,均为轻量级大模型。其中ERNIE Speed适用于自然语言处理任务中的多种场景,如文本分类、命名实体识别、语义匹配等,在智能客服、搜索引擎、智能推荐等领域的应用表现突出,在阅读理解、close-book问答、创作与续写等复杂任务上,也能达到甚至超越千亿大模型的效果。

而ERNIE Lite则适合搭载在低算力的AI加速卡上处理推理任务,应用于检索、推荐、意图识别等高并发、低延时等场景。

在文心大模型之后,5月22日,科大讯飞也宣布旗下讯飞星火Lite API永久免费开放,此前该模型版本价格为0.018元/千Tokens。Spark Lite同样是轻量级大语言模型,支持在线联网搜索功能,适用于低算力推理与模型精调等定制化场景。

图片

除了轻量级大模型之外,在顶配的Spark 3.5 Max版本上,价格也降到0.21-0.3元/万Tokens,即0.021-0.03元/千Tokens,这个价格相比文心一言和通义千问同级别大模型也要更低。比如文心一言的ERNIE-4.0输入、输出均为0.12元/千Tokens;通义千问Qwen-Max输入0.04元/千Tokens,输出0.12元/千Tokens。

这一轮大模型降价,可以追溯到5月初。幻方量化旗下深度求索(DeepSeek)在5月6日正式开源第二代MoE模型DeepSeek-V2,而其API的定价为输入1元/百万Tokens,输出2元/百万Tokens,算下来大概是0.001-0.002元/千Tokens,价格几乎是GPT-4-Turbo的百分之一。

5月11日,智谱大模型官宣降价,其中个人版 GLM-3Turbo模型产品的API调用价格从0.005元/千Tokens,降至0.001元/千Tokens;最顶配的GLM-4和GLM-4V价格也来到0.1元/千Tokens。

字节跳动旗下的云服务平台火山引擎,在5月15日推出了豆包大模型家族,其中豆包主力模型的推理输入定价仅为0.0008元/千Tokens,当时火山引擎表示,这个价格要比行业便宜99.3%。

但大模型内卷的趋势,并不是“中国特色”,5月13日,OpenAI推出了新一代的大模型GPT-4o,除了性能上的大幅提升之外,更重磅的消息是该新模型将全部功能免费使用。

此前OpenAI仅免费开放GPT-3.5供用户使用,而GPT-4是要付费使用的。但在GPT-4o发布后,不仅性能上超越GPT-4,而且还免注册开放使用。当然,免费用户使用GPT-4o只能每三小时使用十次,超过10次将自动降级至GPT-3.5。

与此同时,商业用户方面,GPT-4o的API调用价格也相比GPT-4 Turbo全面下降50%。

所以,大模型的全面降价,甚至是免费,已经成为目前全球AI行业的趋势。

价格战是“良药”还是“双输”?

在互联网行业,疯狂烧钱的零和博弈打法已经司空见惯,从电商到外卖、再到共享单车,在行业发展初期都依靠低价打开市场规模。

零一万物创始人兼CEO李开复认为,大模型降价对整个行业来说是好消息,行业每年降低10倍推理成本是可以期待的,而且也应该是必然发生的,但同时他也表示价格战是一个“双输”的打法,大模型公司不会这样不理智。

“当其团队认定自己的技术值得的时候,就会坚持一个合适的价格,而绝不会靠贴钱、赔钱去做生意。”

AI大模型的商业化,一直以来都是行业的头号难题。首先是大模型训练成本居高不下,比如李飞飞团队分析报告显示,Google此前发布的Gemini Ultra训练成本高达近2亿美元,OpenAI 的 GPT-4训练成本也预计高达7800万美元,并且随着时间的推移,新推出的大模型训练成本还在不断提高。

而在C端应用中,用户留存和活跃度也正在面临很大挑战,即使是ChatGPT, 自从去年六月开始流量就开始出现下降,大多数用户使用ChatGPT还是基于尝鲜的性质,而无法成为一个日常应用。

根据QuestMobile的数据,AICG的运营数据活跃率均在20%以下,3日留存均在50%以下,卸载率更是在50%以上。

所以,这也反映出目前类ChatGPT的大模型应用,并不是目前大模型的最终表现形式。

而面向B端的API降价,则能够推动AI应用的开发。近一年里,大模型的技术能力提升速度极快,尤其是国内的众多玩家入局后,大模型的能力突飞猛进。

5月21日李开复公布了零一万物团队在国际测评榜单中的新成绩, Yi-Large在 LMSYS 盲测竞技场总榜排名世界第七,中国大模型中第一;其中在中文分榜中与GPT-4o并列世界第一。

他也表示在近一年时间里,中美大模型的差距从7到10年,已经缩短到6个月左右。

因此,在当前大模型技术发展迅速的时间节点,在投入大量资本去创造大模型的同时,如何让大模型商业落地是整个行业共同希望解决的难题。毕竟只有将大模型商业化变现,才能回收训练支出的高昂成本。

所以大模型降价,一定程度上能够吸引更多的企业尝试使用大模型开发AI应用,通过AI应用去创造更广泛的使用场景,以实现“AI普及”。

当然,大模型降价也不是盲目的。火山引擎在发布会上表示,其在技术上有很多优化手段可以降低大模型训练成本,而在工程上可通过分布式推理的形式提高算力利用率等。

另一方面,大模型价格战,对于背靠互联网业务的大厂来说,由于资金压力较小,在市场推广上更有优势。但对于一些大模型初创公司,市场的价格战毫无疑问是加速了优胜劣汰的节奏。

小结

对于当前商业模式还未走通的大模型行业来说,尝试总是好事。但重走互联网时代的“零和博弈”路线,到底能否复现过去的成功,还要看后续的发展。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

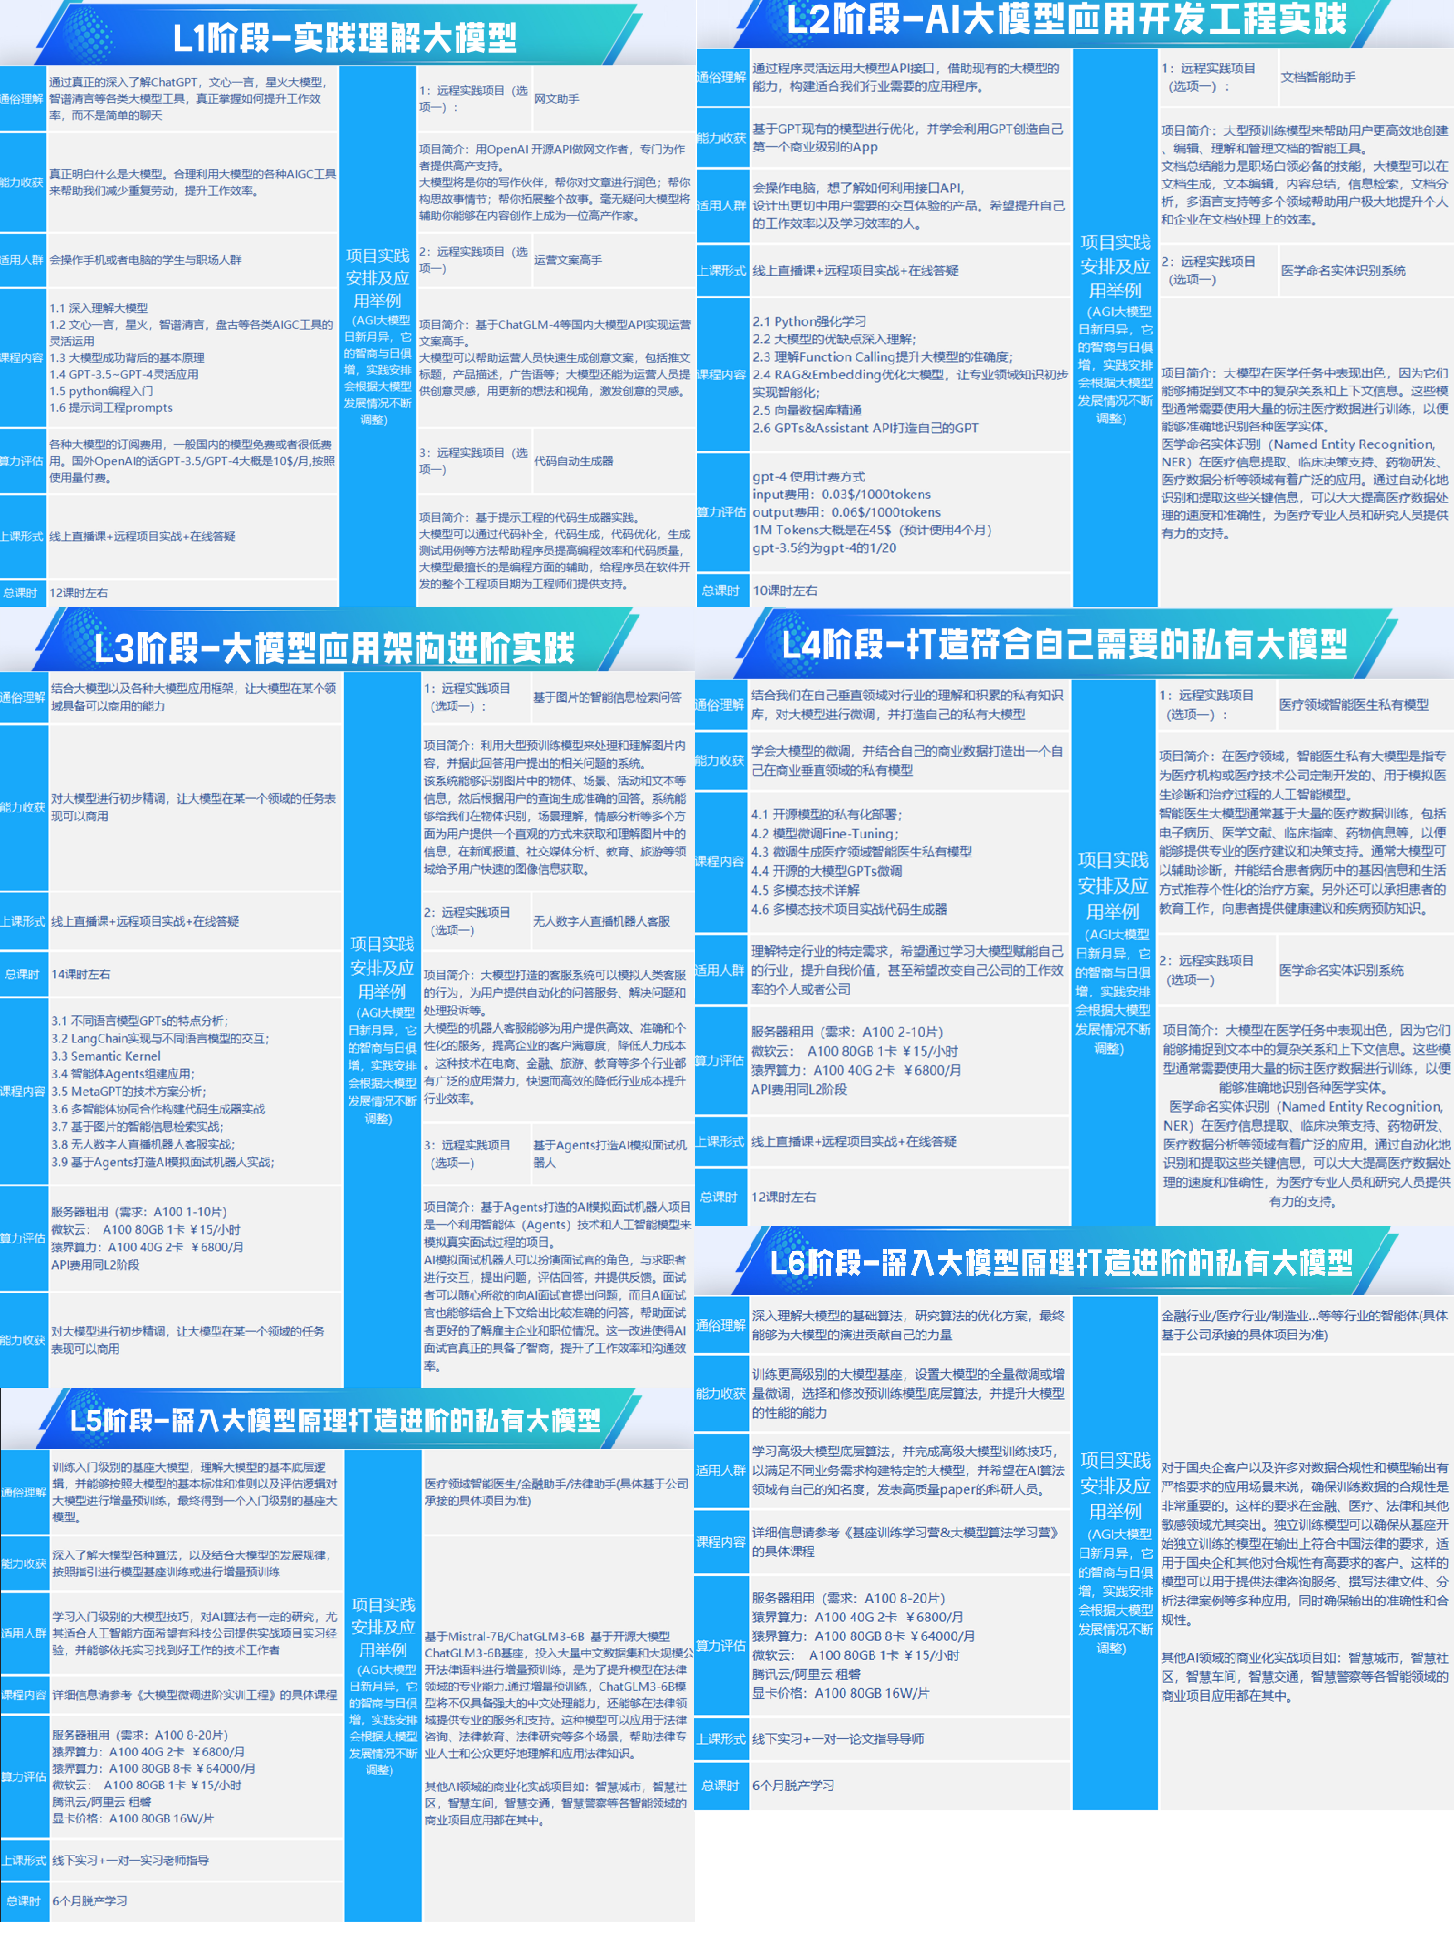
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

Kimi大模型IPO背后的AGI商业化逻辑与技术卡位战 大语言模型(LLM)正从通用能力竞争迈向AGI级商业落地阶段,其核心价值不再仅取决于参数规模或基准分数,而在于多模态理解、Agent工作流闭环与真实场景的转化效率。Kimi K2.5通过原生多模态架构、动态稀疏激活机制和深度研究Agent调度器,构建了区别于传统双塔模型的技术代差;其IPO选择并非财务驱动,而是卡位监管窗口、资本周期与技术代际更迭的三重临界点。在港股上市路径下,Kimi以离岸人民币结算、复用已验证合规框架、绑定中东与亚太开发者生态,实现地缘适配性突围。这一案例为AI创业者、投资人与工程师提供 阅读详情

相关推荐

第八章 MobileNetv3网络详解

本文介绍了基于互补的搜索技术和新颖的架构设计的MobileNets的下一代。MobileNetV3通过硬件感知网络架构搜索(NAS)和NetAdapt算法相结合,针对移动电话CPU进行优化,随后通过新颖的架构改进技术进行了进一步提高。本文开始探索自动化搜索算法和网络设计如何相互协作,以利用互补的方法改进整体技术水平。通过此过程,我们创建了两个新的MobileNet模型:MobileNetV3-Large和MobileNetV3-Small,分别针对高资源和低资源使用情况。

ADICDFHL的博客 1万+

大模型应用中一个 Token 占多少汉字?答案超乎想象!

原创 Soyoger AI技术研习社 2024年07月14日 09:00 美国先说答案:不同模型可能采用各自的切分方法,因此,一个 Token 所对应的汉字数量也会有所不同。如腾讯1token≈1.8个汉字,通义千问、千帆大模型等1token=1个汉字,对于英文文本来说,1个token通常对应3至4个字母, 不同的模型对相同的输入分词, 分词结果是不一样的。同样可以说,一个汉字占约0.5个Token。‌Token 是大模型中最基础、最常见的概念,它既可以是一个完整的单词,也可以是一个单词的一部分,甚至是标点

具身机器人和通用AI 9539

MATLAB PDE工具箱电磁场仿真平行电容板及电偶极子详解

首先打开matlab,在命令行输入pdetool打开PDE工具箱 工具箱的功能我就不赘述了,大概就是以有限元的数值计算方法,计算二阶偏微分方程,因此可以解决电磁场、热力学等问题。 首先点击左上角按钮,画三个矩形 画完一个后可以双击矩形编辑,参数如下: 其中R1表示上极板,R2表示下极板,R3表示整个空间区域。 在上方Set formula为R3-R2-R1,表示求解区域是整个空间区域减去两个极板。下拉框选择Electrostatics表示求解的是静电场问题。 接下来点击上方菜单栏中的这个按钮,表

weixin_42845306的博客 1万+

如何计算 ChatGPT 的 Tokens 数量?

本文主要介绍了 GPT 如何计算 Tokens 的方法,官方提供了两种方式:网页计算和接口计算。 网页计算不需要技术,只需要魔法即可体验,而接口计算,事实上接口计算包含了两种方法,一种使用tiktoken,则需要点 Python 基础,而openai还需要点网络基础和货币基础,需要代理和 plus 账号(20刀/月)等。

明而决之 1万+

NVIDIA DGX Spark 开发环境深度配置与优化指南

定期系统维护每月执行一次完整的系统更新监控存储空间使用情况,及时清理临时文件定期检查硬件健康状况开发习惯优化使用tmux或screen管理长时间运行的任务配置自动化测试和代码质量检查建立完善的项目文档体系性能调优周期每月重新评估和调整系统参数根据工作负载特点优化容器配置持续监控和记录性能指标DGX Spark作为一个强大的AI开发平台,其真正的价值需要通过精细的环境配置和优化才能充分发挥。本文提供的配置方案和建议均基于实际生产环境经验,旨在帮助开发者构建稳定、高效、可维护的开发环境。

time_days的博客 3683

ARM Cortex平台NEON指令集优化实战指南

本文为ARM Cortex平台开发者提供了一份全面的NEON指令集优化实战指南。文章从NEON的SIMD架构原理讲起,详细介绍了开发环境搭建、NEON内联函数与自动向量化两种核心编程方法、关键数据类型与指令,并通过图像饱和运算、矩阵乘法等实战案例,深入解析了性能调优技巧与常见避坑指南,旨在帮助开发者充分释放ARM处理器的并行计算潜力。

weixin_29162439的博客 259

Cursor使用及接入教程(非常详细),零基础入门到精通,看这一篇就够了

Cursor使用及接入教程(非常详细),零基础入门到精通,看这一篇就够了

Python单行客的博客 1万+

FOC无刷电机磁编码器机械角度与电角度自动对齐校准及电机极对数自动获取的方法

本文提出磁编码器机械角度与电角度自动对齐校准方法及电机极对数自动获取方案。通过通直流电流使转子定向,读取机械角度并计算电角度偏移量,实现精确对齐;同时利用低速旋转时检测反电动势过零点次数,结合机械角度变化量自动计算极对数。核心算法包括转子定向、偏移量计算、极对数推导等步骤,并提供了基于STM32的C语言实现代码。该方法适用于工业伺服、机器人等高精度控制场景,需注意负载安全、参数调整和误差处理。两种自动化流程可有效解决电机安装调试中的角度对齐和参数识别问题。

qq_29653575的博客 2475

大语言模型免费API获取教程1:讯飞星火(科大讯飞)、文心一言(百度)

简单介绍2个能够免费调用API的LLM

Ben__Ho的博客 5815

Android 10 根文件系统和编译系统(十):Android.mk编译动态库

配套系列教学视频链接: Android 10.0 AOSP源码编译: 2-AOSP源码开发环境搭建 Android 10.0 根文件系统和编译系统: 3-Android根文件系统和编译系统 说明 系统:AOSP Android10.0 设备:Android模拟器 前言 本文章重点讲解Android.mk如何控制编译源码编译成动态库 ...

ldswfun的专栏 932

ArcGIS供地图斑图形及属性入库操作(附练习数据)

已知数据: 供地图斑位置图。 供地图斑表格 成果要求:将供地图斑导入mdb数据库并将供地图斑表格的属性进行挂接。 接下来我们开始操作: 1、 打开arcmap,在目录内连接的文件夹内找到供地图斑位置图。图片 2、 将annotation和polygon添加到arcmap图片 3、 右击文件所在文件夹新建mdb数据库图片 4、 右击数据库新建要素数据集。(要素数据集非常重要,稍后所有操作都在数据集内进行)选择图斑投影方式及代号。图片 5、 右击要素数据集—导入(将图层内的数据导入数据库)图片 6、 数据导入.

qq_43173805的博客 8129

AI大模型时代:从DeepSeek的荣耀到创业公司的困局与破局

大语言模型作为人工智能领域的核心技术,通过海量数据训练和Transformer架构实现对人类语言的深度理解与生成。其原理在于通过自注意力机制捕捉文本中的长距离依赖关系,从而在对话、创作、推理等任务上展现出接近人类的表现。这一技术的核心价值在于大幅降低了信息处理与内容创作的门槛,为各行各业带来了效率革命。在实际应用场景中,大模型不仅支撑着智能客服、代码生成、文档处理等通用服务,更通过微调技术深入法律、医疗、工业等垂直领域,解决特定场景下的复杂问题。开源生态的繁荣进一步加速了技术创新,开发者可以基于公开模型进行

weixin_34121304的博客 1587

UG\NX二次开发 使用UF_CURVE_create_ocf_feature函数创建“在面上偏置”特征

使用UF_CURVE_create_ocf_feature函数创建“在面上偏置”特征。

王牌飞行员_里海的博客 848

AI免费时代将终结,行业效率优先能否实现技术平权?

因为微信月活14亿,若 "小微" 全量开放,推理量巨大,模型性价比不高,光电费就会吞噬利润,所以小微多数日常请求交给WeLM,遇难题有合作模型兜底。此外,DeepSeek用价格杠杆优化算力调度,平峰时段价格不变,缓存命中接近免费,引导部分负载从白天到夜间低谷期,提高GPU整体利用率,降低单位成本。另一方面,算力供给是稀缺资源,价格居高不下,总成本难以降低。然而,AI产品更接近制造业逻辑,用户规模增加,算力成本也随之上升,因为AI成本具有刚性,多一个用户提问,模型就要进行一次推理,消耗一次算力。

IT界那些事儿 31

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

AI产品经理商业化变现破局:2025年新纪元与实战指南

本文系统解析AI产品经理在2025年的商业化变现路径,覆盖订阅制、API付费、广告驱动、按结果付费、硬件整合等主流模式,对比B端与C端市场的差异化策略,结合制造业、金融、医疗、教育等垂直领域成功案例,提炼产品经理必备的三大核心能力,并揭示技术脱节、付费意愿低估等常见陷阱的应对策略。通过深度剖析行业趋势与专家观点,为AI产品商业化提供全景式实战框架。

打造全国最全的AI Agent开发知识领域的博客 2406

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Token 计费与计算、tiktoken介绍

每个模型都具有不同的功能和价格。价格是按照每1000个 Token 计算的。您可以将Token视为单词的组成部分,其中1000个Token 大约相当于750个单词。(这段文字包含35个Token)

AAI666666的博客 4111

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

国内外大模型哪个最便宜?智谱赢了!

模型版本价格GPT3.5-4kGPT3.5-16kGPT4-8kgpt-4GPT4-32kgpt-4-32kPaLM-2PaLM-2claude-2claude-2claude-2讯飞星火SparkDesk360智脑360智脑通义千问qwen-v1通义千问文心千帆ERNIE-Bot文心千帆智谱chatglm智谱chatglm智谱chatglm模型版本价格文心千帆通义千问llm哪个最便宜?还是chatglm。

baidu_34494541的博客 6921

做大模型AI应用一定要了解的成本计算公式

产品二姐读完需要11分钟速读仅需 4 分钟1 引言先给大家先算个账:假设我要 GPT4 Turbo 帮我总结一篇 5000 字的文章,生成的总结是 500 个汉字,总共需要多少钱?这是一道数学题。已知条件是:一个汉字约等于 2 个 tokenOpenAI GPT 4 Turbo 的价格是:输入$0.01/K token,输出$0.03/K token解答:总结 5000 字的文章总金额 = 0...

zenRRan的博客 5860

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1734

基于NLP自然语言以token单位的chatgpt计费方式和收费标准

根据大家的经验,基本问清楚1个问题就要耗费100~200个token,算起来其实不少的,尤其在连续会话中,为了保持对话的连续性,必须每次都要回传历史消息,并且输入都要算 token 数算钱的,满打满算,按量付费其实也不便宜。AI也是创作,是不是可以也以文字数来收费呢?因为存在不同的切分方式,所以“红色的苹果”,就需要切分成“红”“红色”“的”“苹果”“果”“红色的苹果”等多个token去理解。例如,对于短语token,“红色的苹果”可以被视为一个token,而不是单独的“红色”和“苹果”token。

人工智能全栈工程师 | 智能算法研发与实战落地​专注于人工智能算法研究、代码实现与工程落地,提供从模型设计到部署应用的全流程解决方案。 1万+

如何调用讯飞星火认知大模型的API以利用其卓越功能

讯飞星火认知大模型是由科大讯飞构建的一款先进的人工智能模型。这款模型在处理自然语言理解和生成方面具有卓越的能力,能够提供高效、精准的信息交流和数据分析服务。本文向大家讲解如何调用讯飞星火的API,首先介绍python的调用方式,这是一个普遍使用的方式,然后,再讲解如何使用其他的调用方式。该模型通过深度学习技术和大量数据训练,具备了强大的语言理解、文本生成和对话交互等功能。它能够根据用户的具体需求,提供个性化的信息服务,包括但不限于语音识别、文本分析、自动翻译以及智能问答等。

AI浩 6177

大模型一个 token 能代表几个单词和汉字?

大模型一个 token 能代表几个单词和汉字?

2401_85375186的博客 2061

讯飞星火AI大模型API调用指南,免费给你的应用加上AI元素

打开https://xinghuo.xfyun.cn/sparkapi,往下滑找到spark lite,目前免费开放的是spark lite,点击立即体验。点击左侧的spark lite,可以看到有无限量的token,右侧有访问API是需要用到的key。博主会不定期的分享各种有关深度学习、机器学习、AI大模型等AI方面的内容。跳转到控制台,需要登录然后创建一个应用,我这里已经创建好。点进去应用,可以看到详情,这里可以测试对话。不同的平台有不同的访问方式。

AI360labs_atyun的博客 4677

Openai中的tokens怎么估计

大规模语言模型(LLM)的出现给自然语言处理领域带来了变革的可能性,Openai开放了chatgpt的API,方便了开发人员使用LLM的推理能力,注册时赠送5美元的使用额度,有效期3个月。如果想便捷的使用chatgpt的API,需要绑定信用卡,这个计费方式是按每1000个tokens计费。有兴趣进一步了解token如何工作,可以尝试复制文本粘贴即可显示tokens和characters数。

入门记 2639

Openai API 收费标准和计算方式,一个中文汉字算多少Token

API 开发者用户获取 GPT-4 API的使用权限,是通过绑定信用卡获取API key, 需要预充值5美元以上,才能绑卡成功 ​ 对于API 开发者用户,OpenAI 会根据你充值的金额,对你进行消费限额,比如你充值了5美元,调用 API 也最多消费 5 美元,可以另外设置自动充值,设置余额低于一个特定值就自动充值。OpenAI ChatGPT API是收费的,不同模型(如GPT-3.5、GPT-4.0等)的收费标准不一样,以下是OpenAI官方的API价格。API 开发者用户的登录入口是。

ejnoer的博客 3万+

【百度一面】大模型高频面试题:1个token到底等于几个字?

本文主要探讨了大语言模型中Token的概念及其应用。Token是模型处理文本的最小单元,在不同语言中的切分规则各异:中文1Token约1.5-2个汉字,英文1Token约0.75个单词。文章介绍了Token的切分技术(如BPE、子词级切分)、词表作用及输入输出流程,并指出Token数量直接影响模型性能指标。文中还对比了不同平台的Token计算工具,分析了主流切分技术的优劣,最后附带了AI大模型学习资源。Token作为模型的基本运算单位,其切分方式对文本处理质量至关重要。

2401_84494441的博客 2216
上一篇: “三国杀”:互联网云鏖战“云+大模型”
下一篇: AI大模型给稀土产业带来什么
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值