


无需 GPU 的隐私保护 LLM。在本博客中,我将演示使用不同的工具 Ollama 构建的 RAG 应用程序。 与本文相关的所有源代码均已发布在 github上。 请克隆存储库以跟随文章操作。我们可以通过如下的方式来克隆:
git clone https://github.com/liu-xiao-guo/ollama_es
什么是 Ollama?
Ollama 是一个轻量级且灵活的框架,专为在个人计算机上本地部署 LLM 而设计。 它通过直观的 API 简化了 LLMs 的开发、执行和管理,并提供了一系列预配置模型,可立即在各种应用程序中使用。 其设计的核心是将模型权重、配置和数据捆绑到一个统一的包中,并封装在模型文件中。
该框架具有一系列精选的预量化、优化模型,例如 Llama 2、Mistral 和 Gemma,可供部署。 这些模型经过专门设计,可在标准消费类硬件(涵盖 CPU 和 GPU)上运行,并且与多种操作系统兼容,包括 macOS、Linux 和 Windows。 这种方法消除了用户自己承担复杂的模型优化任务的必要性。
鉴于 LLMs 因其规模庞大而通常需要强大的 GPU 来进行操作,Ollama 支持的模型采用神经网络量化。 这项技术极大地降低了硬件要求,使 LLMs 能够在没有互联网连接的情况下在常见计算设备上高效运行。 因此,Ollama 使 LLM 技术变得更容易使用,使个人和组织能够在消费级硬件上利用这些先进的模型。

RAG 应用
该 RAG 应用程序包含一个定制的数据集,该数据集是从在线网站动态抓取的。 用户可以通过 API(例如 REST API)与网站数据进行交互。 出于演示目的,我们选择了 Open5GS 文档网站(Open5GS 是 5G Core 的 C 语言实现)。 Open5GS 文档中的数据被抓取、分割,然后作为向量嵌入存储在 Elasticsearch 向量数据库中。 因此,用户可以通过 API 与 Open5GS 文档的内容无缝交互。
对于此 RAG 应用程序的 LLM 组件,我选择了 Llama2 7B 模型,该模型通过 Ollama 运行。 在 Ollama 上运行的 Llama2 是 Meta 的基于 Llama-2 的 LLM,经过量化以在消费级硬件(例如 CPU)上实现最佳性能。 在此 RAG 应用程序中,与 Ollama 一起运行的 Llama2 LLM 根据 Open5GS 文档中的内容提供用户问题的答案。 通过 Langchain 促进了 RAG 应用程序和 LLM 的集成。
以下是 RAG 应用程序的主要功能。 下图详细介绍了包含这些不同组件的综合功能架构。

1. 抓取网络数据
Langchain 提供不同类型的文档加载器来加载不同来源的数据作为文档。 RecursiveUrlLoader 就是这样一种文档加载器,可用于将 Web url 中的数据加载到文档中。 此步骤使用 Langchain 的 RecursiveUrlLoader 从网络上抓取数据作为文档。 RecursiveUrlLoader 递归地将给定的 url 抓取到给定的 max_depth 并读取网络上的数据。 该数据用于创建向量嵌入并回答用户的问题。
2. 分割文档
处理较长的文本时,必须将文本分成较小的片段。 尽管这项任务看起来很简单,但它可能包含相当复杂的内容。 目标是确保语义相关的文本片段保持在一起。 Langchain 文本分割器有效地完成了这项任务。 本质上,它将文本划分为小的、具有语义意义的单元(通常是句子)。 然后将这些较小的片段组合起来形成较大的块,直到它们达到由特定函数确定的特定大小。 达到此大小后,该块将被指定为单独的文本片段,并且该过程会再次以一些重叠的方式开始。 对于这个特定的场景,我使用了 RecursiveCharacterTextSplitter 将抓取的文档分割成可管理的块。
3. 创建向量嵌入
收集并分割数据后,下一步是将文本信息转换为向量嵌入。 然后根据分割数据创建这些嵌入。 文本嵌入对于 LLM 操作的运作至关重要。 虽然使用自然语言处理语言模型在技术上是可行的,但存储和检索此类数据的效率非常低。 为了提高效率,有必要将文本数据转换为向量形式。 有专门为从文本创建嵌入而设计的专用机器学习模型。 在本例中,我使用开源 HuggingFaceEmbedding 模型 all-MiniLM-L6-v2 来生成向量嵌入。 因此,文本被转换为多维向量,这些向量本质上是捕获语义含义和上下文细微差别的高维数字表示。 嵌入后,可以对这些数据进行分组、排序、搜索等。 我们可以计算两个句子之间的距离来确定它们的相关程度。 重要的是,这些操作超越了依赖关键字的传统数据库搜索,而是捕获句子之间的语义接近度。
4. 将向量嵌入存储在 Elasticsearch 中
然后生成的向量嵌入存储在 Elasticsearch 向量数据库中。Elasticsearch 是一个开放及免费的嵌入数据库,通过存储和检索嵌入及其元数据以及文档和查询,可以轻松构建 LLM 应用程序。 Elasticsearch 可以有效地处理这些嵌入,从而可以快速检索和比较基于文本的数据。 传统数据库在精确查询方面效果很好,但在理解人类语言的细微差别方面却表现不佳。 输入向量数据库,它是处理语义搜索的游戏规则改变者。 与依赖于精确单词或短语的传统文本匹配不同。
5. 用户提问
系统提供API,用户可以通过该 API 提交问题。 在此用例中,用户可以提出与 Open5GS 文档内容相关的任何问题。 该 API 充当用户和聊天机器人之间交互的主要接口。 该 API 采用一个参数 user_id,用于标识不同的用户会话。 此 user_id 用于演示目的。 在现实场景中,可以使用 HTTP 请求中的授权标头(例如 JWT Bearer 令牌)进行管理。 该 API 的设计直观且易于访问,使用户能够轻松输入查询并接收响应。
6. 创建问题的向量嵌入
当用户通过 API 提交问题时,系统会将该问题转换为向量嵌入。 嵌入的生成由 ConversationalRetrievalChain 自动处理。 这有利于向量数据库内与问题相关的文档的语义搜索。
7. 语义搜索向量数据库
创建问题的向量嵌入后,系统会使用语义搜索来扫描向量数据库,识别与用户查询最相关的内容。 通过将问题的向量嵌入与存储的数据的向量嵌入进行比较,系统可以准确地查明上下文相似或与查询相关的信息。 在这种情况下,我使用了 ConversationalRetrievalChain,它根据输入查询自动处理语义搜索。 然后,语义搜索的结果将被识别为 LLM 的上下文。
8. 生成提示
接下来,ConversationalRetrievalChain 会根据用户的问题和语义搜索结果(上下文)生成自定义提示。 语言模型的提示是用户提供的一组指令或输入,用于指导模型的响应。 这有助于模型理解上下文并生成相关且连贯的基于语言的输出,例如回答问题、完成句子或参与对话。
9. 向 LLM 提交提示
生成提示后,它会通过 Langchain 库 Ollama(Langchain 在 langchain_community.llms 中正式支持 Ollama)发布到 LLM(在我们的示例中为 Llama2 7B)。 然后, LLM 根据提供的上下文找到问题的答案。 ConversationalRetrievalChain 处理将查询发布到 LLM 的功能。
10. LLM 生成答案
LLM 利用 Meta 的 Llama-2 的高级功能,在所提供内容的上下文中处理问题。 然后它生成响应并将其发回。
11. 在 MongoDB 聊天记录中保存查询和响应
Langchain 提供了各种用于管理会话内存的组件。 在这个聊天机器人中,MongoDB 用于会话内存的管理。 在此阶段,用户的问题和聊天机器人的响应都作为聊天历史记录的一部分记录在 MongoDB 存储中。 这种方法确保所有用户聊天历史记录都持久存储在 MongoDB 中,从而能够检索以前的交互。 数据按每个用户会话存储在 MongoDB 中。 为了区分用户会话,API 使用 user_id 参数,如前所述。 这些历史数据对于塑造未来的互动至关重要。 当同一用户提出后续问题时,聊天历史记录以及新的语义搜索结果(上下文)将被转发给 LLMs。 此过程保证聊天机器人可以在整个对话过程中保持上下文,从而产生更精确和定制的响应。
在本例中,我们没有完成这个部分的功能。在实际的操作中,我们也可以使用 Elasticsearch 来代替 MongoDB 来完成这个功能。
12. 将答案发送回用户
最后,从 LLM 收到的响应通过 HTTP API 转发给用户。 用户可以通过提供相同的 user_id 在后续请求中继续提出不同的问题。 然后,系统会识别用户的聊天历史记录,并将其与新的语义搜索结果一起包含在发送给 LLM 的信息中。 此过程可确保无缝且上下文相关的对话,从而丰富每次交互的用户体验。
安装
安装 Elasticsarch 及 Kibana
在安装的时候,我们选择 Elastic Stack 8.x 来进行安装。特别值得指出的是:ES|QL 只在 Elastic Stack 8.11 及以后得版本中才有。你需要下载 Elastic Stack 8.11 及以后得版本来进行安装。
在首次启动 Elasticsearch 的时候,我们可以看到如下的输出:

安装 Python 依赖包
我们在项目的根目录下使用如下的命令来创建虚拟的环境:
1.  python3 -m venv .venv
2.  source .venv/bin/activate
我们然后在虚拟的环境中打入如下的命令:
pip3 install -r requirements.txt
拷贝 Elasticsearch 证书
我们可以通过如下的方式把 Elasticsearch 的证书拷贝到当前的项目根目录下:
1.  (.venv) $ pwd
2.  /Users/liuxg/python/ollama
3.  (.venv) $ cp ~/elastic/elasticsearch-8.12.0/config/certs/http_ca.crt .
4.  overwrite ./http_ca.crt? (y/n [n])
你需要根据自己的证书的位置进行调整。
创建环境变量
我们在项目的当前根目录下,创建一个叫做 .env 的文件:
1.  INIT_INDEX=true
2.  TARGET_URL="https://open5gs.org/open5gs/docs/"
3.  HTTP_PORT=7654
4.  ES_USER="elastic"
5.  ES_PASSWORD="hBZtXFwhz3HCtLi-cVc5"
6.  ES_ENDPOINT="localhost"
1.  (.venv) $ pwd
2.  /Users/liuxg/python/ollama
3.  (.venv) $ ls .env
4.  .env
5.  (.venv) $ cat .env
6.  INIT_INDEX=true
7.  TARGET_URL="https://open5gs.org/open5gs/docs/"
8.  HTTP_PORT=7654
9.  ES_USER="elastic"
10.  ES_PASSWORD="hBZtXFwhz3HCtLi-cVc5"
11.  ES_ENDPOINT="localhost"
它的内容如上。你需要根据自己的 Elasticsearch 配置进行相应的修改。
实施
下面详细介绍该 ChatBot 的完整实现。 ChatBot 代理的完整源代码可在 github 上访问和查看。
1) 配置
在 config.py 文件中,我定义了 ChatBot 中使用的各种配置。
config.py
1.  import os
2.  from dotenv import load_dotenv
3.  from elasticsearch import Elasticsearch, helpers

5.  load_dotenv()

7.  # define init index
8.  INIT_INDEX = os.getenv('INIT_INDEX', 'false').lower() == 'true'

10.  # target url to scrape
11.  TARGET_URL =  os.getenv('TARGET_URL', "https://open5gs.org/open5gs/docs/")

13.  # http api port
14.  HTTP_PORT = os.getenv('HTTP_PORT', 7654)

16.  ES_USER = os.getenv("ES_USER")
17.  ES_PASSWORD = os.getenv("ES_PASSWORD")
18.  ES_ENDPOINT = os.getenv("ES_ENDPOINT")

20.  elastic_index_name = "ollama_index"

22.  url = f"https://{ES_USER}:{ES_PASSWORD}@{ES_ENDPOINT}:9200"

24.  connection = Elasticsearch(
25.      hosts=[url],
26.      ca_certs = "./http_ca.crt",
27.      verify_certs = True
28.      )
2) 模型 - model
下面是模型的实现。 它包含一个函数 init_index,该函数从给定的 Web URL 中抓取数据并创建向量存储。 环境变量 INIT_INDEX 用于确定是否创建索引。 init_conversation 函数使用 Ollama 的 Llama2 LLM 初始化 ConversationalRetrievalChain,可通过 Ollama 的模型 REST API :11434 获取(Ollama 提供用于与 LLM 交互的 REST API。有关如何使用此功能的详细说明和更多信息,请参阅到 Run Ollama Llama2 部分)。 聊天功能负责向 LLM 发送问题。
model.py
1.  from langchain_community.llms import Ollama
2.  from langchain_community.chat_models import ChatOpenAI
3.  from langchain_community.document_loaders import PyPDFLoader
4.  from langchain.document_loaders.recursive_url_loader import RecursiveUrlLoader
5.  from langchain_community.embeddings import OpenAIEmbeddings
6.  from langchain.text_splitter import CharacterTextSplitter
7.  from langchain.text_splitter import RecursiveCharacterTextSplitter
8.  from langchain.chains import ConversationalRetrievalChain
9.  from langchain.memory import ConversationBufferMemory
10.  from langchain_community.vectorstores import ElasticsearchStore
11.  from langchain_community.embeddings import HuggingFaceEmbeddings
12.  from bs4 import BeautifulSoup as Soup
13.  from langchain.utils.html import (PREFIXES_TO_IGNORE_REGEX,
14.                                    SUFFIXES_TO_IGNORE_REGEX)

16.  from elasticsearch import Elasticsearch, helpers

18.  from config import *
19.  import logging
20.  import sys

22.  logging.basicConfig(stream=sys.stdout, level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

24.  global conversation
25.  conversation = None

27.  global vectordb
28.  vectordb = None

30.  def init_index():
31.      global vectordb

33.      if not INIT_INDEX:
34.          logging.info("continue without initializing index")
35.          return

37.      # scrape data from web
38.      documents = RecursiveUrlLoader(
39.          TARGET_URL,
40.          max_depth=4,
41.          extractor=lambda x: Soup(x, "html.parser").text,
42.          prevent_outside=True,
43.          use_async=True,
44.          timeout=600,
45.          check_response_status=True,
46.          # drop trailing / to avoid duplicate pages.
47.          link_regex=(
48.              f"href=[\"']{PREFIXES_TO_IGNORE_REGEX}((?:{SUFFIXES_TO_IGNORE_REGEX}.)*?)"
49.              r"(?:[\#'\"]|\/[\#'\"])"
50.          ),
51.      ).load()

53.      logging.info("index creating with `%d` documents", len(documents))

55.      # split text
56.      # this chunk_size and chunk_overlap effects to the prompt size
57.      # execeed promt size causes error `prompt size exceeds the context window size and cannot be processed`
58.      text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
59.      documents = text_splitter.split_documents(documents)

61.      # create embeddings with huggingface embedding model `all-MiniLM-L6-v2`
62.      # then persist the vector index on vector db
63.      embeddings = HuggingFaceEmbeddings(model_)

65.      if not connection.indices.exists(index=elastic_index_name):
66.          print("The index does not exist, going to generate embeddings")
67.          vectordb = ElasticsearchStore.from_documents(
68.                  documents,
69.                  embedding = embeddings,
70.                  es_url = url,
71.                  es_connection = connection,
72.                  index_name = elastic_index_name,
73.                  es_user = ES_USER,
74.                  es_password = ES_PASSWORD
75.          )
76.      else:
77.          print("The index already existed")
78.          vectordb = ElasticsearchStore(
79.              es_connection = connection,
80.              embedding = embeddings,
81.              es_url = url,
82.              index_name = elastic_index_name,
83.              es_user = ES_USER,
84.              es_password = ES_PASSWORD
85.          )

87.  def init_conversation():
88.      global conversation
89.      global vectordb

91.      # llama2 llm which runs with ollama
92.      # ollama expose an api for the llam in `localhost:11434`
93.      llm = Ollama(
94.          model="llama2",
95.          base_url="http://localhost:11434",
96.          verbose=True,
97.      )

99.      # create conversation
100.      conversation = ConversationalRetrievalChain.from_llm(
101.          llm,
102.          retriever = vectordb.as_retriever(),
103.          return_source_documents = True,
104.          verbose = True,
105.      )

107.  def chat(question, user_id):
108.      global conversation

110.      chat_history = []
111.      response = conversation({"question": question, "chat_history": chat_history})
112.      answer = response['answer']

114.      logging.info("got response from llm - %s", answer)

116.      # TODO save history

118.      return answer
3) HTTP API
HTTP API 的实现在 api.py 中进行。 此 API 包括 HTTP POST 端点 api/question,它接受包含问题和 user_id 的 JSON 对象。 user_id 用于演示目的。 在实际应用程序中,这可以通过 HTTP 请求中的授权标头(例如 JWT Bearer 令牌)进行管理。 当收到用户的问题请求时,它会被转发到 ChatBot 模型中的聊天功能。
1.  from flask import Flask
2.  from flask import jsonify
3.  from flask import request
4.  from flask_cors import CORS
5.  import logging
6.  import sys
7.  from model import init_index
8.  from model import init_conversation
9.  from model import chat
10.  from config import *

12.  app = Flask(__name__)
13.  CORS(app)

15.  init_index()
16.  init_conversation()

18.  logging.basicConfig(stream=sys.stdout, level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

20.  @app.route("/")
21.  def index():
22.      return "<p>Hello, World!</p>"

24.  @app.route('/api/question', methods=['POST'])
25.  def post_question():
26.      json = request.get_json(silent=True)
27.      question = json['question']
28.      user_id = json['user_id']
29.      logging.info("post question `%s` for user `%s`", question, user_id)

31.      resp = chat(question, user_id)
32.      data = {'answer':resp}

34.      return jsonify(data), 200

36.  if __name__ == '__main__':
37.      app.run(host='0.0.0.0', port=HTTP_PORT, debug=True)
运行应用
以下是操作 ChatBot 应用程序并与之交互的主要步骤。 可以使用 HTTP API 提交问题,并将收到相应的响应。
运行 Ollama LIama2
Ollama 提供了多种部署选项,使其能够作为独立的二进制文件在 macOS、Linux 或 Windows 以及 Docker 容器中运行。 这种灵活性确保用户可以在自己喜欢的平台上轻松设置 LLM 并与 LLM 进行交互。 Ollama 支持命令行和 REST API 交互,允许无缝集成到各种工作流程和应用程序中。 其实用性的一个例子是通过 Ollama 运行 Llama2 模型,展示了其有效托管和管理 LLM 的能力。 下面是使用 Docker 部署 Ollama 的示例方法,重点介绍了我在此平台上运行 Llama2 模型的经验。
docker run -d -v $(PWD)/data:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
1.  $ docker run -d -v $(PWD)/data:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
2.  Unable to find image 'ollama/ollama:latest' locally
3.  latest: Pulling from ollama/ollama
4.  f4bb4e8dca02: Pull complete
5.  aeed191ede92: Pull complete
6.  920e2a93e5f4: Pull complete
7.  Digest: sha256:75fb97cdd8f435756d26eb7783599122b814c4b97da2012dc21ebc0efbd90fef
8.  Status: Downloaded newer image for ollama/ollama:latest
9.  a7a4fc0bed77b910ee30a5c200ee9a069f47e3974f91c2eda6cda67f353276bb
docker exec -it ollama bash
1.  $ docker exec -it ollama bash
2.  root@a7a4fc0bed77:/# ollama run llama2
3.  pulling manifest
4.  pulling 8934d96d3f08... 100% ▕███████████████████████████████▏ 3.8 GB
5.  pulling 8c17c2ebb0ea... 100% ▕███████████████████████████████▏ 7.0 KB
6.  pulling 7c23fb36d801... 100% ▕███████████████████████████████▏ 4.8 KB
7.  pulling 2e0493f67d0c... 100% ▕███████████████████████████████▏   59 B
8.  pulling fa304d675061... 100% ▕███████████████████████████████▏   91 B
9.  pulling 42ba7f8a01dd... 100% ▕███████████████████████████████▏  557 B
10.  verifying sha256 digest
11.  writing manifest
12.  removing any unused layers
13.  success
14.  >>> /byte
15.  Unknown command '/byte'. Type /? for help
16.  >>> /?
17.  Available Commands:
18.    /set            Set session variables
19.    /show           Show model information
20.    /load <model>   Load a session or model
21.    /save <model>   Save your current session
22.    /bye            Exit
23.    /?, /help       Help for a command
24.    /? shortcuts    Help for keyboard shortcuts

26.  Use """ to begin a multi-line message.

28.  >>> /bye
29.  root@a7a4fc0bed77:/# ollama list
30.  NAME         	ID          	SIZE  	MODIFIED
31.  llama2:latest	78e26419b446	3.8 GB	19 minutes ago
32.  root@a7a4fc0bed77:/# ollama run llama2
33.  >>> what is docker?

35.  Docker is a computer program that creates software containers, which are lightweight and
36.  portable environments for applications to run in. It was first released in 2013 by Docker
37.  Inc., and has since become one of the most popular and widely-used containerization
38.  platforms.

40.  Docker allows developers to package an application and its dependencies into a single
41.  container that can be run on any system that has Docker installed, regardless of the
42.  underlying architecture or operating system. This makes it easy to deploy applications
43.  across different environments, such as from development to testing to production, without
44.  worrying about compatibility issues.

46.  Here are some key features of Docker:

48.  1. Containerization: Docker creates lightweight containers for applications, which
49.  includes everything an application needs to run, including code, libraries, and
50.  dependencies.
51.  2. Portability: Docker containers are platform-independent, meaning they can be run on
52.  any system that has Docker installed, regardless of the underlying architecture or
53.  operating system.
54.  3. Isolation: Docker containers are isolated from each other and from the host system,
55.  which means they do not interfere with each other or access sensitive information outside
56.  of their own container.
57.  4. Efficiency: Docker containers use less resources than traditional virtualization
58.  methods, making them faster to spin up and more efficient in terms of memory and CPU
59.  usage.
60.  5. Security: Docker provides a secure environment for applications by isolating them from
61.  the host system and limiting access to sensitive resources.
62.  6. Networking: Docker provides a built-in networking system that allows containers to
63.  communicate with each other and with external services.
64.  7. Version control: Docker allows developers to manage different versions of their
65.  applications by creating and managing different containers for each version.
66.  8. Collaboration: Docker makes it easy for multiple developers to work on the same
67.  application by allowing them to create and share containers.
68.  9. Automated workflows: Docker provides a range of tools for automating the deployment
69.  and management of applications, such as continuous integration and continuous deployment
70.  (CI/CD) pipelines.

72.  Docker is used in a variety of industries and use cases, including:
73.  ...
74.  >>> exit
75.  >>> exit

77.  Thank you for using Docker! If you have any questions or need further assistance, feel
78.  free to ask. Otherwise, it was nice working with you. Have a great day and happy coding! 🚀

80.  >>> /bye
81.  root@a7a4fc0bed77:/# exit
82.  exit
83.  $ curl http://localhost:11434/api/generate -d '{
84.  >   "model": "llama2",
85.  >   "prompt": "what is docker?",
86.  >   "stream": true
87.  > }'
88.  {"model":"llama2","created_at":"2024-03-24T10:50:52.97276476Z","response":"\n","done":false}
89.  {"model":"llama2","created_at":"2024-03-24T10:50:53.118271052Z","response":"D","done":false}
90.  {"model":"llama2","created_at":"2024-03-24T10:50:53.262979052Z","response":"ocker","done":false}
91.  {"model":"llama2","created_at":"2024-03-24T10:50:53.40882826Z","response":" is","done":false}
92.  {"model":"llama2","created_at":"2024-03-24T10:50:53.554231219Z","response":" an","done":false}
93.  {"model":"llama2","created_at":"2024-03-24T10:50:53.69958351Z","response":" open","done":false}
94.  {"model":"llama2","created_at":"2024-03-24T10:50:53.844950552Z","response":"-","done":false}
95.  {"model":"llama2","created_at":"2024-03-24T10:50:53.989866969Z","response":"source","done":false}
96.   ....
我们可以在另外一个 termnial 中打入如下的命令:
1.  curl http://localhost:11434/api/generate -d '{
2.    "model": "llama2",
3.    "prompt": "what is docker?",
4.    "stream": true
5.  }'
1.  $ curl http://localhost:11434/api/generate -d '{
2.  >   "model": "llama2",
3.  >   "prompt": "what is docker?",
4.  >   "stream": true
5.  > }'
6.  {"model":"llama2","created_at":"2024-03-24T10:54:20.300787717Z","response":"\n","done":false}
7.  {"model":"llama2","created_at":"2024-03-24T10:54:20.453422759Z","response":"D","done":false}
8.  {"model":"llama2","created_at":"2024-03-24T10:54:20.598751134Z","response":"ocker","done":false}
9.  {"model":"llama2","created_at":"2024-03-24T10:54:20.744523634Z","response":" is","done":false}
10.  {"model":"llama2","created_at":"2024-03-24T10:54:20.890211551Z","response":" a","done":false}
11.  {"model":"llama2","created_at":"2024-03-24T10:54:21.035385717Z","response":" container","done":false}
12.  {"model":"llama2","created_at":"2024-03-24T10:54:21.179915259Z","response":"ization","done":false}
13.  {"model":"llama2","created_at":"2024-03-24T10:54:21.324945884Z","response":" platform","done":false}
14.  {"model":"llama2","created_at":"2024-03-24T10:54:21.469440676Z","response":" that","done":false}
15.  {"model":"llama2","created_at":"2024-03-24T10:54:21.614479718Z","response":" allows","done":false}
16.  ^C
我们也可以使用如下的命令来进行测试:
1.  $ curl http://localhost:11434/api/generate -d '{
2.    "model": "llama2",
3.    "prompt": "what is docker?",
4.    "stream": false
5.  }'
6.  {"model":"llama2","created_at":"2024-03-24T10:55:44.499693339Z","response":"\nDocker is an open-source platform that enables you to create, deploy, and run applications in containers. Containers are lightweight and portable, and they provide a consistent and reliable way to deploy applications across different environments. Docker allows developers and IT professionals to package an application and its dependencies into a single container, which can be easily deployed and run on any system that supports Docker, regardless of the underlying infrastructure.\n\nDocker provides several benefits, including:\n\n1. Isolation: Containers are isolated from each other and the host system, which means that if one container crashes or is compromised, it won't affect other containers or the host system.\n2. Portability: Containers are portable, meaning they can be deployed on any system that supports Docker, regardless of the underlying infrastructure.\n3. Faster deployment: With Docker, you can deploy applications faster because containers are smaller and easier to set up than traditional virtual machines.\n4. Easier collaboration: Docker makes it easier for developers to collaborate on applications because containers can be easily shared and reproduced across different environments.\n5. Improved security: Containers provide a consistent and predictable environment, which can help improve application security by reducing the risk of vulnerabilities and attacks.\n6. Scalability: Docker allows you to scale applications more easily by creating multiple containers that can be scaled independently.\n7. Better resource utilization: Docker allows you to make better use of system resources because containers are lightweight and do not require a separate operating system for each application.\n8. Simplified backup and recovery: With Docker, you can easily create backups of your applications and restore them in case of a failure or disaster.\n9. Improved testing and development: Do
请注意:在上面的命令运行后,可能需要一个较长的时间才能得到响应。你需要耐心等待。
运行 RAG 应用
RAG 应用程序可以通过 api.py 启动,如下所述。 在运行之前,有必要通过环境变量设置一些配置。 app.py 执行后,它将启动 HTTP API,使用户能够发布他们的问题。
我们可以使用如下的命令来设置 flask 应用:
1.  export FLASK_APP=api.py
2.  flask run

上面显示我们的服务器运行于地址 http://127.0.0.1:5000。
在运行完上面的命令后,我们可以到 Kibana 中进行查看:
GET ollama_index/_search

我们可以看到有 361 个文档被写入到 Elasticsearch 中。
为了验证我们的 flask 服务器是否已经正常运行,我们可以在浏览器中打入如下的地址。

很显然我们的服务器是运行正常的。
我们在另外一个 terminal 中打入如下的命令:
1.  curl -i -XPOST "http://127.0.0.1:5000/api/question" \
2.  --header "Content-Type: application/json" \
3.  --data '
4.  {
5.    "question": "what is open5gs",
6.    "user_id": "kakka"
7.  }
8.  '
我们在 flask 运行的 terminal 中可以看到如下的画面:

依赖于你的电脑的运行速度,等一小段的时间,我们可以看到如下的结果:

我们再尝试做一个查询:
1.  curl -i -XPOST "http://127.0.0.1:5000/api/question" \
2.  --header "Content-Type: application/json" \
3.  --data '
4.  {
5.    "question": "what is EPC",
6.    "user_id": "kakka"
7.  }
8.  '

请在地址下载所有的源码 GitHub - liu-xiao-guo/ollama_es
如何学习大模型
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
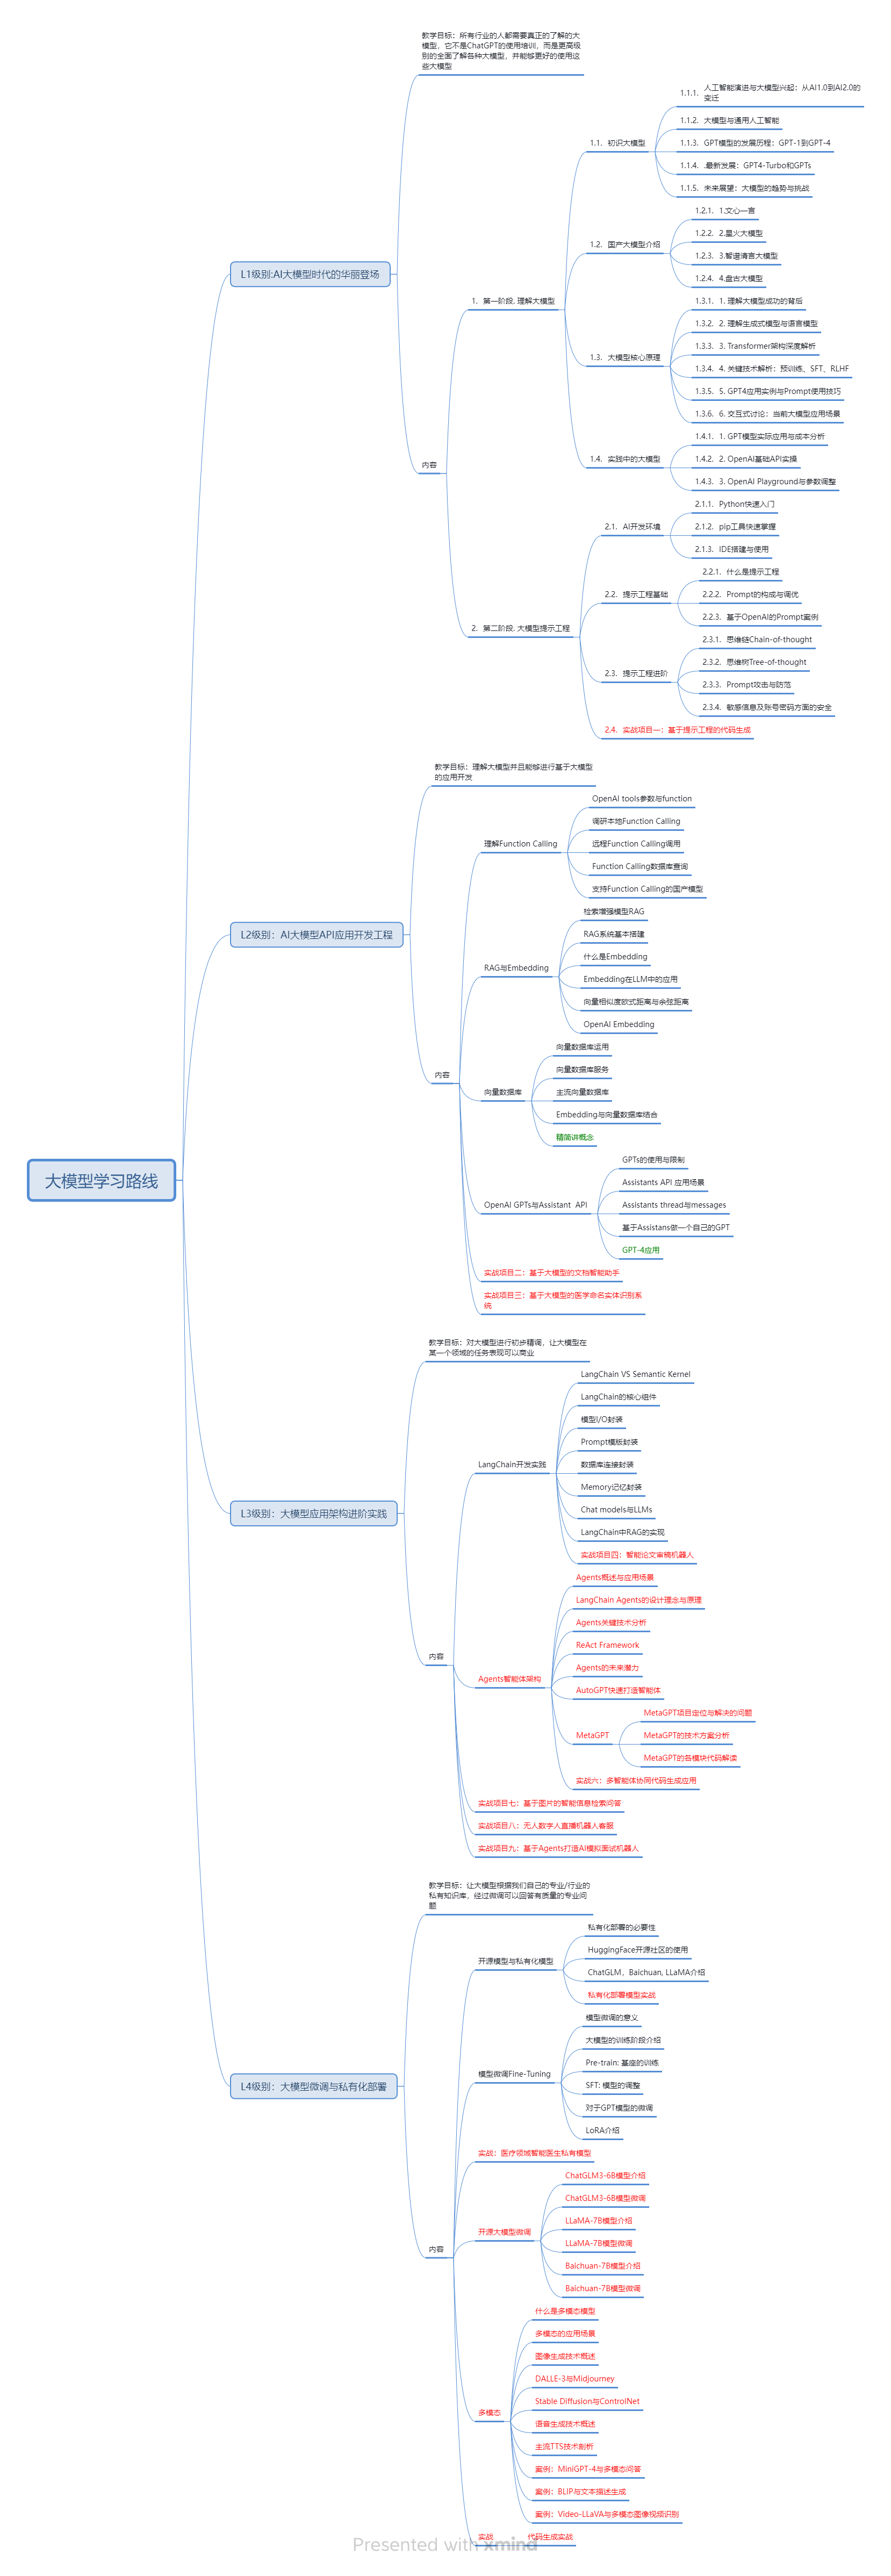
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
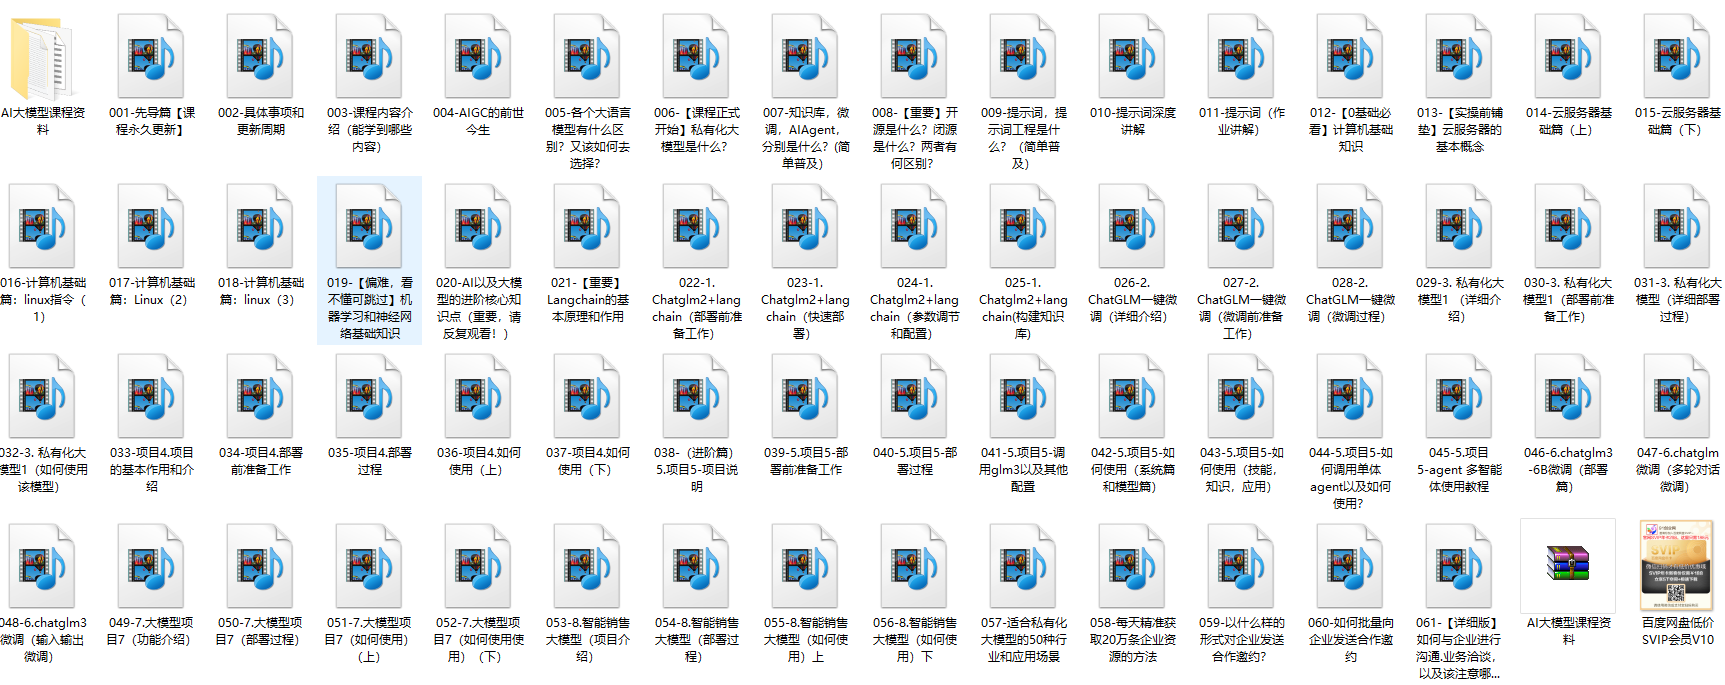
二、AI大模型视频教程
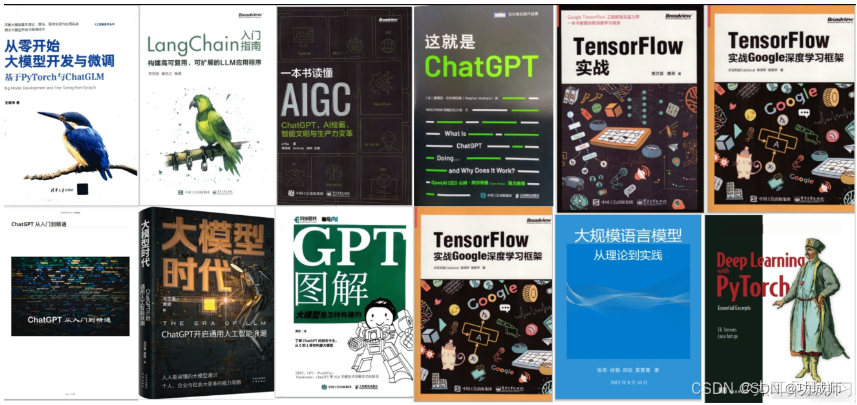
三、AI大模型各大学习书籍!
四、AI大模型各大场景实战案例
五、AI大模型面试题库

五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 1312


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


