现在,一行命令使用Ollama运行任意魔搭GGUF模型

魔搭社区+Ollama实战:快速本地加载DeepSeek-GGUF模型的完整指南 本文提供了一套高效本地部署DeepSeek模型的实战方案。针对Ollama直接下载模型速度慢的问题,详细介绍了如何从魔搭社区快速获取GGUF格式模型文件,并通过编写Modelfile将其导入Ollama运行。该方法结合了魔搭社区的下载速度优势和Ollama的便捷管理,是解决本地加载大模型网络瓶颈的完整指南。 阅读详情
AI摘要

本文介绍了Ollama大模型推理工具框架,它基于llama.cpp,能在不同硬件环境运行GGUF格式大模型,通过命令行拉起服务,还支持ModelScope平台模型。同时分享了一键运行、配置定制等使用方法,最后给出大模型学习资料和路线,强调学习大模型的价值。

img

Ollama是建立在llama.cpp开源推理引擎基础上的大模型推理工具框架。得益于底层引擎提供的高效模型推理,以及多硬件适配,Ollama能够在包括CPU、GPU在内的,不同的硬件环境上,运行各种精度的GGUF格式大模型。通过一个命令行就能拉起LLM模型服务。

通过Ollama,开发者可以更好的使用GGUF模型。而当前ModelScope社区上已经托管了数千个优质的GGUF格式的大模型,为了让开发者更方便地把这些模型用起来,社区最近支持了Ollama框架和ModelScope平台的链接,通过简单的 ollama run命令,就能直接加载运行ModelScope模型库上的GGUF模型。

01

一键运行

入门非常简单:

  1. 设置ollama下启用
ollama serve
  1. ollama run ModelScope任意GGUF模型
ollama run modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF

在安装了Ollama的环境上(建议使用>=0.3.12版本),直接通过上面的命令行,就可以直接在本地运行 Qwen2.5-3B-Instruct-GGUF模型。
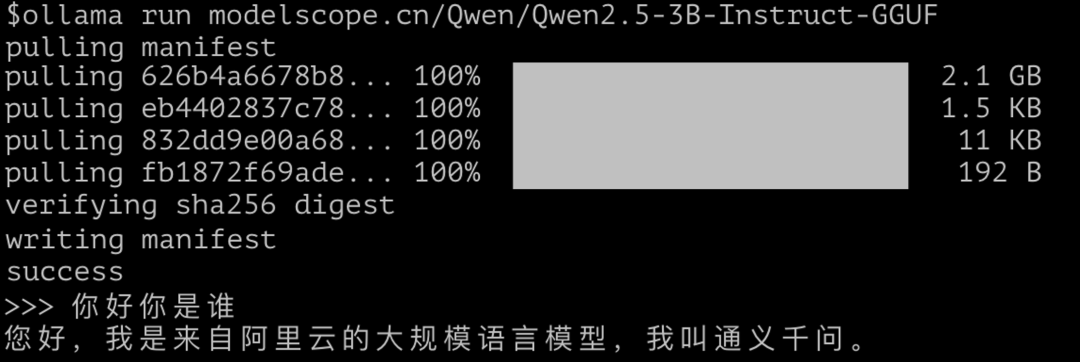
img

命令行的具体格式为:

ollama run modelscope.cn/{model-id}

其中model-id的具体格式为{username}/{model},例如:

ollama run modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF
ollama run modelscope.cn/second-state/gemma-2-2b-it-GGUF
ollama run modelscope.cn/Shanghai_AI_Laboratory/internlm2_5-7b-chat-gguf

关于如何安装Ollama,可参考Ollama官方文档(https://ollama.com/download),建议使用>=0.3.12版本。

或者参见这个ModelScope Notebook来完成安装:https://modelscope.cn/notebook/share/ipynb/4a85790f/ollama-installation.ipynb 。

02

配置定制

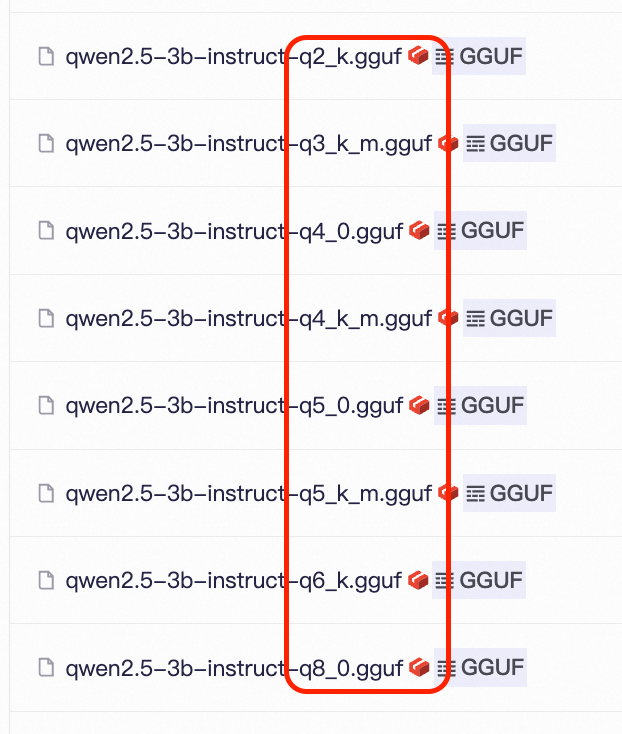
Ollama支持加载不同精度的GGUF模型,同时在一个GGUF模型库中,一般也会有不同精度的模型文件存在,例如Q3_K_M, Q4_K_M, Q5_K等等,入下图所示:
img

一个模型repo下的不同GGUF文件,对应的是不同量化精度与量化方法。默认情况下,如果模型repo里有Q4_K_M版本的话,我们会自动拉取并使用该版本,在推理精度以及推理速度,资源消耗之间做一个较好的均衡。如果没有该版本,我们会选择合适的其他版本。

此外,您也可以显式配置来指定想要使用的版本。例如:

ollama run modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF:Q3_K_M

这里命令行最后的:Q3_K_M选项,就指定了使用Q3_K_M精度的GGUF模型版本,这个选项大小写不敏感,也就是说,无论是:Q3_K_M,还是:q3_k_m,都是使用模型repo里的"qwen2.5-3b-instruct-q3_k_m.gguf" 这个模型文件。当然,您也可以直接指定模型文件的全称,这同样是支持的:

ollama run modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF:qwen2.5-3b-instruct-q3_k_m.gguf

03

更多配置选项

Ollama支持通过Modelfile配置文件,来实现大模型推理的参数自定义。ModelScope与Ollama的对接,会根据平台上GGUF模型的信息,自动生成每个模型需要的配置与参数,包括推理模版(Template),模型参数(Parameters)等等,后续我们也将支持模型贡献者在模型repo里,通过特定文件来指定专属的配置,敬请期待 :)。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

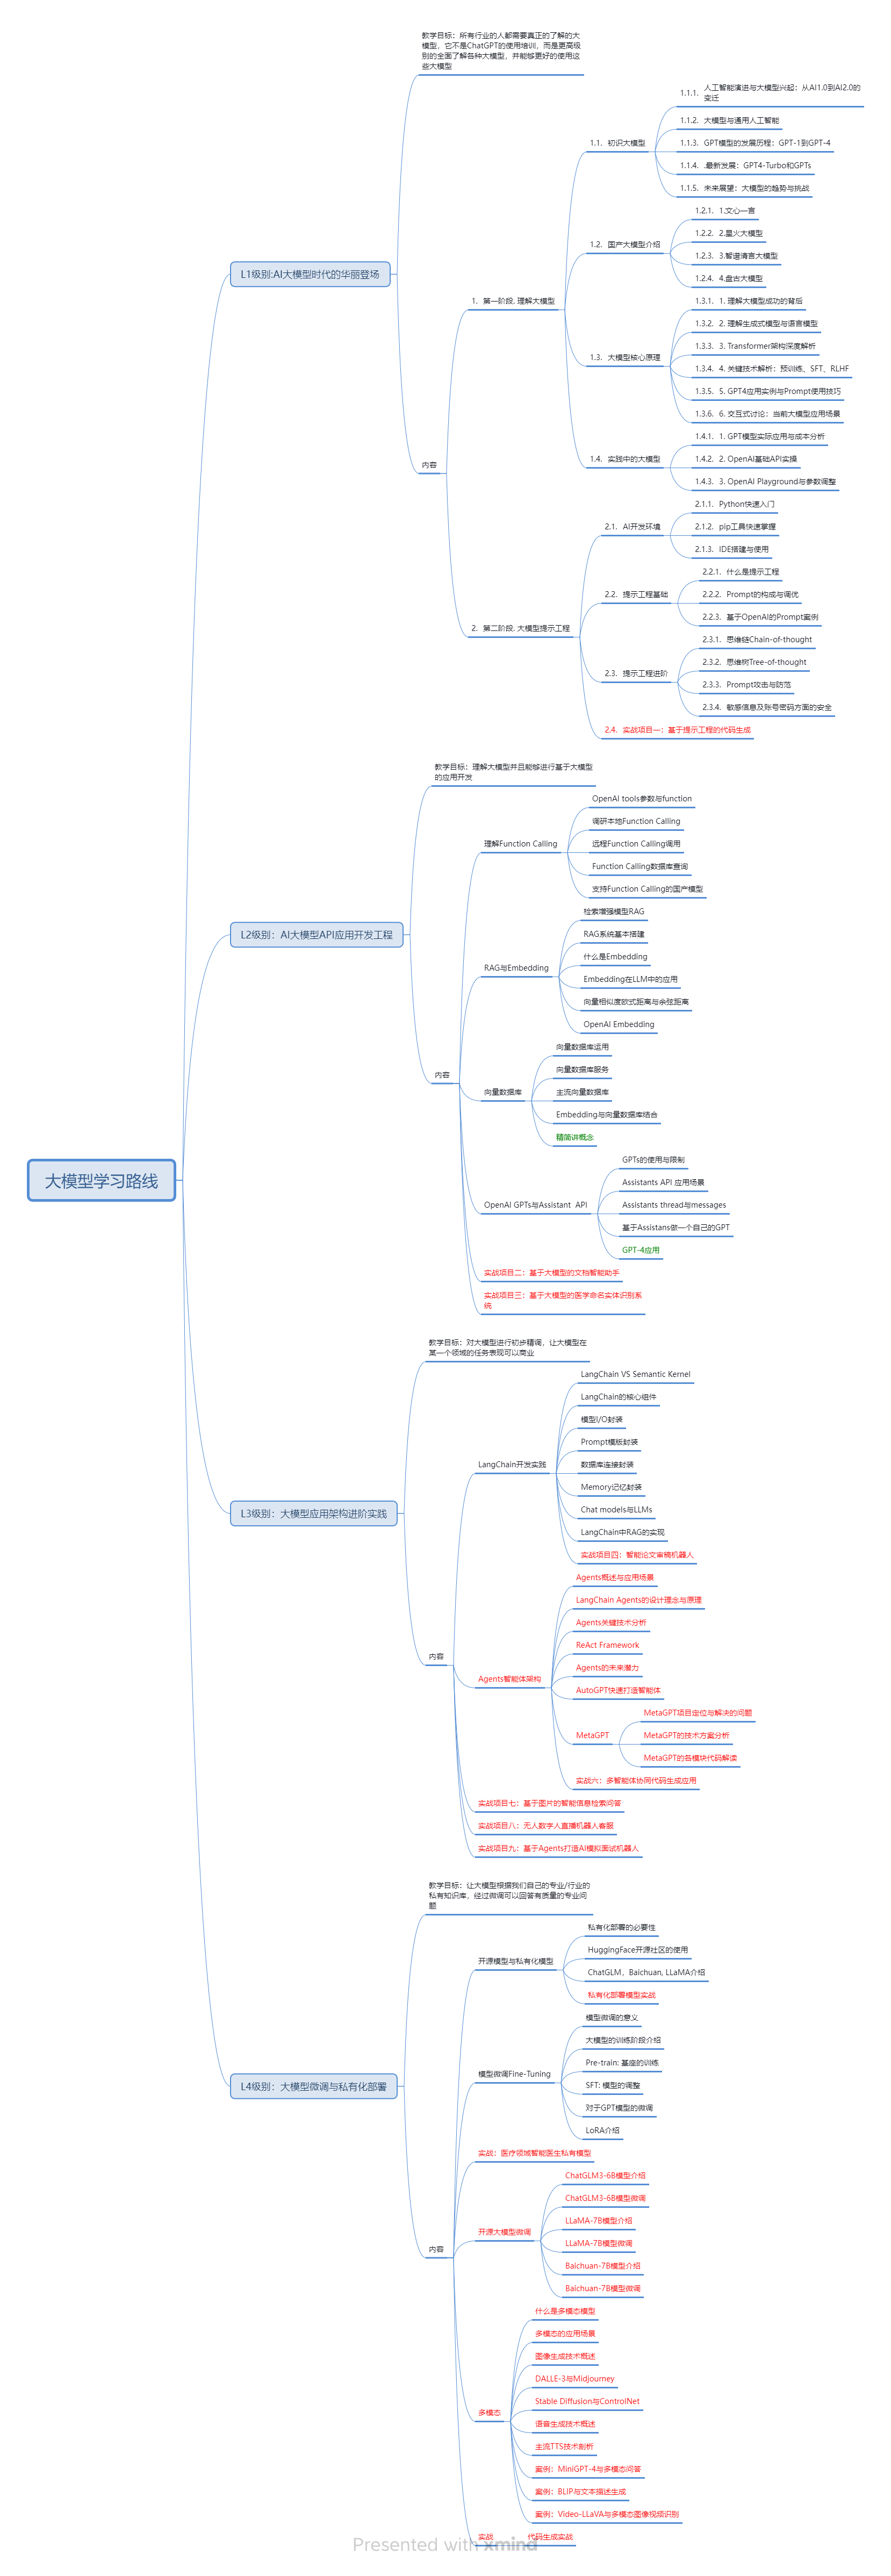
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Ollama与魔搭社区:轻量级大语言模型本地部署方案 大语言模型(LLM)的本地化部署是AI技术落地的重要环节,其核心在于平衡计算资源与模型性能。通过模型量化技术(如GGUF格式)和智能内存调度,可以在消费级硬件上高效运行7B参数级别的模型。Ollama作为轻量级部署框架,结合魔搭社区丰富的开源模型资源,为开发者提供了开箱即用的解决方案。这种技术组合特别适合需要数据隐私保护的企业场景和快速模型迭代的开发需求,实测在16GB内存设备上即可流畅运行ChatGLM3等主流模型。方案支持REST API标准化接口,并能与LangChain等AI开发生态无缝集成,显著降 阅读详情

相关推荐

Ollama 运行从 ModelScope 下载的 GGUF 格式的模型(DeepSeek 为例)

Windows 10。

BI 7817

【LLM大模型】Ollama 运行 GGUF 模型

【LLM大模型】Ollama 运行 GGUF 模型

2301_81888214的博客 4753

将.sefatensors模型文件合并为.gguf模型文件,并使用ollama导入.gguf模型

不同的量化版本精度不同,例如Q2_0的模型文件最小,但模型的精度比Q4_0、Q8_0都更低,Q2_k跟Q2_0的区别是k是0的改进版,提供了另一个优化策略,在两者模型大小差不多的情况下,精度更高一点,后面Q2_k跟着的S、L、M、XL,应该就是跟衣服的码数差不多的意思,你选的越大对你的电脑的硬件要求就更大,F32就是最好的精度,IQ4_XS是电脑内存非常有限才选择。理论上这样是可行的,但是huggingface是国外的网站,每次我进行这样操作的时候,都会出现连接超时,并没有成功过。

chenlei456的博客 3877

Ollama怎么启动.gguf 大模型

Llama3-8B。

本博客,博文仅代表个人操作经验,不能完全解决你的问题,仅供参考,佛系回复。 2782

大模型转换为 GGUF 以及使 用 ollama 运行

使用ollama create命令创建自定义模型。

weixin_47659945的博客 1105

Ollama 加载本地下载的gguf大模型

在本地安装好ollama后,下载加载模型总是失败,出现的错误信息为:pull model manifest net/http: TLS handshake timeout。尝试很多办法都没能成功,所以出现了本文离线下载gguf模型文件,然后再倒入ollama运行的原因。

西木风落 1948

Ollama手动导入GGUF模型文件

本文详述了GGUF模型下载,并将模型手动导入 Ollama 的操作步骤。

weixin_46241866的博客 2万+

Ollama 在本地快速部署大型语言模型,可进行定制并创建属于您自己的模型

Ollama支持从GGUF导入模型至Modelfile中:创建一个名为Modelfile的文件,其中包含一个FROM指令,指定要导入的本地模型文件路径。在Ollama中创建模型运行模型可以从Ollama库中自定义带有提示的模型。例如,要自定义llama2创建一个ModelfileFROM llama2 # 设置温度为1 [数值越高创造力越强,数值越低连贯性越好] PARAMETER temperature 1 # 设置系统消息 SYSTEM """您是来自《超级马里奥兄弟》的马里奥。

洛阳泰山的博客 3712

Ollama+GGUF离线加载本地模型

一般在使用Ollama下载模型时,都是从官方仓库下载(使用,但一些环境下,受限于网速等原因使用这种方式可能会非常慢甚至无法下载,所以我们可以选择使用上的文件,在Ollama仓库里的模型都可以在Huggingface上找到,因此我们可以使用Ollama+GGUF文件离线加载模型。

danielxinhj的博客 1万+

从CMOS到CML:手把手教你为PLL选对分频器电路(附性能对比与选型指南)

本文深入解析了PLL分频器电路的三大主流架构——静态CMOS、动态TSPC和CML,通过性能参数对比和实测数据,提供了从频率需求、功耗预算到噪声防护的完整选型指南。特别针对高频应用的CML分频器设计要点和混合架构优化方案,为射频与模拟IC设计工程师提供实用参考。

weixin_30887919的博客 462

win10下Miracast无线投屏使用教程及异常解决方案(超详细)

文章目录一、什么是Miracast?二、主流的无线投屏技术有哪些特点?三、如何查看自己的win10电脑是否支持Miracast无线投屏功能?四、win10电脑如何使用Miracast无线投屏功能? 一、什么是Miracast? Miracast是由Wi-Fi联盟于2012年所制定,以Wi-Fi直连(Wi-Fi Direct)为基础的无线显示标准。支持此标准的3C设备(如智能手机、电视、投影、电脑等...

帅气的小白的博客 44万+

如何在ollama中导入并运行GGUF模型文件

在GGUF文件相同的位置创建一个Modelfile文件,使用文本编辑器写一句话表示GGUF模型文件的路径即可。GGUF文件是模型的量化文件,可以从Huggingface或者魔塔社区进行下载。SYSTEM “你是一个专业AI助手,请根据用户输入回答问题,不要编造信息。模型创建成功之后可以通过下面的命令查看。模型创建成功之后可以通过下面的命令查看。

是小驴呀的博客 6031

stm32控制舵机_使用URT-1控制飞特舵机上手教程(SM40BL舵机为例)

使用URT-1控制飞特舵机上手教程(SM40BL舵机为例):1,参阅URT-1使用说明.pdf2, 材料清单:① URT-1驱动板② 连接驱动板与电脑的MINI USB 连接线③ 给舵机供电的电源④ 舵机与舵机连接线⑤ 杜邦线(可选)3,将URT-1驱动板与电脑连接4,安装驱动,参阅文件CH340驱动,检查设备管理器串口号。5,舵机连接URT-1驱动板,驱动板接电源,参考下图:6,打开FD软件进行...

weixin_39564510的博客 3432

Ollama通过gguf文件加载AI模型

通过ollama与gguf文件可以在电脑上运行一个属于自己的离线AI模型,比闭源模型更可以保护隐私信息不被泄露。另外,在自己的电脑上集成AI模型可以随时随地使用,不被网络环境限制

2201_75335496的博客 4169

Depth Anything 3实战:如何用DINOv2 Transformer一键生成3D高斯点云?

本文详细介绍了Depth Anything 3(DA3)模型如何利用DINOv2 Transformer架构,实现从单张或多视角图像一键生成高质量3D高斯点云。DA3通过统一的深度-射线表示和自适应注意力机制,简化了传统复杂的3D重建流程,并可直接微调用于3D高斯渲染,为图形学、CV和内容创作领域提供了高效的端到端解决方案。

postgres8guard的博客 723

基于pytorch cnn ResNets卷积网络的模糊图像检测 完整代码数据直接运行

基于pytorch cnn ResNets卷积网络的模糊图像检测 完整代码数据直接运行

730

如何在本地使用Ollama运行 Hugging Face 模型

通过简单的步骤,用户可以将 Hugging Face 上的模型转换为 GGUF 格式,实现在本地离线运行大型语言模型。文章首先介绍了 Ollama 的优势,包括简单的命令行界面、内置 REST API、快速模型切换和离线支持。然后详细讲解了完整的工作流程:从寻找或创建 GGUF 版本的模型,到编写 Modelfile、创建和运行模型。对于没有现成 GGUF 版本的模型,文章还提供了详细的转换教程,包括安装依赖、下载模型、转换格式等步骤

AI人工智能的学习之路 2850

RK3568平台(KBuild篇)KBuild编译体系

从Linux内核2.6开始,Linux内核的编译采用Kbuild系统,这和过去的编译系统有很大的不同,尤其对于Linux内核模块的编译。在新的系统下,Linux编译系统会两次扫描Linux的Makefile:首先编译系统会读取Linux内核顶层的Makefile,然后根据读到的内容第二次读取Kbuild的Makefile来编译Linux内核。kbuild,即 kernel build,用于编译 Linux 内核文件。

weixin_49303682的博客 349

Ollama 加载及运行 ModelScope GGUF 模型

Ollama是建立在llama.cpp开源推理引擎基础上的大模型推理工具框架。得益于底层引擎提供的高效模型推理,以及多硬件适配,Ollama能够在包括CPU、GPU在内的,不同的硬件环境上,运行各种精度的GGUF格式大模型。通过一个命令行就能拉起LLM模型服务。ModelScope社区上托管了数千个优质的GGUF格式的大模型(包括LLM和视觉多模态模型),并支持了Ollama框架和ModelScope平台的链接,通过简单的ollama run命令,就能。

学亮编程手记 2453

语音识别:PyAudio、SoundDevice、Vosk、openai-whisper、Argos-Translate、FunASR(Python)

本文介绍了Python中常用的音频处理库PyAudio,详细解析了其核心功能、核心概念和典型工作流程。PyAudio是一个跨平台的音频I/O库,支持音频录制、播放、实时流处理和低延迟操作。核心概念包括PyAudio类(管理音频设备和流)和Stream类(代表音频流)。文章重点讲解了open()方法的关键参数、回调函数的使用方式以及典型的工作流程,包括设备查询、流配置和资源释放。PyAudio适用于需要实时音频处理的场景,如语音识别和音频效果处理。

算法工程师 706

ISO21434 组织网络安全管理(二)

为了实现网络安全工程,该组织建立并维护网络安全治理和网络安全文化,包括网络安全意识管理、能力管理和持续改进。这涉及到指定针对本文档的目标进行独立审计的特定于组织的规则和过程。 为了支持网络安全工程,该组织实施了网络安全的管理系统,包括管理工具和应用质量管理系统。

qq_42357877的博客 1322

【大模型】Ollama 更改镜像源,通过魔搭拉取模型

当前比较流行使用Ollama部署本地大模型,但是由于资源问题,经常会遇到下载速度很慢或下载不成功的问题。国内知名镜像源并没找到相应的镜像。以下介绍通过魔搭社区的模型库拉取大模型的方法:ModelScope2Registry 是 Ollama 到 ModelScope 的模型 Registry 镜像站 / 加速器,它为 ModelScope 补齐更多了 Ollama Registry Manifests 信息,使 Ollama 能够从 ModelScope 魔搭 更快的 拉取 / 下载 模型。

OpenSeek的博客 2万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

大模型转换为 GGUF 并使用Ollama部署

下载的模型都是GGUF格式,那如何部署私有大模型呢?

Y525698136的博客 3136

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

【Ollama】解决 ollama 软件下载慢,模型下载慢的问题

本文主要解决 ollama 软件及模型下载慢的问题。

m0_66434421的博客 2万+

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

上一篇: Ollama 部署的大模型如何输出结构化响应?
下一篇: 一书直接讲透自然语言处理《Getting Started with Google BERT_ Build and train》
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值