


经常有新手小白在学习完 Python 的基础知识之后,不知道该如何进一步提升编码水平,那么此时找一些友好的网站来练习爬虫可能是一个比较好的方法,因为高级爬虫本身就需要掌握很多知识点,以爬虫作为切入点,既可以掌握巩固 Python 知识,也可能在未来学习接触到更多其他方面的知识,比如分布式,多线程等等,何乐而不为呢!
下面我们介绍几个非常简单入门的爬虫项目,相信不会再出现那种直接劝退的现象啦!
【豆瓣】
豆瓣作为国民级网站,在爬虫方面也非常友好,几乎没有设置任何反爬措施,以此网站来练手实在是在适合不过了。
1、评论爬取
我们以如下地址为例子
https://movie.douban.com/subject/3878007/
可以看到这里需要进行翻页处理,通过观察发现,评论的URL如下:
https://movie.douban.com/subject/3878007/comments?start=0&limit=20&sort=new_score&status=P&percent_type=l
每次翻一页,start都会增长20,由此可以写代码如下
def get_praise():
    praise_list = []
    for i in range(0, 2000, 20):
        url = 'https://movie.douban.com/subject/3878007/comments?start=%s&limit=20&sort=new_score&status=P&percent_type=h' % str(i)
        req = requests.get(url).text
        content = BeautifulSoup(req, "html.parser")
        check_point = content.title.string
        if check_point != r"没有访问权限":
            comment = content.find_all("span", attrs={"class": "short"})
            for k in comment:
                praise_list.append(k.string)
        else:
            break
    return
使用range函数,步长设置为20,同时通过title等于“没有访问权限”来作为翻页的终点。
下面继续分析评论等级
豆瓣的评论是分为三个等级的,这里分别获取,方便后面的继续分析
def get_ordinary():
    ordinary_list = []
    for i in range(0, 2000, 20):
        url = 'https://movie.douban.com/subject/3878007/comments?start=%s&limit=20&sort=new_score&status=P&percent_type=m' % str(i)
        req = requests.get(url).text
        content = BeautifulSoup(req, "html.parser")
        check_point = content.title.string
        if check_point != r"没有访问权限":
            comment = content.find_all("span", attrs={"class": "short"})
            for k in comment:
                ordinary_list.append(k.string)
        else:
            break
    return

def get_lowest():
    lowest_list = []
    for i in range(0, 2000, 20):
        url = 'https://movie.douban.com/subject/3878007/comments?start=%s&limit=20&sort=new_score&status=P&percent_type=l' % str(i)
        req = requests.get(url).text
        content = BeautifulSoup(req, "html.parser")
        check_point = content.title.string
        if check_point != r"没有访问权限":
            comment = content.find_all("span", attrs={"class": "short"})
            for k in comment:
                lowest_list.append(k.string)
        else:
            break
    return
其实可以看到,这里的三段区别主要在请求URL那里,分别对应豆瓣的好评,一般和差评。
最后把得到的数据保存到文件里
if __name__ == "__main__":
    print("Get Praise Comment")
    praise_data = get_praise()
    print("Get Ordinary Comment")
    ordinary_data = get_ordinary()
    print("Get Lowest Comment")
    lowest_data = get_lowest()
    print("Save Praise Comment")
    praise_pd = pd.DataFrame(columns=['praise_comment'], data=praise_data)
    praise_pd.to_csv('praise.csv', encoding='utf-8')
    print("Save Ordinary Comment")
    ordinary_pd = pd.DataFrame(columns=['ordinary_comment'], data=ordinary_data)
    ordinary_pd.to_csv('ordinary.csv', encoding='utf-8')
    print("Save Lowest Comment")
    lowest_pd = pd.DataFrame(columns=['lowest_comment'], data=lowest_data)
    lowest_pd.to_csv('lowest.csv', encoding='utf-8')
    print("THE END!!!")
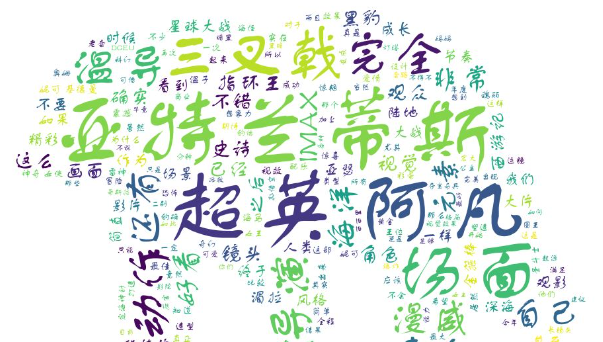
2、制作词云
这里使用jieba来分词,使用wordcloud库制作词云,还是分成三类,同时去掉了一些干扰词,比如“一部”、“一个”、“故事”和一些其他名词,操作都不是很难,直接上代码
import jieba
import pandas as pd
from wordcloud import WordCloud
import numpy as np
from PIL import Image

font = r'C:\Windows\Fonts\FZSTK.TTF'
STOPWORDS = set(map(str.strip, open('stopwords.txt').readlines()))


def wordcloud_praise():
    df = pd.read_csv('praise.csv', usecols=[1])
    df_list = df.values.tolist()
    comment_after = jieba.cut(str(df_list), cut_all=False)
    words = ' '.join(comment_after)
    img = Image.open('haiwang8.jpg')
    img_array = np.array(img)
    wc = WordCloud(width=2000, height=1800, background_color='white', font_path=font, mask=img_array, stopwords=STOPWORDS)
    wc.generate(words)
    wc.to_file('praise.png')


def wordcloud_ordinary():
    df = pd.read_csv('ordinary.csv', usecols=[1])
    df_list = df.values.tolist()
    comment_after = jieba.cut(str(df_list), cut_all=False)
    words = ' '.join(comment_after)
    img = Image.open('haiwang8.jpg')
    img_array = np.array(img)
    wc = WordCloud(width=2000, height=1800, background_color='white', font_path=font, mask=img_array, stopwords=STOPWORDS)
    wc.generate(words)
    wc.to_file('ordinary.png')


def wordcloud_lowest():
    df = pd.read_csv('lowest.csv', usecols=[1])
    df_list = df.values.tolist()
    comment_after = jieba.cut(str(df_list), cut_all=False)
    words = ' '.join(comment_after)
    img = Image.open('haiwang7.jpg')
    img_array = np.array(img)
    wc = WordCloud(width=2000, height=1800, background_color='white', font_path=font, mask=img_array, stopwords=STOPWORDS)
    wc.generate(words)
    wc.to_file('lowest.png')


if __name__ == "__main__":
    print("Save praise wordcloud")
    wordcloud_praise()
    print("Save ordinary wordcloud")
    wordcloud_ordinary()
    print("Save lowest wordcloud")
    wordcloud_lowest()
    print("THE END!!!")
3、海报爬取
对于海报的爬取,其实也十分类似,直接给出代码
import requests
import json


def deal_pic(url, name):
    pic = requests.get(url)
    with open(name + '.jpg', 'wb') as f:
        f.write(pic.content)


def get_poster():
    for i in range(0, 10000, 20):
        url = 'https://movie.douban.com/j/new_search_subjects?sort=U&range=0,10&tags=电影&start=%s&genres=爱情' % i
        req = requests.get(url).text
        req_dict = json.loads(req)
        for j in req_dict['data']:
            name = j['title']
            poster_url = j['cover']
            print(name, poster_url)
            deal_pic(poster_url, name)


if __name__ == "__main__":
    get_poster()
【烂番茄网站】
这是一个国外的电影影评网站,也比较适合新手练习,网址如下
https://www.rottentomatoes.com/tv/game_of_thrones
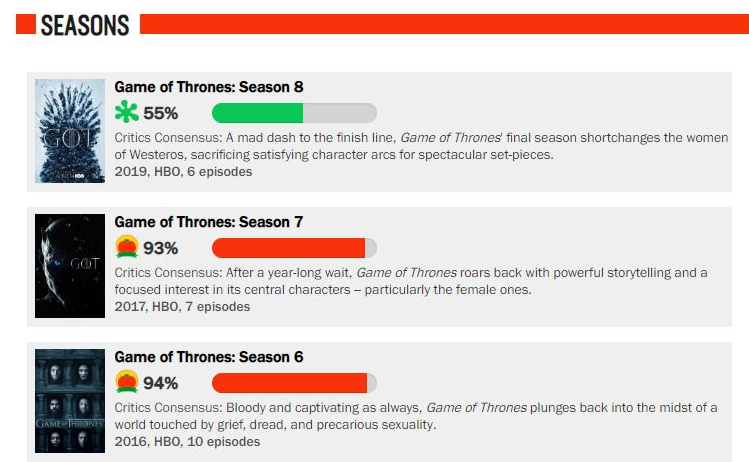
我们就以权力的游戏作为爬取例子
import requests
from bs4 import BeautifulSoup
from pyecharts.charts import Line
import pyecharts.options as opts
from wordcloud import WordCloud
import jieba


baseurl = 'https://www.rottentomatoes.com'


def get_total_season_content():
    url = 'https://www.rottentomatoes.com/tv/game_of_thrones'
    response = requests.get(url).text
    content = BeautifulSoup(response, "html.parser")
    season_list = []
    div_list = content.find_all('div', attrs={'class': 'bottom_divider media seasonItem '})
    for i in div_list:
        suburl = i.find('a')['href']
        season = i.find('a').text
        rotten = i.find('span', attrs={'class': 'meter-value'}).text
        consensus = i.find('div', attrs={'class': 'consensus'}).text.strip()
        season_list.append([season, suburl, rotten, consensus])
    return season_list


def get_season_content(url):
    # url = 'https://www.rottentomatoes.com/tv/game_of_thrones/s08#audience_reviews'
    response = requests.get(url).text
    content = BeautifulSoup(response, "html.parser")
    episode_list = []
    div_list = content.find_all('div', attrs={'class': 'bottom_divider'})
    for i in div_list:
        suburl = i.find('a')['href']
        fresh = i.find('span', attrs={'class': 'tMeterScore'}).text.strip()
        episode_list.append([suburl, fresh])
    return episode_list[:5]


mylist = [['/tv/game_of_thrones/s08/e01', '92%'],
          ['/tv/game_of_thrones/s08/e02', '88%'],
          ['/tv/game_of_thrones/s08/e03', '74%'],
          ['/tv/game_of_thrones/s08/e04', '58%'],
          ['/tv/game_of_thrones/s08/e05', '48%'],
          ['/tv/game_of_thrones/s08/e06', '49%']]


def get_episode_detail(episode):
    # episode = mylist
    e_list = []
    for i in episode:
        url = baseurl + i[0]
        # print(url)
        response = requests.get(url).text
        content = BeautifulSoup(response, "html.parser")
        critic_consensus = content.find('p', attrs={'class': 'critic_consensus superPageFontColor'}).text.strip().replace(' ', '').replace('\n', '')
        review_list_left = content.find_all('div', attrs={'class': 'quote_bubble top_critic pull-left cl '})
        review_list_right = content.find_all('div', attrs={'class': 'quote_bubble top_critic pull-right  '})
        review_list = []
        for i_left in review_list_left:
            left_review = i_left.find('div', attrs={'class': 'media-body'}).find('p').text.strip()
            review_list.append(left_review)
        for i_right in review_list_right:
            right_review = i_right.find('div', attrs={'class': 'media-body'}).find('p').text.strip()
            review_list.append(right_review)
        e_list.append([critic_consensus, review_list])
    print(e_list)


if __name__ == '__main__':
    total_season_content = get_total_season_content()
【王者英雄网站】
我这里选取的是如下网站
http://db.18183.com/
import requests
from bs4 import BeautifulSoup


def get_hero_url():
    print('start to get hero urls')
    url = 'http://db.18183.com/'
    url_list = []
    res = requests.get(url + 'wzry').text
    content = BeautifulSoup(res, "html.parser")
    ul = content.find('ul', attrs={'class': "mod-iconlist"})
    hero_url = ul.find_all('a')
    for i in hero_url:
        url_list.append(i['href'])
    print('finish get hero urls')
    return url_list


def get_details(url):
    print('start to get details')
    base_url = 'http://db.18183.com/'
    detail_list = []
    for i in url:
        # print(i)
        res = requests.get(base_url + i).text
        content = BeautifulSoup(res, "html.parser")
        name_box = content.find('div', attrs={'class': 'name-box'})
        name = name_box.h1.text
        hero_attr = content.find('div', attrs={'class': 'attr-list'})
        attr_star = hero_attr.find_all('span')
        survivability = attr_star[0]['class'][1].split('-')[1]
        attack_damage = attr_star[1]['class'][1].split('-')[1]
        skill_effect = attr_star[2]['class'][1].split('-')[1]
        getting_started = attr_star[3]['class'][1].split('-')[1]
        details = content.find('div', attrs={'class': 'otherinfo-datapanel'})
        # print(details)
        attrs = details.find_all('p')
        attr_list = []
        for attr in attrs:
            attr_list.append(attr.text.split(':')[1].strip())
        detail_list.append([name, survivability, attack_damage,
                            skill_effect, getting_started, attr_list])
    print('finish get details')
    return detail_list


def save_tocsv(details):
    print('start save to csv')
    with open('all_hero_init_attr_new.csv', 'w', encoding='gb18030') as f:
        f.write('英雄名字,生存能力,攻击伤害,技能效果,上手难度,最大生命,最大法力,物理攻击,'
                '法术攻击,物理防御,物理减伤率,法术防御,法术减伤率,移速,物理护甲穿透,法术护甲穿透,攻速加成,暴击几率,'
                '暴击效果,物理吸血,法术吸血,冷却缩减,攻击范围,韧性,生命回复,法力回复\n')
        for i in details:
            try:
                rowcsv = '{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{}'.format(
                    i[0], i[1], i[2], i[3], i[4], i[5][0], i[5][1], i[5][2], i[5][3], i[5][4], i[5][5],
                    i[5][6], i[5][7], i[5][8], i[5][9], i[5][10], i[5][11], i[5][12], i[5][13], i[5][14], i[5][15],
                    i[5][16], i[5][17], i[5][18], i[5][19], i[5][20]
                )
                f.write(rowcsv)
                f.write('\n')
            except:
                continue
    print('finish save to csv')


if __name__ == "__main__":
    get_hero_url()
    hero_url = get_hero_url()
    details = get_details(hero_url)
    save_tocsv(details)
好了,今天先分享这三个网站,咱们后面再慢慢分享更多好的练手网站与实战代码!
对于初学者想更轻松的学好Python开发,爬虫技术,Python数据分析,人工智能等技术,这里也给大家准备了一套系统学习资源
文中所展示的资料全部都是免费分享,点击下方链接添加微信即可免费获取!
戳这里 👉 【读者福利】Python经典学习资料免费分享,领走不谢! 👈
👉 1.确定好自己的学习路线 👈
无论做什么事,或者学什么技能,在一开始就要有所规划,所以我们要事先确定好自己的学习路线,这是非常重要的,能够在我们学习的时候使得我们的思路更为清晰。

👉 2.Python必备开发工具 👈
工欲善其事必先利其器,既然我们要学习Python,那么想与之的开发工具必须要先行安装好,利用好工具能让我们事半功倍。

👉 3、Python学习视频合集 👈
观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

👉 4.实战案例 👈
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉 5.一百道Python练习题 👈
学而不练则罔,练而不学则殆,检查学习结果,是优秀人员必备的。

👉 资料领取 👈
文中所展示的资料全部都是免费分享,点击下方链接添加微信即可免费获取!
戳这里 👉 【读者福利】Python经典学习资料免费分享,领走不谢! 👈
关注我!长期更新分享Python等编程技术干货~
 2214


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


