决策树与信息熵,信息增益

机器学习笔记之信息熵、信息增益和决策树(ID3算法) 阅读详情

信息熵(entropy)

作用

描述不确定性的大小,值越小越确定,值越大越不确定

历史

香农提出了 ”信息熵“的概念
在这里插入图片描述

举例

1: 太阳明天从东边升起(确定的,信息熵小)
2: 明天可能会遇见月食(具有不确定性,信息熵大)

公式

假设有K 个信息集
组成样本集合D
记录第K个信息发生的概率为,(所有Pk 累加起来和为1)
Pk(1≤k≤K)P_k (1 \leq k \leq K)Pk​(1≤k≤K)

这个K个信息的信息熵公式,E(D) 的值越小,表示信息越确定,D的纯度越高:
E(D)=−∑k=1KPklog⁡2Pk E(D) = -\sum_{k=1}^{K}P_k \log_{2}P_k E(D)=−k=1∑K​Pk​log2​Pk​

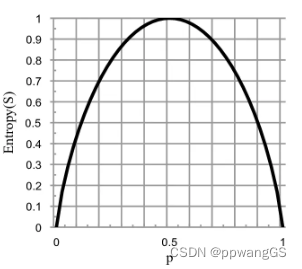
描绘函数曲线图,所有Pk 累加起来和为1,当只有两个信息时,信息熵随概率变化的曲线如图所示:
在这里插入图片描述

信息增益

作用

用来描述分类后不确定性 减少的程度,可以作为决策树选择分类条件的依据

公式

Gain(D,A)=E(D)−∑i=1n∣Di∣∣D∣⋅E(Di)\text{Gain(D,A)} = \text{E}(D) - \sum_{i=1}^{n} \frac{|D_i|}{|D|} \cdot \text{E}(D_i) Gain(D,A)=E(D)−i=1∑n​∣D∣∣Di​∣​⋅E(Di​)

例子

原始数据:
在这里插入图片描述
步骤一:求解分类前,是否去游乐场的信息熵
9人去游乐场,5人不去游乐场,依据信息熵公式求解如下:
−(914∗log2914+514∗log2514)=0.94 -(\frac{{9}}{{14}} * log_2 \frac{{9}}{{14}} + \frac{{5}}{{14}}* log_2 \frac{{5}}{{14}} )= 0.94 −(149​∗log2​149​+145​∗log2​145​)=0.94
步骤二:求解按照天气分类后,是否去游乐场的信息熵
晴去游乐场
晴天2人去游乐场,3人不去游乐场,晴天去游乐场的信息熵求解如下
−(25∗log225+35∗log235)=0.971 -(\frac{{2}}{{5}} * log_2 \frac{{2}}{{5}} + \frac{{3}}{{5}}* log_2 \frac{{3}}{{5}} ) = 0.971 −(52​∗log2​52​+53​∗log2​53​)=0.971
多云去游乐场
多云4人去游乐场,0人不去游乐场,多云去游乐场的信息熵求解如下
−(44∗log244)=0 -(\frac{{4}}{{4}} * log_2 \frac{{4}}{{4}} ) = 0 −(44​∗log2​44​)=0
雨云去游乐场
雨天3人去游乐场,2人不去游乐场,雨天去游乐场的信息熵求解如下
−(35∗log235+25∗log225)=0.971 -(\frac{{3}}{{5}} * log_2 \frac{{3}}{{5}} + \frac{{2}}{{5}}* log_2 \frac{{2}}{{5}} ) = 0.971 −(53​∗log2​53​+52​∗log2​52​)=0.971
步骤三:求解分类后对比分类前的信息增益
其中 A = ”天气状况“,于是按照天气状况归类后的信息增益为
Gain(D,A)=E(D)−∑i=1n∣Di∣∣D∣⋅E(Di) \text{Gain(D,A)} = \text{E}(D) - \sum_{i=1}^{n} \frac{|D_i|}{|D|} \cdot \text{E}(D_i) Gain(D,A)=E(D)−i=1∑n​∣D∣∣Di​∣​⋅E(Di​)
0.940−(514∗0.971+414∗0+514∗0.971)=0.246 0.940-(\frac{{5}}{{14}} *0.971 + \frac{{4}}{{14}}* 0 + \frac{{5}}{{14}} *0.971) = 0.246 0.940−(145​∗0.971+144​∗0+145​∗0.971)=0.246

结论:
按照天气划分后,信息增益为0.246,降低了信息不确定性
在这里插入图片描述

决策树何选择根节点?

重复上面步骤二,步骤三的操作,对原始数据按照温度,湿度,是否有风进行归类,分别计算其对应的信息增益如下,可以看出按照天气归类,信息增益(0.24)最大,所以应该选择天气作为根节点。
天气:0.24
温度:0
湿度: 0.045
是否有风: 0.048
在这里插入图片描述
在这里插入图片描述

决策树,信息熵,信息增益计算----机器学习 决策树(decision tree)决策树简单介绍信息量信息熵信息增益 决策树简单介绍 决策树是一种基于树状结构来做决策的。是一种常见的机器学习方法。主要做分类,也可以做回归。一棵决策树含有一个根结点(样本全集),若干个内部结点和若干个叶结点(最终结论)。 简单的一个例子。比如我们相亲的时候,老母亲甩出来一沓照片来让你做选择。这时候我们会问一些问题来做一下筛选,比如对方的年龄,相貌,工作收入,家庭住址等等等,然后最终确定选择两个或三个人去见。 这一系列问题和层层的筛选判断就是在做决策,这些问题为“子决策”。 阅读详情

相关推荐

决策树模型及案例(Python)

目录 1 决策树模型简介 2 Gini系数(CART决策树) 3信息熵、信息增益 4决策树模型代码实现 4.1分类决策树模型(DecisionTreeClassifier) 4.2回归决策树模型(DecisionTreeRegressor) 5案例:员工离职预测模型 5.1模型搭建 5.1.1数据读取与预处理 5.1.2提取特征变量和目标变量 5.1.3划分训练集与测试集 5.1.4模型搭建及训练 5.1.5代码汇总 5.2模型预测及评估 5.2.1直...

qq_42433311的博客 9万+

决策树(信息熵、增益率、基尼指数)

目录 前言 一、决策树是什么? 二、实验过程 1.选择数据集中各个决策属性的优先级 1.1信息熵 1.2增益率 1.3基尼指数 2.决策树的构造 2.1创建决策树: 2.2准备数据: 2.3.读取和保存决策树: 2.4绘制决策树: 3运行结果: 3.1利用信息熵进行构造 3.2利用增益率进行构造决策树: 3.3利用基尼指数进行构造决策树: 总结 前言 决策树(Decision Tree)是一种简单但是广泛使用的分类器。通过训练数据构建决策树,..

qq_48864962的博客 9783

决策树:介绍信息熵-信息增益-决策树信息增益法构造决策树

熵 什么是熵 熵,表示事物的不确定性 信息,可以消除不确定性的事物 看见某些特定的情况下,某些后果的成功率就变高了 看见某些特定的情况下,某些干扰就消除了 噪音,白白让人浪费注意力的东西,完全没用 信息熵的公式 是怎么推倒出来的 此处参考 “致敬大神”里啃西瓜书的B站视频 个人感觉讲的极好 首先先声明信息熵公式Ent(D)=−∑k=0∣y∣pklog2pkEnt(D) = -\sum_{k=0}^{{\mid}y{\mid}}p_k{log_2}p_kEnt(D)=−∑k=0∣y∣​pk​log

weixin_44391984的博客 410

机器学习:决策树之信息熵、信息增益、信息增益率、基尼指数分析

信息熵 信息理论 从信息的完整性描述:当系统的有序状态一致时,数据越集中的地方熵值越小,数据越分散的地方熵值越大。 从信息的有序性描述:当数据量一致时,系统越有序,熵值越低;系统越混乱或者分散,熵值越高。 “信息熵” (information entropy)是度量样本集合纯度最常用的一种指标。 信息熵理解 信息熵是一个变量包含信息多少的度量方式 信息熵的值越大,则认为该变量包含的信息量就大 信息熵越大,表示包含的信息种类就越多,信息量就越大,信息越混乱分散,纯度就越低 信息熵只和包含的信息种类

m0_58475958的博客 1万+

白话详解决策树模型之使用信息熵构建决策树

信息是一个很抽象的概念,假设我们以一篇文章为例,文章的信息量的多少并不完全取决于这篇文章中文字字数的多少,有时候即使很少的内容也可以蕴含很大的信息量。划分方式2以“收入<10000元”为根节点进行划分,如下图所示,划分后的信息熵为0.924,信息增益为0.046,计算过程如下。划分方式1以“满意度<5”为根节点进行划分,如下图所示,划分后的信息熵为0.65,信息增益为0.32,计算过程如下。回到我们的决策树构建过程中,如果以信息熵为度量,我们选取某一特征进行分裂的原则,就是要在划分前后,...

白话机器学习 1248

【ESP32 S3 开发】基于I2S协议驱动INMP441数字麦克风 实现语音采集

注意INMP441的 L/R接地之后才稳定输出数据 否则一直都是0WAV格式说明这里主要是想说wav文件重要的就是生成一个wavhead来标识它是一个wave文件,wave文件的data chunk 中的data部分还是PCM编码格式的数据,直接从I2S读进去就可以,不需要压缩。wav文件的头一般由4个chunk组成。 以16bit深度为例,代码如下。其他深度可以根据注释自行计算。 I2S -> DAC i2s_read()函数,向flash中划分的一个buff当中读入byte数组。以16bit深度为例,一

m0_43395703的博客 1万+

机器学习(决策树一)——最直白的话来说信息熵

接下来几篇博客介绍决策树,并且尽量用最直白的话来讲解。本篇博客介绍决策树中比较重要的一个概念——信息熵。

张连海 7058

大麦网抢票协议逆向分析:从Web安全到高并发风控实战

在当今高并发Web应用场景下,理解网络协议交互与反爬虫机制是后端开发和系统架构设计的核心技能。其基本原理涉及客户端与服务器之间通过HTTP/HTTPS协议进行数据交换,关键环节包括请求参数构造、身份认证与会话管理。这一技术的核心价值在于保障系统安全与公平性,通过动态令牌、签名算法及设备指纹等多重手段,有效抵御自动化脚本攻击。典型应用场景包括票务系统、电商秒杀等需要严格管控资源访问的高并发业务。本文以热门票务平台为例,深入剖析其**请求链与令牌体系**及**行为生物特征分析**等风控策略,通过实战演示协议逆向

weixin_34354173的博客 454

决策树——信息熵与信息增益

参考:[https://www.cnblogs.com/YouXiangLiThon/p/7214393.html] 信息熵(Entropy):度量信息的不确定度,熵越大,不确定度越高,在分类中类别越多,也就说包含的信息越多。 计算方法:X表示某个分类,P(x)选择该分类的概率。H(X)所有类别之和 例如:天气预报的例子, 在14天中,play=no的事件为5,paly=Yes的事件为9.分类之...

weixin_43826596的博客 3362

stm32f103运行FreeRTOS使用DMA实现USART1不定长接收

使用DMA是实现USART1的不定长接收和发送数据。接收采用FIFO缓存和队列的方式向应用层抛数据。首先定义接收和发送的缓存区,缓存区的大小根据收发数据量确定。DMA接收开启转移完成和转移一般中断。在中断中从缓存向FIFO转移数据。串口开启空闲中断,实现接收数据的分帧。分帧后的数据节点通过写入到队列。发送数据缓存的大小根据发送数据量调整。然后初始化串口和DMA。串口的发送数据接口函数。...

polaris_zgx的博客 1991

细聊Oracle通过ODBC数据源连接SQL Server数据库

    类似文章搜索引擎上有很多,内容大致相同,今天所谓细聊是因为我在借鉴这些文章时候走了些弯路,所以写此文,为自己备忘,同时如果能为初涉此处知识点的小伙伴提供些帮助就更好了,废话不多说。    我的应用场景:    项目系统使用oracle数据库,与客户的第三方系统供应商实现资源共享,对方为sql server数据库;    我的测试开发环境为64bitwin7PC机,本机上装有64位Oracl...

xueren_83的博客 1万+

决策树①——信息熵&信息增益&基尼系数

本文主要内容: ① 大白话解释何为 信息,信息熵,信息增益,信息增益率,基尼系数 ② 介绍决策树3种算法(ID3,C4.5,CART)的原理及区别 一、基础概念 ① 信息 能消除不确定性的内容才能叫信息,而告诉你一个想都不用想的事实,那不叫信息。 比如数据分析师的工作经常是要用数据中发现信息,有一天上班你告诉老大从数据中发现我们的用户性别有男有女。。。(这不废话吗?)这不叫信息,但是如果你告诉老大...

cindy407的博客 1万+

matlab物元可拓模型程序,熵权可拓物元模型

1 概述物元分析方法是中国学者蔡文于20世纪80年代提出的用于解决矛盾问题的技术方法,是研究物元及其变化规律,解决现实世界中不相容问题的有效方法,可应用于生态环境,水资源承载力,农用地分级和土地生态水平等综合评价研究中.本文主要介绍了熵权可拓物元模型的相关概念与该模型的建立过程.2 概念2.1 物元物元分析法的主要思想是把事物用"事物,特征,量值"(分别用N,C,V表示)3个要素以有序三元组的形式...

weixin_33823399的博客 4118

ID3决策树、信息熵、信息增益

本文所用的例子引自《机器学习》,周志华。 ID3决策树 ID3中的ID,是Iterative Dichotomiser的简称。 ID3是一种经典的基于信息增益的决策树学习算法。 信息熵 信息熵是度量样本集合纯度最常用的一种指标。假定当前样本集合DDD中第kkk类样本所占的比例为pk(k=1,2,…,∣Y∣)p_k(k=1,2, \ldots,|\mathcal{Y}|)pk​(k=1,2,…,∣Y∣),则DDD的信息熵被定义为: Ent⁡(D)=−∑k=1∣Y∣pklog⁡2pk \operatorna.

Codefmeister's BLOG 3377

使用 Simulink/Simscape Electrical/Stateflow,构建一个并网逆变器短路故障动态响应与恢复策略仿真模型

本文基于Simulink平台,详细介绍了并网逆变器短路故障的动态响应与恢复策略仿真方法。主要内容包括:1)构建包含热模型的高精度逆变器模型;2)模拟IGBT击穿和桥臂直通两种短路故障;3)设计基于Stateflow的微秒级快速保护逻辑;4)实现放电、去磁、自检、重启的完整恢复流程。仿真结果表明,所提出的保护方案能在200μs内有效限制故障电流,避免器件永久损坏,并通过标准化恢复流程实现系统安全重启。文章还探讨了硬件保护协同、多级保护和预测保护等高级策略,为电力电子系统安全防护提供了实用解决方案。

xiaoheshang_123的博客 107

【TCAD】AlGaN 器件的Sentaurus仿真

否则,必须在 LatticeParameters Sentaurus Device 的参数文件中的部分。Sentaurus Device 有两个工具实例:第一个工具实例, sd_fdiv ,模拟正向偏置特性,第二个工具实例, sd_rviv ,模拟反向偏置特性直至击穿。对于牛顿求解器,通常应该将非线性迭代次数限制为一个足够小的值,例如 Iterations=20 ,同时通过指定非阻尼迭代次数高于允许的牛顿迭代次数来避免解的阻尼( NotDamped=30 )。晶胞中的 Ga-N 键为橙色。

荷塘阅色 1215

信息熵、信息增益以及决策树

什么是信息熵? 信息熵是信息论的范畴,利用概率论和统计的方法,因此信息熵也被称为基于概率分布的信息熵。在介绍信息熵概念之前,先介绍一个基本的概念:区分能力。所谓区分能力是指把对象划分到具体分组的能力,比如金庸武侠小说里的英雄人物,每一个武侠人物都是性别、智商、情商、侠义、个性5个属性,如何根据这个5个属性来区分不同的武侠人物。如果某个属性可以将被测试的人物尽可能分到相应的组,那么可以认为这个问题的区分能力强。 我们看性别和智商两个属性。 图片来源:极客时间程序员的数学基础课 我们看性别属性

lilinfei001的博客 2541

【TC3xx芯片】TC3xx芯片PFlash的ECC校验问题补充

TC3xx芯片PFlash的ECC校验问题补充

qq_36056498的博客 1153

决策树分类算法(一)(信息熵,信息增益,基尼指数计算)

决策树分类算法(一)(信息熵,信息增益,基尼指数计算)

weixin_46028606的博客 6035

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

信息熵与信息增益在决策树生成中的使用

香农熵,信息增益概念和公式整理,以及根据信息增益求出最合适的根节点。

feinifi的博客 1663

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

决策树介绍(一)信息熵和信息增益

信息熵和信息增益   对决策树有过初步了解的人对决策树应该有个初步概念,决策树就是将各种属性根据在当前条件下,计算出划分结果最有利的属性,并将该属性做为划分属性,以此类推,直到所有的属性都划分完毕。其中如何确定该属性对于划分结果是最有利?这个需要用到信息熵的概念,即通过计算条件熵H(Y|X)(表示在已知随机变量X的条件下随机变量Y的不确定性),选择不确定性最低的属性做为最优划分属性。 信息熵概念 ...

liaoyaonline的博客 1445

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

决策树、ID3决策树(信息熵、信息增益)

决策树 (Decision Tree) 是一种​​树形结构的预测模型​​,它代表的是对象属性与对象值之间的一种映射关系。决策树通过学习数据特征,构建一套层次化的“判断-分支”规则,最终在叶子节点给出预测结果(每个叶子节点代表一种分类结果)。根节点 (Root Node)​​:代表整个数据集的起始点,包含所有样本。内部节点 (Internal Node)​​:对应特征或属性上的判断条件,每个判断会产生分支。叶节点 (Leaf Node)​​:代表决策的最终结果,即分类的类别或回归的预测值。

pan13360344415的博客 1802

C2-4.2.2 决策树-纯度+信息熵+信息增益

【※※※总结】:信息熵是用来衡量 给出的数据集中 数据的纯度的信息熵越小,数据就越纯。通常用在机器学习分类的情况下3.2 信息熵公式。

weixin_46228946的博客 2255

机器学习傻瓜书决策树之信息熵和信息增益 增益率理解

先给出结论:利用信息增益的目的是为了生成最优决策树,方便在测试集预测首先给出书上信息熵的数学定义:举一个通俗例子理解这个公式 接下来理解信息增益书上公式 光看公式很难理解 但是其实并没有新的数学概念知识(理解公式的目的是获取其现实意义和其现实逻辑)先给出结论:信息增益其实就是系统经过特征选择后(比如该例选择色泽为特征),过度为下个子系统,子系统与上一个系统的信息熵差值的一个量度,当然越大,说明系统不确定性坍缩的越厉害,这正是我们想要的。毕竟信息熵坍缩为0,就能确定做出抉择了。类比:速度,速度差,加速度对

qq_44386182的博客 835
上一篇: 贝叶斯分析
下一篇: 小白也能看懂的线性回归
ppwangGS
博客等级 码龄11年 58粉丝 14原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
