简单使用Vanna

VannaAI 介绍及使用 - 第三篇 前面两篇,对Vanna的一些原理和基本使用进行的总结,本篇将根据Vanna提供的多样化配置进行体验尝试,并共同来探索一下Vanna源码,有不正之处请友友们指正。先做一些说明:1.我本地目前使用的是 python3.12版本,Vanna是0.5.5版本,不同版本的包可能源码会有些许区别,但主体是一致的。2.因为Vanna默认是使用chatGPT3.5,我自己本地测试连接其他LLM是通过代理服务实现的,有条件的可以自己部署大模型尝试,本文仅作为自主体验的记录,仅供参考。 阅读详情

简单使用Vanna

1 安装依赖环境

⚠️ 表结构等信息,请参考见“https://blog.youkuaiyun.com/make_progress/article/details/151905155”

安装依赖

pip install vanna
pip install PyMySQL
pip install cryptography
pip install vanna[chromadb,openai,bigquery]

2 构建模型

2.1 自定义CustomVanna

from abc import ABC

from openai import OpenAI
from vanna.base import VannaBase
from vanna.chromadb import ChromaDB_VectorStore


class CustomLLM(VannaBase, ABC):
    """
    自定义虚拟基类大模型
    """

    def __init__(self, config=None):
        # 调用超类
        super().__init__(config)

        if config is None:
            raise ValueError(
                "For LLM, config must be provided with an api_key and model"
            )

        if "base_url" not in config:
            raise ValueError("config must contain a LLM base_url")

        if "api_key" not in config:
            raise ValueError("config must contain a LLM api_key")

        if "model" not in config:
            raise ValueError("config must contain a LLM model")

        # 模型基本信息
        base_url = config["base_url"]
        api_key = config["api_key"]
        model = config["model"]

        # 构建客户端
        self.client = OpenAI(base_url=base_url, api_key=api_key)
        self.model = model

    def system_message(self, message: str) -> any:
        return {"role": "system", "content": message}

    def user_message(self, message: str) -> any:
        return {"role": "user", "content": message}

    def assistant_message(self, message: str) -> any:
        return {"role": "assistant", "content": message}

    def generate_sql(self, question: str, **kwargs) -> str:
        # 调用超类生成sql
        sql = super().generate_sql(question, **kwargs)

        # 用 "_" 替换 "\_"
        sql = sql.replace("\\_", "_")

        return sql

    def submit_prompt(self, prompt, **kwargs) -> str:
        chat_response = self.client.chat.completions.create(
            model=self.model,
            messages=prompt,
        )

        return chat_response.choices[0].message.content


# 继承虚拟基类
class CustomVanna(ChromaDB_VectorStore, CustomLLM):
    def __init__(self, config=None):
        # 注意会使用向量,模型默认是 all-MiniLM-L6-v2
        ChromaDB_VectorStore.__init__(self, config=config)
        CustomLLM.__init__(self, config=config)


# 构建自定义Vanna
vn = CustomVanna(config={
    "base_url": "https://api.moonshot.cn/v1",
    "api_key": "XXXX",
    "model": "kimi-k2-0905-preview"
})

2.2 使用自定义的Vanna

from vanna.flask import VannaFlaskApp

from my.custom_vanna import vn


# 1 连接MySQL数据库
vn.connect_to_mysql(host="192.168.108.147", port=3306, dbname="company_salary", user="root",password="123456")


# 2 训练数据
"""
# 此注释的内容可以不要
# 获取数据的属性信息
df_information_schema = vn.run_sql("SELECT * FROM INFORMATION_SCHEMA.COLUMNS")

# 把信息模式分解为LLM可以引用的小块
plan = vn.get_training_plan_generic(df_information_schema)
vn.train(plan=plan)
"""

# 添加表结构schema
vn.train(ddl="""
    CREATE TABLE salary_records (
        id INT AUTO_INCREMENT PRIMARY KEY COMMENT '主键自增ID',
        employee_id VARCHAR(10) NOT NULL COMMENT '员工编号唯一标识员工',
        name VARCHAR(50) NOT NULL COMMENT '员工姓名',
        department VARCHAR(50) COMMENT '所属部门如技术部、人事部等',
        position VARCHAR(50) COMMENT '职位名称',
        base_salary DECIMAL(10,2) DEFAULT 0.00 COMMENT '基本工资税前基础薪资',
        bonus DECIMAL(10,2) DEFAULT 0.00 COMMENT '奖金、绩效或项目奖励',
        deductions DECIMAL(10,2) DEFAULT 0.00 COMMENT '扣款含社保、公积金、个税等',
        net_salary DECIMAL(10,2) AS (base_salary + bonus - deductions) STORED COMMENT '实发工资自动计算字段',
        pay_date DATE COMMENT '发薪日期通常为每月固定日期',
        created_at DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '记录创建时间'
    ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='员工工资记录表存储每位员工的月度工资明细'
""")

# 训练数据说明
vn.train(documentation="数据中包括员工名称、部门名称、职位名称、基本工资等信息")
vn.train(documentation="统计员工的基本工资、奖金等")

# 将示例SQL查询添加到训练数据中,越多越好
vn.train(question="查询单个用户信息", sql="SELECT * FROM salary_records WHERE name = '张伟'")
vn.train(question="统计不同部门人数", sql="SELECT department AS department_name, COUNT(*) AS employee_count FROM salary_records GROUP BY department ORDER BY employee_count DESC;")
vn.train(question="统计不同岗位的金额", sql="SELECT position AS job_position, COUNT(*) AS employee_count, SUM(net_salary) AS total_net_salary, AVG(net_salary) AS average_net_salary, MIN(net_salary) AS min_net_salary, MAX(net_salary) AS max_net_salary FROM salary_records GROUP BY position ORDER BY average_net_salary DESC;")

# 调用问题,visualize=True会使用的token数量
data = vn.ask(question="查询单个用户信息", visualize=False)
# 返回的数据信息是个元组
print(data)

# 用于启动可视化页面,根据自己的情况可以不要
VannaFlaskApp(vn).run()

3 使用截图

⚠️ 有的时候加载不出来下面的页面,关闭网络,再重新打开,就可以了。

(1)简单使用

查询用户孙浩信息
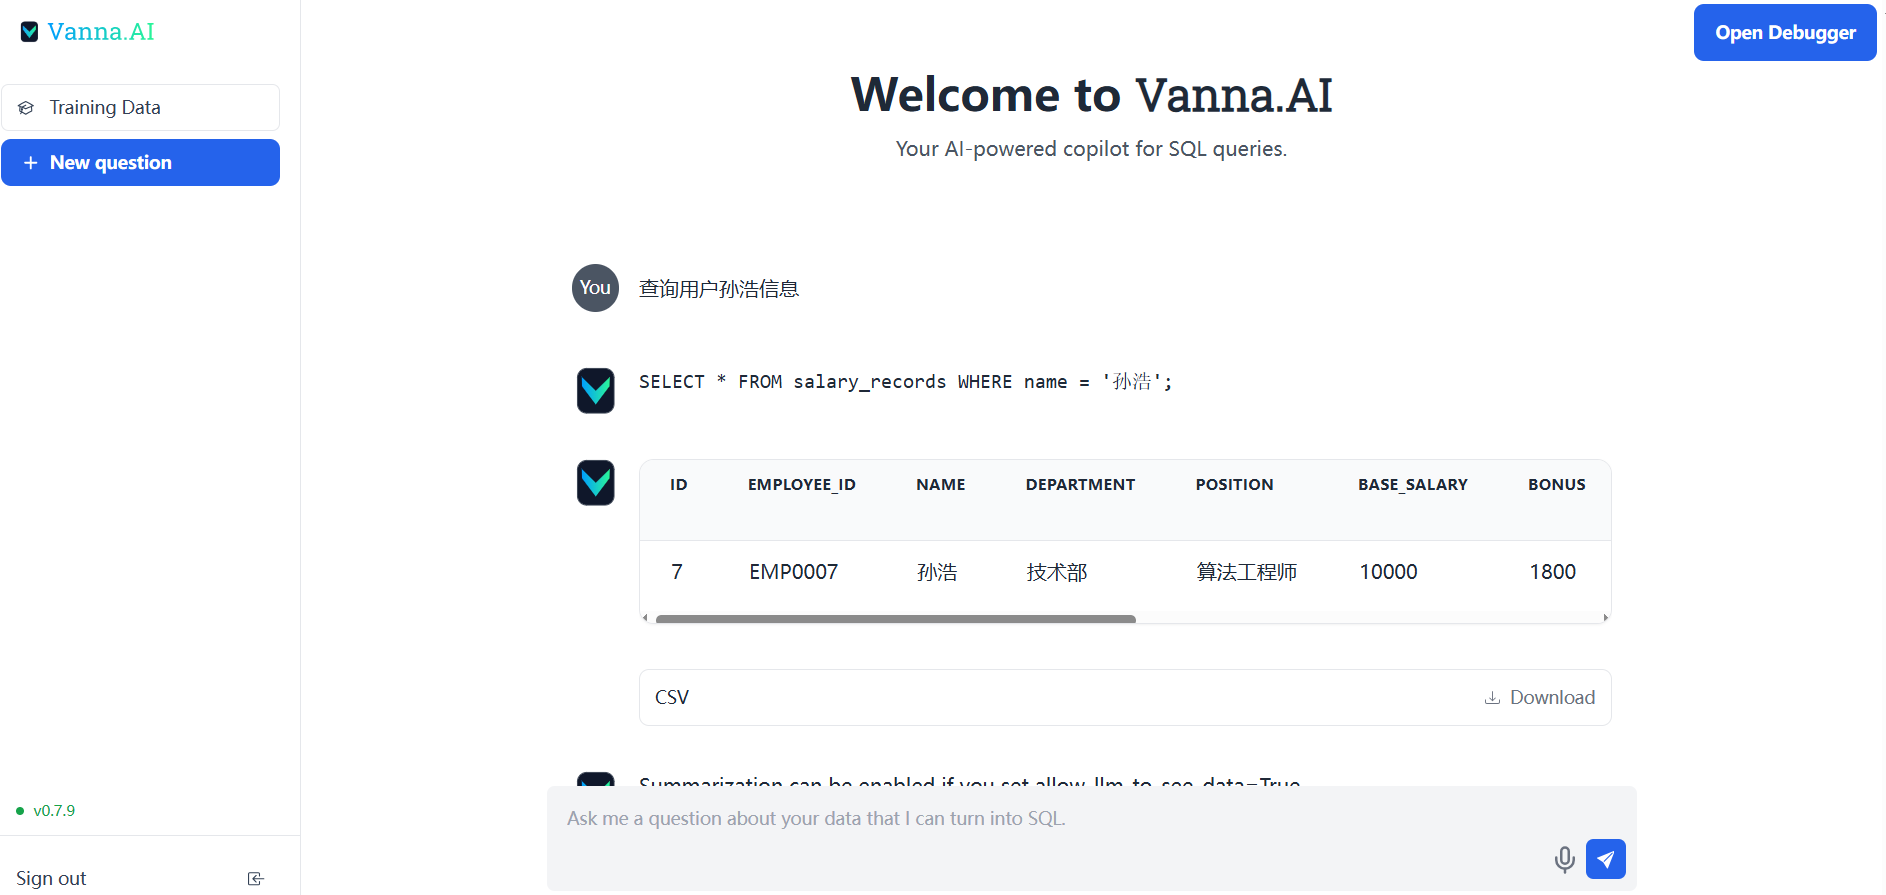
在这里插入图片描述

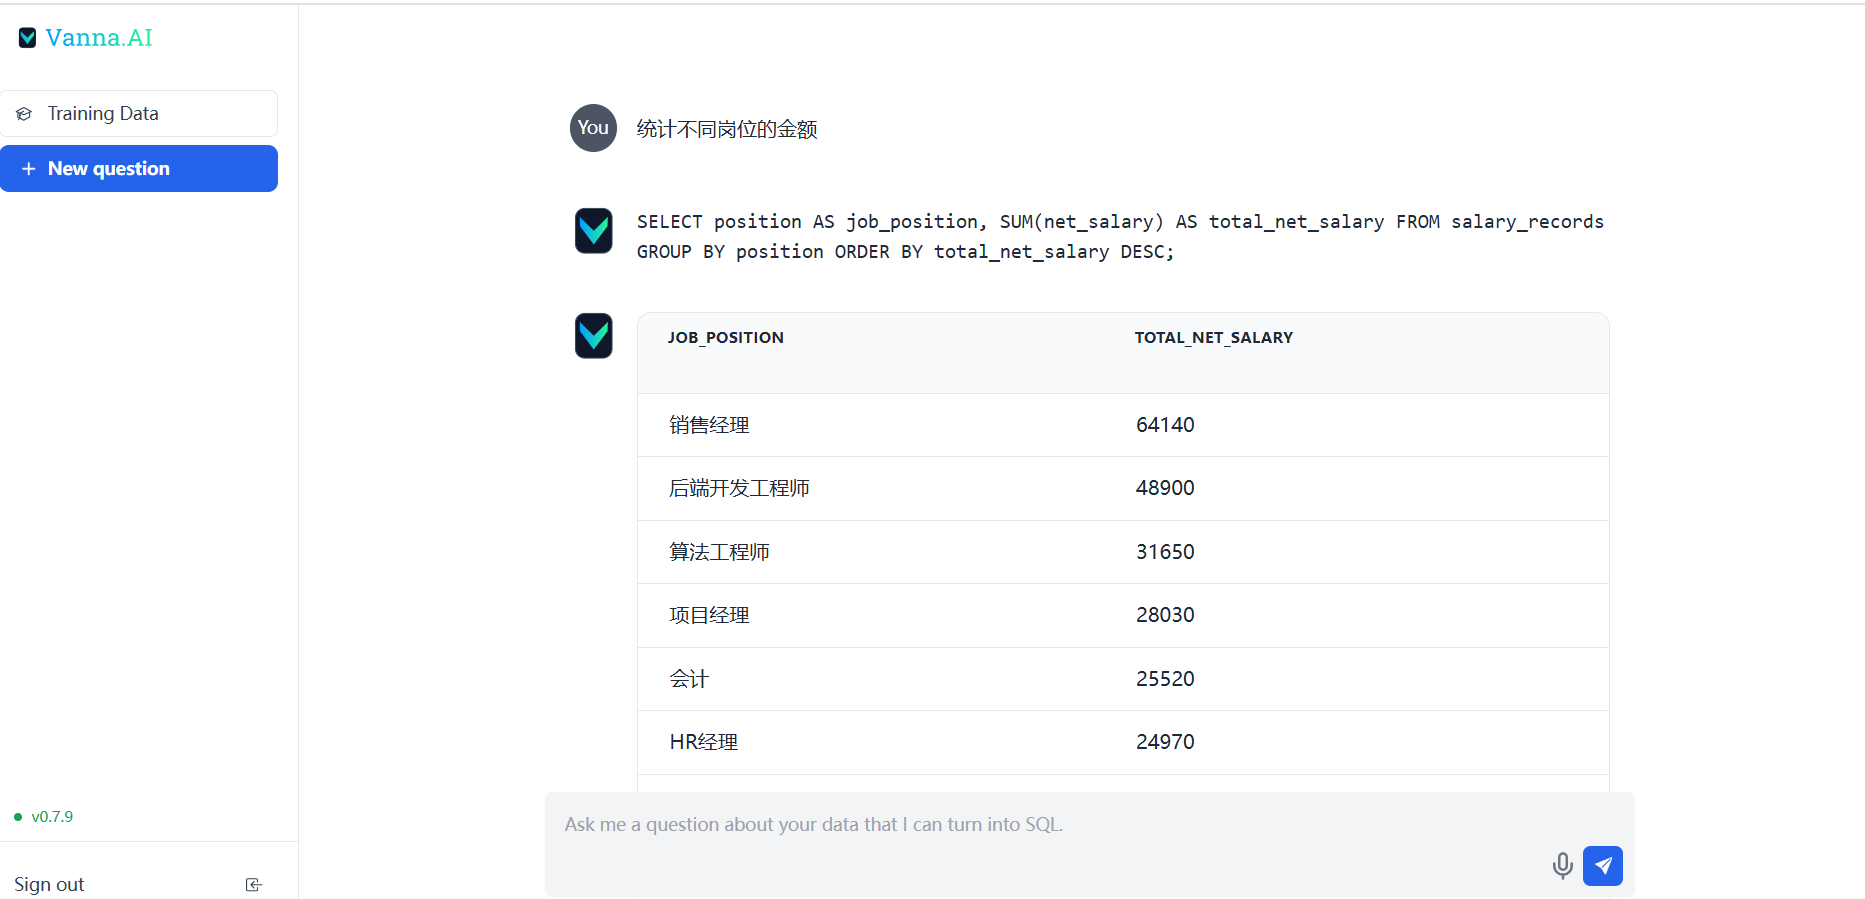
统计不同岗位的金额
在这里插入图片描述

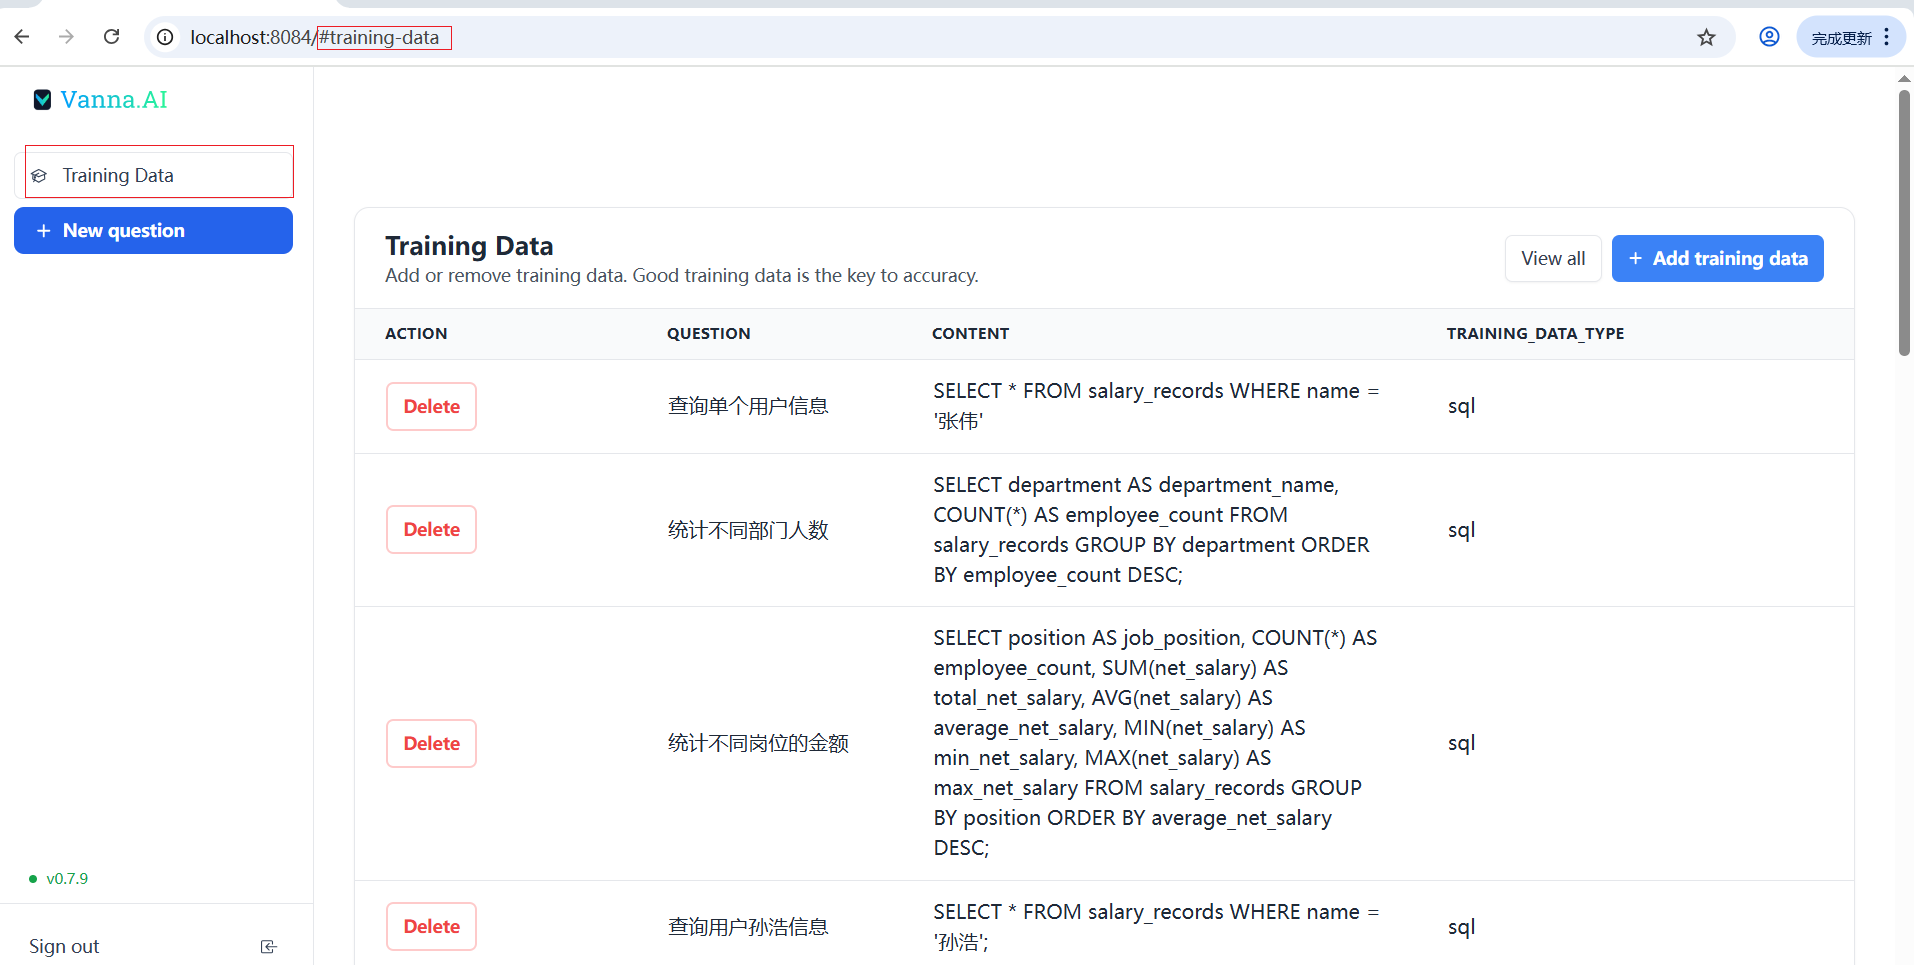
(2)查看Training Data

在这里插入图片描述

VannaAI 介绍及使用 - 第二篇 以上是在本地初步体验Vanna的几种方式,根据个人情况可以去一一尝试。Vanna还提供了个性化的配置,比如不同的向量数据库,LLM大模型以及不同的数据库。我将在第三篇内容中,用案例去展示如何个性化的配置Vanna,体验不同大模型进行问题回答。 阅读详情

相关推荐

TEXT2SQL工具vanna本地化安装和应用

在待连接的mysql数据库的,demodb数据库中新建表和记录,当然可以在不同数据库里面创建表,并插入不同的数据,根据实际情况可以调整SQL,并调整后续步骤的python代码中连接数据库的内容。这里的脚本chroma使用的local的模型,运行了以下脚本后,会在运行的目录下生成chroma.sqlite3文件,存放训练的数据,别删了,删了那训练数据就没了,要重新来。这里使用的是centos7 ,并有一块11G显存的GeForce GTX 1080 Ti,本文编制的时候,使用的是vanna 0.5.4版本。

wengad的博客 1万+

vanna-ai 私有化部署使用实战

基于RAG的text2sql 解决方案vanna私有化部署和使用实践

wu_tech的博客 7605

解密Vanna的RAG魔法:为什么简单的三明治架构能颠覆Text2SQL?

本文深入解析了Vanna框架如何通过三明治架构的RAG设计颠覆Text2SQL领域。Vanna结合底层向量库、中间检索层和上层生成层,实现了高效的自然语言到SQL查询转换,显著提升数据库查询的准确性和可解释性。其独特的动态Prompt工程和闭环学习系统使系统持续进化,特别适合企业级应用场景。

weixin_29057695的博客 686

MySQL 数据库增强工具 Vanna 使用示例:通过 Vanna 将自然语言转换为 SQL 查询

以下是在数据库中的使用示例。演示如何通过 Vanna 将自然语言转换为 SQL 查询,并在 MySQL 数据库中执行。

学亮编程手记 1146

Vanna:开源 AI 检索生成框架,自动生成精确的 SQL 查询

Vanna 是一个开源的 Python RAG(Retrieval-Augmented Generation)框架,能够基于大型语言模型(LLMs)为数据库生成精确的 SQL 查询。Vanna 支持多种 LLMs、向量数据库和 SQL 数据库,提供高准确性查询,同时确保数据库内容安全私密,不外泄。

士多啤梨先生の博客 3107

Unity URP 深度解析:利用Stencil与RenderFeature实现高效遮挡高亮

本文深入解析Unity URP中利用Stencil与RenderFeature实现高效遮挡高亮的技术方案。通过模板缓冲机制和自定义RenderFeature,开发者可以在保持场景完整性的同时,清晰标识被遮挡物体位置,提升游戏体验。文章详细介绍了Shader编写、URP管线配置及性能优化技巧,并提供了常见问题排查方法。

weixin_29012677的博客 478

text2sql框架-vanna使用总结

ChromaDB_VectorStore、MyCustomLLM、MyVanna 类都通过 config 接收使用的配置参数在创建 MyVanna 类时,可通过 config 传递配置参数MODEL_URL = "模型接口的 URL,http://xxx"MODEL = "模型名称"API_KEY = "模型提供的 API KEY"CHROMADB_PATH = "保存 ChromaDB 数据库文件的目录路径"

adrninistrat0r的博客 6651

SAP-ABAP:SAP客户端管理核心事务码SCC4深度解析

SAP客户端管理核心事务码SCC4深度解析

baidu_35680696的博客 1568

告别SQL门槛:Vanna四大界面全攻略,让数据查询像聊天一样简单

你是否还在为编写SQL查询而头疼?是否希望非技术人员也能轻松获取数据库见解?Vanna——这款AI驱动的SQL生成工具,通过Jupyter、Streamlit、Flask和Slackbot四大界面,让文本到SQL的转换变得前所未有的简单。本文将带你一站式掌握所有集成方案,无需复杂代码,即可快速搭建属于你的AI查询助手。 ## 为什么选择Vanna? Vanna是一个基于RAG(检索增强生成)技...

gitblog_00668的博客 535

STM32F103跑LVGL,用DMA加速刷屏,800*480大屏也能丝滑

本文详细介绍了如何在STM32F103芯片上通过DMA加速和内存优化,实现800*480大屏的LVGL流畅运行。通过FSMC+DMA硬件架构优化、双缓冲机制和LVGL参数调优,显著提升了界面刷新率和响应速度,适用于嵌入式GUI开发中的高性能需求场景。

weixin_30357231的博客 376

大模型-CLIP 详细介绍

最先进的计算机视觉系统通常被训练来预测一组预定义的对象类别。这种受限的监督形式限制了它们的通用性和可用性,因为要指定任何其他视觉概念,就需要额外的标注数据。比如,它们可以识别“猫”、“狗”、“汽车”等。但是,这种做法有一个明显的局限性:如果你想让系统识别一个新的类别,比如说“独角兽”,你就必须提供大量带有“独角兽”标签的图片来训练系统。这不仅耗时费力,而且限制了系统的灵活性和广泛适用性。直接从原始文本中学习关于图像的信息是一种很有前途的替代方案,因为它利用了更广泛的监督来源。

晓的博客 9719

零SQL搞定车辆数据:Vanna AI让自动驾驶分析像聊天一样简单

你是否还在为分析自动驾驶车辆的海量数据而头疼?面对复杂的数据库表结构和SQL查询语句,运营人员和非技术岗位的同事往往望而却步。本文将带你了解如何使用Vanna这个AI驱动的数据库查询工具,无需编写SQL代码,就能轻松实现车辆数据的自然语言查询与分析,让数据决策变得前所未有的简单。 读完本文,你将能够: - 理解Vanna的核心功能及优势 - 掌握Vanna的基本安装与配置方法 - 学会使用Van

gitblog_00152的博客 507

HTML5+CSS3+JS小实例:焦点图波浪切换动画特效

实例:焦点图波浪切换动画特效。字体图标库:Font Awesome。技术栈:HTML+CSS+JS。

艾恩小灰灰的博客 907

简单易用!Bedrock+Vanna.AI轻松构建Text-to-SQL方案

然而,这类解决方案通常需要繁琐的前期准备,如数据标注、模型微调,对使用者的技术储备和工程能力要求较高。Vanna.AI提供了一个内置的基于Flask框架的Web APP,可以直接运行后,通过更直观的界面与您的数据库对话,并且具有图表可视化的效果,还内置了简单的。在数字化浪潮中,大语言模型(LLM)发展迅猛,在智能客服、开发助手等多个领域展现出卓越的应用潜力,推动了各行业的智能化转型。的高效查询分析解决方案。,系统便能自动将其转换为准确的SQL查询,显著降低了数据分析的技术门槛,大幅提升了数据利用效率。

亚马逊云科技专栏 554

【零基础学习CAPL】——CAN报文的发送(CRC——ChecSum值)

本章主要介绍带有CRC值的报文发送一般报文可使用CANoe的IG模块直接发送,但带有CRC值的报文就只能编写脚本进行发送,以下详细讲解在配合Panel面板情况下,如何进行带有循环冗余码的报文进行报文的发送。

LOVE135149的博客 1913

OpenGL 进阶系列10 - 光线跟踪实现简介(Ray Tracing)

OpenGL 实现光线跟踪(Ray Tracing)是一个相对复杂但有趣的挑战,通常用于生成高度逼真的图像效果,如反射、折射、阴影等。OpenGL 本身并不是为光线跟踪设计的,但可以通过结合计算着色器和现代 OpenGL 功能实现光线跟踪。光线跟踪的基本思路是从相机(或视点)出发,发射光线并计算这些光线与场景中物体的交点。光线与场景中物体相交的计算。计算交点的光照(基于表面法线、光源位置、材质等)。反射和折射的处理(如果物体是透明或反射的)。

GPU全栈博主 1534

Vanna AI 3大革新:如何让数据库对话像聊天一样简单自然?

想象一下,你不再需要记住复杂的SQL语法,也不用担心表结构关系,只需用日常语言提问"显示第四季度销售额最高的10个客户",系统就能自动生成准确的查询并返回精美图表!这就是Vanna AI带来的革命性体验——一个专为现代数据交互设计的开源Python框架,让自然语言查询数据库成为现实。无论你是数据分析师、产品经理还是业务用户,都能轻松获得想要的数据洞察! ## 🎯 项目亮点:为什么Vanna A

gitblog_00585的博客 425

【ATC/DTC方法第四期】GOT09-dT-tao 昼夜温度周期模型方法介绍(含Python代码实现)

GOT09-dT-tao 模型是一种经过简化和参数固定的 昼夜温度周期模型(Diurnal Temperature Cycle, DTC)。它从 GOT09 模型(Göttsche and Olesen, 2009)衍生而来,但更加轻量化,更适合在数据不足或参数估计困难的情境下使用。

WW、forever的博客 146

Vanna AI数据库助手:让自然语言查询15种数据库变得简单

Vanna是一个基于人工智能的数据库查询工具,通过RAG(检索增强生成)技术实现精准的文本到SQL转换。它支持15种主流数据库,让不懂SQL的用户也能通过自然语言轻松获取数据洞察。 ## 🚀 核心优势:零SQL门槛的数据查询 传统的数据查询需要专业的SQL知识,而Vanna彻底改变了这一现状。无论您是运营人员、产品经理还是业务分析师,只需用日常语言提问,就能获得准确的数据结果。 [![Va

gitblog_00767的博客 334

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Vanna 2.0实战指南:如何用AI智能生成SQL查询,让数据库对话变得简单

还在为复杂的SQL查询语法头疼吗?是否希望用自然语言就能与数据库进行智能对话?Vanna 2.0正是这样一个革命性的AI驱动SQL生成框架,它通过先进的RAG(检索增强生成)技术实现精准的文本到SQL转换。本文将为你全面解析Vanna的核心功能、部署实战和优化策略,让你在几分钟内搭建起自己的智能SQL助手! ## 为什么需要AI驱动的SQL生成? 在数据驱动的时代,数据分析师、产品经理和业务人

gitblog_00200的博客 218

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Vanna 2.0 终极指南:3步搞定自然语言SQL查询,让数据分析像聊天一样简单!

还在为复杂的SQL查询而头疼吗?🤔 每天花费数小时编写数据库查询代码,却依然无法快速获取想要的数据洞察?Vanna 2.0 正是为你解决这个痛点的AI驱动SQL生成框架!作为开源的自然语言转SQL工具,Vanna让任何人都能用简单的对话方式与数据库交互,无需掌握复杂的SQL语法。想象一下,只需像聊天一样提问"显示销售额前十的客户",系统就能自动生成准确的SQL查询并返回可视化结果——这就是Van

gitblog_01137的博客 453

Vanna:让SQL飞起来的开源RAG神器,数据分析师的终极外挂!

Vanna能让你一句话问出SQL,轻松对接你的数据库,自动出表、出图、出洞见,堪称AI时代的“数据魔法棒”!今天这篇文章,我会用风趣幽默的方式,带你从入门到精通,深度剖析Vanna的原理、玩法和应用场景,让你看完后不仅会用,还能装X,分分钟在同事面前成为“SQL AI大师”!Vanna则是“RAG+SQL”的完美结合,能理解你的数据库、业务语义,生成高质量SQL,自动执行、可视化,极大降低数据分析门槛。再也不用苦苦查表结构、写SQL、调BUG了,Vanna自动帮你生成、执行、可视化,一站式搞定!

dotNET跨平台 705

Python Vanna 库使用示例:将自然语言转换为 SQL 查询

是一个基于 Python 的开源库,专注于的转换。它利用机器学习模型,将用户用自然语言描述的问题转换为结构化的 SQL 查询,从而简化数据库查询的过程。Vanna 特别适合非技术用户或数据分析师,使他们能够通过简单的自然语言与数据库交互,而无需编写复杂的 SQL 语句。

学亮编程手记 1218

Vanna:AI如何革新数据分析与可视化

在数据分析领域,SQL查询和可视化是两项核心技能,但对于非技术背景的用户或时间紧迫的开发者来说,手动编写SQL和设计图表往往耗时费力。Vanna是一个基于AI的数据分析工具,它能够理解自然语言描述的数据查询需求,自动生成对应的SQL查询语句,并直接输出可视化图表。比如你只需要说“显示过去三个月销售额最高的产品”,Vanna就能自动分析数据库结构,生成正确的SQL,并以折线图或柱状图呈现结果。传统方式可能需要半小时的工作,Vanna在10秒内就输出了带注释的可视化结果,还附带了可复用的SQL代码。

CrystalwaveEagle34的博客 733

【亲测免费】 推荐:Vanna.AI Streamlit App - 让数据分析更直观的利器

推荐:Vanna.AI Streamlit App - 让数据分析更直观的利器 项目介绍 Vanna.AI Streamlit App 是一个基于Streamlit框架构建的数据可视化应用。它提供了用户友好的界面,让你能够轻松配置和展示由Vanna.AI提供的复杂数据洞察。只需几行代码,你就可以拥有一个定制化的数据分析工具,将数据转换为生动的图表和交互式仪表板。 项目技术分析 这个项目依赖于Py...

gitblog_00708的博客 1173

【爆款长文】Vanna:让SQL飞起来的开源RAG神器,数据分析师的终极外挂!

Vanna,表面上是个Python包,实际上是你数据分析路上的“外挂”。它基于RAG(检索增强生成)技术,能把自然语言问题自动转成SQL,并且还能直接跑在你的数据库上,自动生成可视化图表。训练(Train):把你的数据库结构、业务文档、历史SQL喂给Vanna。提问(Ask):用自然语言问业务问题,Vanna自动生成SQL并执行,结果直接出表、出图。是不是有点像ChatGPT?但Vanna专为数据分析和SQL生成优化,支持各种主流LLM(大模型)、向量数据库和SQL数据库,灵活性爆表。

许泽宇的技术分享 1461
上一篇: NL2SQL简单使用
下一篇: 智能体长记忆解决方案Mem0和Memobase
MasonYyp
博客等级 码龄9年 301粉丝 297原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值