Spark 2.4.0 三节点集群部署文档 (Standalone 模式)

安装Spark-单机部署,Standalone集群部署,Spark on Yarn实现 SparkSession也是Spark程序中的一个类,功能类似于SparkContext,Spark2.0以后推出的,如果Hadoop生态的程序,例如MR、Hive、Sqoop、Oozie等使用YARN来计算。2-存储实时工具元数据。资源管理和任务调度:将所有从节点的资源在逻辑上合并为一个整体,将任务分配给不同的从节点。使用自己所在节点的资源运行计算进程Executor:给每个计算进程分配一定的资源。YARN支持多种类型程序的运行:MR、Tez、Spark、Flink等。 阅读详情

Spark 2.4.0 三节点集群部署文档 (Standalone 模式)

1. 集群规划

节点 IP主机名 (映射)角色分配备注
10.8.16.213node213Master + WorkerSpark主节点兼Flink分节点
10.8.16.209node209WorkerSpark分节点兼Flink主节点
10.8.16.210node210WorkerSpark分节点兼Flink分节点
  • 安装路径:/home/bigdata/spark-2.4.0-bin-hadoop2.7
  • 运行用户:bigdata
  • JDK版本:1.8

2. 环境准备 (所有节点)

2.1 jdk8安装

JDK 8 安装

#下载jdk8
sudo yum install -y java-1.8.0-openjdk-devel

修改环境变量:

vi ~/.bashrc

添加以下:

export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk
export PATH=$JAVA_HOME/bin:$PATH

刷新环境变量

source ~/.bashrc

查看jdk是否安装成功

java -version
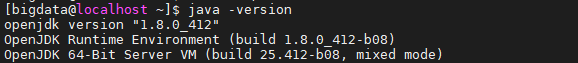
在这里插入图片描述

2.2 修改 Hosts 文件

在 /etc/hosts 中添加映射,确保三台机器能通过主机名互访:

10.8.16.213 node213
10.8.16.209 node209
10.8.16.210 node210
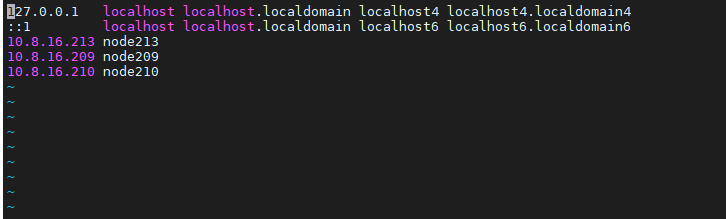
在这里插入图片描述

2.2 SSH 免密登录 (以 bigdata 用户执行)

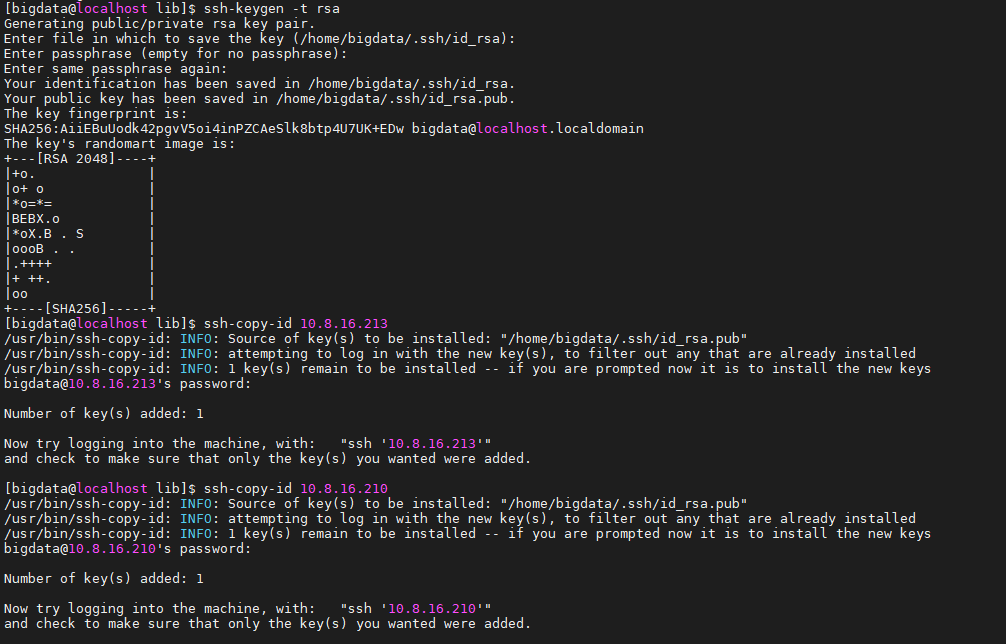
在 10.8.16.213 上生成密钥并分发,确保 Master 启动时不需要输入密码:

ssh-keygen -t rsa   # 一路回车
ssh-copy-id bigdata@10.8.16.213
ssh-copy-id bigdata@10.8.16.209
ssh-copy-id bigdata@10.8.16.210
在这里插入图片描述

3. 软件安装与配置 (三节点都需要)

3.1 下载并解压

cd /home/bigdata
wget https://archive.apache.org/dist/spark/spark-2.4.0/spark-2.4.0-bin-hadoop2.7.tgz
tar -zxvf spark-2.4.0-bin-hadoop2.7.tgz

3.2 配置环境变量

编辑 ~/.bashrc:

export SPARK_HOME=/home/bigdata/spark-2.4.0-bin-hadoop2.7
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin

执行 source ~/.bashrc 生效:

source ~/.bashrc

3.3 修改 spark-env.sh(仅在10.8.16.213)

#进入所在文件目录
cd /home/bigdata/spark-2.4.0-bin-hadoop2.7/conf
#复制备份原文件
cp spark-env.sh.template spark-env.sh
#进入编辑
vi spark-env.sh

本次搭建环境是三节点flink1.19.3集群模式和三节点spark2.4.0集群模式,如果单独搭建spark2.4.0集群模式可以省略以下这一步:
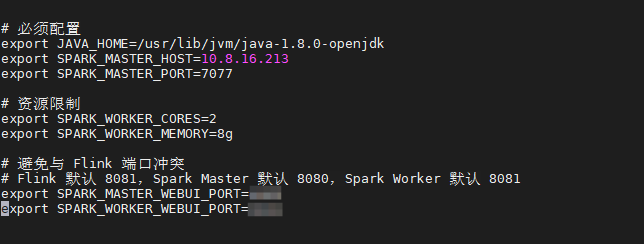
添加以下内容(注意避开 Flink 端口):

export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk
export SPARK_MASTER_HOST=10.8.16.213
export SPARK_MASTER_PORT=7077

# Web UI 端口配置 (避开 Flink 8081),自行设置即可
export SPARK_MASTER_WEBUI_PORT=xxxx
export SPARK_WORKER_WEBUI_PORT=xxxx

# 资源限制
export SPARK_WORKER_CORES=2
export SPARK_WORKER_MEMORY=8g
在这里插入图片描述

3.4 修改 slaves(仅在10.8.16.213)

cp slaves.template slaves
vi slaves

写入 Worker 节点 IP:

10.8.16.213
10.8.16.209
10.8.16.210

4. 分发配置 (从10.8.16. 213主节点分发到其余节点)

将配置好的文件同步到其他两台机器:

分发slaves:

#分发到10.8.16.209
scp /home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/slaves bigdata@10.8.16.209:/home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/
#分发到10.8.19.210
scp /home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/slaves bigdata@10.8.16.210:/home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/

分发spark-env.sh:

#分发到10.8.16.209
scp /home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/spark-env.sh bigdata@10.8.16.209:/home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/
#分发到10.8.19.210
scp /home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/spark-env.sh bigdata@10.8.16.210:/home/bigdata/spark-2.4.0-bin-hadoop2.7/conf/

也可以分发覆盖全部配置:

scp -r $SPARK_HOME/conf/* bigdata@10.8.16.209:$SPARK_HOME/conf/
scp -r $SPARK_HOME/conf/* bigdata@10.8.16.210:$SPARK_HOME/conf/


5. 集群启停

5.1 启动集群 (在 10.8.16.213 执行)

#进入spark路径
cd /home/bigdata/spark-2.4.0-bin-hadoop2.7/sbin
#启动
./start-all.sh

5.2 停止集群

./stop-all.sh

6. 验证与测试

6.1 进程检查

各节点执行 jps:

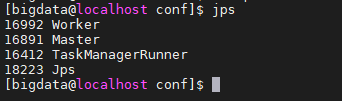
  • 213: Master, Worker
    在这里插入图片描述

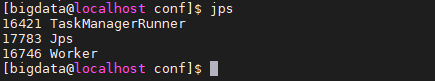
  • 209/210: Worker
    在这里插入图片描述

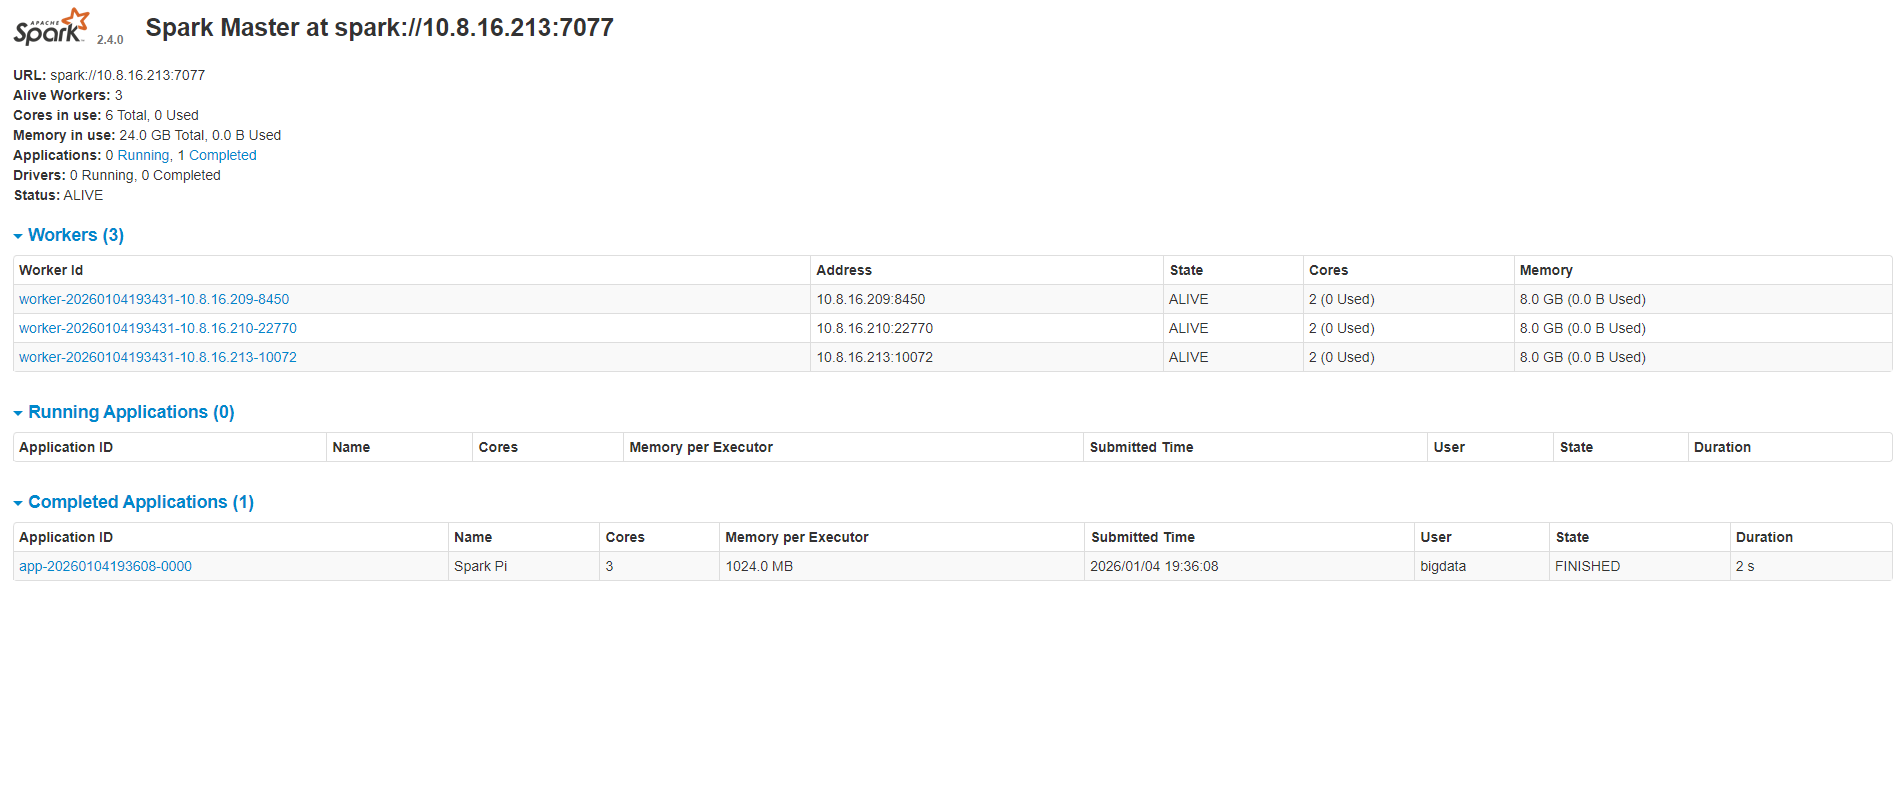
6.2 Web UI 监控

访问:http://10.8.16.213:xxxx(自定义的端口)
确认 Alive Workers 数量为 3。
在这里插入图片描述

6.3 运行示例任务

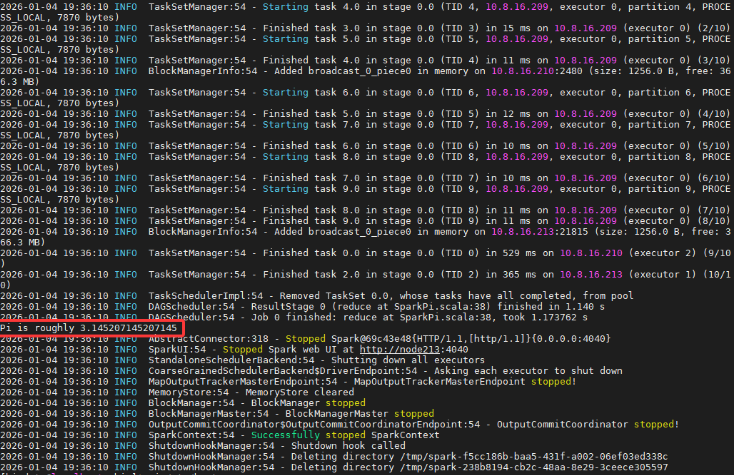
在 10.8.16.213 节点执行以下官方示例命令(计算圆周率 Pi):

spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://10.8.16.213:7077 \
--executor-memory 1G \
--total-executor-cores 3 \
$SPARK_HOME/examples/jars/spark-examples_2.11-2.4.0.jar \
10

结果确认:在终端日志或 Web UI 的 stdout 中看到 Pi is roughly 3.1415…。
在这里插入图片描述

Spark 集群搭建:Standalone 模式详解 通过以上步骤,我们成功搭建了一个 Spark Standalone 集群。这个集群为大数据处理提供了一个高效的计算平台。在实际应用中,我们可以根据业务需求进一步优化集群配置,如调整内存分配、增加节点数量等,以满足大规模数据处理的要求。同时,也要定期对集群进行维护和监控,确保其稳定运行。希望这篇博客能帮助你顺利搭建起自己的 Spark 集群,开启大数据处理之旅!如果你在搭建过程中遇到任何问题,欢迎在评论区留言交流。 阅读详情

相关推荐

Spark 2.4.0 standalone 模式安装

Spark 2.4.0 standalone 模式安装 更多资源 github: https://github.com/opensourceteams/spark-scala-maven-2.4.0 官网文档 https://spark.apache.org/docs/2.4.0/spark-standalone.html 技能标签 学会安装Spark 2.4.0 standalone模...

大数据技术分享 2579

centos7三个节点的 spark集群搭建

一.前期准备: 三台centos7虚拟机hadoop01,hadoop02,hadoop03(已成功完成hadoop集群搭建),xshell,xftp,spark安装包(https://www.apache.org/dyn/closer.lua/spark/spark-2.4.3/spark-2.4.3-bin-hadoop2.7.tgz) 说明:以下全部使用root用户进行操作 二.针对h...

赴前尘 1522

Spark搭建 Standalone模式详细步骤

Spark搭建 Standalone模式详细步骤

weixin_52134189的博客 3268

【Spark集群部署系列二】Spark StandAlone模式介绍和搭建以及使用

【Spark集群部署系列一】Spark local模式介绍和搭建以及使用(内含Linux安装Anaconda)http://t.csdnimg.cn/0xmky 在部署spark集群前,请部署好Hadoop集群,jdk8【当然Hadoop集群需要运行在jdk上】,需要注意hadoop,spark的版本,考虑兼容问题。比如hadoop3.0以上的才兼容spark3.0以上的。 下面是Hadoop集群部署的链接,个人笔记,已经成功部署两次了,实时更新,分【一】【二】两部分,需要的自己看。不懂欢迎问,看到了解答。

qq_65231448的博客 1718

Spark Standalone 模式的安装和部署 第1关: Standalone 分布式集群搭建

Spark Standalone 模式的安装和部署 第1关: Standalone 分布式集群搭建

qq_61604164的博客 2368

Spark的StandAlone集群模式安装部署

StandAlone集群模式的介绍与部署 集群角色介绍 Spark是基于内存计算的大数据并行计算框架,实际中运行计算任务肯定是使用集群模式,那么就需要了解spark自带的standalone集群模式的架构以及它的运行机制 stand alone集群模式使用了分布式计算中的master - slave模型 master是集群中含有master进程的节点 slave是集群中worker节点含有Executor进程 Spark架构图如下: Apache对spark架构的官方描述:http://spark.apa

weixin_38097878的博客 646

基于Spark3.3.4版本,实现Standalone 模式高可用集群部署

在早期大数据处理中,我们会选择使用MapReduce分析处理海量数据,MapReduce存在计算慢、代码编写复杂、不支持流式计算及性能上的一些问题,Apache Spark计算框架的出现解决了MapReduce计算框架以上各种问题,Apache Spark是新一代的大数据计算框架,支持针对批量数据及流式数据进行处理,在数据处理上相对比MapReduce性能上提升很多,不仅编程方便还支持SQL处理数据、流式编程等。今天我就来带大家基于Spark3.3.4版本,实现Standalone 模式高可用集群部署。

qq_25409421的博客 1905

Spark【安装篇】02:Spark【集群】【手动】安装部署:Standalone模式以及ON YARN模式

Spark【安装篇】02:Spark【集群】【手动】安装部署:Standalone模式以及ON YARN模式

weixin_40612128的博客 3199

Spark 集群部署(Standalone)详解 手把手教学

Spark 集群部署(Standalone)详解 手把手教学

皮蛋不吃粥的博客 2407

Spark系列-3、Spark的部署方式之Standalone模式

Spark的部署方式之Standalone模式

不积跬步无以至千里,不积小流无以成江河 1487

物体检测之非极大值抑制:NMS、softNMS、softerNMS、IoU-Net

当前的物体检测算法为了保证召回率,对于同一个真实物体往往会有多个的候选框输出。由于多余的候选框会影响检测精度,因此需要利用NMS过滤掉重叠的候选框,得到最佳的预测输出。当前有如下几种较为常见的NMS方法, 1.基本NMS 非极大值抑制, 顾名思义就是抑制不是极大值的边框,这里的抑制通常是直接去掉冗余的边框。 这个过程涉及以下两个量化指标: 1.预测得分:NMS假设一个边框的预测得分越高,这个框...

LeoLee 1944

Spark集群部署

2.4) 修改spark-env.sh文件,添加JAVA_HOME环境变量和集群对应的master节点 [root@qianfeng01 local]# vi /usr/local/spark-3.1.2/conf/spark-env.sh。2)修改hadoop中的配置文件/usr/local/hadoop-3.3.1/etc/hadoop/yarn-site.xml vi /usr/local/hadoop-3.3.1/etc/hadoop/yarn-site.xml。

HYSliuliuliu的博客 9312

免费升级哨兵2号分辨率!用SRCNN深度学习模型实现10米→2.5米超分重建

本文详细介绍了如何利用SRCNN深度学习模型,将哨兵2号遥感影像的分辨率从10米免费提升至2.5米。文章提供了从数据准备、模型训练到部署应用的全流程实战指南,旨在通过AI应用技术,为农业监测、城市规划等领域提供更高精度的影像数据支持。

coffee的博客 524

部署spark2.2集群(standalone模式)

部署spark2.2集群(standalone模式)

程序员欣宸的博客 3381

UR10e+D435+ag95夹爪 gazebo 仿真记录(一)

学习仿真环境gazebo下利用UR10e机械臂搭建模拟平台,此博客用于记录搭建过程!!主要参考光头明明、总有一天全城的人都要高看我们和bug404_三位博主。最终自己功能包的主要参考了bug404_的ur_platform,感觉这个结构比较合理。运行环境:Ubuntu18.04+Ros-melodic+Gazebo9。

Forbiven的博客 6330

零代码构建AI智能体:COZE可视化工作流实战指南

AI智能体(AI Agent)是当前人工智能领域的重要发展方向,它通过模块化设计和工作流驱动,使大语言模型从被动对话转向主动执行。其核心原理在于将复杂的任务分解为可规划、可执行的步骤,并调用外部工具(插件)完成闭环。这一技术价值在于显著降低了自动化流程的开发门槛,让非程序员也能构建实用的数字助手。典型的应用场景包括智能客服、内容自动生成、数据分析和跨系统业务流程自动化。本文以COZE平台为例,深入解析如何通过其直观的可视化界面和丰富的插件生态,像搭积木一样快速搭建如“早安简报生成器”等实用智能体,并分享指令

469

Spark 部署 Standalone 模式

Spark 部署 Standalone 模式解压缩文件修改配置文件启动集群Web UI 界面提交应用提交参数说明配置历史服务配置日志存储路径添加日志配置重启动 Hadoop 集群重启动历史服务重新执行任务查看历史服务配置高可用(HA)集群规划 :停止集群启动 Zookeeper启动集群关闭集群关闭历史服务 : 解压缩文件 将 spark-3.0.0-bin-hadoop3.2.tgz 文件上传到 Linux 并解压缩在指定位置 tar -zxvf spark-3.0.0-bin-hadoop3.2.tgz

记录点点滴滴 2136

Atlas 300I Duo - vllm部署Qwen3-VL-8B-Instruct

本文介绍了在Ascend NPU环境下部署Qwen3-VL-8B大语言模型的步骤。主要包括:1)安装驱动、docker和vllm镜像;2)创建特权容器并挂载设备与目录;3)进入容器安装指定版本的transformers;4)设置环境变量和NPU卡配置;5)启动vllm服务;6)测试API接口。部署过程涉及多块NPU卡的使用,需注意内存碎片化问题,最终通过vllm框架提供模型推理服务。

m0_50105717的博客 1566

spark Standalone ha 集群部署

准备三台服务器,配置好对应主机的网络IP、主机名称、关闭防火墙、主机名masterslavescdh101√√cdh102√cdh103√用于Worker的Web UI用于Worker的Web UI应用程序(Driver和Executor)使用的端口5050、4040用于Executor的启动和Driver的回调。外部服务使用的端口(如Spark History Server18080用于Spark History Server的Web UI。

qq_24141759的博客 1279

S7-1200中时钟功能设定和读写调用的具体方法

S7-1200中时钟功能设定和读写调用的具体方法

Robot_PLC_HMI_Automation 1万+

基于Python的FTA协定内容爬虫实战:从数据抓取到智能分析

本文将详细介绍如何使用Python构建一个高效的FTA(自由贸易协定)内容爬虫,涵盖最新技术如Playwright、异步IO、智能解析等。通过本教程,您将学会如何从各类政府网站和国际组织平台抓取结构化FTA数据,并对其进行清洗、存储和分析。文章包含完整的代码实现和最佳实践指南,适合中高级Python开发者学习网络爬虫开发。

2201_76125261的博客 994

Spark学习之路(一):Spark基于Standalone模式完全分布式搭建集群

Spark完全分布式搭建一、Spark集群的部署方式1.Standalone模式2.Spark On YARN模式3.Spark On Mesos模式二、基于Standalone模式部署集群1.下载并解压Spark安装包2.配置环境变量3.置Spark的配置文件4. 启动集群三、测试集群四、总结 一、Spark集群的部署方式 1.Standalone模式 与MapReduce1.0框架类似,Sp...

萧邦主的城邦 1578

EtherCAT ROS2 入门教程(一)

本文介绍了EtherCAT驱动与ROS2的集成方案,主要包括三部分内容:1)在Ubuntu 22.04上安装IgH EtherCAT主站的详细步骤,包括内核配置、源码编译和网络适配器设置;2)构建ethercat_driver_ros2,通过ros2_control描述文件配置硬件接口和EtherCAT从站模块插件;3)使用方法,包括启动EtherCAT主站和运行配置包。该方案支持通过参数文件定义硬件接口,并提供通用和专用两种EtherCAT模块插件,便于开发基于EtherCAT的工业应用。

机器人控制与仿真应用 1531

【Spark集群部署系列三】Spark StandAlone HA模式介绍和搭建以及使用

Spark Standalone集群是Master-Slaves架构的集群模式,和大部分的Master-Slaves结构集群一样,存在着Master单点故障(SPOF)的问题。如何解决这个单点故障的问题,Spark提供了两种方案:1.基于文件系统的单点恢复(Single-Node Recovery with Local File System)--只能用于开发或测试环境。

qq_65231448的博客 1323

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Spark 本地模式 和 standalone集群模式 高可用(HA)部署以及案例测试

文章目录Spark 本地模式Spark-shellwordcount 程序案例监控页面运行圆周率程序案例Spark Standalone 集群模式Standalone 架构在这里插入图片描述Standalone 集群模式部署解压、环境变量Workers主机名称配置Master、Workers、HistoryServer创建EventLogs存储目录配置Spark应用保存EventLogs设置日志级别分发到集群所有机器启动服务进程 创建软链接,方便后期升级 ln -s /usr/spark/spark-2.

shuyv的博客 1695

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

8.1.CentOS7安装Spark安装部署及standalone模式介绍

spark安装部署及standalone模式介绍

IT瘾君子的博客 1585

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

上一篇: maxwell(1.44.0)暂停监听某些表的测试
下一篇: Flink 1.19.3 资源配置优先级验证报告
wangyutian5u
博客等级 码龄4年 94粉丝 15原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值