护卫舰防御无人机群DWTA的改进RL-IGWO算法

Python+Gurobi求解SWTA问题 前言 静态武器目标分配(static weapon-target assignment,WTA)问题是军事领域的著名问题,也是分配问题中的研究热点之一。SWTA问题易于描述但是难以求解,自1958年提出以来,大量学者对其进行了研究,但是对于大规模的SWTA问题求解仍然难以克服,本文将借助Gurobi精确求解小规模的SWTA问题。 SWTA问题 假设我方有m个武器,敌方有n个目标来袭,对我方资产进行打击,来袭目标j具有不同的威胁程度v_j,我方武器i对于目标j的毁伤概率p_i_j已知,SWTA问题旨在寻找一种 阅读详情

原文:A Modified RL-IGWO Algorithm for Dynamic Weapon-Target Assignment in Frigate Defensing UAV Swarms
摘要:无人机蜂群在成本、数量、智能等方面具有显著优势,对传统的护卫舰防空系统构成严重威胁。舰载近程防空武器承担末端防御任务对抗UA V蜂群。在传统的防空火控系统中,将一个动态武器-目标分配分解为若干个静态武器-目标分配,但动态武器-目标分配与静态武器-目标分配之间的关系并没有得到有效的分析证明。以某型护卫舰与UA V编队作战场景为背景,建立了基于模型的强化学习框架,利用动态规划方法将DWAT问题分解为多个静态组合优化问题。此外,设计了几个可变邻域搜索(VNS)算子和一个基于对立的学习(OBL)算子,增强了原灰狼优化器(GWO)的全局搜索能力,从而解决了SCO问题。针对护卫舰防御UA V群攻击中的DWTA问题,提出了一种改进的基于强化学习的灰狼算法(RL-IGWO)。实验结果表明,RL-IGWO在决策时间和求解质量上都有明显的优势。
引言:有三种经典的动态WTA模式
1、AOA——攻击-观察-攻击
2、OODA——观察-确定-决策-行动
3、博弈论
  目前的研究存在以下问题:1、DWTA问题的分解过程没有有效的分析证明支持,子问题的最优解不能保证在整个时域内是全局最优解。2、目前一些最先进的群体智能算法在求解DWTA问题分解出来的每个子问题时存在一些缺陷,有时会陷入局部最优。3、在DWTA问题的多目标优化过程中,许多情况下各个目标函数之间存在着强烈的冲突,传统的目标函数设计严重依赖于权重,没有有效的方法。
  为了有效解决上述问题,提出了一种基于强化学习的改进灰狼算法(RL-IGWO),本文以护卫舰防御UA V群为例,建立了复杂约束条件下的DWTA问题。采用动态规划方法和强化学习方法,将DWTA问题分解为多个静态组合优化问题,并进行了严格的分析证明。设计了几个可变邻域搜索(VNS)算子和一个基于对立学习(OBL)算子来增强灰狼优化算法(GWO)的全局搜索能力。为了通过GWO算法生成高质量的原始解,采用了强化学习训练的策略。GWO算法还能更好地执行贪婪策略,有利于状态值函数收敛。并用强化学习的价值状态函数设计目标函数。
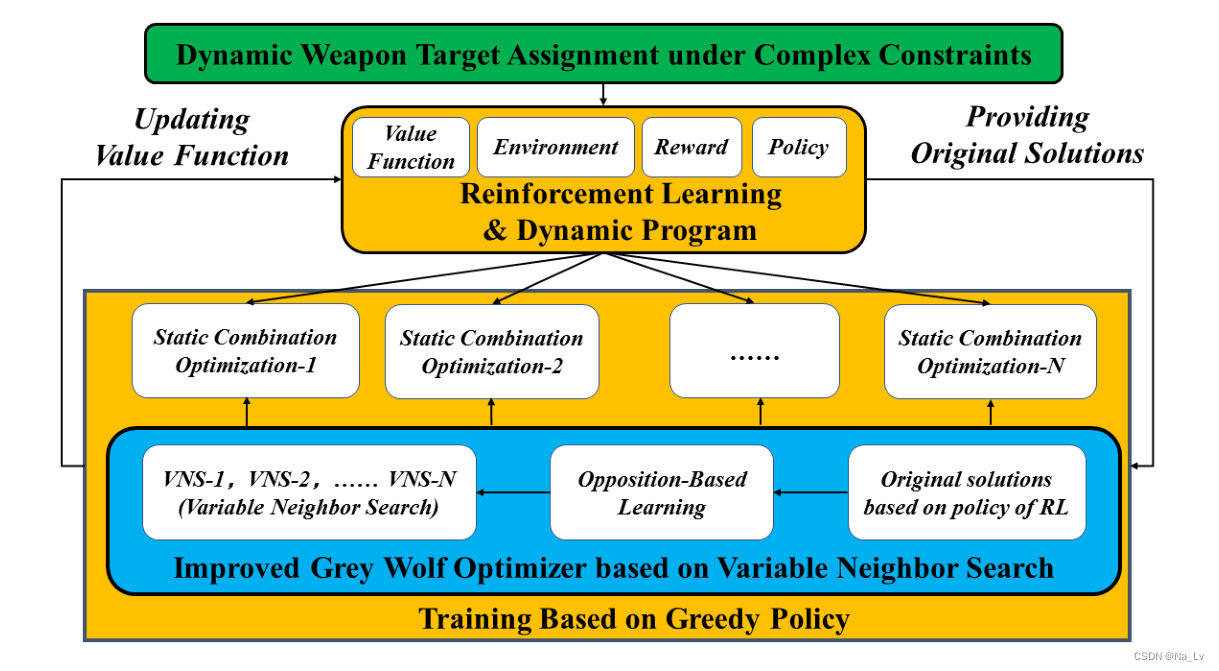
在这里插入图片描述
建模:
核心思想:由于多目标优化问题的多个目标之间往往相互冲突对立,因此本文将多目标问题转化为有约束的单目标问题。
动作:A=[Aij]n×4A=[A_{ij}]_{n\times4}A=[Aij​]n×4​,其中第一列表示短程导弹1的攻击情况;第二列表示短程导弹2;第三列表示制导导弹;第四列表示“密集阵”系统,如:Ai3=3A_{i3}=3Ai3​=3表示用三个制导导弹攻击第iii个无人机。且动作需满足以下约束条件:
在这里插入图片描述
状态及状态转移:St=[n,D]→St+1=[n−death,D+1]S_t=[n,D]\to S_{t+1}=[n-death,D+1]St​=[n,D]→St+1​=[n−death,D+1]表示了由状态ttt到t+1t+1t+1时无人机群数量nnn的变化和机群所在空间DDD的变化
原多目标问题的目标函数:
破坏值(destructive value, Dv)Dv=∑i=1nUAViD_v=\sum_{i=1}^{n}{UAV_i}Dv​=i=1∑n​UAVi​资源消耗(resource consumption, Rc)Rc=∑i=1nWeaponiR_c=\sum_{i=1}^{n}{Weapon_i}Rc​=i=1∑n​Weaponi​效率成本比(efficiency-cost ratio, Ecr)Ecr=Dv/RcE_{cr}=D_v/R_cEcr​=Dv​/Rc​平均拦截率(average interception rate, Air)Air=1−∑i=1n1/eiA_{ir}=1-\sum_{i=1}^{n}{1/e_i}Air​=1−i=1∑n​1/ei​防御完成率(defense completion rate, Dcr)Dcr=1/n∑i=1nsucD_{cr}=1/n\sum_{i=1}^{n}{suc}Dcr​=1/ni=1∑n​sucsuc={1,if  npen==00,if  npen!=0suc = \begin{cases}1,if\ \ n_{pen}==0\\ 0,if\ \ n_{pen}!=0\end{cases}suc={1,if  npen​==00,if  npen​!=0​
对以上目标函数设置权重和违反程度后,带约束的单目标模型如下:
max  Jcer=ω⋅Dv−Rcs.t.{Air>(1−Eair)Dcr>(1−Edcr) max\ \ J_{cer}=\omega\cdot D_v-R_c\\ s.t.\begin{cases}A_{ir}>(1-E_{air})\\D_{cr}>(1-E_{dcr})\end{cases} max  Jcer​=ω⋅Dv​−Rc​s.t.{Air​>(1−Eair​)Dcr​>(1−Edcr​)​其中,ω=100\omega=100ω=100,Eair=0.06E_{air}=0.06Eair​=0.06,Edcr=0.12E_{dcr}=0.12Edcr​=0.12
RL-IGWO算法:
1、DWTA问题的分解
传统的DWTA问题往往被分解为多个SWTA问题解决,
SWTA={SWTA1,SWTA2,...,SWTAt,...}SWTA = \{SWTA^{1},SWTA^{2},...,SWTA^{t},...\}SWTA={SWTA1,SWTA2,...,SWTAt,...}每个阶段的目标函数记为JtJ^{t}Jt, 有:Jt=∑i=1n∏j=1m(1−pijt)aijtJ^t=\sum_{i=1}^{n}{\prod_{j=1}^{m}{(1-p_{ij}^t)^{a_{ij}^t}}}Jt=i=1∑n​j=1∏m​(1−pijt​)aijt​如果按照AOA框架,那么该问题只是在每个局部时域内进行优化,并没有考虑到后续阶段的规划,但DWTA是一个经典的序列决策问题,具有较强的随机性和对时间敏感的特点。因此引入了强化学习解决全局时域内的优化问题。
用如下表达式记录每一阶段内被成功拦截的UAV:
deeath=∑i=1nbroken(i)broken(i)={0,ifx<∏j=14(1−pijt)aijt1,elsedeeath = \sum_{i=1}^n broken(i) \\ broken(i)=\begin{cases}0,ifx<\prod_{j=1}^4(1-p_{ij}^t)^{a_{ij}^t} \\ 1,else\end{cases}deeath=i=1∑n​broken(i)broken(i)={0,ifx<∏j=14​(1−pijt​)aijt​1,else​那么强化学习的奖励函数可以设计为:r={−∞,if  death<n  and  D=7Jecrr = \begin{cases}-\infty,if\ \ death<n \ \ and \ \ D=7\\ J_{ecr} \end{cases}r={−∞,if  death<n  and  D=7Jecr​​,第ttt阶段状态SSS的状态值函数可以表示为:v(St)=E(rt+rt+1+rt+2+…)v(S_t)=E(r_t+r_{t+1}+r_{t+2}+…)v(St​)=E(rt​+rt+1​+rt+2​+…)
假设DWTA问题在遵循马尔科夫决策过程,在决策时采用贪婪策略,那么根据状态值函数可以得到bellman离散方程:vk+1(st)=max(rstA+∑st+1Pstst+1A×v(st+1))v_{k+1}(s_t)=max(r_{s_t}^A+\sum_{s_{t+1}}P_{s_ts_{t+1}}^A\times v(s_{t+1}))vk+1​(st​)=max(rst​A​+st+1​∑​Pst​st+1​A​×v(st+1​))当状态值函数收敛时,DWTA问题转化为一系列静态组合优化问题(SCO):DWTA={SCO1,SCO2,..,SCOt,...}{SCOt:max  J(At)J(At)=rstA+∑st+1Pstst+1A×v(st+1)DWTA = \{SCO^1,SCO^2,..,SCO^t,...\} \\ \begin{cases}SCO^t:max\ \ J(A^t) \\ J(A^t)=r_{s_t}^A+\sum_{s_{t+1}}P_{s_ts_{t+1}}^A\times v(s_{t+1})\end{cases}DWTA={SCO1,SCO2,..,SCOt,...}{SCOt:max  J(At)J(At)=rst​A​+∑st+1​​Pst​st+1​A​×v(st+1​)​
2、灰狼算法的改进
1)加入对立学习算子,提高初始解的多样性
在这里插入图片描述
  强化学习生成的策略π=[S,Aα,Aβ,Aδ]\pi=[S,A_\alpha,A_\beta,A_\delta]π=[S,Aα​,Aβ​,Aδ​]包含了三只头狼的分配矩阵,根据对立学习原则,生成对立的三只狼Aα^,Aβ^,Aδ^A_{\hat\alpha},A_{\hat\beta},A_{\hat\delta}Aα^​,Aβ^​​,Aδ^​,对立个体的分配矩阵是将原个体的分配矩阵中的非零元素转化为零元素,零元素随机生成正整数(也有可能还是0)。
2)可变邻域搜索算子
在这里插入图片描述
设计了三种不同的搜索算子:平衡算子、滑动算子和爆炸算子。
平衡算子:
在这里插入图片描述
滑动算子:
在这里插入图片描述
(上图中4有误,应表示为:As[i,0]=B[i,n2−2]A_s[i,0]=B[i,n2-2]As​[i,0]=B[i,n2−2],As[i,1]=B[i,n2−1]A_s[i,1]=B[i,n2-1]As​[i,1]=B[i,n2−1],As[i,2]=B[i,n2]A_s[i,2]=B[i,n2]As​[i,2]=B[i,n2])
爆炸算子:
当上述两种算子都不能产生更优解时,采用爆炸算子产生新的随机序列,提高了全局搜索能力Aiexploding=Ai+Ei=Ai+E^i+E~iA_i^{exploding}=A_i+E_i=A_i+\hat E_i+\tilde E_iAiexploding​=Ai​+Ei​=Ai​+E^i​+E~i​其中E~i\tilde E_iE~i​表示随机扰动项,其元素E~i[I,J]=Emax×(1−iter/itermax)⋅δ\tilde E_i[I,J]=E_{max}\times(1-iter/iter_{max})\cdot \deltaE~i​[I,J]=Emax​×(1−iter/itermax​)⋅δ,E^i\hat E_iE^i​表示邻域学习项,可以表示为E^i=∑Aj∈Ni(Aj−Ai)\hat E_i=\sum_{A_j\in N_i}(A_j-A_i)E^i​=∑Aj​∈Ni​​(Aj​−Ai​),其中Ni={Aj∣(∥Aj−Ai∥<Ri)}N_i=\{A_j\vert( \Vert A_j-A_i\Vert<R_i)\}Ni​={Aj​∣(∥Aj​−Ai​∥<Ri​)},一般限制邻域半径Ri=1/5n∑j=1n∥Ai−Aj∥R_i=1/5n\sum_{j=1}^n\Vert A_i-A_j\VertRi​=1/5n∑j=1n​∥Ai​−Aj​∥
3、总体算法流程
在这里插入图片描述
实验部分
1、6个基准问题的实验对比
  将I-GWO与其他元启发式算法进行比较:粒子群算法、磷虾群算法(Hrill Hred algorithm,KH)和遗传算法,通过实验说明了该算法在收敛速度和优化结果上的优越性。
2、DWTA问题的实验对比
  模拟了6各不同的战斗场景,每个场景重复35次以测试不同种群规模和迭代下的性能,首先对比了再强化学习的基础上分别采用不同的进化策略:RL-GWO和RL-IGWO两种算法的状态值收敛效果;又对比了RL-IGWO与IGWO、GWO、NSGA-2在上述场景中5个目标函数的结果(数值、柱形图)
结论
  该算法求解动态问题仍会面临较大的计算复杂度,分布式优化和并行计算是未来解决动态问题的关键技术之一;好的优化算法并不一定能找到所有问题都最优解,问题本身的设置需要具备合理性;强化学习提供的高质量初始种群在整个优化过程中的影响会逐渐减弱。

动态武器目标分配 (DWTA) 问题建模与求解:基于Python的3阶段马尔可夫决策过程仿真 本文详细介绍了动态武器目标分配(DWTA)问题的Python实现,采用三阶段马尔可夫决策过程(MDP)进行建模与仿真。通过构建状态空间、动作空间和奖励函数,实现高效算法求解,并对比不同策略的性能。文章还提供了代码框架、性能优化技巧及扩展应用场景,为防御系统优化提供实用解决方案。 阅读详情

相关推荐

数学建模学习(90):改进的灰狼优化算法(I-GWO)对多元函数寻优

改进的灰狼优化算法(I-GWO)对多元函数寻优

全栈川川 2374

DWTA问题的群优化算法

SSODT将DIS和TES两种新方案集成到现有的SSO中,有效地优化DWTA。DIS是一个确定性过程,在这个过程中,具有最高预期威胁值的目标总是优先于对该目标具有最高杀伤概率的武器的交战。该方法在初始化阶段为SSODT生成了一个很有前景的可行初始解。在演化阶段,TES被设计为局部搜索,在交战可行性约束下,从可行解中随机选择两个三元组进行目标交换,从而提高了SSODT在DWTA中的开发能力。

m0_59466752的博客 877

matlab代码粒子群算法-sogwo:基于对立学习的选择性灰太狼优化

matlab代码粒子群算法基于选择性对立的GWO的MATLAB代码 执行功能优化的代码。 这是标题为“基于选择性对立的灰狼优化”的论文的代码 给出的代码是针对三种算法的: 基于选择性对立的灰狼优化(SOGWO) 灰狼优化(GWO) 粒子群优化(PSO) 参数 必须在main.m文件中设置以下参数才能运行代码 迭代-每个函数的运行次数 SearchAgents_no-人口规模 Max_iteration-每个要执行的函数的迭代 algo_choice-要运行的算法 运行代码 在上面指定的文件中设置所有必需的参数 运行文件main.m 链接以获取算法详细信息: 抽象的: 由于具有多种原因,包括灵活性,简单性和鲁棒性,元启发法在科学和工业问题上的优化已广泛使用。 灰狼优化器(GWO)是该领域中最新,最流行的算法之一。 在这项工作中,基于对立的学习(OBL)与GWO相结合,以增强其探索行为,同时保持快速的收敛速度。 Spearman的相关系数用于确定在其上进行对立学习的欧米伽(ω)狼(群居中社会地位最低的狼)。 除了选择狼的所有尺寸外,还选择狼的几个尺寸并对其施加对立。 这有助于避免不必要的探

IGWO算法

IGWO(Improved Grey Wolf Optimizer)算法是一种基于群体智能的优化算法,它是对原始灰狼优化算法的改进版本。

weixin_44943389的博客 1018

改进的灰狼优化器 (I-GWO):灰狼优化器的最佳改进之一-matlab开发

I-GWO 算法受益于一种新的运动策略,称为基于维度学习的狩猎 (DLH) 搜索策略,该策略继承自自然界狼的个体狩猎行为。 DLH 使用不同的方法为每只狼构建一个邻域,其中可以在狼之间共享相邻信息。 DLH 搜索策略中使用的这种维度学习可以增强局部和全局搜索之间的平衡并保持多样性。 作者和程序员:MH Nadimi-Shahraki、S. Taghian、S. Mirjalili 电子邮件:nadimi@ieee.org、shokooh.taghian94@gmail.com、ali.mirjalili@gmail.com http://www.alimirjalili.com 主要论文:MH Nadimi-Shahraki、S. Taghian、S. Mirjalili,用于解决的改进灰狼优化器,工程问题,专家系统与应用,印刷中,DOI:10.1016/j.eswa.2020.1

【优化算法】改进的灰狼优化算法(IGWO)【含Matlab源码 1349期】.zip

完整代码,可直接运行

三种灰狼优化算法(Grey Wolf Optimization)及仿真实验——附代码Matalb

灰狼优化算法(Grey Wolf Optimization)。GWO通过模拟灰狼群体捕食行为,基于狼群群体协作的机制来达到优化的目的。GWO算法具有结构简单、需要调节的参数少、容易实现等特点,其中存在能够自适应调整的收敛因子以及信息反馈机制,能够在局部寻优与全局搜索之间实现平衡,因此在对问题的求解精度和收敛速度方面都有良好的性能。本文实现了三种不同的GWO算法,并通过仿真实验验证了该智能算法在求解优化问题方面的有效性,程序关键行均有注释。

不定时分享电力优化、神经网络、数学建模等技术等 5424

闲鱼客户端三重动态签名机制解析:x-sign、x-mini-wua与x-umt

在移动客户端安全通信中,设备级动态签名已成为主流App防范自动化攻击的核心手段。其原理是将设备指纹、运行时行为与可信硬件标识深度融合,生成不可复用、不可跨端、不可静态伪造的请求凭证。这类机制超越传统Token或Session鉴权,具备强上下文绑定性与实时熵值校验能力,广泛应用于电商、社交及开放平台等高风险接口场景。技术价值体现在有效识别模拟器、无头浏览器与集群化爬虫,同时保障多端一致性与合规数据对接。本文聚焦闲鱼客户端实际落地的x-sign(带设备上下文的混合签名)、x-mini-wua(小程序行为水印)与

weixin_35732273的博客 495

武器目标分配问题研究进展: 模型、算法与应用

源自:系统公正与电子技术作者:李梦杰 常雪凝 石建迈 陈超 黄金才 刘忠武器目标分配问题是指挥控制与任务规划领域的关键难点之一, 也是军事运筹领域的基础研究课题。经过多年研究, 武器目标分配问题在陆海空天电等领域都得到了广泛研究, 涌现出了大量模型和算法。系统梳理武器目标分配问题的典型作战样式、建模方法、求解算法和实验验证, 掌握当前该领域的研究现状, 在此基础上, 结合智能化、无人化战争带来的新挑战, 分析武器目标分配的发展趋势, 为后续研究提供参考。武器目标分配;模型;算法;综述。

renhongxia1的博客 1万+

【QMIX】一种基于Value-Based多智能体算法

文章目录1. QMIX 解决了什么问题(Motivation)2. QMIX 怎样解决团队收益最大化问题(Method)2.1 算法大框架 —— 基于 AC 框架的 CTDE(Centralized Training Distributed Execution) 模式 QMIX 是一种基于 Value-Based 的多智能体强化学习算法(MARL),其基本思想来源于 Actor-Critic 与 DQN 的结合。使用中心式学习(Centralized Learning)分布式执行(Distributed

qq_38638132的博客 9860

VSCode玩转Arduino:手把手解决‘未定义Serial’和头文件找不到的坑

本文详细介绍了在VSCode中配置Arduino开发环境时遇到的‘未定义Serial’和头文件找不到问题的解决方案。通过修改c_cpp_properties.json文件、调整IntelliSense引擎设置以及添加正确的库路径,开发者可以高效解决这些常见错误,提升开发体验。文章还提供了针对不同开发板和平台的高级配置技巧,确保配置的长期有效性。

weixin_42620202的博客 357

【智能优化算法】改进灰狼优化器(Improved Grey Wolf Optimizer,I-GWO)

改进的灰狼优化器(Improved Grey Wolf Optimizer,I-GWO),是由科院二区期刊“Expert Systems with Applications”上文章“An improved grey wolf optimizer for solving engineering problems”提出的。

yuchunyu12的博客 1428

Arduino——GY39大气压、温湿度、光照模块

前几天买东西的时候买了一个GY39,这个模块集成了温湿度,大气压,海拔,光照一体,使用起来很方面。它有两种工作模式使用串口模式时需要搭配转接板,我选择了IIC模式,看一下通信协议吧,就是关于高八位和低八位的数据。看一下接线。

戚晨夕的博客 2605

群体智能优化算法-改进灰狼优化算法(I-GWO,含Matlab源代码)

改进灰狼优化算法(Improved Grey Wolf Optimizer, I-GWO)是针对经典灰狼优化算法(GWO)的增强版本,通过引入距离与邻域搜索(Distance-based Local Hunting, DLH)机制,改善原算法的局部搜索能力和全局收敛速度。I-GWO 通过综合利用 GWO 的「包围、搜捕、进攻猎物」策略及动态邻域搜索技术,为复杂的连续优化问题提供了更有效的解。

qq_53665413的博客 915

LabVIEW小白福音:手把手教你用NI采集卡搭建振动信号采集系统(附源码和避坑指南)

本文为LabVIEW初学者提供详细的NI采集卡振动信号采集系统搭建指南,涵盖硬件连接、驱动安装、信号处理及性能优化等关键步骤。特别针对振动信号采集系统中的常见问题提供解决方案,并附源码和避坑指南,帮助用户快速上手并避免常见错误。

weixin_30485379的博客 103

从GWAS到单细胞:利用seismic包精准定位疾病相关的关键细胞亚群与驱动基因

本文详细介绍了如何利用seismic包将GWAS与单细胞测序数据结合,精准定位疾病相关的核心细胞亚群与驱动基因。通过创新的统计算法和实战案例,帮助研究者从遗传汇总数据中挖掘关键生物学机制,提升疾病研究的精准度和效率。

weixin_29215815的博客 441

基于混合策略的改进灰狼优化算法

文章目录一、理论基础1、基本灰狼优化算法(GWO)2、改进的灰狼优化算法(IGWO)(1)非线性调整收敛因子aaa2、基于记忆指导的位置更新方程3、IGWO算法流程图二、实验对比和分析三、参考文献四、Matlab程序 一、理论基础 1、基本灰狼优化算法(GWO) 请参考这里。 2、改进的灰狼优化算法(IGWO) (1)非线性调整收敛因子aaa 受粒子群算法中惯性权重设置的启发,本文提出一种新的非线性调整收敛因子aaa的策略,计算公式如下:a(t)=ainitial−(ainitial−afinal)×log

心升明月的博客 6834

华为用自研的MetaERP替换全球顶级的SAP ERP系统,其难度与风险远超一次普通的技术升级,它是一场战略级的、涉及业务筋骨的系统性工程

华为成功用自研MetaERP替换SAP系统,这是一项极具挑战的战略工程。面临四大难度:业务复杂度高(170多国业务)、数据迁移量大(20年历史数据)、技术集成复杂(重构生态系统)、人员适应周期长。同时伴随四大风险:业务中断、数据失真、成本超支、供应链协同问题。华为成功的关键在于:生存压力驱动的战略决心、强大的软件研发能力、以自身业务为试验场、分步实施策略。这一案例证明中国企业能攻克高端软件壁垒,但对大多数企业而言,核心系统替换需谨慎评估风险,建议采用渐进式替代策略。

金牌架构师 535

改进的灰狼算法(IGWO)优化BP神经网络原理及MATLAB代码

改进的灰狼算法(improved grey wolf optimizer,IGWO)是Mohammad H. Nadimi-Shahraki等人在2021年基于GWO算法多样性差而提出改进智能算法。IGWO算法受益于一种新的运动策略,即基于维度学习的狩猎(DLH)搜索策略,它继承了自然界中狼的个体狩猎行为。DLH使用一种不同的方法为每只狼构建一个邻域,其中相邻的信息可以在狼之间共享,增强了局部搜索和全局搜索之间的平衡,并保持了多样性。

2403_88401503的博客 957

YOLO项目部署:从Python脚本到Docker容器的企业级交付全流程

YOLO模型企业级Docker部署方案 核心挑战 环境一致性:解决"本地能跑,服务器崩掉"问题 可扩展性:支持单实例到多实例扩展 稳定性:确保99.9%可用性 部署流程 项目改造:模块化代码,分离配置 Docker镜像:支持CPU/GPU环境 API服务:封装推理逻辑 监控告警:实现自动化运维 技术方案 需求 解决方案 环境一致性 Docker镜像+依赖冻结 可扩展性 K8s+负载均衡 稳定性 健康检查+自动重启 项目结构 模块化代码组织 外部化配置管理 精确依赖版本控制 摘要重点:通过

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1230

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

关于Opposition-Based Learning(OBL)算法

OBL 的主要概念是在搜索空间中引入对立的解,以提高搜索的多样性和全局性。它在各种应用领域都有潜在的用途,特别是在需要提高搜索全局性能和避免局部最优解的问题中具有价值。:OBL 引入了对立的解,这意味着每个候选解都有一个对立的解与之关联。对立解通常是通过一种对称性变换生成的,例如,通过取负值、翻转、旋转等方式。:在 OBL 中,搜索过程不仅考虑原始解,还考虑与之对立的解。:引入对立解可以提高搜索的全局性能,因为对立解通常位于搜索空间的不同区域。:在数据挖掘领域,OBL 可以用于聚类、分类、回归等任务。

FM_1793的博客 1951

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【路径规划-TSP问题】基于蚁群算法求解旅行商问题含Matlab代码

旅行商问题,即TSP问题(Trav01ingSalegmanProblem)是数学领域中著名问题之一,这是一个NP难题也是一个著名的组合优化问题.它广泛地应用于电力系统故障诊断,国防武器一目标分配(weapon—targetassignment)问题等领域.蚁群算法是模仿蚂蚁在寻找食物过程中的行为而形成的一种寻找优化路径的机率型模拟进化算法,经研究表明该算法具有许多优良的性质,具有一定的有效性和应用价值.根据蚂蚁寻找食物的行为和旅行商活动的相似性,利用蚁群算法可以求解旅行商问题,从而找到最短路径,实现最优解

matlab_dingdang的博客 780

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

一种改进智能算法新策略:联合对立选择算子

联合对立选择算子(Joint Opposite Selection, JOS)是两种对立学习技术的联合:选择性领导对立(Selective Leading opposition, SLO)和动态对立(Dynamic Opposite, DO)。SLO使用线性递减的阈值来确定搜索代理的近距离维度。DO为搜索代理提供了扩展其在搜索空间中的能力的机会。将JOS应用于哈里斯鹰优化(HHO)中,通过使用SL...

淘个代码 1775

反向学习相对基学习opposition-based learning简介

反向学习,相对基学习opposition-based learning简介 觉得有用的话,欢迎一起讨论相互学习~ Opposition-based learning OBL 在Tizhoosh(2005)[1]中首次引入了OBL作为一种新的计算智能方案。在过去的几年里,OBL已经成功地应用于各种基于种群的进化算法中 [2]-[10]。众所周知,从当前种群中随机生成一个解决方案,往往会导致重新访...

泛用演化计算、通用人工智能优化模型 5798

求解大规模优化问题的改进鲸鱼优化算法

提出一种基于非线性收敛因子的改进鲸鱼优化算法(简记为IWOA)用于求解大规模复杂优化问题。为算法全局搜索奠定基础,在搜索空间中利用对立学习策略进行初始化鲸鱼个体位置;设计一种随进化迭代次数非线性变化的收敛因子更新公式以协调 WOA算法的探索和开发能力;对当前最优鲸鱼个体执行多样性变异操作以减少算法陷入局部最优的概率。选取15个大规模(200维、500维和1000维)标准测试函数进行数值实验,结果表明,IWOA在求解精度和收敛速度方面明显优于其他对比算法。

心升明月的博客 3191

无人机夜视模块如何选择?——从参数指标到系统集成的完整选型指南

搜索为主→ 热成像识别为主→ 全彩夜视综合需求→ 双光谱成本敏感→ 红外补光在参数维度,重量、延迟、最低照度是三个最关键的指标。系统集成时,接口兼容性和与飞控/图传的配合是不可忽视的工程细节。

AiNightVision的博客 172
上一篇: DWTA问题的群优化算法
下一篇: 强化学习的数学原理(1-3)
Na_Lv
博客等级 码龄5年 2064粉丝 17原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值