DDP(DistributedDataParallel)自用笔记

Pytorch并行计算(二): DistributedDataParallel介绍 PyTorch并行计算一、为什么要并行计算?二、基本概念三、DistributedDataParallel的使用1. multiprocessing2. distributed二者区别一些BUG和问题 nn.parallel.DistributedDataParallel 这部分是nn.DataParallel的后续,想看nn.DataParallel的点击这里 为什么要用nn.parallel.DistributedDataParallel呢,首先我们看PyTorch官网对nn.DataParallel的 阅读详情

DDP 的工作原理——数据并行

当一张GPU可以存储一个model时,可以通过每张GPU都复制一份模型,在不同的GPU上运行不同的数据,即将一个批次的数据送入各个模型进行并行训练,通过对并行的GPUs上的数据和模型结果进行运算(求平均梯度...)来实现增大batch、提高速度的效果。
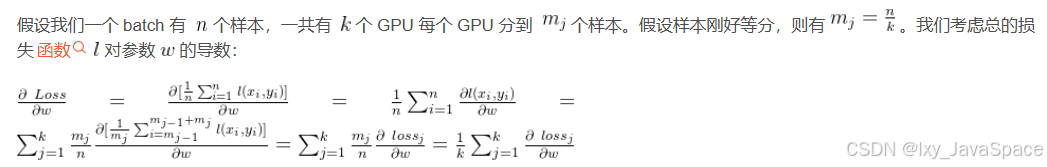
训练过程是多进程的,每一块GPU都对应一个进程,除非我们手动实现相应代码,不然各个进程的数据都是不互通的。

如果要用DDP来进行训练,我们通常需要修改三个地方的代码:数据读取器dataloader,日志输出print,指标评估evaluate。

1. DDP的训练过程

DDP的训练过程可以总结为如下步骤:

1)在训练开始时,整个数据集被均等分配到每个GPU上。每个GPU独立地对其分配到的数据进行前向传播(计算预测输出)和反向传播(计算梯度)。

2)通过Ring-All-Reduce算法同步各个GPU上的梯度,以确保模型更新的一致性。

3)一旦所有的GPU上的梯度都同步完成,每个GPU使用这些聚合后的梯度来更新他的模型副本参数,也就是step的过程。因为每个GPU都使用相同的更新梯度,所以所有的模型副本在任何时间点上都是相同的。

2.DDP的名词定义

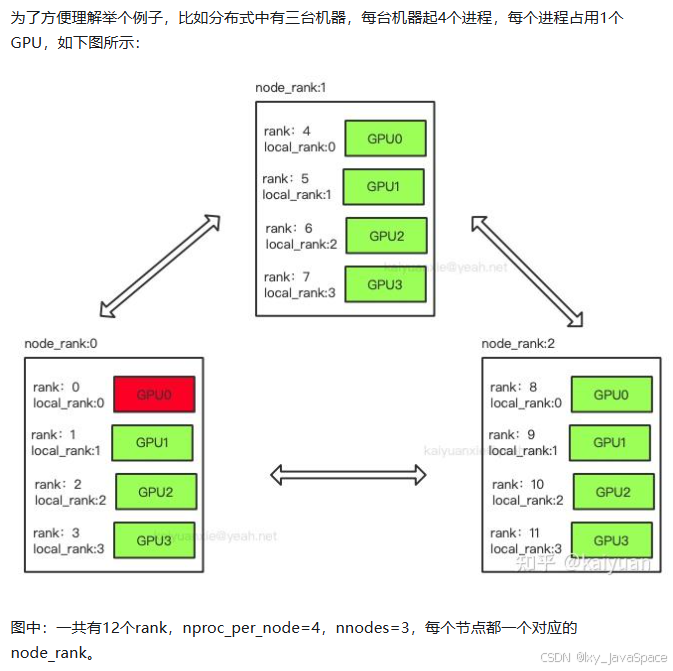
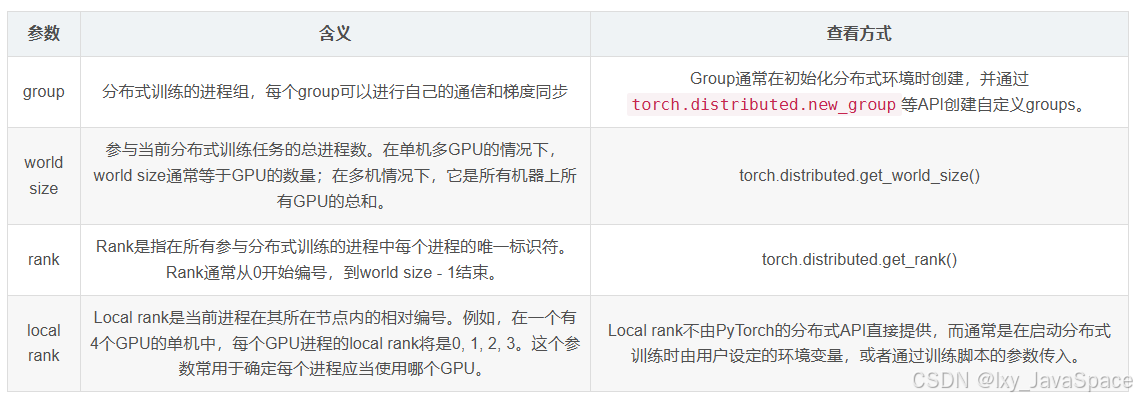
rank:一个分布式训练的进程号,一个序号表示一个进程,一个分布式训练由多个rank进程组成。

node:物理节点,可以是一台机器也可以是一个容器,节点内部可以有多个GPU。

rank与local_rank: rank是指在整个分布式任务中进程的序号;local_rank是指在一个node上进程的相对序号,local_rank在node之间相互独立。

nnodes、node_rank与nproc_per_node: nnodes是指物理节点数量,node_rank是物理节点的序号;nproc_per_node是指每个物理节点上面进程的数量。

word size : 全局(一个分布式任务)中,rank的数量。

master_addr与master_port:主节点的地址以及端口,供init_method 的tcp方式使用。 因为pytorch中网络通信建立是从机去连接主机,运行ddp只需要指定主节点的IP与端口,其它节点的IP不需要填写。 这个两个参数可以通过环境变量或者init_method传入。
3. DDP是如何分布式的并行的运行代码的:

分布式训练通过启动多个进程,每个进程负责不同的 GPU 或部分计算任务。

--use_env 会自动设置分布式训练所需的环境变量,主要包括:

  • RANK:全局进程 ID。
  • WORLD_SIZE:总进程数。
  • LOCAL_RANK:当前进程对应的 GPU 索引(在本地节点上的 GPU 编号)。
  • MASTER_ADDR:主节点地址。
  • MASTER_PORT:主节点通信端口。

例如,假设你使用两张 GPU(nproc_per_node=2),会启动两个进程,分别负责 GPU 0 和 GPU 1。每个进程都会独立执行 main(args)。

## init_distributed_mode:
#给每个进程分配local rank序号,指导gpu的device序号
args.gpu = int(os.environ['LOCAL_RANK'])   

这时,init_distributed_mode会根据环境变量进行初始化,比如说,上面两个进程,会分别得到:

arg.gpu=0和arg.gpu=1

Rank: 0, Local Rank: 0, World Size: 2
Rank: 1, Local Rank: 1, World Size: 2

还有一个问题:

获得多gpu方法:

logging.info(f'GPU is available:{torch.cuda.is_available()}')
    if torch.cuda.is_available():
        gpus = torch.cuda.device_count()
        for i in range(gpus):
            print(f'\t GPU{i}.:{torch.cuda.get_device_name(i)}')

如果要想高效的处理并行运算:

可以使用nn.parallel.DataParallel或nn.parallel.DistributedDataParallel,如:

从其他文章中学习的第一版(个人感觉不太符合我的需求):

在指定gpu的时候,如果device='cuda',并且是ddp多卡运行,那么xx.to(device)默认选择第一个卡作为选中的gpu,这意味着,即使系统中有多块 GPU,这条命令也只会指向默认的一块。比如:

device = torch.device(args.device)  # args.device='cuda'
model.to(device)

model 会在“cuda:0”上。

下面这种一次性输入多个device给ddp,不符合我一张gpu处理一个进程的需求,(不考虑):
#指定多个GPU
from torch.nn import DataParallel
#上面这一行一定要加,因为没加一直报错都开始怀疑torch版本是不是有问题了哈哈
import os
os.environ['CUDA_VISIBLE_DEVICES']='0,2,3,4'#代表使用的第一块,第三块,第四块和第五块卡
device_ids = [0,2,3,4]
model  = torch.nn.Dataparallel(model, device_ids =device_ids)
model = model.cuda()

或:

model = torch.nn.Dataparallel(model)  
# 默认适用所有gpu(这种可以通过CUDA_VISIBLE_DEVICES在命令行中指定使用的gpu)

二改:

DDP单机多卡的gpu定义问题

torch.nn.parallel.DistributedDataParallel (简称 DDP) 时,device_ids参数指定的是 每个进程负责的设备列表,而不是整个系统的所有设备。

torch.nn.parallel.DistributedDataParallel的作用是copy model给每个进程。所以,该函数中的device_ids参数告诉 DDP 当前进程应该使用哪些设备(通常是一个或多个 GPU),并且这些设备是该进程独占的。
对于单机多卡训练,device_ids通常是每个进程对应的单个 GPU 的设备 ID 列表,如 [0], [1]。
如果一个进程负责多个 GPU,则 device_ids可以是一个列表,如 [0, 1]。(但通常不这样)

所以,正确代码:

torch.cuda.set_device(args.local_rank)  # 设置当前进程使用的 GPU
model = DistributedDataParallel(model, device_ids=[args.local_rank])

这样的话,每个model使用的device_ids就是当前进程分配的gpu id:例 [0]。

参考:Pytorch DistributedDataParallel(DDP)教程一:快速入门理论篇_distributeddataparallel教程-优快云博客PyTorch分布式训练基础--DDP使用 - 知乎

PyTorch 源码解读之 DP & DDP:模型并行和分布式训练解析_runtimeerror: distributeddataparallel is not neede-优快云博客

多卡训练DataParallel和DistributedDataParallel的使用和区别 分布式训练,DataParallel,DistributedDataParallel,DP,DDP,init_process_group,单机单卡,单机多卡,多机多卡 阅读详情

相关推荐

学习使用DDP: DistributedDataParallel

WORLD_SIZE:总进程数量,通常每个进程都会被分配一个唯一的 rank,而 world_size 就是所有进程的总数量。和:这两个环境变量用于指定主进程的地址和端口号。在分布式训练中,主进程通常用于协调其他进程的工作。LOCAL_RANK和LOCAL_SIZE: 这两个环境变量是 torch.distributed.launch 工具特有的,用于指定当前进程在本地节点上的 local_rank 和节点上 GPU 的总数量 local_size。RANK和WORLD_SIZE。

blueag1e的博客 2233

PyTorch:DistributedDataParallel(DDP)学习

PyTorch:DistributedDataParallel纸上谈兵(无实际测过)

weixin_46782905的博客 2431

DDP, DistributedDataParallel 是什么

是 PyTorch 提供的一个用于分布式训练的工具,它可以将。将其包装起来进行分布式训练。每个进程负责一个 GPU,通过。)模块,用于在多 GPU 或多节点环境下进行分布式训练。在这个示例中,我们定义了一个简单的玩具模型。以下是一个简单的示例,展示了如何使用。实现梯度的同步和模型的更新。PyTorch 中的。

ZhangJiqun&191cm&85kg 167

DistributedDataParallel多GPU分布式训练全过程总结 跟着做90%成功

DistributedDataParallel分布式训练全教程什么是DistributedDataParallel为什么是DistributedDataParallel要不要装别的库教程一、初始化二、加一个解析参数三、数据集四、设定device五、模型加载到多gpu六、数据加载到gpu七、最后一句命令参考 什么是DistributedDataParallel 一种基于pytorch框架的分布式训练工具(也就是让你用多GPU来训练) 为什么是DistributedDataParallel nn.DataPar

qq_40564301的博客 9637

Windows 11 上 WSL2 安装 Ubuntu 22.04 保姆级教程(含桌面环境配置)

本文提供在Windows 11上通过WSL2安装Ubuntu 22.04并配置桌面环境的详细教程。涵盖WSL2核心安装、性能调优、Xfce桌面环境部署以及开发环境集成,帮助开发者构建高效、无缝的Windows-Linux混合开发工作站。

Jerry的专栏 634

DRAM知识整理系列(三):部分时序参数整理

一、tCL-tRCD-tRP-tRAS(第一时序) 内存是根据行和列寻址的,当请求触发后,最初是tRAS(Active to precharge Delay),预充电后,内存才真正开始初始化RAS(Row Address Strobe)。一旦tRAS激活后,RAS开始进行需要数据的寻址。首先是行地址,然后初始化tRCD(RAS to CAS Delay),周期结束,接着通过CAS(Column Address Strobe)访问所需数据的十六进制地址。其中,从CAS开始到CAS结束,就是CAS延迟(即t

不吃鱼的猫的博客 7万+

pytorch单机多卡DistributedDataParallel (DDP)分布式训练

利用pytorch的DistributedDataParallel进行单机多卡分布式训练。

xwyljt的博客 3321

基于FPGA 外置qspi Flash的读写

fpga上实现flash读写代码

weixin_43498765的博客 4956

DDP(DistributedDataParallel) 分布式训练1——入门上手

DistributedDataParallel(DDP)是一个支持多机多卡、分布式训练的深度学习工程方法。

哦豁灬 1万+

Autodesk全家桶怎么选?AutoCAD、Revit、Fusion 360等7款软件超全对比指南

本文深入对比了Autodesk旗下七款核心软件(AutoCAD、Revit、Inventor、Fusion 360、Maya、3ds Max、Forge)的核心定位与适用场景。针对建筑、制造、创意设计等不同专业需求,提供精准的选型指南,帮助用户根据自身工作流(如二维绘图、BIM协同、产品开发、影视动画)选择最匹配的工具,避免资源浪费并提升效率。

stone的博客 434

《低功耗方法学》翻译——卷首语

低功耗设计方法学。

记录所学,分享知识,结识挚友 993

DDP(DistributedDataParallel) 分布式训练3——实践与技巧

1 在 DDP 中引入 syncBN 1.1 syncBN SyncBN就是Batch Normalization(BN)。其跟一般所说的普通BN的不同在于工程实现方式:SyncBN能够完美支持多卡训练,而普通BN在多卡模式下实际上就是单卡模式。 BN中有moving mean和moving variance这两个buffer,这两个buffer的更新依赖于当前训练轮次的batch数据的计算结果。但是在普通多卡DP模式下,各个模型只能拿到自己的那部分计算结果,所以在DP模式下的普通BN被设计为只利用主卡上的

哦豁灬 1万+

RT-DETR模型应用过程中的报错处理及疑问解答,涉及环境搭建、模型训练、模块改进、论文写作

本文记录了RT-DETR模型的这一系列过程中可能发生的问题,以及大家非常关心的问题,这里统一做了一个记录和解答。

Limiiiing的博客 1768

pytorch分布式数据并行DistributedDataParallel(DDP)

DistributedDataParallel(DDP)在module级别实现数据并行性。它使用torch.distributed包communication collectives来同步梯度,参数和缓冲区。并行性在单个进程内部和跨进程均有用。在一个进程中,DDP将input module 复制到device_ids指定的设备,相应地按batch维度分别扔进模型,并将输出收集到output_device,这与DataParallel相似。Across processes, DDP inserts neces

云中寻雾的博客 7834

高创伺服的龙门调试经历2

摘要:本文介绍了高创伺服在龙门控制中的配置方法。首先通过ServoStudio2连接驱动器并命名区分主从轴(MASTER/DIFF),然后设置接口模式、23位编码器参数及极限位置。重点说明龙门模式的三项关键参数设置(gantryfbenmode=1、gantrymode=1/2)和连线状态确认。建议单轴自动整定后调整从轴增益(如0.2),并强调带刹车电机的同步控制要点:刹车线需接同一继电器由主轴控制,避免位置偏差。

wzz418550729的博客 916

使用Matlab simulink的PLC coder功能进行算法搭建与处理

使用的案例如下: Anti-Windup PID Control Demonstration with Feedforward Control 将其中的PID块生成SCL语言再导入TIA 使用的平台如下: Matlab 2019b TIA portal 15.1 应用:可以在PLC中搭载一些并不方便使用的,或者比较难使用的算法 步骤如下: 首先打开案例,案例地址我放在最下面,点击Run运行仿真,必...

苦走一口田 1万+

Python DistributedDataParallel(DDP)训练模型

Python 训练模型 文章目录Python 训练模型前言一、DistributedDataParallel(DDP)二、使用步骤1. 简单命令例子## 2.读入数据总结 前言 最近在搞DistributedDataParallel(DDP)模型训练,踩了不少坑,总结一下,以后遇到问题,可以看一下。 一、DistributedDataParallel(DDP) DistributedDataParallel(DDP)支持多机多卡分布式训练。说效率更高,所以想用一下。 重要参考 二、使用步骤 1. 简单

qq_37422545的博客 2088

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

PyTorch 分布式 DistributedDataParallel (DDP)

这篇博客将带你深入 DDP 的核心,彻底理解它的工作原理、关键组件、与 DP 的本质区别,以及它如何借助 NCCL 等后端实现高效通信,助你真正释放分布式计算的潜力。这几个关键组件的用法,你就能驾驭这个强大的工具,显著加速你的模型训练过程,并为迈向更大规模的分布式计算打下坚实的基础。它简单易用,但其固有的主 GPU 瓶颈、GIL 限制和低效的通信模式,往往让它在实际应用中难以充分发挥多 GPU 的威力。DDP 是 PyTorch 官方推荐的、用于严肃的分布式训练场景的首选方案。操作进行梯度同步,并实现了。

weixin_52861033的博客 1651

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

PyTorch多卡分布式训练:DistributedDataParallel (DDP) 简要分析

©作者 | 伟大是熬出来的单位 | 同济大学研究方向 | 机器阅读理解前言因为课题组发的卡还没有下来,先向导师问了实验室的两张卡借用。之前都是单卡训练模型,正好在这个机会实践以下单机多卡训...

Paper weekly 4696

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Pytorch DistributedDataParallel(DDP)教程二:快速入门实践篇

一个简单的Pytorch DDP实例代码和讲解

weixin_42364196的博客 4472

DistributedDataParallel(DDP)分布式单机多GPUS训练

pytorch官方链接 使用过程中总结大概需要以下几步: 1、设置local_rank及device(启动器开启后,会将当前进程的(其实就是 GPU的)index 通过参数传递给python环境local_rank参数中); 2、初始化分布式环境、进程间通信; 3、DDP包装model; 4、采样器包装dataset 5、数据输入to.(device)或者.cuda() 6、用torch.distributed.launch启动(其他方式不作分享).........

ywfwyht的博客 2085

Pytorch DistributedDataParallel(DDP)教程一:快速入门理论篇

,简明扼要地介绍一下DDP的使用,抛开繁杂的细节和原理,帮助快速上手使用(All in one blog)。 篇幅较长,分为上下两篇:这篇简要介绍相关背景和理论知识,下篇详细介绍代码框架和搭建流程。

weixin_42364196的博客 3177

DDP及其在pytorch中应用

1 分布式训练及其分类 本部分内容引用自:https://zhuanlan.zhihu.com/p/72939003 分布式训练是为了应用多卡显卡加速模型的训练,可以分为三类: 按照并行方式分,可分为模型并行和数据并行; 按照更新方式分,可分为同步更新和异步更新; 按照算法来分,可分为Parameter Server和Ring AllReduce算法。 数据并行 vs 模型并行: 模型并行:模型大到单个显卡放不下的地步,就把模型分为几个部分分别放于不同的显卡上单独运行,各显卡输入相同的数据; 数据并行

cdknight_happy的专栏 1万+

【PyTorch教程】PyTorch分布式并行模块DistributedDataParallel(DDP)详解

PyTorch中的Distributed Data Parallel模块是什么?DistributedDataParallel 和 DataParallel 有什么区别?PyTorch中的Distributed Data Parallel模块如何加速训练?读完本文相信你会得到答案。

Sihang_Xie的博客 2635

Pytorch分布式训练DDP:DistributedDataParallel

DistributedDataParallel分布式训练,是Pytorch官方推荐用户使用的分布式方法:它为每张GPU拷贝一个完整的模型副本,并通过AllReduce操作在反向传播阶段自动同步各副本的梯度,从而确保每张卡在参数更新时始终保持一致。

weixin_48222697的博客 1544

pytorch教学:torch.nn.parallel.DistributedDataParallel(DDP分布式训练)

DDP训练大致是一个GPU开一个线程,如果有两个GPU,则将dataset分成2份,然后一个GPU读取一份 下面的代码能正确使用DDP分布式训练,直接参考即可 注:本代码只适用于单机多卡训练,多机多卡的由于资源有限还没试过 在终端的运行命令: python -m torch.distributed.launch --nproc_per_node 2 train.py 其中2表示你有几个GPU import datetime import os import torch from torch impor

j879159541的博客 6942
上一篇: 查看网络grad
下一篇: Contiguous()到底怎么用,什么时候用
叙利亚男篮
博客等级 码龄6年 31粉丝 13原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值