大模型布署如何选择GPU资源?

Nvidia GPU系列产品分析 Nvidia的GPU发展了30多年,已经逐渐形成了消费级、专业级、AI加速等不同计算任务的GPU系列。纵观Nvidia的GPU发展历程,其不断迭代的GPU架构以及性能强劲的GPU互联技术成了Nvidia始终站在市场顶峰的决胜法宝。 阅读详情

当前主流GPU型号及其显存大小(显存“大小”)的详细分类汇总,结合消费级、专业工作站级及数据中心级三大应用场景,数据综合自行业常用型号及最新产品信息(截至2025年6月):


🎮 一、消费级显卡(游戏/个人创作)

主要用于游戏娱乐、视频剪辑、轻量AI学习等场景。

​​GPU型号​​​​显存大小​​​​显存类型​​​​核心架构​​​​典型应用场景​​​​参考价(美元)​​
​​RTX 4090​​24 GBGDDR6XAda Lovelace4K游戏、AI绘图、轻量模型训练1,599–2,000
​​RTX 4080 Ti​​20 GBGDDR6XAda Lovelace高帧率2K/4K游戏、视频渲染1,199
​​RTX 4070 Ti​​12–16 GBGDDR6XAda Lovelace1440p游戏、直播推流799–899
​​RTX 4060​​8–12 GBGDDR6Ada Lovelace1080p游戏、入门AI299–399
​​RX 7900 XT​​20 GBGDDR6RDNA 3竞品4K游戏、多屏创作899–1,099
​​Arc A770​​16 GBGDDR6Xe-HPG性价比游戏、编解码加速349

​​注​​:消费级显卡显存多为​​GDDR6/GDDR6X​​,容量在​​8–24GB​​之间,适合单机任务,不支持多卡互联或ECC纠错。


🖥️ 二、专业工作站显卡(设计/仿真/AI开发)

面向工业建模、影视特效、中小规模AI训练等专业场景。

​​GPU型号​​​​显存大小​​​​显存类型​​​​架构​​​​核心特点​​
​​RTX 6000 Ada​​48 GBGDDR6 ECCAda Lovelace顶级渲染、支持vGPU分片
​​RTX 5000 Ada​​32 GBGDDR6 ECCAda Lovelace8K视频编辑、光线追踪预览
​​RTX 4500 Ada​​24 GBGDDR6 ECCAda LovelaceCAD/CAM/医疗影像
​​RTX A6000​​48 GBGDDR6 ECCAmpere科学计算、传统渲染主力
​​RTX A5500​​24 GBGDDR6 ECCAmpere虚拟现实、多屏输出工作站

​​特点​​:专业卡普遍配备 ​​ECC纠错显存​​,容量​​24–48GB​​,支持NVLink扩展(如A6000双卡可达96GB)。


🚀 三、数据中心/AI计算卡(大模型/HPC)

专为千亿参数大模型训练、超算中心等高强度任务优化。

​​GPU型号​​​​显存大小​​​​显存类型​​​​互联技术​​​​AI算力(FP16)​​​​典型用途​​
​​H100 NVL​​188 GBHBM3NVLink 4.0≈8,000 TFLOPSGPT-5级别大模型训练
​​H100 SXM​​80 GBHBM3NVLink 900GB/s≈2,000 TFLOPS超算集群、AI云服务
​​A100 80GB​​80 GBHBM2eNVLink 600GB/s≈312 TFLOPS主流大模型训练
​​H800​​80 GBHBM3受限NVLink≈1,979 TFLOPS中国市场合规版训练集群
​​L40S​​48 GBGDDR6 ECCPCIe 4.0≈362 TFLOPS企业AI推理、云渲染
​​T4​​16 GBGDDR6PCIe 3.0≈65 TFLOPS高密度推理、边缘计算

​​关键区别​​:

  • 支持多卡NVLink互联,显存可聚合(如双H100 NVL = 376GB);
  • 支持FP8/TF32等AI优化精度及MIG虚拟化分片。

与当代显卡的对比定位​​

​​指标​​​​V100​​​​A100​​​​H100​​​​消费级(RTX 4090)​​
​​架构​​Volta (2017)Ampere (2020)Hopper (2022)Ada Lovelace (2022)
​​FP32算力​​15.7 TFLOPS19.5 TFLOPS67 TFLOPS83 TFLOPS
​​Tensor算力​​125 TFLOPS (FP16)312 TFLOPS (FP16)2,000 TFLOPS (FP8)1,321 TFLOPS (FP16)
​​显存带宽​​900 GB/s1.5 TB/s (HBM2e)3.35 TB/s (HBM3)1 TB/s (GDDR6X)
​​定位级别​​​​上一代旗舰​​​​主流数据中心​​​​当前旗舰​​​​消费级天花板​

💎 四、如何选择GPU显存?

根据任务类型推荐显存容量:

  • ​​≤8GB​​:1080p游戏、办公、网页开发
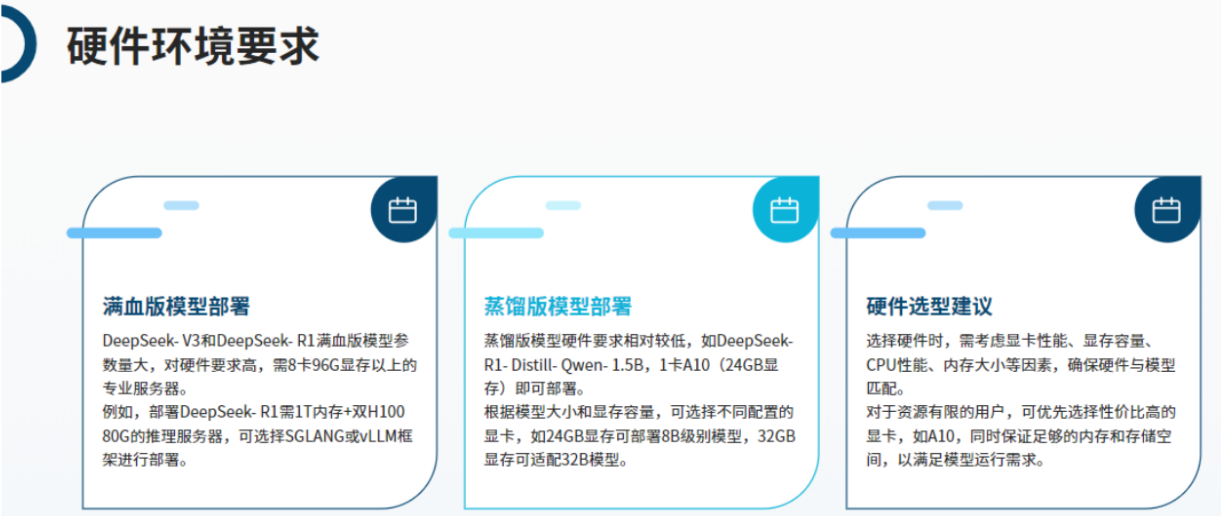
  • ​​12–16GB​​:2K游戏、Stable Diffusion绘图、Llama 2-13B推理
  • ​​24GB​​:4K视频剪辑、UE5开发、70B级LLM微调
  • ​​48GB+​​:影视级光线追踪、科学模拟、≥千亿参数训练

三、对比其他数据中心GPU(企业采购参考)​​

​​GPU型号​​​​显存/带宽​​​​FP16算力​​​​适用场景​​​​性价比优势​​
​​A10​​24GB GDDR6/600GB/s125 TFLOPSAI推理、图形渲染、视频处理⭐⭐⭐⭐⭐(成本最低)
​​V100​​32GB HBM2/900GB/s125 TFLOPS大型模型训练⭐⭐(二手价约2万)
​​T4​​16GB GDDR6/320GB/s65 TFLOPS轻量推理、边缘计算⭐⭐⭐⭐(低功耗)
​​A100​​80GB HBM2e/2TB/s312 TFLOPS千亿参数训练⭐(单价超10万)

✅ ​​企业选型建议​​:

  • ​​推理/渲染首选A10​​:预算有限且需高并发(如16卡服务器成本仅12万)

    ​​训练选A100/V100​​:需大显存和NVLink扩展

  • 边缘计算选T4​​:低功耗+高能效比

💡 ​​显存类型比大小更重要​​:

  • 大模型训练 → 选 ​​HBM显存 + 高带宽​​(如H100)
  • 高并发推理 → 选 ​​低功耗 + 高能效比​​(如L40S/T4)
  • 多任务虚拟化 → 选 ​​支持MIG​​ 的型号(如A100/H100)

服务器测试之GPU基础汇总 GPU英文全称Graphic Processing Unit,中文翻译为“图形处理器”。一个专门的图形核心处理器。GPU是显示卡的“大脑”,决定了该显卡的档次和大部分性能,同时也是2D显示卡和3D显示卡的区别依据。可以形象的理解为90%的ALU(运算单元),5%的Control(控制单元)、5%的Cache(缓存单元)GPU的设计原理——总结为大量的简单运算。 阅读详情

相关推荐

AI Agent开发第84课-paddleocr-vl全网唯一最全本地化布署教程

本文详解 PaddleOCR-VL 本地化布署全过程,指出为何在真实生产环境中 PaddleOCR-VL 更稳定、更易部署、更贴近工程落地。同时还会详细比较与 DeepSeek-OCR 的核心差异,为全网独家介绍paddleocr-vl的本地部署实战指南。

打造全国最全的AI Agent开发知识领域的博客 5969

GPU基本概念--GPU 的主要类型

不同类型的 GPU 根据其设计目标和应用场景有不同的特点和适用范围。选择合适的 GPU 类型取决于你的具体需求,如性能、功耗、成本和应用场景等AI GPU 可以根据其设计目标和应用场景分为几类,包括数据中心和高性能计算 GPU、专业级 GPU、消费级 GPU、国产 AI GPU 和虚拟 GPU。每种类型都有其独特的特点和适用范围,选择合适的 AI GPU 需要考虑你的具体需求,如性能、功耗、成本和应用场景等。

MHD0815的博客 3163

23数字图像置乱技术(matlab程序)

所谓“置乱”,就是将图像的信息次序打乱,a像素移动到b像素位置上,b像素移动到c像素位置上,……,使其变换成杂乱无章难以辨认的图片。数字图像置乱技术属于加密技术,是指发送发借助数学或者其他领域的技术,对一幅有意义的数字图像做变换,使之变成一幅杂乱无章的图像用于传输。在图像传输过程中,它通过对图像像素矩阵的重排,破坏了图像矩阵的相关性,使非法截获者无法从杂乱无章的图像中获得原图像信息,以此实现信息的加密。接收方经去乱解密可恢复原图像。

m0_57943157的博客 1209

如何选择GPU?

[AI开发]深度学习如何选择GPU? 机器推理在深度学习的影响下,准确性越来越高、速度越来越快。深度学习对人工智能行业发展的贡献巨大,这得益于现阶段硬件计算能力的提升、互联网海量训练数据的出现。本篇文章主要介绍深度学习过程中如何选择合适的GPU显卡,如果你是深度学习新手,希望这篇文章对你有帮助。 推理用到的硬件分两种,一种是专业AI硬件公司出的AI芯片,一种就...

m0_38101947的博客 858

wsl2 配置ubuntu 固定ip

wsls ubuntu 设置固定ip

musk1212的博客 2621

使用TensorFlow Lite Micro流程记录(带源码)

记录如何使用tensorflow lite micro,以及期间解决的问题

ZhaoDongyu_AK47的博客 6217

Nvidia核心技术和用于AI训练的高端工业级显卡

这是 Nvidia 的最新数据中心 GPU,具有高达 80 GB 的显存、6912 个 CUDA 核心和 432 个 Tensor 核心,适用于最大规模的 AI 模型训练和推断。: 这是一款最强大的消费级 GPU,具有高达 72 GB 的显存、4608 个 CUDA 核心和 576 个 Tensor 核心,适用于大型模型的训练和推断。: 这是一款用于数据中心和高性能计算的 GPU,适用于大规模的 AI 模型训练和推断。这些显卡都是非常强大的,不同的应用场景和预算可以选择不同型号的显卡。

roxxo的博客 8686

手把手教你用STM32CubeMX和HAL库驱动DW3000:从SPI配置到第一个测距Demo

本文详细介绍了如何使用STM32CubeMX和HAL库驱动DW3000 UWB定位通信模块,从SPI配置到实现厘米级测距Demo的全过程。涵盖硬件连接、SPI通信调试、驱动移植及双向测距(TWR)算法实现,帮助开发者快速掌握UWB高精度定位技术,适用于仓储物流、智能家居等场景。

weixin_27038245的博客 485

无需网络,轻松在手机上离线布署本地大模型

无需网络,轻松在手机上离线布署本地大模型

DEVELOPERAA的博客 5483

中文实体关系抽取数据集大盘点:从百度Duie2.0到医疗CBLUE,哪个更适合你的NLP项目?

本文全面分析了中文实体关系抽取领域的主流数据集,包括百度DuIE 2.0、医疗CBLUE等,帮助开发者根据项目需求选择最适合的数据集。文章详细对比了各数据集的特点、适用场景及优化策略,为自然语言处理项目提供实用指南。

weixin_29284657的博客 122

YOLOv13必学核心:SKAttention选择性核注意力机制原理 + 实战全拆解

SKAttention的核心思想来源于人类视觉系统的一个重要特性:根据不同的视觉刺激,人眼能够自适应地调整感受野大小。SKAttention将这一生物学原理转化为深度学习中的注意力机制,通过动态选择和融合不同大小的卷积核,实现了自适应的多尺度特征提取。在人类视觉皮层中,不同的神经元具有不同大小的感受野,而且这些感受野的大小会根据视觉刺激的类型动态调整。本文将深入解析SKAttention模块的设计原理、数学基础、实现细节,以及其在YOLOv13目标检测框架中的集成应用,为读者提供全面而深入的技术理解。

FJN110的博客 97

无需网络,轻松在手机上离线布署本地大模型(附教程)

无需网络,轻松在手机上离线布署本地大模型(附教程)

DEVELOPERAA的博客 4731

Cesium 实战 28 - 三维视频融合(视频投影)

Cesium 实战 27 - 三维视频融合(视频投影)。

非科班Java出身GISer的博客 3371

AirLLM突破性方案:低资源环境下大模型部署的技术革命

在人工智能大模型时代,70B参数模型通常需要80GB以上显存的专业GPU支持,这一高门槛将众多开发者和中小企业挡在AI应用的大门之外。AirLLM通过创新的内存优化技术,实现了在单张4GB GPU上流畅运行70B大模型的突破,彻底改变了大模型部署的硬件需求格局。本文将从核心价值、技术突破、实践指南到场景拓展四个维度,全面解析这一低资源部署方案的实现原理与应用方法。 ## 一、核心价值:重新定义大

gitblog_00648的博客 316

使用 ABAP Development Tool 登录 SAP BTP ABAP 环境时,遇到弹出框应该怎么办?

但在实际环境里,隐私模式、第三方 Cookie 禁止、跨站追踪限制、缓存代理误命中、混合内容拦截等因素,都可能让这条跳转链路被打断。等),浏览器会弹出系统原生登录框,请求用户输入账号和口令或做集成认证。只要它们在响应头里出现,浏览器就会理直气壮地弹框,这是协议层的强约定。,最终弹出原生登录框。前端与网关领域有个通用的经验规则:如果你看到了原生登录框,而期望的是带样式的。环境里的登录方式表述为基于浏览器的前端认证,也就是这类重定向式的交互。环境的具体落地,拆出几类常见诱因与排障路径,并穿插真实世界的案例。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 375

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

体验AI大模型省钱攻略:云端GPU按需付费,比买显卡省万元

本文介绍了基于星图GPU平台,如何自动化部署📄 AI 智能文档扫描仪 -镜像,实现高效、低成本的AI应用开发。用户可按需启动GPU资源,快速构建文档扫描与识别系统,适用于合同数字化、票据处理等场景,无需高成本硬件投入,显著提升办公自动化效率。

MoonstoneFalcon62的博客 251

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

大模型部署技巧总结,大模型入门到精通!

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 1104

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

DeepSeek开源模型本地化部署攻略:无需GPU,三步轻松实现!

deepseek和chatGpt最大的区别就在于,它是开源的模型,并且训练成本更低,这使得我们普通人也能够在自己的电脑部署大语言模型,训练自己的AI智能体。我们需要谨记的就是,AI是工具,是为了提高我们的效率,它能够给我们提供更精确,更具逻辑的回答,你再根据自身的需求进行修改和采用。最近Deepseek访问量剧增,导致App时常访问不了,但是不用担心,官方给我们提供了本地部署大模型的方案。

2401_84204207的博客 2273

50多G,1000+文件|DeepSeek从入到精通、本地布署视频+PPT精讲、应用视频+PPT精讲、AIGC、大模型汇总

在人工智能飞速发展的时代,大模型和 AIGC(人工智能生成内容)技术正深刻地改变着我们的生活和工作方式。DeepSeek 作为这一领域的新兴力量,以其卓越的性能和创新的应用,吸引了众多关注的目光。本文将通过一系列视频和 PPT 精讲,带你深入了解 DeepSeek,从基础概念到本地部署,再到丰富的应用场景,全面掌握这一强大工具。文末附获取方式大模型,即基于深度学习技术构建的具有海量参数的模型,它能够通过对大规模数据的学习,实现对自然语言、图像、音频等多种数据的理解和处理。以 DeepSeek 为代表的大模型

weixin_44094929的博客 1541

本地大模型部署(下载) vs. 从头训练大模型

本地大模型部署(下载) vs. 从头训练大模型:核心区别与技术选择

海的博客 807

无需网络,手机上轻松部署本地大模型

一旦模型加载完成,进入“聊天”页面并开始与加载的模型对话!生成性能指标也会显示。如果感兴趣,可以通过观察聊天气泡查看实时性能指标:每秒令牌数和每个令牌的毫秒数。

2401_85390073的博客 6000

大模型部署技巧

本文是实用生成式人工智能应用系列文章的一部分。在这一系列文章里,我们呈现了来自顶尖生成式人工智能实践者的现实世界解决方案和实操经验。当大多数人提及大语言模型,他们可能会想到 OpenAI 旗下的某款模型。这些模型不仅规模大,而且功能强大,托管在 OpenAI 的服务器上,并通过网络 API 进行调用。这些基于 API 的模型调用是快速尝试 LLM 的一种方式。然而,企业也可以选择部署自己的模型。部署或自托管 LLM 是一项具有挑战性的任务,并不像调用 OpenAI 的 API 那样简单。

Python_cocola的博客 1306

AI大模型多并发部署:从理论到实践

随着人工智能技术的快速发展,AI大模型(如GPT、BERT等)在自然语言处理(NLP)和计算机视觉(CV)领域取得了显著的成果。这些模型能够生成高质量的文本内容或进行精准的图像识别,广泛应用于聊天机器人、智能写作、图像识别等场景。然而,大模型的部署和运行面临着巨大的挑战,尤其是在高并发场景下。本文将详细介绍AI大模型多并发部署的理论基础、实际部署步骤、性能优化方法以及实际案例分析,帮助读者从理论到实践全面掌握这一技术。本文详细介绍了AI大模型多并发部署的理论基础、实际部署步骤、性能优化方法以及实际案例分析。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 2232

你想在本地部署大模型吗?本地部署大模型的三种工具

人工智能的发展如火如荼,也让越来越多的人了解到人工智能;而对大部分人来说使用的都是第三方提供的客户端,不论是网页版,还是PC端或移动端。那么,我们怎么在本地部署一款大模型呢?下面就来介绍三种工具。01本地部署大模型的三种工具gpt4all是一款可以本地部署大模型的客户端工具,其支持window,macOS和ubuntu(一款linux桌面系统)系列。其官网地址:https://gpt4all.io/index.html。

2401_84205765的博客 893

小白程序员轻松上手部署DeepSeek大模型,开启AI创新之旅

本文介绍了DeepSeek大模型的开源特性及其对全球AI竞争格局的影响。详细阐述了DeepSeek R1模型的本地化部署流程,包括运行环境要求、依赖工具安装以及可视化部署方法。通过Ollama工具下载并运行DeepSeek R1模型,实现本地化部署,保障数据安全并灵活定制业务场景。DeepSeek大模型为企业智能化转型提供了可靠的技术底座,展现了与私有化场景深度融合的技术潜力。

aolan123的博客 420
上一篇: ​​CentOS 7.9​​ 上配置 ​​Fail2ban 自动封禁 IP​​ 的完整步骤,整合了多篇权威资料的最佳实践
下一篇: 管理经验分享2025612【解决不可能完成的事情】
学博成
博客等级 码龄17年 915粉丝 175原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值