


最近,一篇题为《Language Models are Injective and Hence Invertible》的论文在学术界与科技圈引发热议,连马斯克旗下的 Grok 官方账号也转发了相关动态。
该论文来自意大利罗马第一大学 GLADIA 研究实验室,其中提出了一个颇具争议却引人深思的观点:当前主流的 Transformer 语言模型在信息处理过程中几乎不会丢失原始输入内容,从数学角度来看,它们具有可逆性。
换言之,模型的隐藏状态并非对语义的模糊压缩,而更像是对输入信息的一种完整、精确的重新编码。这一发现不仅动摇了人们对语言模型“理解”机制的传统认知,也促使研究者进一步追问:这种理论上的信息无损特性,在实际模型中是否真实存在?
一、研究背景:为什么语言模型的"可逆性"如此重要?
在我们深入讨论之前,先来聊聊这个问题的背景。长期以来,社区普遍认为Transformer架构是"信息有损"的——比如,LayerNorm会对每个样本进行归一化,相当于抹平了部分差异;注意力机制可能将多个位置的信息融合,导致细节丢失。这种观点引发了对大模型透明度和安全性的担忧:如果模型内部状态无法唯一对应输入,那么我们就很难追溯模型的决策过程,甚至在隐私保护、模型审计等领域埋下隐患。
但这篇论文的切入点非常巧妙:作者们没有陷入"组件是否非线性"的争论,而是直接聚焦于语言模型作为一个整体函数,从离散输入序列到连续隐藏状态的映射关系。他们发现,只要模型参数是随机初始化的(比如用高斯分布),并且通过标准梯度下降训练,那么不同提示词几乎必然(概率为1)对应不同的最后词元(last-token)隐藏状态。这种单射性不仅在初始化时成立,还会在整个训练过程中保持!

研究意义在于,它首次从理论上保障了语言模型内部表示的完整性:隐藏状态不是模糊的抽象,而是输入的"无损编码"。这为可解释性、隐私合规(例如用户数据删除要求)、甚至模型窃取攻击的防御提供了新基础。举个例子,监管机构常争论"模型权重是否包含个人数据",而这篇论文表明:一旦用户输入进入模型,其信息就完整保存在隐藏状态中,删除提示词并不等于删除数据(参见论文第6节讨论)。
二、模型架构:单射性如何被证明?SIPIT算法如何工作?
2.1 单射性的数学基础:实分析与测度论
论文的核心证明依赖于实分析(Real Analysis工具。作者将Transformer视为一个参数化函数,并证明其每个组件(嵌入层、LayerNorm、因果注意力、MLP)都是实解析的(real-analytic)。实解析函数有一个关键性质:如果两个不同输入导致相同输出,那么这种情况只可能发生在参数空间的一个"测度为零"的集合上(想象成一条细线在广阔平面中的面积为零)。而标准初始化(如高斯分布)几乎必然避开这种 pathological 参数设置。
具体来说,作者定义了最后词元表示函数 r(s;θ),其中 s是输入序列,θ是模型参数。他们通过构造性证明(见论文定理2.2)显示:对于任意两个不同提示词 ,总存在一组参数使得 θθ。这意味着差异函数 θθθ不恒为零,因此其零集测度为零。训练过程中,梯度下降的更新映射也是实解析的,从而保持参数分布的绝对连续性,避免落入碰撞集。

2.2 SIPIT算法:利用因果结构逐词元还原
单射性本身是理论结果,但论文进一步提出了SIPIT(Sequential Inverse Prompt via Iterative Updates)算法,将理论变为实践。SIPIT的核心思想非常直观:利用Transformer的因果掩码机制,从隐藏状态逐位置反向推导输入词元。
具体流程如下(对应论文算法1):
- 输入:观测到的某一层隐藏状态矩阵(其中 T是序列长度)。
- 逐位置恢复:从第一个位置开始,对于每个位置 t:
- 已知前缀 π(已恢复的部分)。
- 对词汇表 V中的每个候选词 v,计算其对应的预测隐藏状态 π(即模型在给定前缀 π下,将 v作为第 t个词时的隐藏状态)。
- 比较预测状态与观测状态,找到唯一匹配的词(由于单射性,匹配是唯一的)。
- 输出:完整序列
关键创新点:
- 因果局部性:由于因果注意力机制,位置 t的隐藏状态只依赖于前缀和当前词,因此只需局部搜索。
- 线性时间保证:最坏情况下,SIPIT最多进行 次验证(词汇表大小乘以序列长度),但实际中通过梯度引导策略(如对候选词排序)大幅加速。
- 鲁棒性:即使隐藏状态有噪声,只要误差小于最小间隔 π,,仍能正确恢复(论文命题D.2)。
简单类比:这就像破解一个密码锁,我们已知每个齿轮的最终位置(隐藏状态),然后从第一个齿轮开始,逐个尝试数字(候选词),直到匹配为止。由于每个齿轮只受前面齿轮影响,问题被分解为独立的局部问题。
三、实验结果:单射性是否真的成立?SIPIT有多高效?
3.1 碰撞测试:数十亿次比较无一例外
论文在6个主流模型上进行了大规模实验,包括GPT-2系列、Gemma-3系列、Llama-3.1、Mistral等。作者从Wikipedia、C4等数据集中采样10万条提示词,提取最后词元隐藏状态,并进行了约50亿次 pairwise 比较。

核心发现:
- 零碰撞:所有模型和所有层中,不同提示词的最后词元状态距离均严格大于 10−6(碰撞阈值),最小距离在 10−3量级(图3)。
- 深度效应:隐藏层越深,最后词元状态的区分度越大(图3右),说明深层网络强化了单射性。
- 长度稳定性:随着序列长度增加,最小距离先快速上升后趋于稳定(图5),表明模型在不同长度下均保持分离性。

3.2 反转效率:SIPIT实现100%准确恢复
作者进一步测试SIPIT算法在GPT-2 Small上的反转任务。他们采样100条提示词(90%为自然句子,10%为随机词序列),仅使用隐藏状态进行恢复。
对比基线:
- HARDPROMPTS(基于梯度的提示词发现方法):无法精确恢复输入。
- 暴力搜索(Brute-force):虽能最终恢复,但耗时高出几个数量级。
结果(论文表2):
- SIPIT在所有提示词上实现100%词级别准确率,且耗时随序列长度线性增长。
- 反转时间随层深略有增加,但整体保持高效(图6)。

局限性:
- 计算成本与词汇表大小 线性相关,对于超大词汇表需优化。
- 当前仅针对Decoder-only模型,多模态扩展是未来方向。
个人思考:这项研究将如何影响未来?
这篇论文的突破不仅在于理论严谨(几乎必然性证明),更在于其实践价值。它告诉我们:语言模型的隐藏状态本质上是"明文"的另一种形式——任何能够访问隐藏状态的系统(如云服务中间层)实际上都能还原用户输入。这直接冲击数据隐私和合规设计:例如,欧盟GDPR要求"被遗忘权",但如果隐藏状态可逆,单纯删除输入记录可能不够,需重新审视模型部署架构。
未来方向:
- 扩展到多模态模型:论文框架可能适用于视觉、音频Transformer,验证跨模态单射性。
- 近似反转研究:在量化或噪声环境下,如何保持鲁棒性?
- 安全应用:例如基于可逆性的模型水印或侵权检测。
最后,我想用一句话总结:这项研究将语言模型从"黑盒"推向"玻璃盒",为我们理解大模型提供了新的数学基础。作为研究者,我们应该思考如何利用这种可逆性增强透明度,而不是视其为威胁。毕竟,理解是控制的第一步!
最后
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包:
- ✅AI大模型学习路线图
- ✅Agent行业报告
- ✅100集大模型视频教程
- ✅大模型书籍PDF
- ✅DeepSeek教程
- ✅AI产品经理入门资料
如果你也想通过学大模型技术去帮助自己升职和加薪,可以扫描下方链接👇👇
为什么说现在普通人就业/升职加薪的首选是AI大模型?
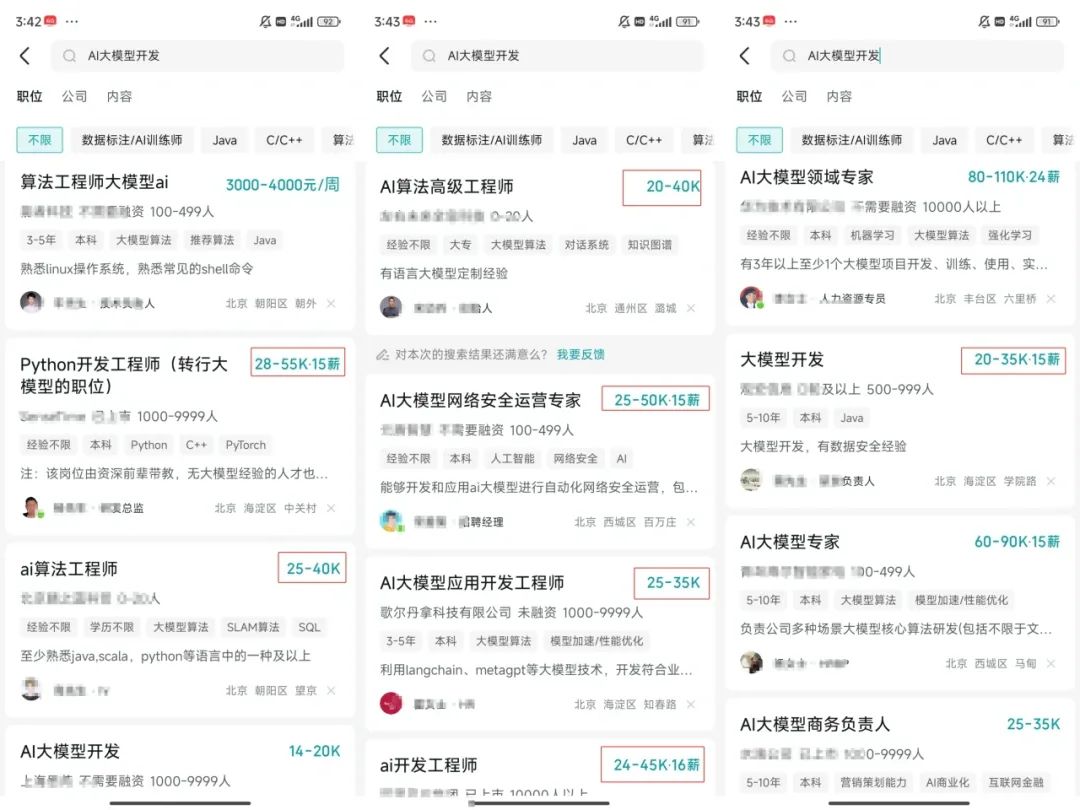
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
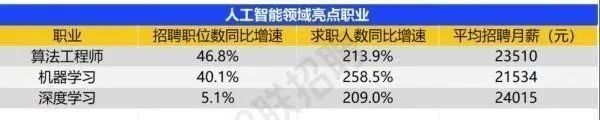
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
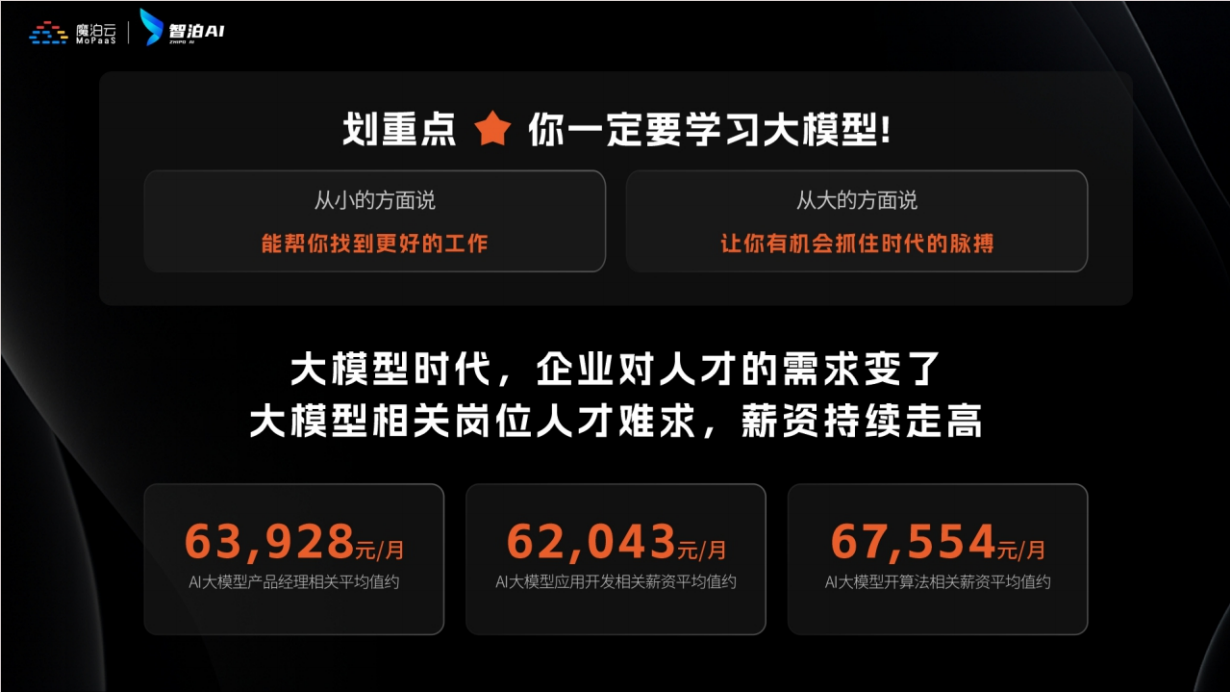
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
资料包有什么?
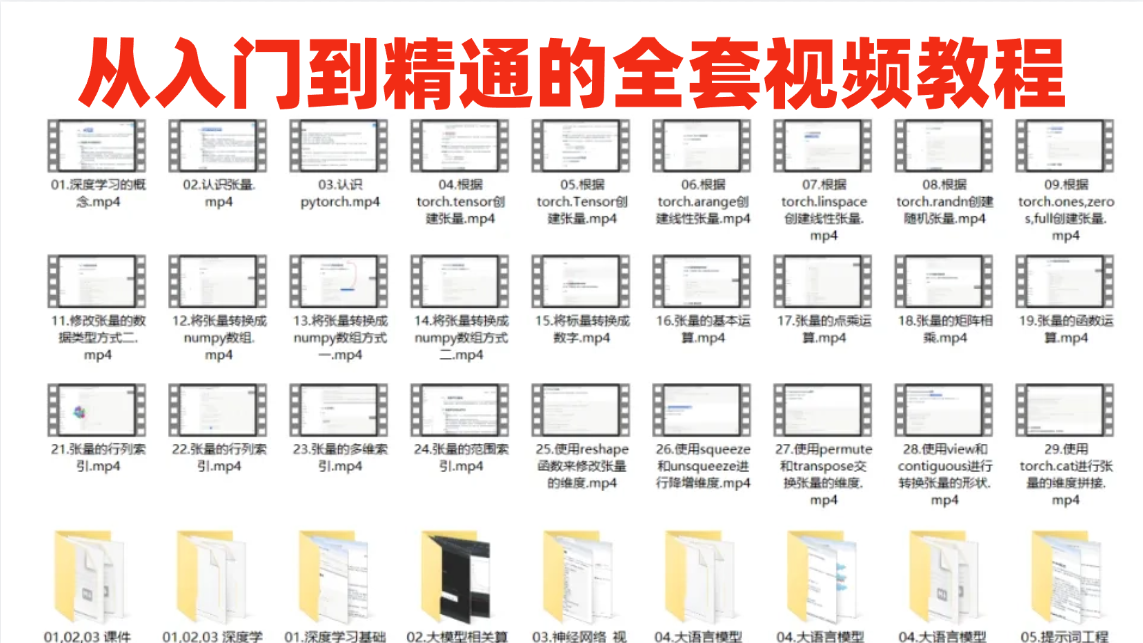
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
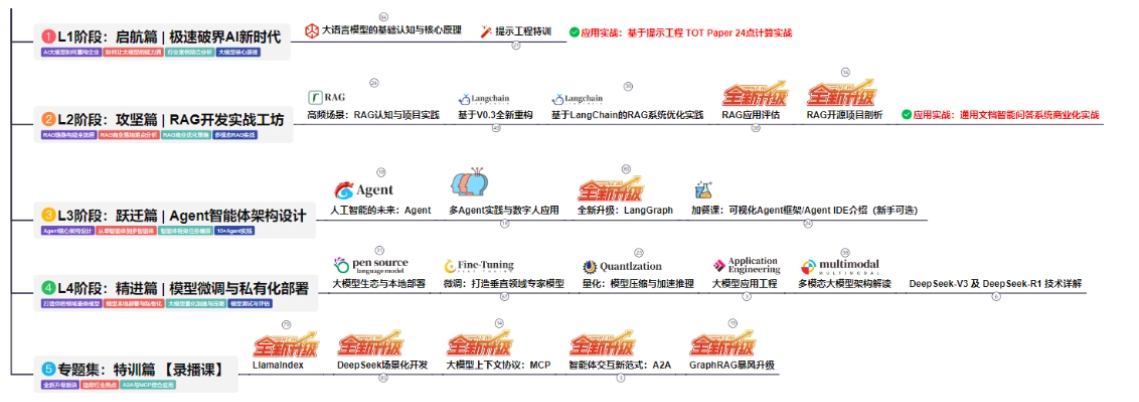
② AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
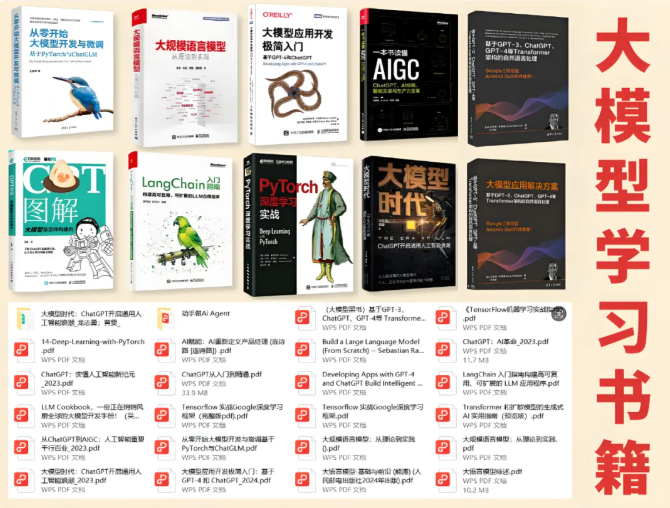
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
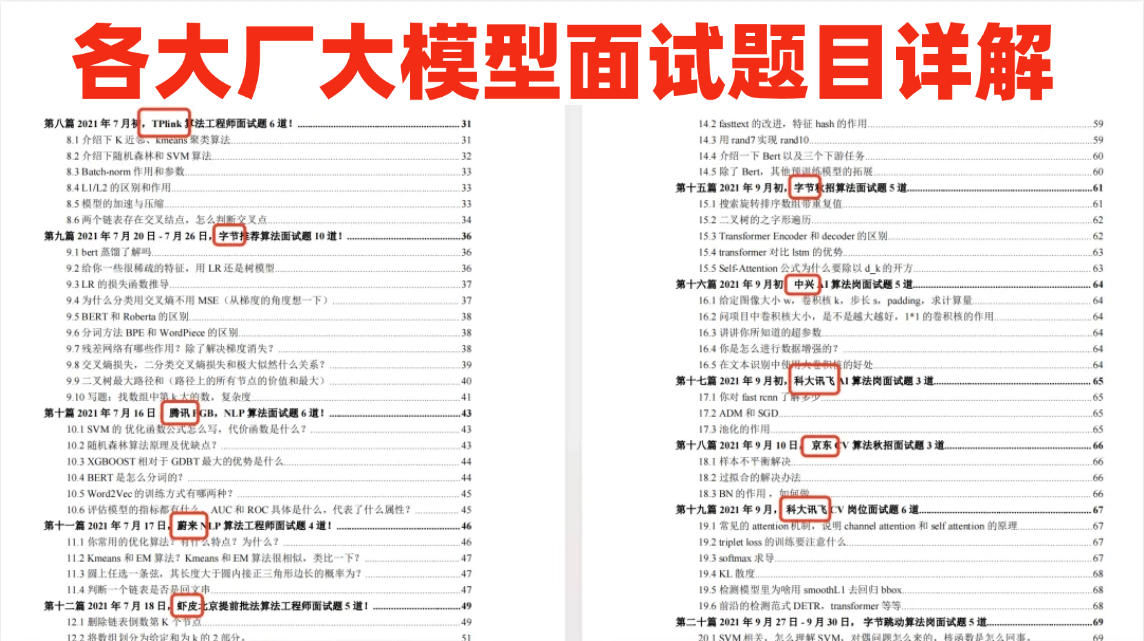
④各大厂大模型面试题目详解
⑤ 这些资料真的有用吗?
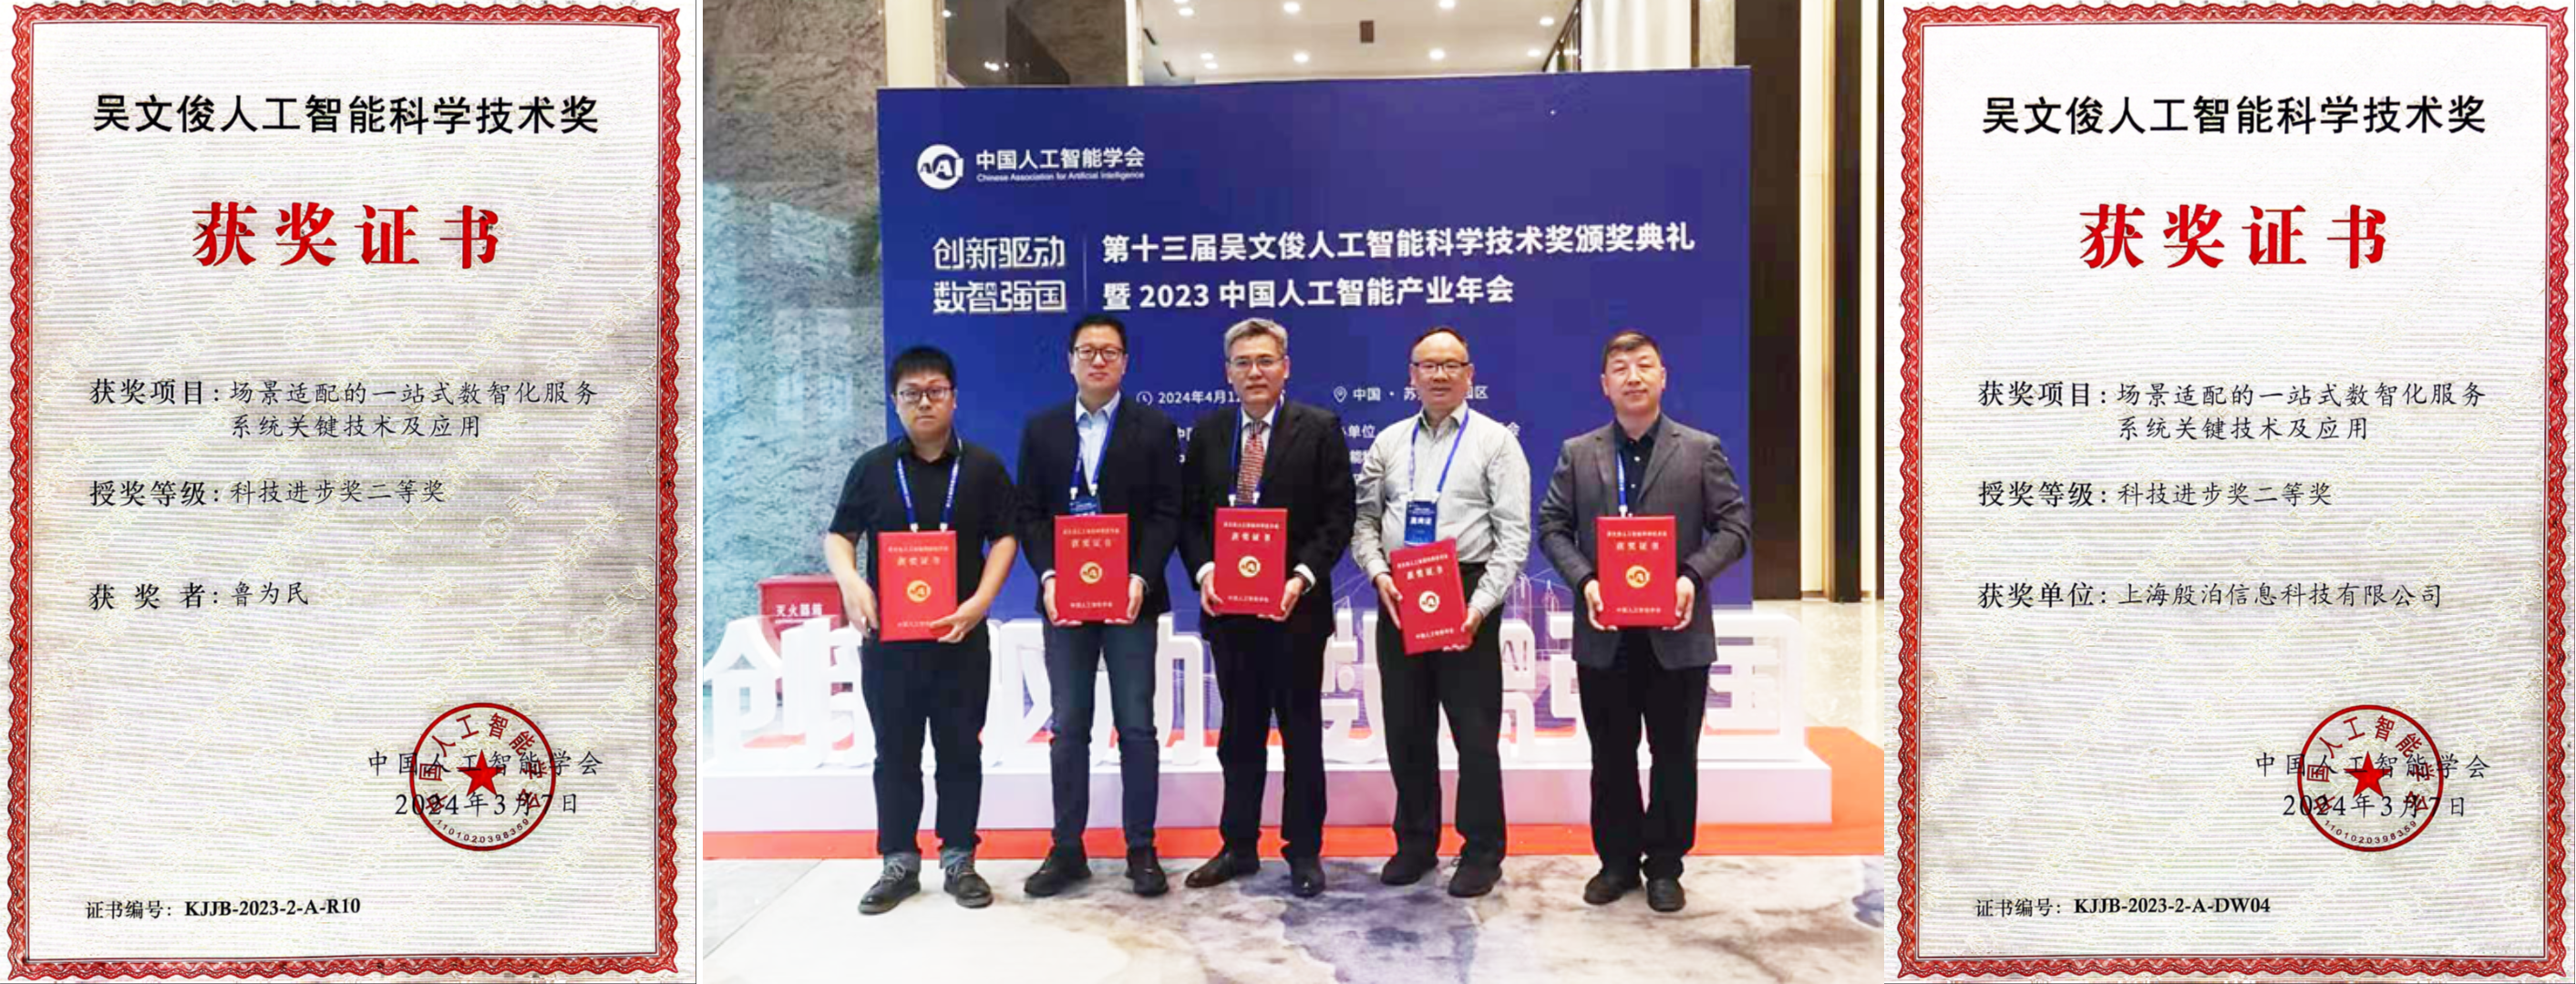
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
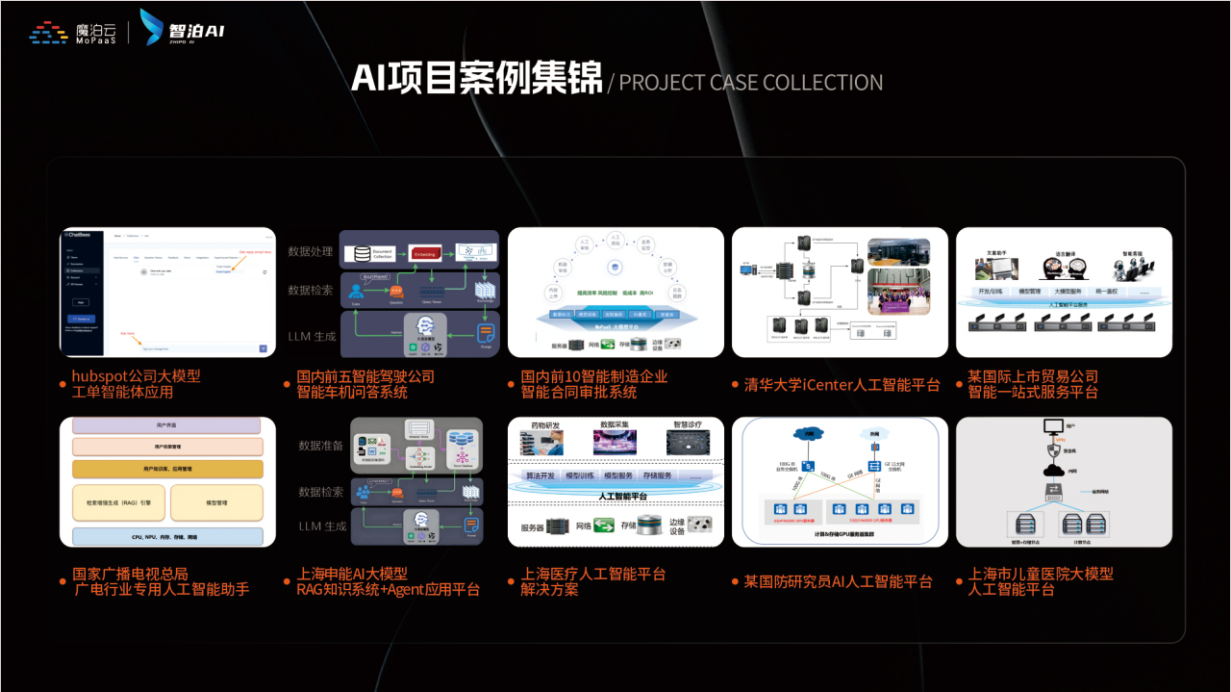
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**
 439


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


