


文生图/txt2img
文生图是Stable Diffusion中最基础、最实用也是最好玩的功能。顾名思义,文生图通过简单的文字描述(英文)就能生成你想要的图片。当然这个图片肯定不是完美的,如若你想生成完美的、惊艳的图片,还需要深入了解和学习文生图详细参数和功能。掌握和熟悉出图技巧,让你十秒即可出图!这就是本篇文章的目的,快来学习吧!
老规矩,提神时刻!

什么?很一般?

概览
整个SD webui 的功能其实不多,上手也比较容易,但是想出好图还是得把每个功能都研究透彻。

从图片我们就能得知整个sd webui有哪些功能。左上角是大模型选择,紧接着就是webui的功能菜单(文生图,图生图等)。两个大的文本框就跟用户息息相关:提示词Prompt和反向提示词Negative prompt。这个两个文本框是生图的关键设置,你的文字描述就是放在Prompt里面。
左下角就是我们的详细出图参数,下面会详细介绍,其他区域就是生成按钮和出图区域。
接下来我们就详细介绍各个部分功能,作者不是领域专家,如有错误,请包涵!
大模型

是什么?
是一种拥有完整结构的稳定扩散模型,是一个你拿过来即使不写提示也能生图的模型。
哪里可以获取呢?
C站、HuggingFace、Discord也可以找到。。。当然我这也有。
怎么用?
选择模型*(国风),点击生成按钮。如下。

没有提示词的效果也不错哈!
Prompt和Negative prompt
这两部分就是文生图的核心部分,描述准确、精炼的提示词能让的创作得心应手。
Prompt
用文字描述你想要生成的东西
支持自然语言处理,如:
A girl with long hair, Laurie. She has long hair and a double ponytail design
但更建议逐个关键词用逗号隔开,如:
1girl,loli,long hair,low twintails
Negative prompt
用文字描述你不想在图像中出现的东西
一般会直接用通用文本粘贴进去,特殊需求再单独修改
如:
lowres,bad anatomy,bad hands,text,error,missing fingers,
extra digit,fewer digits,cropped,worst quality,
low quality,normal quality,jpeg artifacts,signature,
watermark,username,blurry,missing arms,long neck,
Humpbacked,missing limb,too many fingers,
mutated,poorly drawn,out of frame,bad hands,
unclear eyes,poorly drawn,cloned face,bad face
更详细的 tag 语法后面再展开,这个环节建议以体验为主

让我们看看prompt提示词,如下
best quality ,masterpiece, illustration, an extremely delicate and beautiful, extremely detailed ,CG ,unity ,8k wallpaper, Amazing, finely detail, masterpiece,best quality,official art,extremely detailed CG unity 8k wallpaper,absurdres, incredibly absurdres, huge filesize , ultra-detailed, highres, extremely detailed,beautiful detailed girl, extremely detailed eyes and face, beautiful detailed eyes,light on face,(Hanfu:1.1),1girl, full body,full-body shot,
翻译结果:

Negative prompt(反向/负面提示词)
sketches, (worst quality:2), (low quality:2), (normal quality:2), lowres, normal quality, ((monochrome)), ((grayscale)), skin spots, acnes, skin blemishes, bad anatomy,(long hair:1.4),DeepNegative,(fat:1.2),facing away, looking away,tilted head, {Multiple people}, lowres,bad anatomy,bad hands, text, error, missing fingers,extra digit, fewer digits, cropped, worstquality, low quality, normal quality,jpegartifacts,signature, watermark, username,blurry,bad feet,cropped,poorly drawn hands,poorly drawn face,mutation,deformed,worst quality,low quality,normal quality,jpeg artifacts,signature,watermark,extra fingers,fewer digits,extra limbs,extra arms,extra legs,malformed limbs,fused fingers,too many fingers,long neck,cross-eyed,mutated hands,polar lowres,bad body,bad proportions,gross proportions,text,error,missing fingers,missing arms,missing legs,extra digit, extra arms, extra leg, extra foot,
翻译结果:
Prompt和Negative prompt是有使用技巧的,这里就不展开讨论。后续会专门开这一块的介绍。前期我们会复制粘贴就行。当然你肯定会问哪里粘贴?
- C站:https://civitai.com/images
- prompthero:https://prompthero.com/
- Majinai:https://majinai.art/index.php
- 词图:https://www.prompttool.com/NovelAI
- Black Lily:http://heizicao.gitee.io/novelai/#/book
- Danbooru 标签超市:https://tags.novelai.dev/
- AI 词汇加速器:https://ai.dawnmark.cn/
- NovelAI 魔导书:https://thereisnospon.github.io/NovelAiTag/
使用提示词的效果:多了很多细节,出图也跟描述的差不多

出图参数详解
以下是详细的出图参数介绍,一一介绍,一看就会。

采样器/Sampling method

Stable Diffusion的webUI中,提供了大量的采样器供我们选择,例如Eular a, Heum,DDIM等,不同的采样器之间究竟有什么区别,在操作时又该如何进行选择,下文将会详细讲解采样器是如何工作的,以及各种采样器的优劣对比。
以下信息搜集网络,文末有引用链接
- Euler a :有很高的多样性,tag利用率仅次与DPM2和DPM2 a。但是构图有时很奇葩,而且步数大于30,效果减弱
- Euler:柔和,也适合插画,环境细节与渲染好,背景模糊较深。同时是最简单、最快的
- LMS 是 Euler 的衍生,它们使用一种相关但稍有不同的方法(平均过去的几个步骤以提高准确性)。大概30step可以得到稳定结果,更倾向于动画的风格
- 4.Heun:单次出图平均质量比Euler和Euler a高,但速度最慢,高step表现好。
- 5.DPM2:该采样方法对tag的利用率最高,几乎占80%+
- 6.DPM2 a:几乎与DPM2相同,是对于DDIM的改进,减少步骤以获得良好的结果,它的速度大约是DDIM的两倍,生图效果也非常好
- 7.DPM fast:此为上界开发者所遗留的测试工具,不适合魔术师使用
- 8.LMS Karras:会大改成油画的风格,写实不佳。
- 9.DDIM:适合宽画,速度偏低,高step表现好,负面tag不够时发挥随意,环境光线与水汽效果好,写实不佳。
- 10.UniPC 效果较好且速度非常快,对平面、卡通的表现较好,推荐使用。
- 11.DDIM 收敛快,但效率相对较低,因为需要很多 step 才能获得好的结果,适合在重绘时候使用。
- 12.PLMS 是 Euler 的衍生,可以更好地处理神经网络结构中的奇异性。
- 待补充
这些大部分的采样器是由Katherine Crowson根据论文实现的功能,stable diffusion官方的blog也提到过她,她在github中有一个名为K-diffusion的项目,理论基础主要基于Jiaming Song等人的论文、Karras等人的论文以及前不久基于Cheng Lu等人的论文!
其他补充
祖先采样器
名称中带有a标识的采样器表示这一类采样器是祖先采样器。这一类采样器在每个采样步骤中都会向图像添加噪声,采样结果具有一定的随机性。
Karras后缀
LMS Karras 基于Karras论文,运用了相关Karras的noise schedule的方法,可以算作是LMS使用Karras noise schedule的版本;
DPM2 Karras,DPM2 a Karras,DPM++ 2S a Karras,DPM++ 2M Karras,DPM++ SDE Karras这些含有Karras名字的采样方法和上面LMS Karras意思相同,都是相当于使用Karras noise schedule的版本;
采样步数/Sampling steps
Stable Diffusion 的工作方式是从以随机高斯噪声起步,向符合提示的图像一步步降噪接近。随着步数增多,可以得到对目标更小、更精确的图像。但增加步数也会增加生成图像所需的时间。增加步数的边际收益递减,取决于采样器。一般开到 20~30。
记住一点:步数设置区间20-30

采样相关参数配合展示

面部修复/Restore faces
修复画面中人物的面部,但是非写实风格的人物开启面部修复可能导致面部崩坏。

无缝贴图/Tiling
用于生成一个可以平铺的图像

高分辨率修复/Hires. fix
通过勾选 “Highres. fix” 来启用。默认情况下,文生图在高分辨率下会生成非常混沌的图像。如果使用高清修复,会型首先按照指定的尺寸生成一张图片,然后通过放大算法将图片分辨率扩大,以实现高清大图效果。最终尺寸为(原分辨率*缩放系数 Upscale by)。
- 放大算法中,Latent 在许多情况下效果不错,但重绘幅度小于 0.5 后就不甚理想。ESRGAN_4x、SwinR 4x 对 0.5 以下的重绘幅度有较好支持。
- Hires step 表示在进行这一步时计算的步数。
- Denoising strength 字面翻译是降噪强度,表现为最后生成图片对原始输入图像内容的变化程度。该值越高,放大后图像就比放大前图像差别越大。低 denoising 意味着修正原图,高 denoising 就和原图就没有大的相关性了。一般来讲阈值是 0.7 左右,超过 0.7 和原图基本上无关,0.3 以下就是稍微改一些。实际执行中,具体的执行步骤为 Denoising strength * Sampling Steps。

图片大小等
设置宽度/Width,高度/Height,生成批次/Batch count,每批数量/Batch size

提示词引导系数/CFG Scale
图像与你的提示的匹配程度。增加这个值将导致图像更接近你的提示,但它也在一定程度上降低了图像质量。可以用更多的采样步骤来抵消。过高的 CFG Scale 体现为粗犷的线条和过锐化的图像。一般开到 7~11。CFG Scale 与采样器之间的关系:

图像生成种子/Seed
种子决定模型在生成图片时涉及的所有随机性,它初始化了 Diffusion 算法起点的初始值。

脚本/Script
这一块内容很多,也很专业,一般使用也不用用的。我个人了解也不是很深入,后续了解比较多了,再给大家开介绍。

关于AI绘画技术储备
学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!
对于0基础小白入门:
如果你是零基础小白,想快速入门AI绘画是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案
包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!
需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

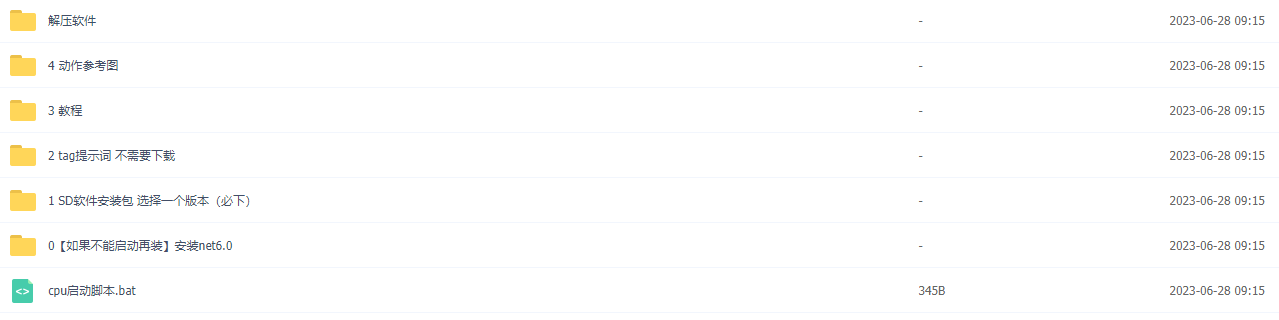
1.stable diffusion安装包 (全套教程文末领取哈)
随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。
最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
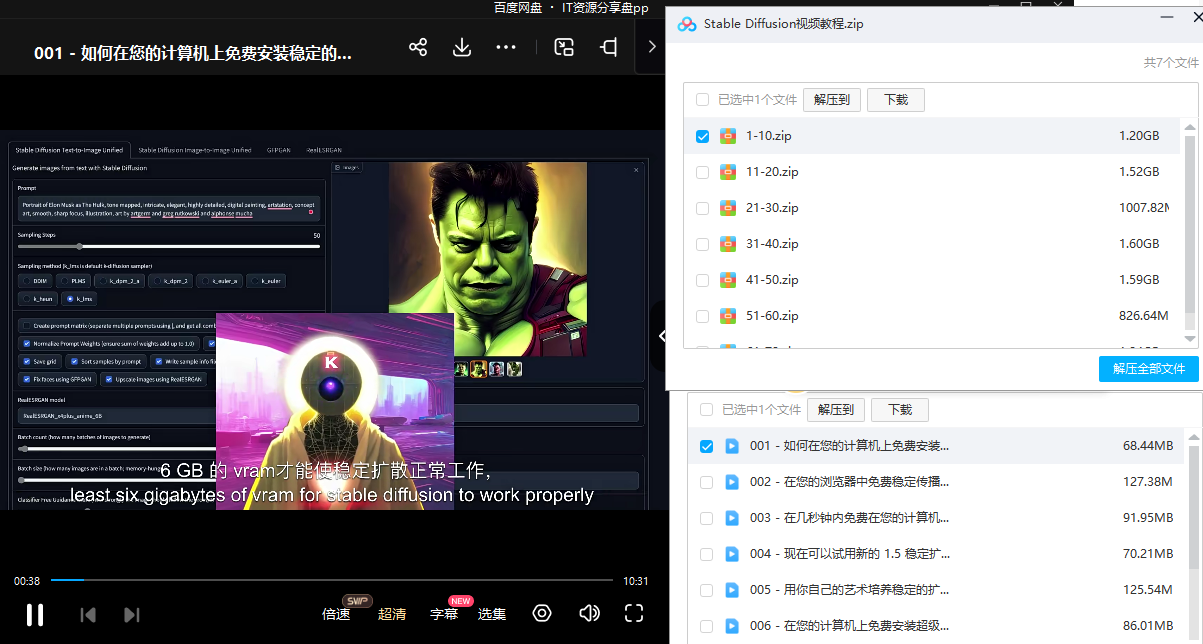
2.stable diffusion视频合集
我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
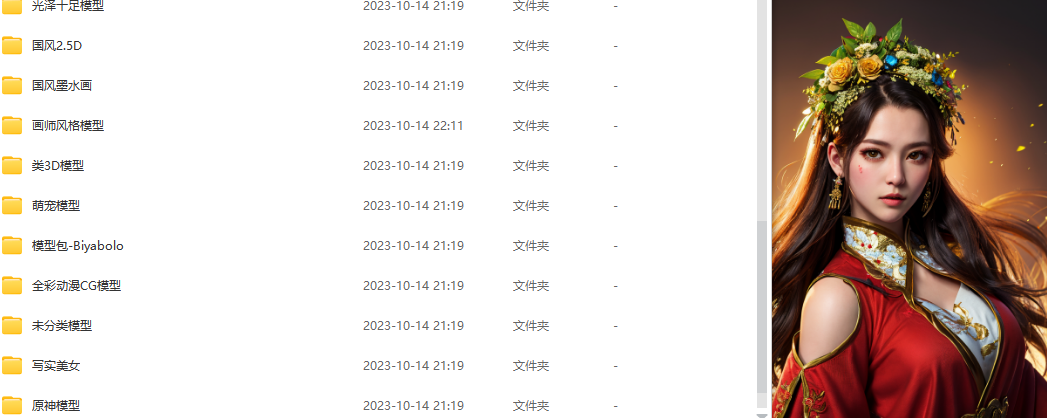
3.stable diffusion模型下载
stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
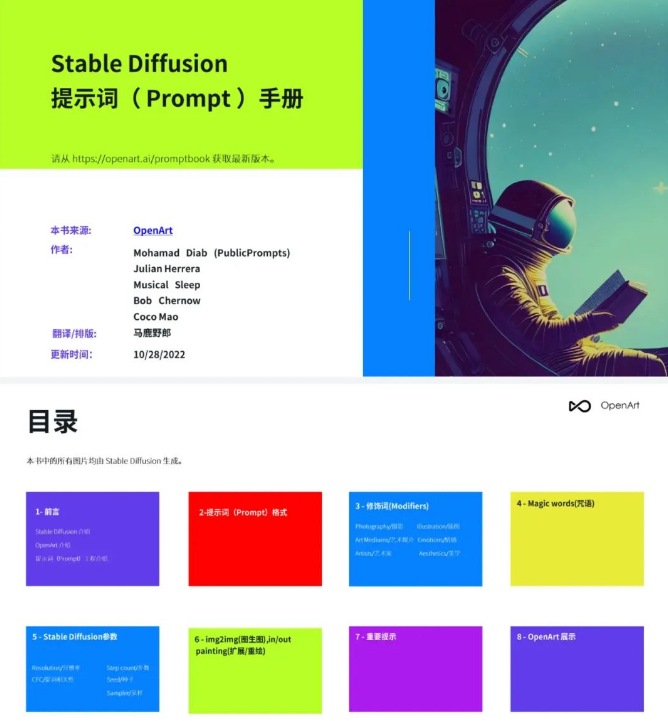
4.stable diffusion提示词
提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
5.AIGC视频教程合集
观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
实战案例
纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


