CLIP图生文

图生文【学习中】 图生文:提供图像,把图像对应的信息用文本描述出来 阅读详情
AI摘要

文章介绍了如何利用CLIP模型进行图像与文本的匹配,包括作为灵感检索系统和与文本生成模型结合的方式。还提及了如何使用COCO数据集进行模型finetune,以及相关工具如clip_benchmark和CapDec的应用实例。,

CLIP模型本身并不是图生文的,CLIP模型用来做图片和文本描述的匹配。
但它可以与其他技术结合使用来实现这一点,以下是两种常见的方法:

  1. CLIP作为文本灵感检索系统:

这种方法利用了 CLIP 在寻找图像和文本之间相似表示方面的优势。

步骤:
1.准备图像: 准备好要为其生成文本的图像。
2.使用 CLIP 对图像进行编码:使用 CLIP 的图像编码器部分生成图像的矢量表示。
3.搜索相似的文本嵌入: 搜索文本嵌入数据库(预先训练的文本编码)以查找最接近图像编码的文本嵌入。
4.使用检索到的文本获取灵感: 具有最接近嵌入的检索到的文本可以用作您自己的创意文本生成的起点,您可以使用此文本作为故事、诗歌或任何其他创意写作任务的灵感。

  1. CLIP 引导文本生成与附加模型:

这种方法将 CLIP 与单独的文本生成模型相结合,以实现更多控制:

需要:
CLIP模型:对图像进行编码并理解其内容。
文本生成模型:这可以是像 GPT-3 这样的预训练模型,也可以是您根据自己的文本数据训练的模型。
步骤:
1.使用 CLIP 对图像进行编码:与之前的方法类似,使用 CLIP 的图像编码器生成图像的矢量表示。
2.使用图像编码作为提示: 将图像编码与文本提示(可选)一起提供给文本生成模型。
3.生成文本:文本生成模型将使用提示和图像编码来创建与图像相关并遵循提示指导(如果提供)的新文本输出。

open_clip的generate函数已经实现了这一功能。
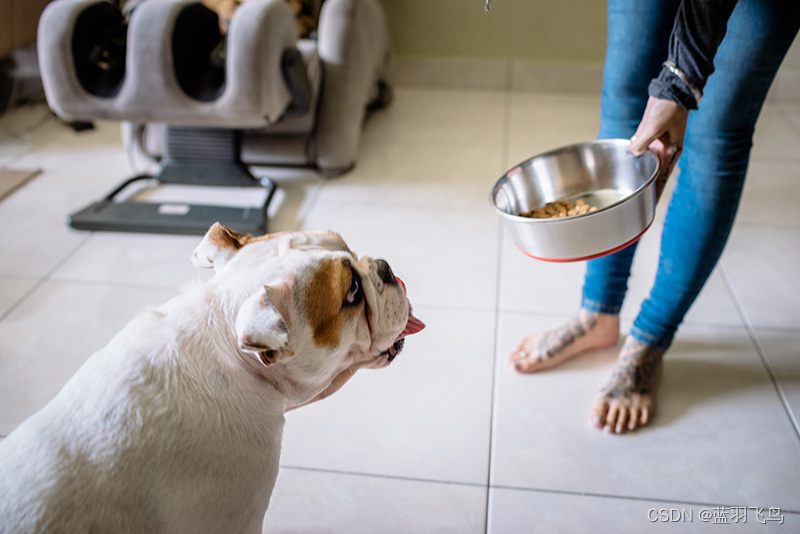
这里用COCO图片测试。

首先安装open_clip.

pip install open_clip_torch
import open_clip
import torch
from PIL import Image

model, _, transform = open_clip.create_model_and_transforms(
  model_name="coca_ViT-L-14",
  pretrained="mscoco_finetuned_laion2B-s13B-b90k"
)

im = Image.open("cat.jpg").convert("RGB")
im = transform(im).unsqueeze(0)

with torch.no_grad(), torch.cuda.amp.autocast():
  generated = model.generate(im)

print(open_clip.decode(generated[0]).split("<end_of_text>")[0].replace("<start_of_text>", ""))

这时候大概率会碰到如下error:

RuntimeError: Boolean value of Tensor with more than one value is ambiguous

这是transformer的问题,参见#860,
一般会显示出现在coca_model.py, 点进去,这样修改即可。
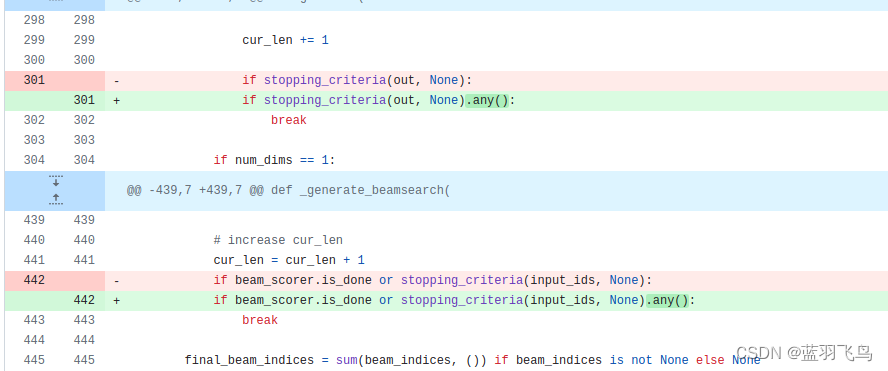
在这里插入图片描述
看下测试结果:

在这里插入图片描述

coca_ViT-L-14的输出:

a white and brown dog with its tongue hanging out and a bowl of food in front of a person .

coca_ViT-B-32的输出:

a brown and white dog sitting on top of a bathroom floor .

如果你想finetune, 那么数据量一定要大。
准备一个csv文件,两列,一列是filepath, 一列是文本描述。
用COCO数据集的话csv可以自动生成。

当然首先要pip install clip_benchmark.

from clip_benchmark.datasets.builder import build_dataset
import pandas as pd
import os

root_path = "path/to/data/dir" # set this to smth meaningful
ds = build_dataset("mscoco_captions", root=root_path, split="train") # this downloads the dataset if it is not there already
coco = ds.coco
imgs = coco.loadImgs(coco.getImgIds())
future_df = {"filepath":[], "title":[]}
for img in imgs:
    caps = coco.imgToAnns[img["id"]]
    for cap in caps:
        future_df["filepath"].append(img["file_name"])
        future_df["title"].append(cap["caption"])
pd.DataFrame.from_dict(future_df).to_csv(
  os.path.join(root_path, "train2014.csv"), index=False, sep="\t"
)

用csv文件finetune, 数据集没有那么大的话可换成小一点的coca_ViT-B-32.

python -m training.main \
    --dataset-type "csv" \
    --train-data "path/to/data/dir/train2014.csv" \
    --warmup 1000 \
    --batch-size 128 \
    --lr 1e-5 \
    --wd 0.1 \
    --epochs 1 \
    --workers 3 \
    --model "coca_ViT-L-14" \
    --report-to "wandb" \
    --coca-contrastive-loss-weight 0 \
    --coca-caption-loss-weight 1 \
    --log-every-n-steps 100

还有其他方法也可由图生文,比如clip_interrogator。有web UI界面。

和上面同样的图片,生成结果如下:

there is a dog that is standing next to a person, unsplash photography, bowl filled with food, movie still of a snarling, as an offering to zeus, template layout, someone in home sits in bed, bite, stainless steel, short spout, chloe price

还可以参考CapDec,实现不同风格的text.
CLIP-Caption-Reward,用不同的reward训练生成Text.

想用中文版的CLIP看这里

一些好的CLIP应用可以参考Awesome-CLIP

从文生图到图生文:多模态融合如何重塑AIGC创作边界 本文探讨了多模态融合技术如何推动AIGC创作的革新,从文生图到图生文的双向转换,展示了计算机视觉与自然语言处理的深度结合。通过CLIP、Stable Diffusion等先进模型,实现了语义级交互与精细化控制,显著提升了创作效率和质量。多模态融合正在重塑电商、医疗等行业的应用场景,开创内容创作的新纪元。 阅读详情

相关推荐

解读亚马逊云科技语义搜图检索方案

方案二:利用图生文模型(案例使用vit-gpt2-image-captioning模型,可替换)先对图像产生对应的文本描述,再将生成的图片描述文本与查询文本放入同一维度的潜在向量空间中,找到与查询文本向量最相近的描述文本向量所对应的图像,以实现基于语义的图像搜索。方案一:利用CLIP模型的文本编码器和图像编码器,将图像和文本放入同一维度的潜在向量空间中,找到与文本向量最相近的图像向量以实现基于语义的图像搜索。例如,如果您的查询文本是“一朵红花”,它将返回红玫瑰图像的向量作为类似的项目。

2301_76768294的博客 1762

CLIPCAP:图生文

本文主要目的是学习这篇paper,以及纪录相关的代码学习过程ClipCap:让计算机学会看图说话。

weixin_46133588的博客 6369

CLIP图文匹配模型实例

CLIP图文匹配模型

Toby的博客 870

Midjourney图生文教程

解读的关键词并不一定准确,在解读出来的提示词基础上需要再进行修改。按钮 1️⃣2️⃣3️⃣4️⃣,点击相应按钮生成对应提示的新图片。上传图片让Midjourney生成解读提示词。

GPT创新工坊 995

手把手写深度学习(18):finetune微调CLIP模型的原理、代码、调参技巧

​ 在前面的博客《手把手写深度学习(16):用CILP预训练模型搭建图文检索系统/以图搜图/关键词检索系统》中介绍了如何在图文检索、以图搜图、关键词检索等任务中使用CLIP。这篇博客重点讲解代码和调参技巧。

沉迷单车的追风少年 9417

生成式-看图说话/图片问答/以图生文-2023-BLIP2.0:零样本“图生文”【利用已有的ViT & LLM(均冻结)+ 轻量Q-Former模块做模态融合】

但是,需要确保的是,上下文不能超过 512 个标记,因为这是 BLIP-2 使用的语言模型 (OPT 和 T5) 的上下文长度。这些查询还可以通过相同的自注意力层与文本进行交互 (译者注: 这里的相同是指图像 transformer 和文本 transformer 对应的自注意力层是共享的)。通过引入一种新的视觉语言预训练范式来应对这一挑战,该范式可以任意组合并充分利用两个预训练好的视觉编码器和 LLM,而无须端到端地预训练整个架构。这一新的预训练范式使它能够充分享受两种模态的各自的进展的红利。

u013250861的博客 791

多模态大模型文生图和图生文的主要技术

该模型架构由图像编码器和文本编码器组成。图像编码器将图像转换为嵌入(数字列表),文本编码器将文本转换为嵌入。这两个编码器在成批的图像-文本对上进行训练,其中文本描述图像。编码器的训练方式如下:对于每个图像-文本对,图像和文本嵌入彼此“接近”。对于所有不匹配的图像-文本对,图像和文本嵌入彼此相距甚远。注意,有很多种方法可以测量两个嵌入之间的距离。一些常用的方法是欧几里得距离和余弦相似度。CLIP 使用后者。此图中有 N 个图像-文本对。I N和 T N是第 N 个图像-文本对的图像和文本嵌入。

酌沧 5190

【多模态评测】图生文/文生图模型怎么测?多模态评测集 CLIP Score 介绍

文章摘要 CLIP Score作为多模态评测的通用指标,正面临性能边界问题。本文深入剖析CLIP Score原理及其应用现状:基于对比学习的双塔架构通过4亿图文对训练实现跨模态对齐,但其对细节不敏感、存在语义漂移等问题逐渐显现。文章提供原生CLIP、HuggingFace和OpenCLIP三种实现方案,并给出多GPU分布式计算的工业级实践。测试数据显示,CLIP在ImageNet-1K上保持82.4%准确率,但新型模型表现参差,跨模态相似度方差扩大2.3倍。建议组合使用CIDEr、CLIP Score和GP

2601_95807009的博客 193

MusePublic多模态创作效果展示:文生图+图生文联动

本文介绍了如何在星图GPU平台上自动化部署🎨 MusePublic Art Studio镜像,实现文生图与图生文的多模态联动创作。该平台简化了部署流程,用户可快速体验从文字生成图像,再通过AI分析图像生成描述,进而创作新图像的创意闭环,典型应用于海报设计、概念图迭代等场景。

weixin_32999557的博客 358

AIGC:clip-interrogator

如果你安装的是0.6.0,那么可以使用自定义词库其他:clip-interrogator代码解析 - plus studio-腾讯云开发者社区-腾讯云clip_interrogator教程 - plus studio - StudyingLover。

微风❤水墨 1379

QMT量化交易桥接方案深度对比:从MiniQMT淘汰说起

量化交易系统中的API桥接,本质是解决本地终端与底层交易引擎之间的通信瓶颈。其核心原理在于绕过GUI封装、直连确定性执行层,从而获得低延迟、高可靠、可监控的指令通路。技术价值体现在策略实盘一致性提升、毫秒级响应保障及运维可控性增强。典型应用场景包括打板策略、T+0套利、高频网格等对时效与稳定性双敏感的自动化交易。本文聚焦国金证券QMT专业版生态,系统剖析DLL注入、HTTP反向代理、IPC共享内存与官方HTTP API四大桥接路径的性能边界、合规风险与工程落地成本,尤其深入解析qmt终端 client is

weixin_33892359的博客 456

AI图像理解技术的演进

在CLIP等现代多模态模型出现之前,,但其技术路线与当前方法存在本质差异。

神棍之路 916

从钕铁硼到电机磁钢:用COMSOL玩转新能源永磁体磁场仿真(含3D模型导入技巧)

本文详细介绍了如何利用COMSOL Multiphysics进行新能源永磁体磁场仿真,从基础的单块钕铁硼磁钢建模到复杂的3D电机磁钢组件分析。重点讲解了3D模型导入技巧、辐射环等特殊结构的充磁定义,以及如何通过仿真结果优化磁路设计、评估气隙磁密和退磁风险,为工程师提供了一套高效、精准的有限元仿真解决方案。

2y3u4i5o6p的博客 1037

电商/游戏AI应用终结者!Nano-banana多模态RAG从入门到精通,看这篇就够了!

最近全球刷屏Nano Banana,应该没有人还没用过吧?! 它不仅能根据一句话描述,就生成栩栩如生的手办图片,还能根据用户的描述,对图片进行精细化编辑,就连速度,也快得出奇。

xx_nm98的博客 1580

两轮差速小车循线控制原理分析

硬件资料设定:小车驱动来自于两个相同的电机,转向依靠两轮差速实现,小车前后左右安装超声波传感器,前后各一个,左右各两个; 功能目标:假设小车左侧有墙壁,通过超声波测距实现按指定距离沿墙行驶 参数设定:车轮半径r=3cm,车轮间距wd=10cm,车身长length=16cm,侧边超声波传感器前后各一个,假设一个在车头一个在车尾,间距=车身=length=16cm,小车线速度恒定v = 0.2m/s,距离墙d=10cm,假设超声波传感器以10Hz的频率采集距离。 在以上条件下,设定小车出发点,方向与墙平行

aibingjin的博客 1万+

IAR for ARM 搭建STM32F103C8T6工程模板(实战指南)

本文详细介绍了如何在IAR for ARM开发环境中为STM32F103C8T6微控制器搭建完整的工程模板。从环境准备、固件库获取、目录结构设计到工程配置与编译调试,提供了实战指南和常见问题解决方案,帮助开发者快速建立稳定的STM32开发环境。

fun88的博客 987

BLIP2预研笔记

文章是公司内部分享学习写的预研报告,里面有小部分文段是直接从网上借鉴的,侵删。

初级打字员博客 1429

uniapp 开发微信小程序请求问题 , 真机调试正常,开发工具正常,但是使用扫码预览接口都是不通的,发布到体验版也是请求失败

uniapp开发小程序体验版接口请求失败(真机可以)

weixin_60408555的博客 3953

大模型学习笔记------BLIP模型的再思考

本文主要介绍了BLIP这个大模型相关推理方面的思考,供大家参考!

gz7seven 1451

大模型训练方法全面解析:SFT、RFT、TRPO、DPO、PPO、GRPO、RLH、RLHF技术深度剖析

大模型训练方法全面解析 本文系统介绍了当前主流的大模型训练和对齐技术,包括监督微调(SFT)、拒绝采样微调(RFT)、信任域策略优化(TRPO)、直接偏好优化(DPO)、近端策略优化(PPO)等。这些方法各有特点:SFT简单高效但数据依赖性强;RFT通过质量筛选提升输出质量;TRPO训练稳定但计算复杂;PPO是RLHF核心算法,平衡探索与利用。文章详细分析了各方法的实现原理、优势劣势及适用场景,为开发者选择合适的大模型训练策略提供参考。

2793

【YOLOv8改进-注意力机制】BRA(bi-level routing attention ):双层路由注意力

【YOLOv8改进-注意力机制】BRA(bi-level routing attention ):双层路由注意力我们提出了一种新颖的动态稀疏注意力机制,通过双层路由实现更加灵活且具有内容感知的计算分配。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 3166

造相-Z-Image多模态实践:CLIP引导实现图文协同创作

本文介绍了如何在星图GPU平台自动化部署🎨 造相-Z-Image文生图引擎,实现CLIP引导的图文协同创作。该方案通过AI理解图片内容并生成精准描述,再驱动文生图引擎创作新图像,可广泛应用于社交媒体配图、创意设计等场景,提升多模态内容生成效率。

weixin_29885875的博客 150

手把手教你学Simulink--逆变器场景:基于Simulink的单相全桥逆变器PWM控制仿真建模

本文介绍了使用Simulink和Simscape Electrical库进行单相全桥逆变器PWM控制仿真建模的详细步骤。主要内容包括:从创建Simulink项目、添加电力电子组件、构建逆变器模型,到设置参数、运行仿真和结果分析。重点讲解了逆变器核心模块的配置、PWM信号生成、负载建模等关键环节,并提供了优化改进建议。该指南适用于电力电子初学者,通过仿真可以帮助理解单相全桥逆变器的工作原理和PWM控制技术,为实际应用和算法开发提供基础平台。

MHD0815的博客 665

大模型学习笔记------CLIP模型解读与思考

本文详细解读了CLIP模型的原理、推理与对应的一些思考。

gz7seven 3762

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

VLM技术:多模态(首次更新)

https://zhuanlan.zhihu.com/p/2433292582(一文详解 codebook 技术史(从 VAE 到 VQ/RQ-VAE 到 FSQ))https://zhuanlan.zhihu.com/p/698502893(重新发现VAE(Variational Autoencoders))

2401_84495872的博客 1431

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

CLIP-GmP-ViT-L-14:图文匹配在人工智能内容生成中的关键作用

本文介绍了CLIP-GmP-ViT-L-14图文匹配测试工具在AI内容生成中的关键作用。该工具可在星图GPU平台上实现自动化部署,为文生图、图生文等AIGC流程提供核心的质量评估与训练引导能力,例如自动筛选与文本描述最匹配的AI生成图片,从而提升内容创作的效率与可控性。

weixin_35935514的博客 82

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

上一篇: 自定义数据 微调CLIP (结合paper)
下一篇: pytorch3d.ops.ball_query 用法
蓝羽飞鸟
博客等级 码龄8年 1万+粉丝 727原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝羽飞鸟

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值