遥感&机器学习入门实战教程|Sklearn案例⑯:聚类与无监督分类(cluster 模块)

sklearn专题六:聚类算法K-Means 1 概述 1.1 无监督学习与聚类算法 在过去的五周之内,我们学习了决策树,随机森林,逻辑回归,他们虽然有着不同的功能,但却都属于“有监督学习”的一部分,即是说,模型在训练的时候,即需要特征矩阵X,也需要真实标签y。机器学习当中,还有相当一部分算法属于“无监督学习”,无监督的算法在训练的时候只需要特征矩阵X,不需要标签。我们曾经学过的PCA降维算法就是无监督学习中的一种,聚类算法,也是无监督学习的代表算法之一。 聚类算法又叫做“无监督分类”,其目的是将数据划分成有意义或有用的组(或簇)。这种划分 阅读详情

在很多遥感应用中,我们并不总能获得足够的标注样本。比如:

  • 新区域没有实地调查数据;

  • 部分年份没有高质量的样本;

  • 标注工作代价昂贵。

这时,无监督学习 尤其是 聚类(Clustering) 就派上用场了。它可以仅依靠光谱特征对像素进行分组,形成初步的“伪分类结果”,再结合少量人工标注进行后续分析。

往期内容和数据链接如下:

遥感&机器学习入门实战教程 数据集分享

🧩 sklearn.cluster 常见方法

  • KMeans:最经典的聚类方法,基于欧式距离最小化。

  • MiniBatchKMeans:大数据优化版,更适合整幅影像。

  • AgglomerativeClustering:层次聚类,自底向上逐步合并。

  • DBSCAN:基于密度的聚类,可发现任意形状簇,能识别噪声。

  • SpectralClustering:基于图论的聚类,适合复杂结构。

在遥感实验中,最常用的是 KMeans,因为它简单高效,结果可解释性强。

💻 代码示例:KSC 数据无监督聚类

# -*- coding: utf-8 -*-
"""
Sklearn案例⑯:聚类与无监督分类(KSC 数据)
"""

import os, numpy as np, scipy.io as sio, matplotlib.pyplot as plt, matplotlib
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN

# ===== 中文显示 =====
matplotlib.rcParams['font.family'] = 'SimHei'
matplotlib.rcParams['axes.unicode_minus'] = False

# ===== 参数 =====
DATA_DIR = r"your_path"   # ← 修改为你的 KSC 数据路径
PCA_DIM  = 20             # 聚类前先降维,加快计算
SEED     = 42

# ===== 1. 读取数据 =====
X_cube = sio.loadmat(os.path.join(DATA_DIR,"KSC.mat"))["KSC"].astype(np.float32)
Y_map  = sio.loadmat(os.path.join(DATA_DIR,"KSC_gt.mat"))["KSC_gt"].astype(int)
h, w, b = X_cube.shape
coords = np.argwhere(Y_map!=0)
X_all  = X_cube[coords[:,0], coords[:,1]]
y_all  = Y_map[coords[:,0], coords[:,1]] - 1
num_classes = y_all.max()+1
print(f"标签像素: {len(y_all)}, 类别数: {num_classes}")

# ===== 2. 标准化 + PCA =====
scaler = StandardScaler().fit(X_all)
X_std  = scaler.transform(X_all)
X_pca  = PCA(n_components=PCA_DIM, random_state=SEED).fit_transform(X_std)

# ===== 3. 聚类模型 =====
models = {
    "KMeans": KMeans(n_clusters=num_classes, random_state=SEED, n_init=10),
    "层次聚类": AgglomerativeClustering(n_clusters=num_classes),
    "DBSCAN": DBSCAN(eps=2, min_samples=5)   # 参数需调节
}

# ===== 4. 聚类结果可视化(抽样二维PCA显示)=====
fig, axes = plt.subplots(1, 3, figsize=(13,4), constrained_layout=True)
for ax,(name,model) in zip(axes, models.items()):
    labels_pred = model.fit_predict(X_pca)
    sc = ax.scatter(X_pca[:,0], X_pca[:,1], c=labels_pred, cmap="tab20", s=5)
    ax.set_title(name)
plt.suptitle("KSC 数据无监督聚类二维可视化", fontsize=14)
plt.show()

# ===== 5. 整图聚类(仅KMeans示例)=====
X_flat = X_cube.reshape(-1, b)
X_flat_std = scaler.transform(X_flat)
X_flat_pca = PCA(n_components=PCA_DIM, random_state=SEED).fit_transform(X_flat_std)

kmeans = KMeans(n_clusters=num_classes, random_state=SEED, n_init=10)
labels_full = kmeans.fit_predict(X_flat_pca).reshape(h, w)

plt.figure(figsize=(7,6))
plt.imshow(labels_full, cmap="tab20")
plt.title("KSC 整图无监督分类 (KMeans)")
plt.axis("off")
plt.show()

🔍 结果解读

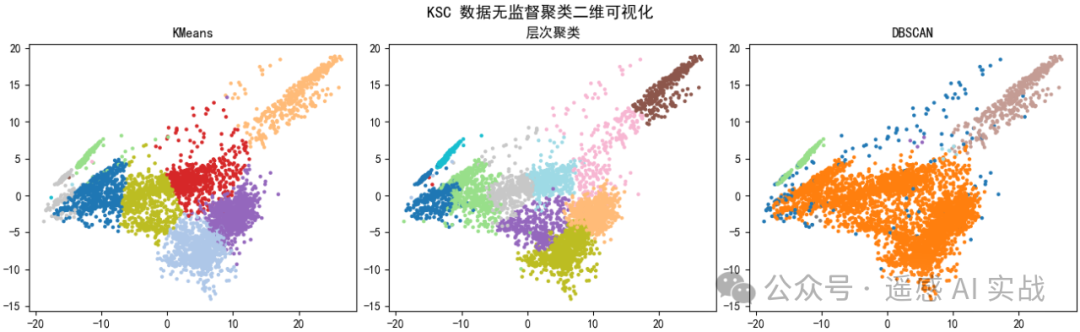
  • 二维散点图:通过 PCA 压缩后,可以直观看到不同聚类方法对样本的分组效果。
图片

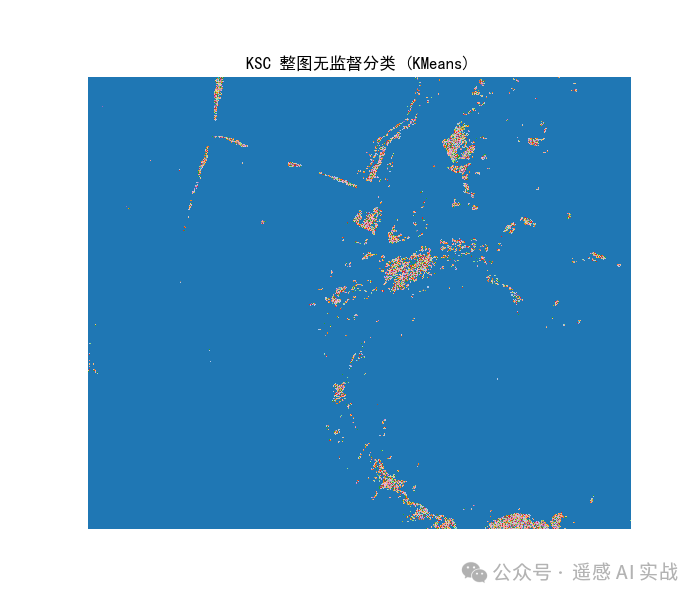
  • 整图结果:KMeans 聚类后,整幅影像被自动划分为若干类别,虽然和真实标签不完全一致,但在缺乏样本时非常有参考价值。
图片

  • 不同方法特点:

    • KMeans:速度快,适合大规模影像;

    • Agglomerative:更适合小样本,能得到层次树状结构;

    • DBSCAN:能识别噪声,但需要调参,否则可能出现所有样本都归为一类的情况。

✅ 总结

  • sklearn.cluster 提供了丰富的聚类方法,可作为 无监督分类基线。

  • 在遥感实验中,聚类结果可作为 样本生成、模式探索 的辅助工具,尤其在缺乏标注时很有价值。

  • 建议:先用 KMeans 快速跑一遍,再根据数据特点尝试层次聚类或 DBSCAN。

欢迎大家关注下方公众号获取更多内容!

sklearn聚类算法之Meanshift 基本思想 Meanshift是一个简单的概念,但不太好解释,用类比的方法解释或许比较容易理解。想象有一个雾气弥漫的足球场(即一个二维的特征空间),上面站着100个人(即我们的观察值)。因为雾很大,人只能看到很近的地方。每分钟每个人向四周看一看,然后朝着可以看到最多人的方向移动一步。随着时间流逝,因为人们一次次地朝着越来越大的人群移动,球场上的人开始聚集成一个小组,最终这些人就在球场上形成了聚类(cluster)。每个人的分类被指定为他们最终所在的分类。Meanshift算法步骤如下: 首先以随机选取的点为 阅读详情

相关推荐

利用sklearn.cluster实现k均值聚类

一、k-mean算法介绍 1.主要思想:在给定聚类簇数(K值)【n_clusters】和K个初始类簇中心(通常从数据集中随机选取k个数据)的情况下,历遍数据集中的每个数据点,而数据点距离哪个类簇中心(cluster centers)最近,就把该数据点分配到这个类簇中心点所代表的类簇中;所有数据点分配完毕之后,根据类簇内的所有点重新计算每个类簇的中心点(取平均值),然后再迭代的进行分配点

Hisun_Gwen的博客 1万+

Sklearn(二): sklearn.cluster 各种聚类方法解析

Classes 各种聚类方法特性汇总: sklearn.cluster.KMeans from sklearn.cluster import KMeans KMeans(n_clusters=8,init='k-means++',n_init=10,max_iter=300,tol=0.0001,precompute_distances='auto',verbose=0,random_state...

u014765410的博客 1万+

图解5G HARQ-ACK反馈:从DCI解析到PUCCH发送的完整数据流

本文详细解析了5G通信系统中HARQ-ACK反馈机制的完整流程,从DCI解码到PUCCH发送的实战指南。重点介绍了HARQ-ACK码本生成、DCI关键参数解读以及PUCCH资源映射等核心技术环节,帮助工程师深入理解5G NR中的数据传输可靠性保障机制。

weixin_27722377的博客 395

Sklearn 聚类分析 kmeans,DBSCAN

KMenas算法 #导入KMeans模块 from sklearn.cluster import KMeans from sklearn.datasets import make_blobs #随机生成含150个类别数为3的数据集 X,y=make_blobs(n_samples=150,centers=3,random_state=8) #数据可视化 import matplotlib.pyplot as plt %matplotlib inline plt.figure(dpi=100) plt.sc

CX 1408

手把手教你用AirSim生成无人机训练数据集:RGB/深度图/分割图全攻略

本文详细介绍了如何使用AirSim仿真插件在UE4环境中生成无人机训练数据集,涵盖RGB、深度图和分割图等多种模态数据的采集与处理。通过实战指南,读者可以掌握环境配置、多模态数据采集、自动化流程设计及数据后处理等关键技术,为无人机视觉算法开发提供高质量训练数据。

weixin_29008805的博客 445

偷懒必备:3种方法快速移植MFC界面资源(含.rc文件打不开解决方案)

本文针对MFC桌面应用开发,详细介绍了三种快速移植界面资源的实战方法:直接编辑.rc文件、利用Visual Studio“添加现有项”进行可视化挂载,以及双实例拖拽应急方案。文章重点剖析了.rc文件无法打开的常见问题,提供了通过修复rc.exe等关键文件来根治此问题的解决方案,帮助开发者高效复用资源,规避ID冲突等陷阱。

weixin_28358083的博客 271

【机器学习】聚类算法Kmeans

聚类算法kmeans详解

高朗的博客 3656

保姆级教程:用xmir-patcher一键解锁Redmi AX3000路由器的SSH(附视频演示)

本文提供Redmi AX3000路由器SSH解锁的保姆级教程,详细介绍了使用xmir-patcher工具一键解锁SSH的步骤,包括环境搭建、工具获取、图形化操作详解及常见问题排查。解锁后,用户可通过SSH连接实现刷机、插件安装、网络优化等高级功能,提升路由器性能。

weixin_29216049的博客 723

Python 机器学习8:sklearn 聚类算法

1. K-Means算法是一种广泛使用的聚类算法。 from sklearn.cluster import KMeans K-Means是聚焦于相似的无监督的算法,以距离作为数据对象间相似性度量的标准,即数据对象间的距离越小,则它们的相似性越高,则它们越有可能在同一个类。K值指的是把数据划分成多少个类别。 算法步骤:随机设置K个特征空间内的点作为初始的聚类中心。对于其他每个点计算到K个中心的距离,未知的点选择最近的一个聚类中心点作为标记类别。接着,对着标记的聚类中心之后,重新计算出每个聚类的新中心

Amzmks的博客 2263

RK3588 部署 YOLO26 目标检测:从训练到 NPU 推理

如果做垂直场景(工业缺陷、农作物、特定零件),需要自己标数据。采集图像(500+ 张,覆盖不同光照/角度)→ 筛选(删除模糊/无目标)→ LabelImg 标注(选择 YOLO 格式)→ 划分(train:val:test = 7:2:1)labelImg├── train/├── val/├── test/YOLO26 在 RK3588 上的全流程是 PC 端训练 + ONNX 导出 → RKNN 转换(INT8 量化)→ 板端推理。

m0_71589036的博客 107

面试官连夜整理:103道AI Agent面试题,答对一半直接加薪50%

维度AutoGPTLangGraphAutoGen控制流LLM 驱动的隐式循环代码层定义的显式状态图对话驱动的自动流转状态存储Prompt 上下文中(易丢失)结构化 State 对象(可持久化)对话历史(自动累积)分支能力依赖 LLM 的文本输出(不稳定)条件边 + 节点路由(确定性)多 Agent 对话自然分支(涌现式)回溯/回滚无原生支持,只能重新开始原生 Checkpoint 支持时间旅行无全局回滚,单 Agent 可重启人机协同仅人工在关键点介入(需要自定义)原生支持。

weixin_35774598的博客 620

python——k-means聚类算法

k-means聚类算法 k-means算法属于无监督学习的一种聚类算法,其目的为:在不知数据所属类别及类别数量的前提下,依据数据自身所暗含的特点对数据进行聚类。对于聚类过程中类别数量k的选取,需要一定的先验知识,也可根据“类内间距小,类间间距大“(一种聚类算法的理想情况)为目标进行实现。 需要用到sklearn库,scikit-learn是Python的一个开源机器学习模块,它建立在NumPy,S...

lili_wuwu的博客 4818

【DRAM存储器六十七】DDR5介绍--训练相关之write leveling

详述DDR5 write leveling细节

highman110的博客 283

【scikit-learn】sklearn.cluster 模块 :聚类算法

sklearn.cluster 提供了多种 无监督学习聚类算法,用于数据分组、模式发现、异常检测 等任务,适用于图像分割、市场分析、异常检测 等应用。sklearn.cluster 提供了多种聚类方法,KMeans 适用于大规模数据,DBSCAN 适用于噪声数据,AgglomerativeClustering 适用于层次结构数据。

彬彬侠的博客 1326

大数据利器Hadoop:从基础到实战,一篇文章掌握大数据处理精髓!

在当今大数据时代,数据量的爆炸式增长对企业和技术提出了前所未有的挑战。如何高效地存储、处理和分析这些庞大的数据集,成为了亟待解决的问题。Hadoop作为一种分布式计算框架,应运而生,为大数据处理提供了有效的解决方案。Hadoop是一个由Apache软件基金会维护的开源项目,它基于Google的分布式文件系统(Google File System,GFS)和MapReduce计算模型设计。Hadoop的主要目标是处理大规模数据集,它可以在普通硬件集群上运行,从而降低了大数据处理的成本。

邓邓子的博客 8273

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

【机器学习】Sklearn-cluster聚类方法

Classes1 各种聚类方法特性汇总: sklearn.cluster.KMeans from sklearn.cluster import KMeans KMeans(n_clusters=8,init='k-means++',n_init=10,max_iter=300,tol=0.0001,precompute_distances='auto',verbose=0,random_...

小白兔的窝 2万+

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Python机器学习14——聚类分析

K均值聚类,分层聚类,完全连接,单一连接,平均连接

weixin_46277779的博客 6285

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

使用K-means方法对遥感图像进行聚类

import cv2 import numpy as np np.set_printoptions(threshold=np.inf) from sklearn.cluster import KMeans img0 = cv2.imread(r'paviau_area_16bit2.tif', flags=1) img0 = img0[1:, 1:, 0] # 获取B通道图片,B通道更能区别叶片色彩;且将不必要部分截除,便于处理。 cv2.imshow("imagin0", img0) cv2.wai.

soderayer的博客 2372

遥感图像处理-K值聚类-地物分类

(环境:VS2017+OPENCV4.0) K值聚类算法并不复杂,这里不多介绍,直接上代码。 #include "pch.h" #include <iostream> #include <opencv2/opencv.hpp> #include <math.h> using namespace std; using namespace cv; struc...

WHU_StudentZhong的博客 3465

sklearn实战-----6.聚类算法K-Means

1 概述 1.1 无监督学习与聚类算法 在过去的五周之内,我们学习了决策树,随机森林,逻辑回归,他们虽然有着不同的功能,但却都属于“有监督学习”的一部分,即是说,模型在训练的时候,即需要特征矩阵X,也需要真实标签y。机器学习当中,还有相当一部分算法属于“无监督学习”,无监督的算法在训练的时候只需要特征矩阵X,不需要标签。我们曾经学过的PCA降维算法就是无监督学习中的一种,聚类算法,也是无监督学习的代表算法之一。 聚类算法又叫做“无监督分类”,其目的是将数据划分成有意义或有用的组(或簇)。这种划分可以基于我们

zjmy的博客 3406

sklearn库之sklearn.cluster.KMeans的学习

这篇呢是接着上一篇kmeans的学习,这篇主要是介绍调用机器学习的库来使用集成的kmeans ,哈哈会调用就行,主要学习呢就是看官方文档,学习这个包装类的参数,返回值以及它方法,这里面有好多examples,大家可以尝试下。下面是我练习时的代码:#-*- coding:utf-8 -*- from sklearn.cluster import KMeans #from sklearn.cluste...

tjuwwk 2万+

sklearn聚类方法详解

1 KMeans 1.1 算法描述 随机选择k个中心 遍历所有样本,把样本划分到距离最近的一个中心 划分之后就有K个簇,计算每个簇的平均值作为新的质心 重复步骤2,直到达到停止条件 停止条件: 聚类中心不再发生变化;所有的距离最小;迭代次数达到设定值, 代价函数:误差平方和(SSE) 1.2 算法优缺点 优点: 算法容易理解,聚类效果不错 具有出色的速度 当簇近似高斯分...

ustbbsy的博客 8万+

层次聚类sklearn.cluster包AgglomerativeClustering

** Ward策略:让所有类簇中的方差最小化。 Maximum策略:也叫completed linkage(全连接策略),力求将类簇之间的距离最大值最小化。 Average linkage策略:力求将簇之间的距离的平均值最小化 single单次使用所有观测之间的最小距离两组中的一组。 AgglomerativeClustering中linkage参数为 [‘ward’, ‘co...

as394349658的博客 1万+

聚类算法学习----之----sklearn.cluster.KMeans

聚类算法学习----之----sklearn.cluster.KMeans

xiaoQL520的博客 1万+

sklearn clustering聚类

无标签数据的聚类可以通过sklearn.cluster模块进行。每个聚类算法都有两个变体一个类,实现在训练数据上学习聚类的拟合方法;一个函数,给定训练数据,返回对应于不同聚类的整数标签阵列。对于类,训练数据上的标签可以在labels_属性中找到。...

qq_27390023的博客 1021

python之sklearn学习笔记

前言:本文是学习笔记。sklearn介绍scikit-learn是数据挖掘与分析的简单而有效的工具。 依赖于NumPy, SciPy和matplotlib。它主要包含以下几部分内容: 从功能来分: classification Regression Clustering Dimensionality reduction Model selection Preprocessing 从API模块来分

一个人漫步走 4万+
上一篇: 遥感&机器学习入门实战教程|Sklearn案例⑮:流形学习与非线性降维(manifold)
下一篇: 遥感&机器学习入门实战教程|Sklearn案例⑰:决策树与遥感分类(tree 模块)
遥感AI实战
博客等级 码龄9年 1002粉丝 107原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

遥感AI实战

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值