遥感&机器学习入门实战教程|Sklearn案例⑮:流形学习与非线性降维(manifold)

《机器学习原理及应用》全套PPT课件2026(重庆工商大学) 获取 《机器学习原理及应用》全套PPT课件2026(重庆工商大学)::https://download.youkuaiyun.com/download/m0_54748666/93793958。13-第十三章高斯混合模型.pptx。1-第一章 机器学习概述.pptx。3-第三章模型评估与选择.pptx。12-第十二章K均值聚类.pptx。14-第十四章 谱聚类.pptx。6-第六章 逻辑回归.pptx。7-第七章 神经网络.pptx。11-特征选择与提取.pptx。9-第九章决策树.pptx。 阅读详情

在高光谱遥感分析中,我们经常遇到高维特征空间:几百个波段的光谱向量。 之前我们介绍了 PCA,它是一种线性降维方法,能够高效去除冗余。但 PCA 的本质是寻找最大方差方向,并不能很好地捕捉 非线性流形结构。

有同学会问:

如果光谱数据其实“分布在某个非线性低维流形上”,PCA 还能找到真实的结构吗?

答案是:不一定。这就是 流形学习(Manifold Learning) 的用武之地。

往期内容和数据链接如下:

遥感&机器学习入门实战教程 数据集分享

🧩 sklearn.manifold 常见方法

  • Isomap:保留流形上的测地距离,适合处理非线性嵌入问题。

  • Locally Linear Embedding (LLE):保持局部邻域的线性关系。

  • t-SNE:在二维空间中很好地展示样本之间的聚类关系(常用于可视化)。

  • MDS (多维尺度分析):通过保持样本对之间的距离关系实现降维。

  • Spectral Embedding:基于图拉普拉斯特征向量的降维方法。

这些方法常用于可视化与探索,而不是直接作为分类的预处理步骤,因为它们的映射方式通常不可逆,且计算成本较高。

💻 代码示例:KSC 数据二维流形可视化

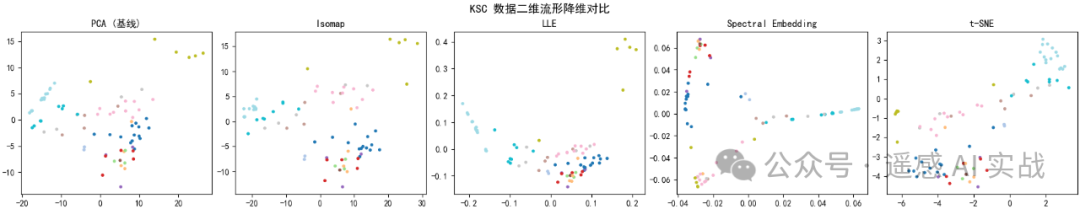
下面的代码演示了如何用 sklearn.manifold 将 KSC 样本降到二维,并对比不同方法的效果。

# -*- coding: utf-8 -*-
"""
Sklearn案例⑮:流形学习与非线性降维(KSC 数据)
"""

import os, numpy as np, scipy.io as sio, matplotlib.pyplot as plt, matplotlib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.manifold import Isomap, LocallyLinearEmbedding, TSNE, SpectralEmbedding

# ===== 中文显示 =====
matplotlib.rcParams['font.family'] = 'SimHei'
matplotlib.rcParams['axes.unicode_minus'] = False

# ===== 基本参数 =====
DATA_DIR = r"your_path"   # ← 修改为你的 KSC 数据路径
SAMPLE_N = 20           # 抽样数量,避免计算太慢
SEED     = 42

# ===== 1. 读取数据 =====
X_cube = sio.loadmat(os.path.join(DATA_DIR, "KSC.mat"))["KSC"].astype(np.float32)
Y_map  = sio.loadmat(os.path.join(DATA_DIR, "KSC_gt.mat"))["KSC_gt"].astype(int)
coords = np.argwhere(Y_map != 0)
X_all  = X_cube[coords[:,0], coords[:,1]]
y_all  = Y_map[coords[:,0], coords[:,1]] - 1
num_classes = y_all.max() + 1
print(f"有标签像素: {len(y_all)}, 类别数: {num_classes}")

# 抽样(避免计算量过大)
np.random.seed(SEED)
idx = np.random.choice(len(y_all), size=SAMPLE_N, replace=False)
X_sample, y_sample = X_all[idx], y_all[idx]

# 标准化
X_std = StandardScaler().fit_transform(X_sample)

# ===== 2. 定义流形学习方法 =====
methods = {
    "PCA (基线)": PCA(n_components=2, random_state=SEED),
    "Isomap": Isomap(n_components=2, n_neighbors=10),
    "LLE": LocallyLinearEmbedding(n_components=2, n_neighbors=10, random_state=SEED),
    "Spectral Embedding": SpectralEmbedding(n_components=2, n_neighbors=10, random_state=SEED),
    "t-SNE": TSNE(n_components=2, random_state=SEED, init="pca", learning_rate="auto")
}

# ===== 3. 可视化结果 =====
fig, axes = plt.subplots(1, len(methods), figsize=(18, 3.5), constrained_layout=True)
cmap = plt.get_cmap("tab20")

for ax, (name, model) in zip(axes, methods.items()):
    Z = model.fit_transform(X_std)
    sc = ax.scatter(Z[:,0], Z[:,1], c=y_sample, cmap=cmap, s=8)
    ax.set_title(name)

plt.suptitle("KSC 数据二维流形降维对比", fontsize=14)
plt.show()

🔍 结果解读

  • PCA:作为基线,保留全局最大方差方向,但聚类结构不一定明显。

  • Isomap:能展开非线性结构,常用于流形展开。

  • LLE:对局部保持较好,适合流形较复杂时。

  • Spectral Embedding:基于图方法,适合样本点分布稀疏的情况。

  • t-SNE:最常见的可视化方法,能清晰看到类别簇状分布,但计算成本高。

图片

✅ 总结

  • sklearn.manifold 提供了多种非线性降维方法,在高光谱等高维数据的探索性分析中非常有用。

  • 实验表明,PCA 虽然简单高效,但流形学习方法能更好地揭示数据的潜在结构。

  • 需要注意:这些方法主要用于可视化与探索,不适合直接大规模应用于整图分类(计算量太大,且映射不可逆)。

下一篇(案例⑯),我们将介绍 sklearn.cluster 聚类方法,并演示在遥感影像上的无监督分类效果。

欢迎大家关注下方公众号获取更多内容!

HSmartWindowControl vs HWindowControl:Halcon老鸟教你如何根据项目需求选对控件(附性能对比) 本文深度对比Halcon图像处理中的HSmartWindowControl与HWindowControl控件,从性能、内存占用和交互体验等维度提供选型建议。HSmartWindowControl在硬件加速渲染、智能内存管理方面表现优异,特别适合医疗影像和工业检测等高性能需求场景,而HWindowControl则更适合兼容旧系统和资源受限环境。 阅读详情

相关推荐

双极性步进电机驱动技术:从H桥电路到精准控制

本文深入解析了双极性步进电机驱动技术的核心,从H桥电路的基础原理讲起,阐述了其作为实现电机正反转和精准控制的关键。文章详细介绍了H桥的工作模式、防共态导通设计,并对比了L298N、DRV8825及TMC2209等主流集成驱动芯片的选型。进一步探讨了通过微步进与电流矢量控制实现平滑、静音运行的高级技术,并提供了基于STM32的实战代码与避坑指南,帮助开发者从理论到实践全面掌握精准运动控制。

tea88的博客 592

【机器学习300问】139、Post-LN 和 Pre-LN 的区别?

Post-LN与Pre-LN的核心区别在于LayerNorm的位置:Post-LN在残差连接后,导致梯度需经LayerNorm变换,深层易出现梯度衰减或震荡;Pre-LN先做归一化,使输入稳定,残差路径梯度可无损回传,显著提升深层训练稳定性。尽管Pre-LN支持更深层次模型(如LLaMA、Qwen),但存在“深度诅咒”——深层贡献不足。相比之下,Post-LN浅层表现尚可,深层数易发散。因此,现代大模型普遍采用Pre-LN以保障训练可靠性。

qq_39780701的博客 347

在unity urp项目中 通过图片创建材质(透明光晕)

unity中通过图片创造材质(urp管道)

m0_49721415的博客 1536

python 机器学习 交叉验证train_test_split 网格搜索GridSearchCV

最佳参数: {'metric': 'euclidean', 'n_neighbors': 3, 'weights': 'uniform'}交叉验证 用于在数据集中拆分成测试集和验证集,用于模型训练和验证。最佳交叉验证得分: 0.9428571428571428。网格搜索 用于自动查找最合适的模型参数,用于模型调优。测试集准确率: 1.0。

frt的博客 240

FPGA实现PI控制

FPGA实现PI控制

m0_57319166的博客 3888

TSP:车为什么能和云端交互?

TSP:车为什么能和云端交互?

天赐好车的博客 408

【机器学习300问】138、LayerNorm和BatchNorm的区别?

本文阐述了归一化与标准化在深度学习中的核心作用。输入层标准化可统一初始输入,但深层网络仍面临激活分布漂移。为此,提出BatchNorm与LayerNorm两种主流方法。

qq_39780701的博客 176

R数据分析:潜在剖面分析LPA的做法与解释

Latent Profile Analysis (LPA) tries to identify clusters of individuals (i.e., latent profiles) based on responses to a series of continuous variables (i.e., indicators). LPA assumes that there are unobserved latent profiles that generate patterns of resp.

Codewar的博客 1万+

为什么生成对抗网络训练常不稳定,模式崩溃与判别器过强之间是什么关系?

当支持集不重叠时(即 $D$ 能完美区分真假),JS 散度为常数 $\log 2$,其梯度为 0。这意味着一旦 $D$ 训练得稍好,$G$ 就失去了学习方向,导致训练停滞。生成对抗网络(GAN)的训练本质上是生成器($G$)与判别器($D$)之间的非合作零和博弈。以下代码展示了如何通过梯度惩罚(Gradient Penalty)来约束判别器,避免其过强导致生成器梯度失效。判别器过强是导致模式崩溃的直接诱因之一,二者之间存在明确的**“梯度误导”**因果关系。

2402_84593233的博客 195

C#实战:从零搭建Vosk离线语音转文字系统

本文手把手教你用C#构建离线语音转文字系统,基于NAudio和Vosk实现全流程开发。首先介绍环境搭建,包括NuGet包安装和中文模型配置,强调16kHz单声道音频格式的关键性。接着详细解析音频预处理转换、Vosk模型初始化及识别过程的核心代码,提供多线程优化建议和实时识别扩展思路。文章包含80%以上代码注释,从常见问题排查到性能优化技巧,完整覆盖从"Hello World"到工业级部署的关键技术点,特别适合需要开发本地化语音识别应用的C#开发者。

墨夶的博客 752

锁的艺术:Java并发中的常用锁策略与实践

对java锁相关内容进行整理分析:乐观锁 VS 悲观锁+自旋锁 VS 适应性自旋锁+无锁 VS 偏向锁 VS 轻量级锁 VS 重量级锁+公平锁 VS 非公平锁+可重入锁 VS 非可重入锁+独享锁 VS 共享锁

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 171万+

人工智能,机器学习,深度学习,神经网络之间到底是什么关系,它们之间有什么联系和区别

联系:四者是目标 - 方法 - 架构 - 深化的递进关系。AI 是终极目标,ML 是实现 AI 的主流路径,NN 是 ML 中模仿人脑的算法架构,DL 是利用深层 NN 解决复杂问题的最强工具。区别核心AI包含非学习型规则系统(如专家系统)。ML强调“从数据中学习”,但通常需要人工介入特征工程。NN是具体的算法模型,浅层 NN 属于传统 ML。DL特指“深层”NN,核心优势在于自动特征提取和处理非结构化大数据的能力。技术选型建议:若数据量小、特征明确且需要高可解释性(如金融风控表格数据),首选。

2402_84593233的博客 226

AI智能体丨使用Coze一键生成中式养生视频,39 条作品涨粉 37.9 万!(附保姆级教程)

本文介绍如何利用扣子(Coze)AI智能体工作流高效制作中式养生短视频。该方案通过AI自动生成养生文案、古风插画素材、语音合成和视频剪辑,将传统制作流程从2-3小时缩短至1-2分钟。工作流包含文案创作、音频生成、图片素材制作和视频合成四大模块,采用大模型处理各环节内容,最终输出可直接导入剪映的草稿文件。特别适合希望快速批量制作文化氛围感强、兼具干货与视觉效果的养生内容创作者,效率提升近百倍。

李同学Lino的博客 3025

【人工智能驱动的电催化研究-01】人工智能是什么?AI、机器学习、深度学习和神经网络之间有什么区别?

介绍人工智能、机器学习、神经网络和深度学习的基本概念及相互关系。围绕催化剂性能预测,解释样本、特征、标签、模型、参数、训练、预测与验证的含义。结合二硫化钼边缘位点与析氢活性的研究案例,说明科学问题如何指导特征选择。利用真实文献中的析氢数据,通过手算和Python实践,对比人工规则与均值模型,理解参数学习和误差评价。强调数据学习不保证预测更优,相关性不能直接证明反应机理,文献数据还须核查实验条件与适用范围,为后续编程、数学和电催化机器学习课程建立基础。

2402_84593233的博客 748

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

机器学习01,KNN使用与简单数学原理

个人笔记

qq_59247073的博客 247

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

机器学习教程,从入门到精通,高斯混合模型(GMM)——写给机器学习小白的保姆级教程(10)

高斯混合模型(Gaussian Mixture Model,简称 GMM):假设你手里的数据是由"好几堆正态分布的数据混在一起"形成的,GMM 的任务就是——把这几堆分开,并且描述清楚每一堆的样子。

qq_45746668的博客 108

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

机器学习01,了解与KNN

个人笔记

qq_59247073的博客 343

【slam公式】

F:状态转移矩阵H:观测矩阵R: 观测噪声协方差。

qq_44691564的博客 285

基于有效Token规模化的大模型预训练数据配方与工程体系研究——基于唐杰《高级机器学习》课程演讲

在此背景下,本文系统梳理GLM系列模型数据迭代轨迹,纠正数据墙认知偏差,分析天然数据与合成数据的互补机制,并完整构建支撑高质量Token挖掘的全链路数据工程体系,为大模型数据规模化建设提供理论与工程参考。早期小模型训练场景下,数据总量远大于算力可消化量,核心策略为择优筛选少量高质量数据。基于唐杰公开演讲核心观点、GLM数据迭代、数据墙、合成数据、清洗解析工具链、分层架构图、自研工程壁垒),完整重构成一篇结构严谨、逻辑连贯、标准期刊论文风格全文,预留精准图片插入位置,可直接定稿、查重、发表、结课提交。

interpromotion的博客 231

机器学习-支持向量机

本文通过多个案例深入解析SVM在二分类、多分类及高维文本数据中的应用。基于乳腺癌数据集,构建标准化+SVM的流水线,结合网格搜索优化C与gamma参数,实现98.02%的测试准确率。通过交叉验证评估模型稳定性,结果显示标准差仅0.0162,表明模型鲁棒性强。引入probability=True后,可输出预测概率,揭示模型不确定性(如样本4的52%良性概率),助力医疗决策。结果表明,特征维度提升需调小gamma、增大C以适应复杂数据,凸显参数与数据特性的交互关系。

buwangchuxinking的博客 325

茶叶病虫害目标检测数据集

目标检测 yolo 目标检测数据集 茶叶病虫害目标检测数据集

DL_data_set的博客 338

生成式对抗网络GAN(Generative Adversarial Network)

和我们之前所说的梯度消失的问题类似所以很长一段时间用GAN来生成Sequence文字是非常困难的更多的生成模型:但是一般还是GAN产生的结果最好。

2303_76561497的博客 155

分布式计算框架如何赋能大规模机器学习

PyTorch 和 TensorFlow 是当今最流行的深度学习框架,它们都提供了强大的内置库来支持分布式训练。其核心策略主要分为数据并行和模型并行。

Cat_fish_snow的博客 172

基于机器学习的酒店数据分析及流失预测系统

本系统是一个面向酒店行业的客户数据分析与流失预测平台,基于 Antonio et al. (2019) 公开的酒店预订需求数据集,采用 Flask + SQLite + ECharts + scikit-learn 技术栈,实现数据可视化分析、机器学习流失预测、模型管理等功能,帮助酒店管理者识别流失风险客户并制定针对性挽留策略。流失(1):预订取消(is_canceled = 1),或非回头客且有历史取消记录未流失(0):不符合上述条件的客户。

aiyuanma_vip的博客 335

40V/24A高频率增强型GaN HEMT功率开关管/高频DC转换/电动工具/GaN充电器 方案首选

是一种增强型硅基氮化镓晶体管。氮化镓是一种宽禁带半导体,具有高功率密度。氮化镓晶体管的特点是没有体二极管,因此反向恢复电荷为零。这种氮化镓高电子迁移率晶体管(HEMT)是一种高性能增强型氮化镓HEMT,可实现优异的高频和高效率运行。该氮化镓功率HEMT结合了最高的dv/dt抗扰性以及行业标准的低轮廓、低电感FCQFN 3x4封装,使设计人员能够实现简单、快速且可靠的解决方案。符合RoHS、无铅、REACH标准。提供FCQFN 3x4封装。无人机及遥控模型电子调速器。高频DC-DC转换器。

2301_76864527的博客 224

分类模型评估:混淆矩阵、精确率、召回率与阈值调整

模型训练后仅凭准确率(如87%)无法判断是否可用,因它忽略错误类型与业务代价。本文以BERT中文情感分类为例,系统演示模型评估流程:通过混淆矩阵分析预测结果,结合精确率、召回率、F1等指标全面评估性能。代码实现中,使用sklearn计算各类指标,并可视化混淆矩阵,揭示模型在类别不平衡下的真实表现,强调应根据实际场景选择合适评估标准,避免误判风险。

weixin_50260670的博客 278
上一篇: 遥感&机器学习入门实战教程|Sklearn案例⑭:数据划分与交叉验证(KSC 真实数据)
下一篇: 遥感&机器学习入门实战教程|Sklearn案例⑯:聚类与无监督分类(cluster 模块)
遥感AI实战
博客等级 码龄9年 1002粉丝 107原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

遥感AI实战

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值