机器学习很有趣!第六章:通过机器学习进行语音识别

人工智能 基于机器学习的AI语音识别(ASRT) (一)环境搭建 Anaconda 安装 tensorflow 环境详细教程 教你判断如何选择 tensorflow-cpu 和 tensorflow-gpu 机器学习 AI人工智能 语音识别 语音识别训练 阅读详情

作者:Adam Geitgey

原文:https://medium.com/@ageitgey/machine-learning-is-fun-part-4-modern-face-recognition-with-deep-learning-c3cffc121d78

翻译:拼命先生

转载请联系译者!


语音识别正在侵入我们的生活。它内置于我们的手机,游戏机和智能手表中。它甚至可以使我们的家庭自动化。只需50美元,您就可以获得一个Amazon Echo Dot 魔术盒,它可帮您订购披萨,获取天气预报甚至购买垃圾袋,只需大声说出:Alexa, 订购一个大号的披萨!

Alexa,订一个大号的比萨!

但语音识别已经存在了几十年了,那为什么它现在才成为主流呢?原因在于深度学习最终使语音识别足够准确,足以在实验室环境之外的场景使用。

吴恩达Andrew Ng长期以来预测,随着语音识别从95%准确到99%准确,它将成为我们与计算机交互的主要方式。这就是说,这4%的差距,就是“很不靠谱”和“非常有用”的差异。感谢深度学习,我们终于达到了顶峰。

让我们学习如何通过深度学习进行语音识别!


机器学习并不总是黑盒子

如果你知道神经机器翻译是如何工作的,你可能会想到我们可以简单地将录音输入神经网络并训练它来产生文本:

这是深度学习语音识别的圣杯,但我们还没有达到(至少在我写这篇文章的时候 - 我打赌我们将会在几年内)。

最大的问题是语音速度不同。一个人可能会很快说“Hello!”而另一个人可能会非常缓慢地说“Heeeelllllllllllllooooo!”,从而生成一个包含更多数据的更长声音文件。两个声音文件都应该被识别为完全相同的文本 - “Hello!”,而自动将各种长度的音频文件对齐到固定长度的文本相当困难。

要解决这个问题,除了深度神经网络之外,我们还必须使用一些特殊的技巧和额外的动作。让我们看看它是如何工作的!


把声音变成比特

语音识别的第一步显而易见 - 我们需要将声波输入计算机。

在第3章中,我们学习了如何拍摄图像并将其视为数字数组,以便我们可以直接将其提供给神经网络以进行图像识别:
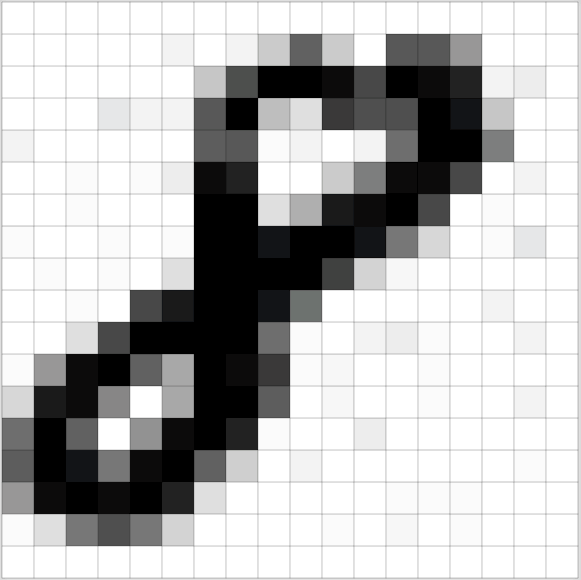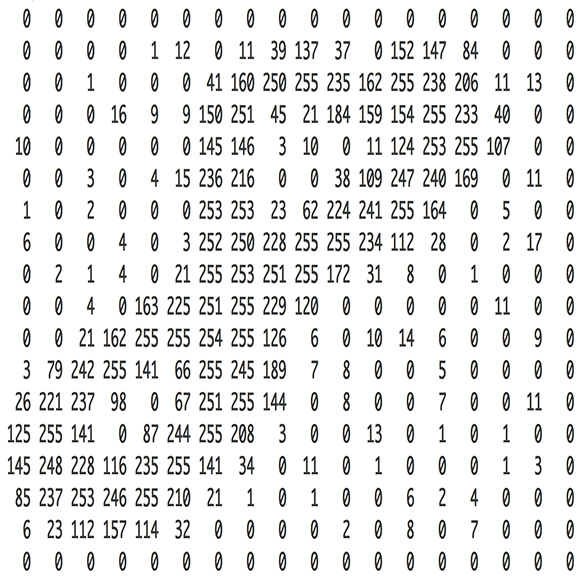
图像只是图片中每个像素深度的数字编码序列

但声音是以波浪的形式传播的。我们如何将声波转换为数字?让我们用我说的“hello”这个声音片段举个例子:

我说的"hello"的波形

声波是一维的。在每个时刻,他们都有一个基于波浪高度的高度值。让我们放大声波的一小部分,看看:

要将此声波转换为数字,我们只需在等间距点记录波的高度:

采样声波

这称为采样(sampling)。我们每秒读取数千次读数,并记录表示该时间点声波高度的数字。这基本上都是一个未压缩的.wav音频文件。

“CD质量”音频采样为44.1khz(每秒读数为44,100)。但对于语音识别,16khz(每秒16,000个采样)的采样率足以覆盖人类语音的频率范围。

让我们每秒16,000次采样我们的“Hello”声波。这是前100个样本:

每个数字表示声波1/16000秒的间隔的振幅

数字采样小助手

您可能认为采样只是创建原始声波的粗略近似值,因为它只是偶尔读取。我们的读数之间存在差距所以我们必须丢失数据,对吧?

数字采样能否完美地重现原始的模拟声波?那些差距怎么办?

但是由于采样定理(奈奎斯特Nyquist theorem定理),我们知道我们可以根据间隔采样数据,使用数学来完美地重建原始声波,只要我们采样的速度至少是我们想要记录的最高频率的两倍。

我之所以提到这一点,只是因为几乎每个人都错了,并假设使用更高的采样率总能带来更好的音质。其实并不是这样。


预处理我们的声音采样数据

我们现在有一个数字数组,每个数字代表声波的振幅,以1/16,000秒为间隔。

我们可以将这些数字直接输入神经网络。但是试图通过直接处理这些样本来识别语音模式是困难的。相反,我们可以通过对音频数据进行一些预处理来简化问题。

让我们首先将我们的采样音频分组为20毫秒长的块。这是我们之前的20毫秒音频(即我们的前320个样本):

将这些数字绘制为简单的折线图,可以在20毫秒的时间内粗略估计原始声波:

该记录的长度只有1/50秒,但即便是这么短的录音也是一种不同频率声音的复杂混合物。有一些低音,一些中音,甚至还有一些高音。但是把它们放在一起,这些不同的频率混合在一起,构成了复杂的人类语音。

为了使神经网络更容易处理这些数据,我们将把这个复杂的声波分解成一个个组成部分。我们将分离低音部分,再分离次低音调部分,以此类推。然后通过计算每个频段(从低到高)的能量,我们为此音频片段创建了指纹(fingerprint )。

想象一下,你有一个人在钢琴上演奏C大调和弦的录音。那个声音是三个音符C,E和G的组合,所有音符都混合成一个复杂的声音。我们希望将复杂的声音分解为单个音符,以此分辨C,E和G,这是和语音识别是完全相同的倒立。

我们使用称为傅立叶变换(Fourier Transform)的数学运算来完成此操作。它将复杂的声波分解成简单的声波。一旦我们获得了那些简单的声波,我们就会把每个声波中包含的能量相累加。

最终结果是从低音到高音,每个频率范围的重要性得分。下面的每个数字代表我们20毫秒音频剪辑的每个50赫兹频段的能量:

列表中的每个数字表示那 50Hz 的频段所含的能量

不过,把它们画成这样的图表会更加清晰:

如果我们在每20毫秒的音频块上重复这个过程,我们最终得到一个频谱图(从左到右的每个列都是一个20ms的块):

“hello”声音片段的完整频谱图

频谱图很酷,因为您实际上可以在音频数据中看到音符和其他音高模式。对于神经网络来说,相比原始声波,在这种数据中更容易找到规律。所以这就是我们实际输入到神经网络中的数据表示方式。


从短声音识别字符

现在我们有了格式易于处理的音频,我们将把它输入到深度神经网络中去。神经网络的输入将会是 20 毫秒的音频块。对于每个小的音频切片(audio slice),神经网络都将尝试找出当前正在说的声音所对应的字母。


我们将使用循环神经网络(RNN)  - 即具有影响未来预测的记忆能力的神经网络。这是因为它预测的每个字母都会影响它预测下一个字母的可能性。例如,如果到目前为止我们已经说过“HEL”,那么我们很可能接下来会说“LO”,来完成“Hello”。我们不太可能会像“XYZ”那样说一些不可发音的东西。因此,对先前预测的记忆有助于神经网络进行更准确的预测。

在我们通过神经网络(一次一个块)运行我们的整个音频剪辑之后,我们将最终得到每个音频块和其最优可能对应的字母的映射。这是对于“hello”的映射看起来的样子:

我们的神经网络预测我可能说的是“HHHEE_LL_LLLOOO”这个东西。但它也认为有可能我说“HHHUU_LL_LLLOOO”甚至“AAAUU_LL_LLLOOO”。

我们有一些步骤来清理这个输出。首先,我们将替换任何重复字符的单个字符:

  • HHHEE_LL_LLLOOO变为HE_L_LO
  • HHHUU_LL_LLLOOO变为HU_L_LO
  • AAAUU_LL_LLLOOO变为AU_L_LO

然后我们将删除任何空白:

  • HE_L_LO变为HELLO
  • HU_L_LO变成了HULLO
  • AU_L_LO变为AULLO

这给我们留下了三个可能的结果 - “Hello”,“Hullo”和“Aullo”。如果你大声说出来,所有这些听起来都像“hello”。因为神经网络一次预测一个字符,所以它会得出一些纯粹表示发音的转录。例如,如果你说“He would not go”,它可能会给出一个可能的转录“He wud net go”。

诀窍是将这些基于发音的预测与基于书面文本(书籍,新闻文章等)的大型数据库的可能性得分相结合。你扔掉似乎最不可能的结果,并保留看起来最真实的结果。

在我们可能的结果 “Hello”,“Hullo”和“Aullo”中,显然“Hello”将更频繁地出现在文本数据库中(更不用说在我们原始的基于音频的训练数据中),因此可能是正确的。所以我们选择“Hello”作为我们的最终结果而不是其他。完成!

等一等!

你可能会想“但如果有人说' Hullo '怎么办?这是一个有效的词。也许'hello'是错误的结果!“
喂,是谁?

当然有人可能会说“Hullo”而不是“hello”。但像这样的语音识别系统(受美国英语训练)基本上不会产生“Hullo”的结果。对于用户而言,与“hello”相比,无论你多么强调“U”声,它总是会认为你在说“hello”。

试试看!如果您的手机设置为美式英语,请尝试让手机的语音助理识别“Hullo”。这肯定不行!它拒绝!它总是将其理解为“hello”。

不识别“Hullo”是一种合理的行为,但有时你会发现烦人的情况,你的手机总是拒绝理解你说的有效的东西。这就是为什么这些语音识别模型总是被不断训练,需要更多的数据来修复这些少数情况。


我可以建立自己的语音识别系统吗?

关于机器学习最酷的事情之一就是它有时看起来有多简单。你获得了大量数据,将其输入到机器学习算法中,然后神奇地得到了一个可以运行在你游戏笔记本电脑显卡上的世界级的AI系统...... 对吗?

在某些情况下,这种情况确实如此,但不适用于语音识别。言语识别是一个难题。您必须克服几乎无穷无尽的挑战:质量差的麦克风,背景噪音,混响和回声,重音变化等等。所有这些问题都需要存在于您的训练数据中,以确保神经网络能够处理它们。

这里有另一个例子:你知道吗,当你在一个嘈杂的房间里说话时,你会无意识地提高你的声音,以便能够盖过噪音?无论哪种方式,人类对你的理解都没有问题,但需要训练神经网络来处理这种特殊情况。因此,您需要人们大声讲话的训练数据!

要构建一个在Siri,Google Now!或Alexa级别上执行的语音识别系统,您将需要大量的培训数据 - 如果你不雇佣数百人为您录制,这将远远超过您能够获得的数据。由于用户对低质量语音识别系统的容忍度较低,因此您不能吝啬这一点。没有人想要一个只有80%的时间可以正常工作的语音识别系统。

对于像谷歌或亚马逊这样的公司来说,在现实生活中记录的数十万小时的语音就是黄金。这是世界级语音识别系统与您的系统拉开距离的地方。让你免费使用 Google Now 或 Siri,或是只要 50 美元购买 Alexa 而没有订阅费的意义就是:让你尽可能多地使用它们。您对其中一个系统说的每一件事都会被永久记录下来,并用作未来版本的语音识别算法的训练数据。这就是整场比赛!

不相信我?如果你有一部带有Google Now的Android手机!,点击这里聆听自己曾经对它说过的每一个愚蠢的事情:
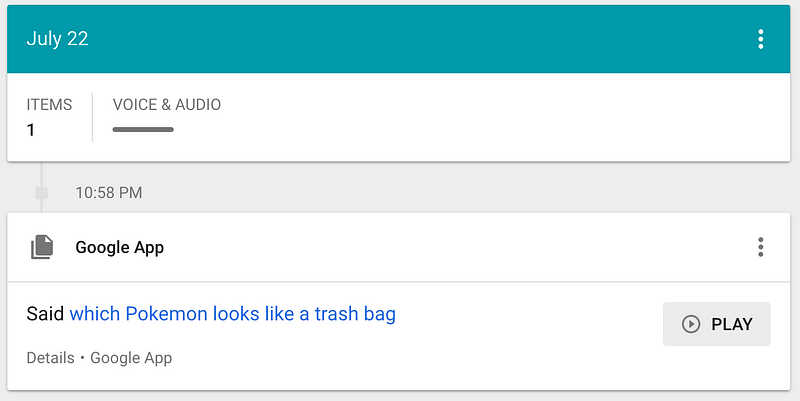
您可以通过Alexa应用程序访问Amazon的相同内容。不幸的是,Apple不允许您访问Siri语音数据

因此,如果你正在寻找一个创业的想法,我不建议你尝试建立自己的语音识别系统来与 Google 竞争。相反,你应该想个办法,让人们把自己讲了几个小时的录音交给你。这种数据可以是你的产品。

路在远方……

这个用来处理不同长度音频的算法被称为连接时序分类(Connectionist Temporal Classification)或 CTC。你可以阅读这篇 2006 年文章。

百度的亚当·科茨(Adam Coates)在湾区深度学习学校做了关于「深度学习语音识别」的精彩演讲。你可以在 YouTube 上观看这段视频。强烈推荐。

 

第六章——机器学习(神经学习) 一、神经学习 1.神经网络基础概念: 人工神经网络又叫神经网络,是借鉴了生物神经网络的工作原理形成的一种数学模型。神经网络是机器学习诸多算法中的一种,它既可以用来做有监督的任务,如分类、视觉识别等,也可以用作无监督的任务。同时它能够处理复杂的非线性问题,它的基本结构是神经元,如下图所示: 其中,x1、x2、x3代表输入,中间部分为神经元,而最后的hw,b(x)是神经元的输出。整个过程可以理解为输入——>处理——>输出。 由多个神经元组成的就是神经网络: 这是一个4层结构的神.. 阅读详情

相关推荐

机器学习与深度学习的对比研究

从模型复杂度来看,深度学习通过构建深层次的神经网络模型,实现了对复杂数据的深层特征提取与学习,展现出在处理图像识别、语音识别等复杂任务中的优势。例如,在图像处理领域,监督学习技术可以用于图像分类、目标检测、人脸识别等任务,通过训练深度神经网络模型来提取图像中的特征信息,并实现对不同类别图像的准确识别。深度学习模型,特别是深度神经网络,由大量的神经元和连接构成,形成了复杂的网络结构。同时,深度学习算法的优化也将成为研究热点,包括更高效的训练算法、更精确的模型评估方法等,以加速模型的训练和提高预测准确性。

阿尔法星球的专栏 1874

机器学习实现语音识别的背后技术详解

语音识别是指通过计算机技术对语音信号进行处理和分析,从而实现语音到文本的转换。它涉及到信号处理、特征提取、模型训练和语音合成等方面。为了更好地理解语音识别在实际应用中的工作原理,我们将使用一个流行的数据集——TIMIT数据集。TIMIT数据集包含了来自不同口音的英语母语者的语音样本,这些样本涵盖了不同的发音和语调。# 加载TIMIT数据集# 加载数据集总结而言,本文详细介绍了机器学习在语音识别领域的应用,从基本概念和方法出发,逐步深入到案例分析、模型优化和API部署。

极客代码 2275

第六章:模型训练:赋予智能导购智慧

第六章:模型训练:赋予智能导购智慧 1. 背景介绍 随着电子商务的蓬勃发展,消费者面对海量商品时,往往感到无所适从。智能导购应运而生,旨在为用户提供个性化推荐和购物指导,提升用户体验和购买效率。模型训练是智能导购的核心环节,它决定了导购系统的智能程度和推荐效果。

AI天才研究院 741

语音识别与语音合成:机器学习在音频处理领域的应用

1.背景介绍 语音识别和语音合成是人工智能领域的两个重要应用,它们在日常生活和工作中发挥着越来越重要的作用。语音识别(Speech Recognition)是将语音信号转换为文本信息的技术,而语音合成(Text-to-Speech Synthesis)是将文本信息转换为语音信号的技术。这两个技术的发展与机器学习紧密相关,尤其是深度学习在这两个领域的应用使得技术的进步变得更加快速。 在本文中,我...

AI天才研究院 1822

ISP一键下载电路分析+74HC1G66GW(信号图)

之前要不用的最小系统的开发板要不就是用的SWD调试口,没有注意过ISP一键下载电路是个怎么回事,因为需要就简单的看了一下野火的ISP一键下载电路。 默认情况一下,一般我们的程序都是从用户闪存也就是内部的FLASH启动的, 对于F103RCT6来说ROM的大小是512kb,启动地址位0x8000000,这个在IDE keil里可以看的到,如下图。 首先简单理解一下ISP是什么: 可以把他理解为芯片厂商出场时固化在ROM当中的一段程序,它的功能就是把你写的程序一点点的搬运到FLASH当中,它引出了两个引脚

lipengyu1363658871的博客 4861

GB28181安防平台未授权访问漏洞:原理、复现与修复指南

未授权访问漏洞是Web安全中常见的访问控制缺陷,其本质在于应用在提供对敏感功能或数据的访问前,未能对请求者的身份和权限进行充分验证。从技术原理上看,这类漏洞常源于拦截器配置错误、安全注解遗漏或自定义校验逻辑缺陷,导致本应受保护的API接口被意外暴露。在工程实践中,此类漏洞危害巨大,攻击者无需登录即可直接访问系统核心接口,可能引发敏感信息泄露、权限提升甚至系统接管。尤其在安防监控、物联网管理平台等场景中,一旦涉及用户管理接口(如`/api/user/**`),风险会急剧放大。本文以GB28181视频监控管理平

weixin_30271335的博客 438

基于机器学习的语音情感识别系统的设计

语音是很重要的表达素材,其中不仅包含了说话人所要表达的文本内容,也同时包含了说话人所要表达的情感,所以对语音中情感内容的有效准确识别不仅能够提升语音辨别度,更是提高了语音的可懂度,因此,人工智能和机器学习在这方面的应用和优势便显而易见。如图可以看出对样本happy.223我们进行了10次实验,二项式核函数的准确率依然表现稳定,其中也是有6次的识别准确率在70%以上,而剩下4次的识别准确率也在60%以上,最高的已达75.8%,虽然最高的识别准确率没有生气高,但是总体的水平比较稳定。

m0_73485263的博客 3069

AutoCAD提示找不到acdb24.dll、AcGe24.dll、AcPal.dll、AcUt.dll怎么办?

在我们安装了AutoCAD 2023版本以后,打开CAD,可能会出现dll文件丢失的情况,如下所示:1、由于找不到acdb24.dll,无法继续执行代码。重新安装程序可能解决此问题。2、由于找不到AcGe24.dll,无法继续执行代码。重新安装程序可能解决此问题。3、由于找不到AcPal.dll,无法继续执行代码。重新安装程序可能解决此问题。4、由于找不到AcUt.dll,无法继续执行代码。重新安装程序可能解决此问题。遇到AutoCAD启动系统错误,由于找不到dll文件该怎么处理呢?

huoxu369的博客 1万+

机器学习 - 语音识别

语音识别 声音的本质是震动,震动的本质是位移关于时间的函数,波形文件(.wav)中记录了不同采样时刻的位移。 通过傅里叶变换,可以将时间域的声音函数分解为一系列不同频率的正弦函数的叠加,通过频率谱线的特殊分布,建立音频内容和文本的对应关系,以此作为模型训练的基础。 案例: import numpy as np import numpy.fft as nf import scipy.io.wavfi...

哦 卷! 3739

【全开源】旅游系统源码(Uniapp+FastAdmin+ThinkPHP)

通过源码的灵活配置和定制开发,我们可以根据旅游企业的实际需求,快速构建出符合其业务特点的旅游系统。旅游系统源码,作为这一变革的基石,为旅游业的数字化转型提供了强有力的支撑。通过深入研究和应用旅游系统源码,我们能够构建出更加智能、便捷、个性化的旅游服务平台,满足游客日益增长的旅游需求。国际化发展:随着全球化的深入发展,旅游系统源码也将迎来国际化的发展机遇,为国内外游客提供更加便捷、高效的旅游服务。跨界融合:旅游系统源码将与更多领域进行跨界融合,如与交通、餐饮、购物等行业的结合,为游客提供更加丰富的旅游体验。

2401_84413757的博客 2151

如何绘制电气绝缘图(GB9706.1-2007和GB9706.1-2020差异)

是用来描述要考虑设备的绝缘状况和它们的值 ,从而便于和相关部门交流和沟通,如权威机构和检测实验室等。本文为绝缘图的实例, 包括所有相关的绝缘路径以及介电强度,爬电距离和电气间隙的值。

学海无涯的专栏 1万+

机器学习(浙大课程b站)第六章

机器学习(浙大课程b站)第六章:传统机器学习笔记测验 笔记 特征提取-主成分分析(Principle Component Analysis, PCA) 主成分分析本质是寻找使方差最大的方向,并在该方向投影。 Mooc上的清楚一点: PCA算法: 更正: 总结:如果特征数量大且可能存在冗余,用PCA降维往往能收到好的效果,这也就是PCA在机器学习中被广泛运用的原因。 这带来一个问题:PCA需要降维到什么程度?即Y的维度M如何确定? 采取能量百分率准则: 一般选取

qq_43541776的博客 1619

【数据结构】期末考试复习(考点+例题)

1.线性表定义及其存储实现:顺序表和链接表,优缺点分析(顺序存储可随 机访问,链式存储可灵活利用空间),相关操作的时间复杂度。 2.链表的插入删除操作 3.两种特殊的线性表及其应用:栈、队列 4.栈、队列上的(插入/删除)操作及其特点 5.循环队列满和空的条件 6.能够定义线性表、栈、队列的数据存储结构,能够实现相关操作的算法并 分析时间复杂度(例如插入、删除及其它应用等) 7.理解线性结构的应用( 如根据要求能灵活定义线性表结构,能根据线性表 的插入、删除操作解决实际问题) 二叉树基本概念与性质(高

Molly 的博客 9370

相比于深度学习,传统的机器学习算法难道就此没落了吗,还有必要去学习吗?

自从 MIT Technology Review(麻省理工科技评论) 将 深度学习 列为 2013 年十大科技突破之首。加上今年 Google 的 AlphaGo 与 李世石九段 惊天动地的大战,AlphaGo 以绝对优势完胜李世石九段。人工智能、机器学习、深度学习、强化学习,成为了这几年计算机行业、互联网行业最火的技术名词。 其中,深度学习在图像处理、语音识别领域掀起了前所未有的一场革命。我本人...

张齐贤的博客 6503

北斗导航 | 从北一到北二再到北三,你应该知道的北斗导航系统

博主github:https://github.com/MichaelBeechan 博主优快云:https://blog.youkuaiyun.com/u011344545 一、引言 我国高度重视北斗系统的建设和发展。自20世纪80年代开始探索适合我们国家国情的卫星导航系统发展道路,形成了“三步走”的发展战略:2000年底,建成北斗一号导航系统,向我国广大用户提供服务;2012年底,建成北斗二号导航系统,...

尘世冰封的专栏 3079

DSI3协议介绍

分布式系统接口(DSI)是一种通用且功能强大的总线协议,旨在将多个遥感器和执行器设备互连到中央控制模块。该网络的主要目标应用是汽车安全系统。这种应用的一些特点是需要低成本、高鲁棒性、中速互连,仅限于两根导线。此外,它必须具有故障安全性、确定性和良好的EMC特性。即使具有所有级别的智能和可编程性的设备都可以连接到网络,远程设备也必须能够通过简单的状态机实现。由于模块尺寸非常重要,因此中央模块和远程单元中的最小组件至关重要。

汽车电子软件领域知识分享 1万+

第六章:数据分析与机器学习的关系

1.背景介绍 1. 背景介绍 数据分析和机器学习是当今计算机科学领域中最热门的话题之一。数据分析是一种用于发现数据中隐藏模式、趋势和关系的方法,而机器学习则是一种通过计算机程序自动学习和改进的方法。在这篇文章中,我们将探讨数据分析与机器学习之间的关系,以及它们在实际应用中的重要性。 2. 核心概念与联系 数据分析和机器学习之间的关系可以从多个角度来看。首先,数据分析是机器学习的基础,因为机...

AI天才研究院 1122

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

博客摘录「 机器学习入门好文,强烈推荐」2023年5月5日

1、从广义上来说,机器学习是一种能够赋予机器学习的能力以此让它完成直接编程无法完成的功能的方法。但从实践的意义上来说,机器学习是一种通过利用数据,训练出模型,然后使用模型预测的一种方法2、通过拟合直线的过程,我们可以对机器学习过程做一个完整的回顾。首先,我们需要在计算机中存储历史的数据。接着,我们将这些 数据通过机器学习算法进行处理,这个过程在机器学习中叫做“训练”,处理的结果可以被我们用来对新的数据进行预测,这个结果一般称之为“模型对新数据 的预测过程在机器学习中叫做“预测。

qq_46887567的博客 463

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

第六章 循环神经网络

第六章 循环神经网络第六章 循环神经网络给网络增加记忆能力延时神经网络有外部输入的非线性自回归模型循环神经网络简单循环网络循环神经网络的计算能力应用到机器学习序列到类别模式同步的序列到序列模式异步的序列到序列模式参数学习随时间反向传播算法实时循环学习算法长程依赖问题改进方案基于门控的循环神经网络长短期记忆网络LSTM 网络的各种变体门控循环单元网络深层循环神经网络堆叠循环神经网络双向循环神经网络扩...

Avery123123的博客 1948

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

基于知识图谱的垃圾自动分类系统设计与实现(Python+语音识别)

本文设计并实现了一个基于知识图谱的垃圾自动分类系统。系统采用Python技术结合MySQL数据库,通过构建垃圾类别知识图谱,实现音频文件的语音识别和文本分类。研究内容包括知识图谱构建、语音识别算法实现、文本分类功能开发及用户界面设计。系统采用模块化架构,包含前台展示和后台管理功能模块,并通过数据库详细设计支持知识图谱存储。测试结果表明系统能有效完成用户注册、垃圾分类管理等核心功能。该研究为垃圾分类技术提供了新的解决方案,具有实际应用价值。

毕业作品网站 1533

TensorFlow 机器学习项目(二)

在本章中,我们学习了一个将音频数据转为文本的项目。现在有许多开源 SDK 和商业付费云服务,可以将音频记录和文件转换为文本数据。作为示例项目,我们使用了 Google 的语音命令数据集和 TensorFlow 基于深度学习的示例,将音频文件转换为语音命令进行识别。在下一章,我们将继续这个旅程,构建一个使用高斯过程预测股票价格的项目,这是一个广泛用于预测的算法。既然我们已经了解了贝叶斯法则的基础知识,接下来让我们尝试理解贝叶斯推断或建模的概念。

龙哥盟 2006

第六章 深度学习

主要就是对代码的解读,用的是theano框架。文件是network3.py,有空再看吧。 本章,我们将给出可以用来训练深度神经网络的技术,并在实战中应用它们。同样我们也会从更加广阔的视角来看神经网络,简要地回顾近期有关深度神经网络在图像识别、语音识别和其他应用中的研究进展。然后,还会给出一些关于未来神经网络又或人工智能的简短的推测性的看法。 本章主要的部分是对最为流行神经网络之一的深度卷积网络的介绍。我们将细致地分析一个使用卷积网络来解决 MNIST 数据集的手写数字识别的例子.我们将从浅层的神经网络开始来

weixin_43938663的博客 240
上一篇: 几种报错的解决办法
下一篇: 最简单的Tensorflow实战入门教程 - 第一篇:Tensorflow的安装
拼命先生A
博客等级 码龄18年 39粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
