深度学习之数据预处理

大数据——数据预处理 数据预处理(data preprocessing)是指在主要的处理以前对数据进行的一系列处理,如对大部分地球物理面积性观测数据在进行转换或增强处理之前,首先将不规则分布的测网经过插值转换为规则网的处理,以利于计算机的运算。数据预处理是大数据分析中不可或缺的一环,涉及数据清洗、集成、规约和变换等多个步骤。通过清洗,去除无关、缺失和异常数据;集成,合并多个数据源;规约,精简数据量;变换,规范化和离散化数据,使之更适合挖掘和分析。数据预处理能显著提升数据质量,确保分析结果的准确性和稳定性。 阅读详情


人工智能学习离不开实践的验证,推荐大家可以多在FlyAI-AI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

如果做过DNN的实验,大家可能会发现在对数据进行预处理,例如白化或者z-score,甚至是简单的减均值操作都是可以加速收敛的,例如下图所示的一个简单的例子:
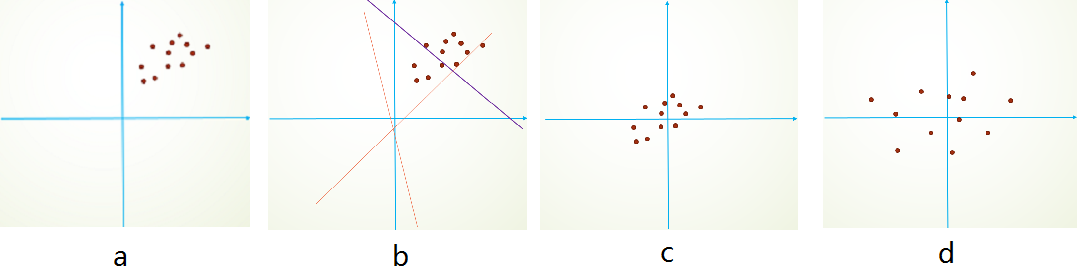
图中红点均代表二维的数据点,由于图像数据的每一维一般都是0 2550 255之间的数字,因此数据点只会落在第一象限,而且图像数据具有很强的相关性,比如第一个灰度值为3030,比较黑,那它旁边的一个像素值一般不会超过100100,否则给人的感觉就像噪声一样。由于强相关性,数据点仅会落在第一象限的很小的区域中,形成类似上图a所示的狭长分布。

而神经网络模型在初始化的时候,权重WW是随机采样生成的,一个常见的神经元表示为:ReLU(Wx+b)=max(Wx+b,0)ReLU(Wx+b)=max(Wx+b,0),即在Wx+b=0Wx+b=0的两侧,对数据采用不同的操作方法。具体到ReLU就是一侧收缩,一侧保持不变。随机的Wx+b=0Wx+b=0表现为图b中的随机虚线,由于初始化参数一般都是00均值的,因此开始的拟合y=Wx+by=Wx+b,基本过原点附近,如图b中的红色虚线。注意到,这两条红色虚线实际上并没有什么意义(没有分割到数据点)。在使用梯度下降时,可能需要很多次迭代才会使这些虚线对数据点进行有效的分割(如紫色虚线),即网络需要经过多次学习才能逐步达到如紫色实线的拟合=》收敛比较慢。

更何况,我们这只是个二维的演示,数据占据四个象限中的一个,如果是几百、几千、上万维呢?而且数据在第一象限中也只是占了很小的一部分区域而已,可想而知不对数据进行预处理带来了多少运算资源的浪费,而且大量的数据外分割面在迭代时很可能会在刚进入数据中时就遇到了一个局部最优,导致overfit的问题。

这时,如果我们对输入数据先作减均值操作,数据点就不再只分布在第一象限了,如图c,这时一个随机分界面落入数据分布的概率增加了多少呢?2n2n倍!更进一步的,我们对数据再使用去除相关性的算法,例如PCA和ZCA白化,数据不再是一个狭长的分布而更加容易区分,这样又会加快训练,如图d。随机分界面有效的概率就又大大增加了。

不过计算协方差矩阵的特征值太耗时也太耗空间,我们一般最多只用到z-score处理,即每一维度减去自身均值,再除以自身标准差,这样能使数据点在每维上具有相似的宽度,可以起到一定的增大数据分布范围,进而使更多随机分界面有意义的作用。

2|0常见的预处理方法

2|1预处理为什么要归一化

前面讲了数据预处理对于模型训练的重要性,那么回归到输入数据的整体分布来看,在训练开始前,都要对输入数据做一个归一化处理,本质原因还是在于神经网络学习过程本质就是为了学习数据分布,一旦训练数据与测试数据的分布不同,那么网络的泛化能力也大大降低;另外一方面,一旦每批训练数据的分布各不相同(batch 梯度下降),那么网络就要在每次迭代都去学习适应不同的分布,这样将会大大降低网络的训练速度,这也正是为什么我们对输入数据都需要做一个归一化预处理的原因。

2|2归一化、标准化与中心化

归一化、标准化可以说是数据处理中最常被提及的词汇之二了,关于二者的定义比较相似,也容易混淆。查阅了网上的各种资料,发现其实所谓“归一化”和“标准化”在不同人的不同文章中,可能有着不一样的定义。那么撇开指代模糊的名字,从最明确公式定义来看,“归一化”和“标准化”通常指的是这四种特征缩放(Feature Scaling):

  1. Rescaling (min-max normalization) 有时简称normalization(有点坑):

    x′=x−min(x)max(x)−min(m)x′=x−min(x)max(x)−min(m)

  2. Mean normalization:

    x′=x−mean(x)max(x)−min(x)x′=x−mean(x)max(x)−min(x)

  3. Standardization(Z-score normalization):

    x′=x−mean(x)σx′=x−mean(x)σ

  4. Scaling to unit length:

    x′=x||x||x′=x||x||

一般把第一种叫做归一化,第三种叫做标准化。而正则化的英文应该是Regularization,有时也被弄混,正则化是完全不同的事情了。而关于在机器学习中是用第一个好还是第三个好,可参考这篇文章:标准化和归一化,请勿混为一谈,透彻理解数据变换,里面有详细的归一化与标准化的区别与联系的讨论,以及使用决策,讲得很好。

中心化比较简单,就是将均值变为0(x′=x−mean(x)x′=x−mean(x)),对方差没要求。

2|3z-score

z-score即上述第三种的“标准化”,将每一个维度的特征都处理为符合标准正态分布N(0,1)N(0,1),核心公式为

μσ2x˜(i)=1N∑i=1Nx(i)=1N∑i=1N(x(i)−μ)2=x(i)−μσ(1)(2)(3)(1)μ=1N∑i=1Nx(i)(2)σ2=1N∑i=1N(x(i)−μ)2(3)x~(i)=x(i)−μσ

每一维特征都服从标准正态分布。经过处理后的数据符合均值为0,标准差为1的分布,如果原始的分布是正态分布,那么z-score标准化就将原始的正态分布转换为标准正态分布,机器学习中的很多问题都是基于正态分布的假设,这是更加常用的归一化方法。

以上都是线性变换,对输入向量XX按比例压缩再进行平移,操作之后原始有量纲的变量变成无量纲的变量。不过它们不会改变分布本身的形状,下面以一个指数分布为例:
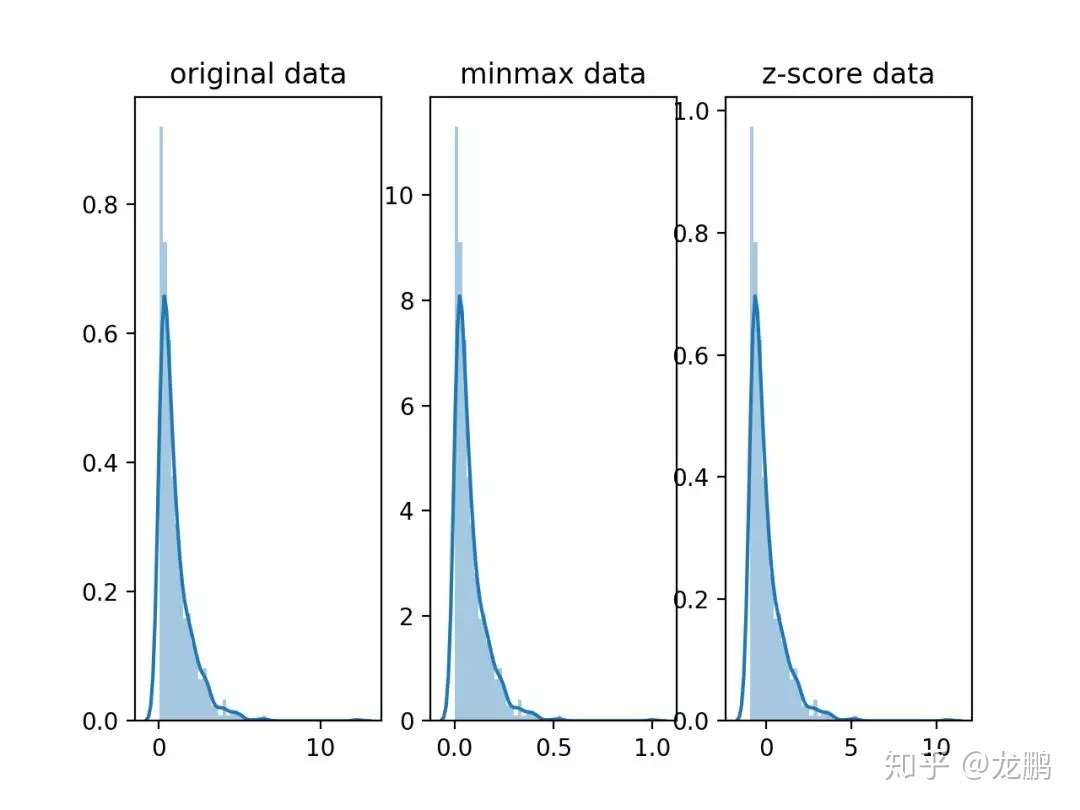
如果要改变分布本身的形状,下面也介绍两种。

2|4正态分布Box-Cox变换

Box-Cox变换可以将一个非正态分布转换为正态分布,使得分布具有对称性,变换公式如下:

Y(λ)={Yλ−1λ,λ≠0lnλ,λ=0Y(λ)={Yλ−1λ,λ≠0ln⁡λ,λ=0

在这里λλ是一个基于数据求取的待定变换参数,Box-Cox的效果如下:
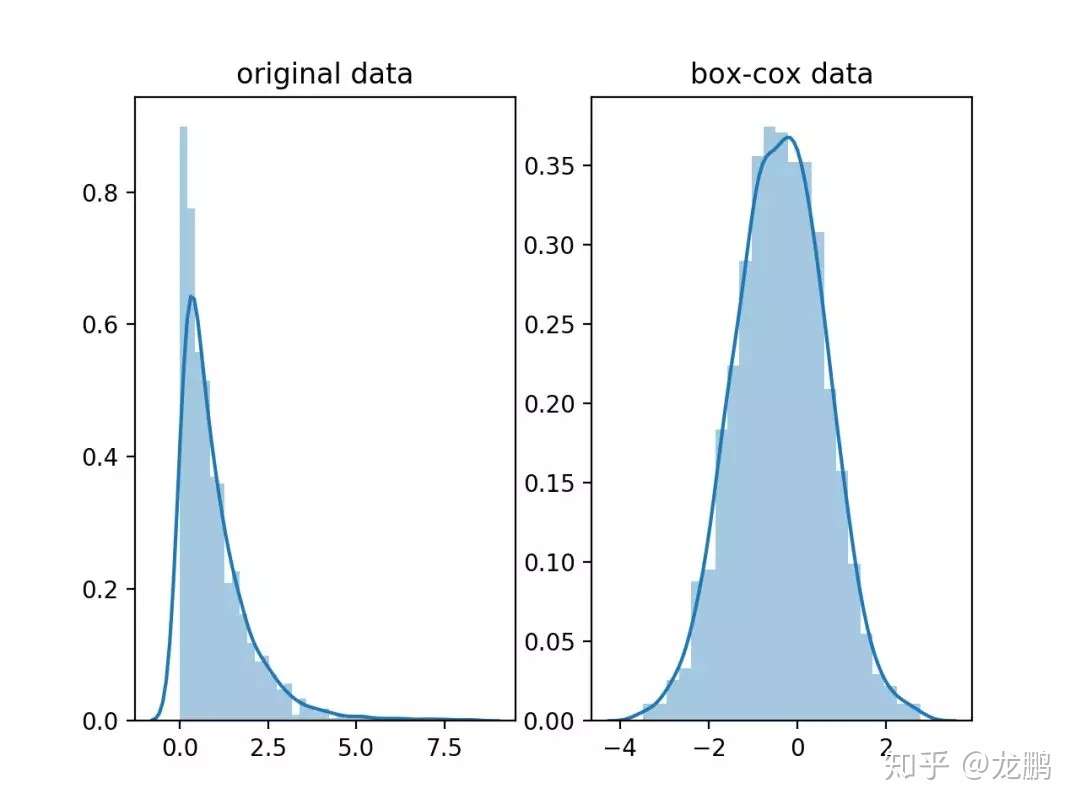
2|5直方图均衡化

直方图均衡也可以将某一个分布归一化到另一个分布,它通过图像的灰度值分布,即图像直方图来对图像进行对比度进调整,可以增强局部的对比度。

它的变换步骤如下:

(1)计算概率密度和累积概率密度。

(2)创建累积概率到灰度分布范围的单调线性映射T。

(3)根据T进行原始灰度值到新灰度值的映射。

直方图均衡化将任意的灰度范围映射到全局灰度范围之间,对于88位的图像就是(0,255)(0,255),它相对于直接线性拉伸,让分布更加均匀,对于增强相近灰度的对比度很有效,如下图。
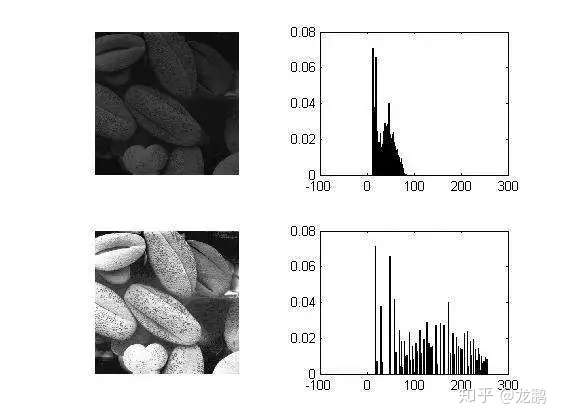
综上,归一化数据的目标,是为了让数据的分布变得更加符合期望,增强数据的表达能力。

在深度学习中,因为网络的层数非常多,如果数据分布在某一层开始有明显的偏移,随着网络的加深这一问题会加剧(这在BN的文章中被称之为internal covariate shift),进而导致模型优化的难度增加,甚至不能优化。所以,归一化就是要减缓这个问题。

2|6白化(Whitening)

白化是一种重要的数据预处理方式,用来降低输入数据特征之间的冗余性。输入数据经过白化处理后,特征之间相关性低,并且所有特征具有相同的方差。

白化具有两个目的:1. 使数据的不同维度去相关;2. 数据每个维度的方差为1。

假设训练数据是图像,由于图像中相邻像素之间具有很强的相关性,所以用于训练时输入是冗余的。白化的目的就是降低输入的冗余性。

PCA白化

PCA即主成分分析(Principal Component Analysis),其思想是将NN维特征映射到KK维上(通常K<NK<N),这KK维是全新的正交特征。这KK维特征称为主成分,是重新构造出来的KK维特征,而不是简单地从NN维特征中直接挑选出的KK维特征。

这里先简单讲一下PCA的主要操作:

(1)求出训练样本XX的协方差矩阵ΣΣ,公式如下(m个m个输入数据XX已经均值化过):

Σ=1m∑i=1m(x(i))(x(i))TΣ=1m∑i=1m(x(i))(x(i))T

(2)将ΣΣ进行SVD分解,取前KK大特征值对应的的特征向量作为列向量,组成特征向量矩阵UU;

(3)将XX投影到UU上即得ZZ:

z=UTx=[uT1xuT2x]z=UTx=[u1Txu2Tx]

如此,样本xx经过PCA后被映射成了zz。

那么,PCA白化的两个主要步骤:

1. 通过PCA将数据XX映射得到ZZ,可以看出ZZ中每一维都是相互独立的(去相关);

(如果K<NK<N,就是PCA降维,如果K=NK=N,则只是降低特征间得相关性。这里的KK是指PCA处理过后的特征数。)

2. 再除以ZZ中每一维对应的方差,使得每一维的方差均为1。

ZCA白化


XZCAwhite=UXPCAwhiteXZCAwhite=UXPCAwhite

只是在PCA白化的基础上做了一个旋转操作,使得白化之后的数据更加接近原始数据。

ZCA白化首先通过PCA去除了各个特征相关性(没降维,K=NK=N),然后使输入特征方差为1,此时得到PCA白化后的结果。之后再将数据旋转回去,得到ZCA白化结果。

3|0升级版的“预处理”——BN

对输入数据进行预处理,减均值->z-score->白化可以逐级提升随机初始化的权重对数据分割的有效性,还可以降低overfit的可能性。我们都知道,现在的神经网络的层数都是很深的,如果我们对每一层的数据都进行处理,训练时间和overfit程度是否可以降低呢?答案是可以,用Batch Normalization。

参考资料:

https://blog.youkuaiyun.com/hjimce/article/details/50866313

https://www.zhihu.com/question/20467170

https://blog.youkuaiyun.com/weixin_36604953/article/details/102652160

https://www.zhihu.com/question/38102762/answer/607815171

更多精彩内容请访问FlyAI-AI竞赛服务平台;为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台;每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

挑战者,都在FlyAI!!!

 

深度学习中数据预处理 深度学习中,数据预处理的核心目的不是“让数据更干净”,而是让原始数据与神经网络的数学假设、计算约束、优化动态三者之间达成可学习的对齐。它既服务于模型,也改造着数据。以下从目的、步骤、结果三个维度展开深度剖析。一、目的:对齐神经网络的三大需求1. 数值稳定性神经网络对输入的分布高度敏感。未处理的尺度差异、长尾分布或异常值会导致梯度爆炸/消失、权重矩阵病态(ill-conditioned),使训练无法收敛或陷入尖锐极小值。2. 容量适配。 阅读详情

相关推荐

深度学习常用数据操作总结——数据预处理

深度学习采用的数据全部以张量的形式存储在内存中,然而我们拿到手的原始数据却不是张量形式,因此需要首先对数据进行处理,将其转换为张量形式,可以采用Python中的Pandas包来完成。

希望变强的小菜鸟的博客 2994

扫盲记-第六篇--Normalization

深度学习模型中的Normalization 数据经过归一化和标准化后可以加快梯度下降的求解速度,这就是Batch Normalization等技术非常流行的原因,Batch Normalization使得可以使用更大的学习率更稳定地进行梯度传播,甚至增加网络的泛化能力。 1 什么是归一化/标准化 Normalization是一个统计学中的概念,可以称它归一化或者规范化,它并不是一...

weixin_30886233的博客 364

从SEG盐体数据到OpenFWI:手把手教你为DL-FWI准备和预处理地震数据集

本文详细介绍了从SEG盐体数据到OpenFWI的深度学习地震反演(DL-FWI)数据预处理全流程,包括SEG盐体数据的参数解析、OpenFWI的结构化处理、炮集数据的张量转换技术以及物理合规的数据增强策略。通过实战案例和代码示例,帮助研究人员高效准备地震数据集,提升DL-FWI模型的训练效果和泛化能力。

weixin_30542079的博客 434

数学建模——数据预处理

数据预处理的相关笔记,分为缺失值处理、异常值处理和数据变换三部分

zyf17887261915的博客 3906

手把手教你用CANopen SDO报文控制步进电机(附CIA402协议详解)

本文详细解析了如何通过CANopen SDO报文控制步进电机,深入讲解CIA402协议的核心架构、状态机模型及对象字典管理,并提供实战代码示例。从SDO报文构造到多轴同步控制,帮助开发者掌握工业级步进电机的精确控制技术,适用于自动化设备开发。

weixin_33737774的博客 486

告别130MB/s瓶颈!用Zynq+NVMe实现1.2GB/s高速存储的PL数据分流实战

本文详细介绍了如何通过Zynq+NVMe实现1.2GB/s高速存储的PL数据分流方案,突破传统Zynq架构130MB/s的瓶颈。文章分享了PL直连NVMe的硬件架构设计、软件栈优化及性能调优实战技巧,帮助开发者实现高速数据流的稳定存储。

weixin_42653691的博客 372

机器学习:如何解决模型数据预处理问题

机器学习 概述 什么是机器学习 机器学习是一门能够让编程计算机从数据中学习的计算机科学。 一个计算机程序在完成任务T之后,获得经验E,其表现效果为P,如果任务T的性能表现,也就是用以衡量的P,随着E增加而增加,那么这样计算机程序就被称为机器学习系统。 自我完善,自我增进,自我适应。 为什么需要机器学习 自动化的升级和维护 解决那些算法过于复杂甚至跟本就没有已知算法的问题 在机器学习的过程中协助人类获得对事物的洞见 机器学习的问题 建模问题 所谓机器学习,在形式上可这样理解:在数据对象中通过统计或推理的

大大枫free 2045

CATIA二次开发CAA:(一)开发环境搭建

CATIA+CAA+RADE+VS2012

ysm1987的博客 1万+

数学建模 数据预处理

想写写关于数据预处理的方法 写下来不养忘了

UESTC Like 1万+

Python自动化测试全套教程-第一天(python、pycharm开发环境的安装与配置(图文超级详细);附安装包)

本文介绍了Python开发环境的完整安装配置流程。主要内容包括:1) Python解释器的下载安装与版本检测方法;2) PyCharm IDE的下载安装步骤,包括专业版和社区版的选择;3) PyCharm的基础配置和项目创建方法;4) 开发环境的基本构造说明。文章提供了两种获取安装包的方式(官网下载和文章附件),并详细说明了解释器卸载、安装过程中的注意事项,以及如何验证环境配置成功。特别强调了PyCharm安装时的路径选择和虚拟环境的创建方法,为Python初学者提供了完整的开发环境搭建指南。

kiwi_king的博客 2035

Zemax实战:20×超高清变焦镜头设计全流程解析(从架构到制造)

本文详细解析了使用Zemax软件设计一款20倍变焦比、恒定F2.8光圈8K超高清镜头的全流程。从应对恒定光圈、宽光谱与8K解析力三大挑战的初始架构规划,到构建多重组态模型、分七阶段进行像差优化与公差分析,最终跨越制造鸿沟,为广播级影视与高精度工业检测应用提供了实战指南。

sun99的博客 552

深度学习——数据预处理篇

深度学习——数据预处理篇 文章目录深度学习——数据预处理篇**一、前言****二、常用的数据预处理方法**零均值化(中心化)数据归一化(normalization)主成分分析(PCA、Principal Component Analysis)白化(whitening)**三、注意事项****四、References** 一、前言 深度学习和机器学习一个重要的区别就是在于数据量的大小。就目前的大量实...

Jmuyjl 1万+

量子-经典混合架构与动态QUBO建模

量子-经典混合架构与动态QUBO建模的结合,是当前量子计算与经典计算融合领域的前沿方向。通过将量子计算的并行性与经典计算的灵活性结合,该技术为解决复杂动态优化问题(如实时调度、金融投资组合优化、电力系统控制等)提供了全新的方法论。:将发电机组调度分解为QUBO(启停决策)与非QUBO(功率分配)子问题,通过3块ADMM协调;c_i(t) $随外部环境(如电力需求、市场价格)动态调整。量子-经典混合架构与动态QUBO建模的结合,标志着优化计算从。:每分钟根据市场波动调整QUBO的收益率-风险系数;

百态·数智思维 | 聚焦大数据、量化与未来AI 1334

深度学习——数据预处理

数据预处理是为了改善数据挖掘分析工作,减少时间,降低成本和提高质量。很有必要,就像做菜不洗菜,这样的人做出来的菜质量也不会好在哪里,没人愿意吃。

EWQOR的博客 2368

YOLO11涨点优化:loss优化 | 一种新的基于Wasserstein距离的小目标检测评估方法,助力小目标涨点

提出了一种新的基于Wasserstein距离的小目标检测评估方法,通过它们对应的高斯分布计算它们之间的相似性

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 1018

CloudCompare&PCL 体元累加法(树冠体积计算)

文章目录

dayuhaitang1的博客 1553

深度学习数据预处理

在深度学习中,数据预处理(preprocessing)的体现在以下几个方面:1、数据质量: 原始数据通常包含错误、缺失值、异常值和噪声。预处理能够检测和处理这些问题,确保数据的质量,从而避免模型因低质量数据而产生错误的学习。2、特征缩放和归一化: 深度学习模型对输入数据的尺度敏感,不同尺度的特征可能导致模型收敛困难。通过特征缩放和归一化,可以将特征值调整到相近的范围,帮助模型更快地收敛并提高泛化能力。

替这位空想家惊讶 2393

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

深度学习-----数据预处理

通过最近一段深度学习的学习与实现,发现数据预处理在深度学习中是非常重要的。 数据归一化 数据预处理中,标准的第一步是数据归一化。虽然这里有一系列可行的方法,但是这一步通常是根据数据的具体情况而明确选择的。特征归一化常用的方法包含如下几种: 简单缩放逐样本均值消减(也称为移除直流分量)特征标准化(使数据集中所有特征都具有零均值和单位方差) Eg:在处理

dcxhun3的博客 4万+

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

深度学习中的不同类型的数据预处理方法

1.背景介绍 1. 背景介绍 深度学习是一种人工智能技术,它旨在模拟人类大脑的学习和推理能力。深度学习通常需要大量的数据进行训练,以便于模型能够学习到有用的特征和模式。然而,这些数据通常是不完美的,可能包含噪声、缺失值、不均衡分布等问题。因此,数据预处理是深度学习中的一个重要环节,它可以帮助提高模型的性能和准确性。 在深度学习中,数据预处理可以分为多种类型,例如:标准化、归一化、数据增强、缺...

AI天才研究院 1729

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

比较全的深度学习数据预处理方法

这里写自定义目录标题当前被广泛用的预处理方法1、中心化/零均值化程序代码2、标准化/归一化程序代码(1)标准化与归一化的联系和差异联系差异(2)为什么要归一化/标准化①某些模型求解需要②③无量纲化④ 避免数值问题(3)什么时候用归一化?什么时候用标准化?3、PCA和白化程序代码 当前被广泛用的预处理方法 1、中心化/零均值化 零均值化就是将每一维原始数据减去每一维数据的平均值,将结果代替原始数据 ​在深度学习中,一般我们会把喂给网络模型的训练图片进行预处理,使用最多的方法就是零均值化(zero-me

ajkdghfa的博客 4920

【深度学习】数据预处理

为了能用深度学习来解决现实世界的问题,我们经常从预处理原始数据开始,而不是从那些准备好的张量格式数据开始。在Python中常用的数据分析工具中,我们通常使用pandas软件包。像庞大的Python生态系统中的许多其他扩展包一样,pandas可以与张量兼容。本节我们将简要介绍使用pandas预处理原始数据,并将原始数据转换为张量格式的步骤。后续将介绍更多的数据预处理技术。

Sakura_ding的博客 978

【机器学习&深度学习】数据预处理

数据预处理的目的是什么? 把原始数据 → 变成模型可训练格式:张量形式,标准大小,归一化,增强(如翻转/旋转)。

qq_62223405的博客 1504

深度学习基础3数据预处理

数据预处理 通常使用pandas软件包。pandas`可以与张量兼容。 读取数据集 创建一个人工数据集,并存储在CSV(逗号分隔值)文件) ../data/house_tiny.csv中。 以其他格式存储的数据也可以通过类似的方式进行处理。 下面我们将数据集按行写入CSV文件中。 import os os.makedirs(os.path.join('..', 'data'), exist_ok=True) data_file = os.path.join('..', 'data', 'house_tin

FLR的博客 1698

【halcon深度学习之那些封装好的库函数】preprocess_dl_dataset

是一个用于预处理深度学习数据集的程序。: 要进行预处理的 DLDataset 字典。: 存储数据的路径。默认值是 ‘dl_dataset’。: 包含预处理参数的字典。: 具有通用参数的字典。默认值为空字典。: 写入的 DLDataset 字典的文件路径。该程序根据包含在字典中的参数对字典DLDataset中的样本进行预处理。预处理的结果包括修改后的DLDataset字典以及每个样本的预处理后字典DLSample。这些字典将被写入到指定的中,同时该目录的名称和路径将被返回到字符串中。此程序接受字典。

songhuangong123的博客 1764
上一篇: LSRA: 轻量级Transformer,注意力长短搭配
下一篇: 深度学习之激活函数
iFlyAI
博客等级 码龄9年 238粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
