LSRA: 轻量级Transformer,注意力长短搭配

Lite Transformer with Long-Short range attention Lite Transformer with Long-Short range attention 2020年 arxiv文章 Abstract Transformer在自然语言处理(例如机器翻译、问答)中变得无所不在;然而,它需要大量的计算来实现高性能,这使得它不适合受到硬件资源和电池严格限制的移动应用。本文提出了一种高效的移动NLP体系结构——Lite Transformer,以方便在边缘设备上部署移动NLP应用。关键的原语是长短距离注意 (LSRA),其中一组头部专用于局部上下文建模(通过卷积), 阅读详情

摘要: Transformer虽然效果好,但是却对资源要求比较高,很难在端设备上运行。在传统的Transformer中,每个block中都有Multi-head Attention和全连接层,其中,随着序列长度N的增大,全连接层的计算量是线性增长,而attent ...

人工智能学习离不开实践的验证,推荐大家可以多在FlyAI-AI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

最近要开始使用Transformer去做一些事情了,特地把与此相关的知识点记录下来,构建相关的、完整的知识结构体系。


Overall

Transformer虽然效果好,但是却对资源要求比较高,很难在端设备上运行。参考文献[1]提出了一种长短attention结合(Long-Short Range Attention, LSRA)的方式,有效的将一些计算节省掉,加速了模型的运行,使得模型可以在端设备上快速运行。


Transformer的计算瓶颈

在传统的Transformer中,每个block中都有Multi-head Attention和全连接层,其中,随着序列长度N的增大,全连接层的计算量是线性增长,而attention的计算量则是平方增长(如果不使用之前提的Performer类似算法的话)。类比的,卷积操作也和序列长度是线性关系。


所以,当序列长度比较长的时候,attention占绝大多数的计算量。所以之前的方法是将通道数变少,然后做注意力计算,然后再放大。如下图的最上一部分所表示的那样。
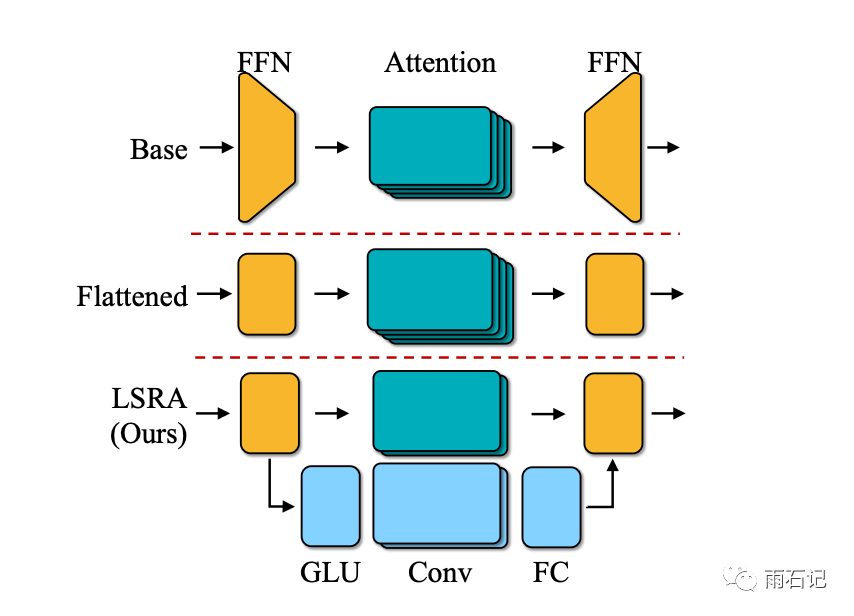
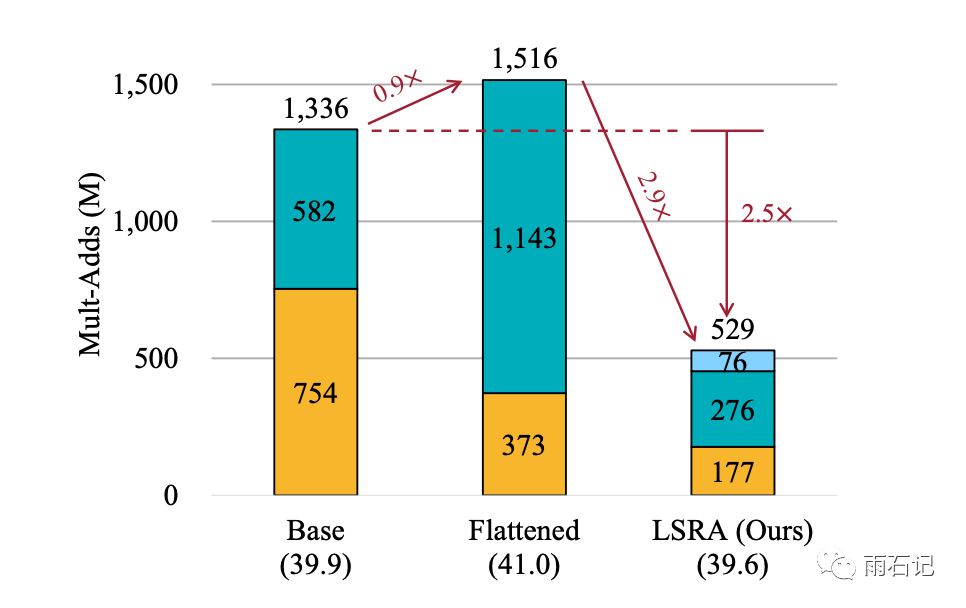
如果维度是d,序列长度是N,那么注意力层的计算量(Multi-Add)是O(4Nd2+N2d),而FFN的计算量(Multi-Add)是O(2x4Nd2)。


而对于翻译任务来说,一般长度在20-30左右,比d要小很多,此时理论上来说FFN占用的计算量比较多,而不是attention。如下图所示,柱状图和上面的三个算法一一对应,对于Base算法,做了通道先减后增之后,FFN占的计算量占了大部分,attention计算反而是少数。但FFN这块并不能捕捉上下文信息,更多的是非线性变化。所以,设计了第二种方法,即,把attention计算的通道数的先减后增去掉,得到的计算量中Attention就占了大多数了。
长短搭配

在翻译任务中,如果使用传统的Transformer的话,会发现attention权重的分布如下,下图中颜色越深,权重越大。
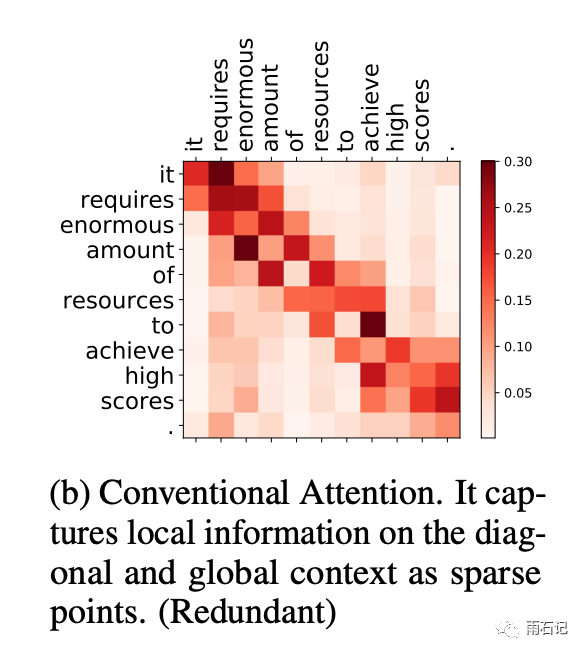
从上图的权重分布中,我们可以看到,attention的很大一部分都是在做局部的attention,每个词主要是需要attend到周边的两个词语,其他长依赖比较少。


这就激发了一种想法,那就是把主要的局部attention剥离出来,由卷积完成,Multi-head attention则主要负责长依赖。如下图:
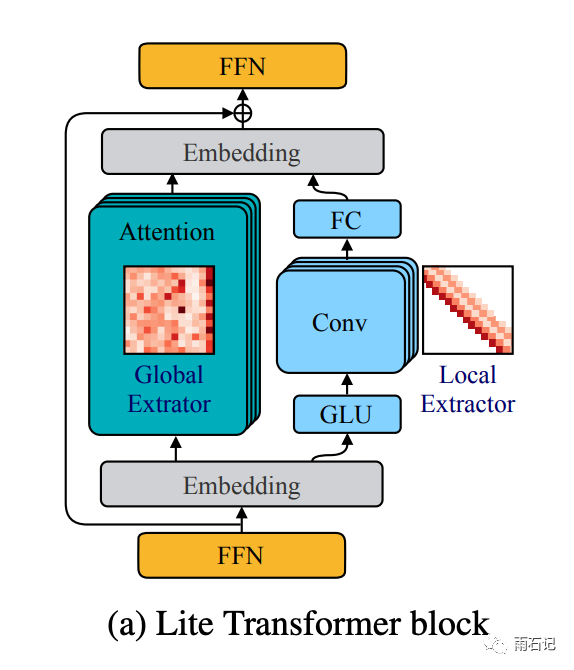
做了这个改进之后,有两点好处:

卷积比attention要快,计算量提升2.5倍。

多头注意力专注于长依赖,得到的注意力更加均匀。如下图:
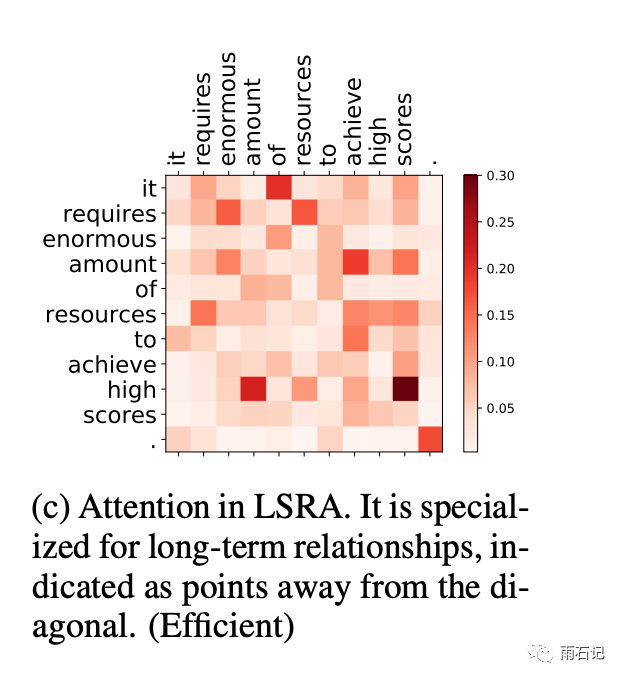
注意,这里使用的卷积并不是普通的卷积,而是depth-wise的卷积加上线性层。具体我们会在后面的文章里讲,这里先挖个坑。


实验

在翻译任务上的结果:
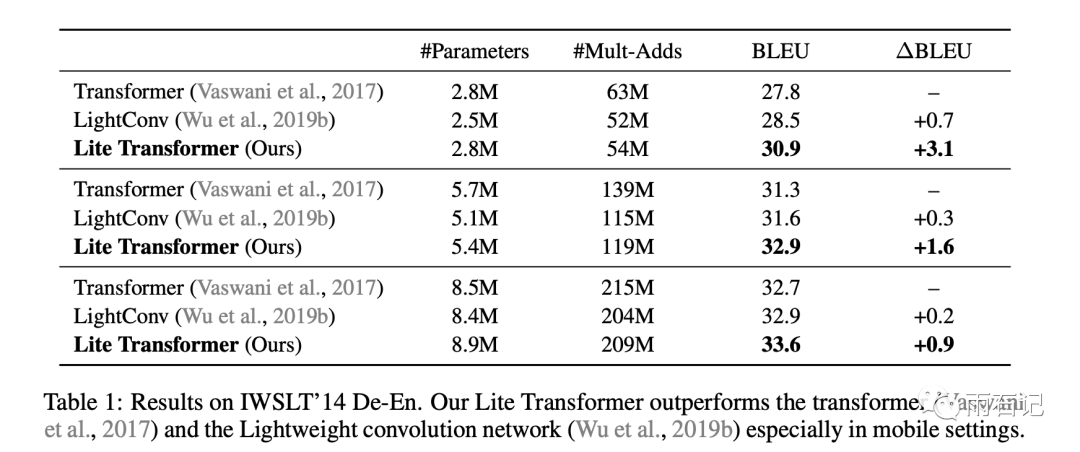
和Evolved Transformer相比:

进一步压缩:
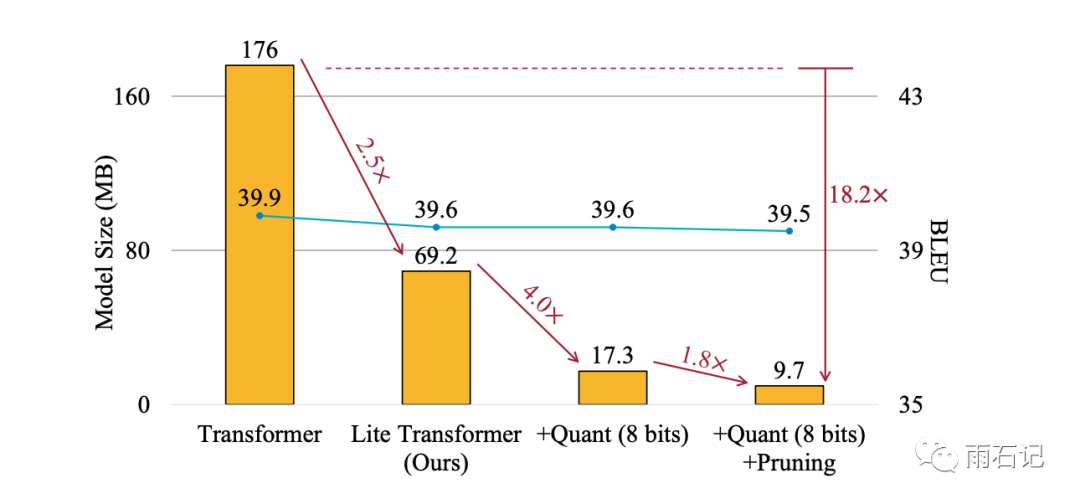
总结

论文的idea比较直观,主要是长依赖和短依赖的剥离,并引入卷积来捕捉短依赖,总体思想和Transformer之自适应宽度注意力有点类似。这篇文章中发现低层次上的注意力都比较短,层次越高,注意力的所关注的依赖越长。

所以感觉这里可以更进一步,在低层次上甚至可以不用Multi-Head Attention?


参考文献

[1]. Wu, Z., Liu, Z., Lin, J., Lin, Y., & Han, S. (2020). Lite transformer with long-short range attention. arXiv preprint arXiv:2004.11886.


更多精彩内容请访问FlyAI-AI竞赛服务平台;为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台;每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。

挑战者,都在FlyAI!!!



DeLighT:深度和轻量化的Transformer 本文提出了一个更深更轻量的Transformer-DeLighT,DeLighT更有效地在每个TransformerBlock中分配参数(1)使用DeLighT转换进行深度和轻量级的转换;(2)使用Block-wiseScaling进行跨Block,允许在输入附近有较浅和较窄的DeLighTBlock,以及在输出附近有较宽和较深的DeLighTBlock。总的来说,DeLighT网络的深度是标准Transformer的2.5到4倍,但参数和操作更少。... 阅读详情

相关推荐

【即插即用模块】Transformer篇 | CVPR 2024 | 倒反天罡!轻量级单头自注意力SHSA,比多头还准?

SHSA模块是一种高效的轻量级视觉Transformer设计,通过单头自注意力机制降低计算冗余。该模块将输入特征分为注意力分支和身份分支,仅对部分通道(pdim)计算单头注意力,结合1×1卷积生成QKV,显著减少计算量。实验表明,当部分通道比例为4.67时,SHSA能更好平衡速度与精度,在轻量级视觉任务中表现优异。其核心优势在于:1)单头注意力减少多头冗余;2)部分通道计算降低复杂度;3)卷积与归一化结合稳定训练。代码实现采用分组卷积和特征拼接,支持即插即用替换传统自注意力模块。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 681

轻量级模型解读——轻量transformer系列

轻量级transformer系列模型解读

lishanlu136的博客 6413

量子阱技术解析:从基础原理到前沿应用

本文深入解析量子阱技术,从微观“能量游泳池”的基础原理出发,阐释了其通过限制电子实现能级量子化,从而精确调控发光波长的核心机制。文章详细探讨了量子阱在半导体激光器和LED中的革命性应用,如实现低阈值电流与高亮度显示,并展望了其在能带工程及量子级联激光器等前沿领域的发展与挑战。

weixin_29267307的博客 282

轻量ViT王者 | EfficientFormerV2:全新轻量级视觉Transformer

点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取点击进入→自动驾驶之心【模型部署】技术交流群后台回复【模型部署工程】获取基于TensorRT的分类、检测任务的部署源码!摘要随着视觉Transformers(ViTs)在计算机视觉任务中的成功,最近的技术试图优化ViT的性能和复杂性,以实现在移动设备上的高效部署。研究人员提出了多种方法来加速注意力机制,改进低效设计,或结合mobil...

CV_Autobot的博客 4491

诠视MR眼镜Unity开发设置_Unity2020.3.38

请按照如下设置Android SDK 和 Gradle。打包前先将Unity切换到Android模式。Preferences 设置。

m0_71932574的博客 603

【11】科曼医疗——科曼医疗 嵌入式--面试,校招,面试问答记录

科曼医疗嵌入式校招面试记录:3位面试官分别考察应用层技术、底层技术和HR面。技术问题涵盖C++特性(多态、虚函数、指针与引用区别)、内存管理(malloc与new对比)、嵌入式基础(51最小系统、IIC/SPI协议)及项目经验(智能黑板擦专利项目)。同时考察了Linux使用经验、STM32开发及嵌入式操作系统认知。最后环节应聘者询问了开发环境及面试流程。面试内容全面覆盖嵌入式开发核心知识点。

程序员,他们想的是什么?他们想的永远都是技术,他们崇尚的也永远都是技术。 1251

Lite Transformer:如何在保持性能的同时将模型压缩18倍

你是否曾为Transformer模型的计算成本和内存占用而烦恼?传统的Transformer模型虽然性能强大,但动辄数亿参数、几十GB的内存需求,让它在资源受限的设备上几乎无法使用。MIT-HAN-Lab推出的Lite Transformer项目,正是为了解决这个痛点而生。 这个项目不是简单地缩小模型,而是通过创新的长短期注意力机制(LSRA),在保持甚至提升性能的同时,将模型大小压缩了惊人的1

gitblog_00052的博客 361

ThingsBoard教程(七):模拟设备遥测

前言 各位读者好,截止目前,ThingsBoard系列文章已经做了六篇,分别是 ThingsBoard教程(一):ThingBoard介绍及安装 ThingsBoard教程(二):租户,租户配置,部件组模块的使用 ThingsBoard教程(三):系统设置模块的使用 ThingsBoard教程(四):规则链简介与操作 ThingsBoard教程(五):客户,资产管理 ThingsBoard教程(六):设备管理 上一篇我们讲解了如何使用设备管理来对设备进行增删改查,和设备配置的一些基本概念,本篇文章就带大

知无涯 4581

ICLR 2020趋势分析:NLP中更好&更快的Transformer

文章目录自注意力变体Long-Short Range Attention使用子树掩码的树结构的注意力哈希注意力多跳注意力训练目标识别替换任务词和句子结构任务类型限制的实体替换嵌入位置感知的复杂词向量层次嵌入分解的嵌入参数模型结构压缩记忆可逆层交叉层参数共享自适应深度预测总结 转载来源:https://mp.weixin.qq.com/s/hbx4DryEaaB0TlJPH7uyyA 导读:介绍了ICLR2020中对Transformer的改进,从自注意力变体,训练目标,模型结构这三个方面对Transfor

郝伟老师的博客——大数据、并行计算与人工智能时代 824

Vue3 - 实现用户上传本地视频文件到服务器+上传进度条+暂停续传+中断取消上传等,视频上传后可在线播放预览已上传的视频,视频文件上传视频回显示例代码(支持Element、Antd等upload组件

实现视频上传和视频预览,vue3实现视频上传功能,上传视频回显,视频流上传播放功能,vue与axios上传视频并显示上传进度,upload组件实现视频文件上传视频回显,upload组件实现视频上传及进度条展示,视频上传及实时进度条显示,视频上传过程中如何中断上传,VUE3+element 上传视频,大文件分片上传+断点续传,axios大文件切片上传,Vue3上传视频后如何播放预览,上传本地视频到后端服务器及在线预览播放视频+移除视频+进度条上传,将已选视频上传服务端并可预览视频,详细实现选择视频并上传到服务

🏆 前端领域优质创作者 3114

OpenStack [ compute_id ] 设计上的小缺陷

而 nova 代码中硬编码(或默认配置)将 compute_id 放在 site-packages 目录,属于 设计上的小缺陷—— 把 “库安装目录” 和 “运行时数据目录” 混在一起了,才导致需要临时调整这个目录的权限。# 配置项说明:node_identity_file 是 nova 用于指定节点标识文件路径的官方配置项,优先级高于代码中的默认路径。自定义 compute_id 路径,指向 /var/lib/nova/ 目录下的 compute_id 文件;

求知若渴,虚心若愚。 491

transformer论文解读_Lite Transformer论文解读

Transformer现在不只在NLP领域流行了,图像还有语音都有相应的尝试了。但是Transformer的计算量太大了,这篇MIT发表在ICLR上的论文像我们展示了一个压缩的足够小的Transformer,从而可以部署在移动终端上面。论文地址:https://arxiv.org/pdf/2004.11886.pdf​arxiv.org一、概述Transformer虽然效果卓越但是模型的大小以及计...

weixin_39887748的博客 624

QT5.12.1报错:1. clang++:error: :fatal error andriod Input/output error

QT5.12.1报错:1. clang++:error: :fatal error andriod Input/output error 解决方式: 1.qt程序不要放在共享目录下编译,直接拷贝到ubuntu系统中编译 2.修改/home/xt/Qt5.12.1/5.12.1/android_armv7/mkspecs/android-clang中 #QMAKE_LINK = QMAKECXXQMAKE_CXX QMAKEC​XXQMAKE_CFLAGS -Wl,–exclude-libs,libgc

xt18971492243的博客 737

轻量级Visual Transformer模型——LeViT(ICCV2021)

LeViT是FAIR团队发表在ICCV2021上的成果,是轻量级ViT模型中的标杆,文章对ViT中多个部件进行的改进,如加速策略等,对很多工程化铺设ViT系列模型都是很有借鉴意义的。 按说,近期出现的优质模型非常多,各种冲击SOTA的,详情可戳我整理的小综述《盘点2021-2022年出现的CV神经网络模型》。但我为何会单独对LeViT拿出来进行详细剖析呢?原因很简单:LeViT非常工程实用,是一款足够优秀的轻量级视觉transformer模型。市面上很多轻量级模型都进入了一个误区:大家都在比拼FLOPs数和

木盏 1万+

【系统架构设计师】模拟预测试卷十 - 案例分析(完整结构)

本文为系统架构设计师考试模拟试题及参考答案,包含五个专题:质量属性(必答)、信息系统架构设计、嵌入式系统架构设计、云原生架构设计、面向服务架构设计(SOA)。试题一聚焦非功能需求与质量属性映射,如性能、可修改性、一致性等;其余选答题分别涉及分层架构设计(如嵌入式实时控制)、云原生会话管理、服务化治理(如契约设计、熔断策略)等核心架构场景,涵盖战术应用、权衡分析及解决方案设计。参考答案提供关键要点,例如离线借还的冲突解决、服务编排与共享服务的区分、嵌入式硬实时保护的必要性等,适用于备考实战演练。

数据知道的博客 251

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

优化与改进之轻量级Transformer - Transformer教程

本文深入探讨了Transformer模型的优化与改进方法,包括低秩近似、稀疏注意力机制、分层注意力机制、动态注意力机制、混合精度训练、模型蒸馏、剪枝技术、混合模型、知识迁移和硬件加速等。这些方法不仅显著降低了计算复杂度和资源需求,还提升了模型的效率和性能,推动Transformer模型在更多实际应用场景中的广泛应用。

shandianfk_com的博客 1141

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

【计算机视觉 | Transformer】魔改Transformer!9种提速又提效的模型优化方案分享!

【计算机视觉 | Transformer】魔改Transformer!9种提速又提效的模型优化方案分享!

wzk4869的博客 5559

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

探索轻量级Transformer:MIT-HAN-Lab的lite-transformer

在深度学习领域,Transformer模型因其出色的性能而在NLP(自然语言处理)中占据了主导地位。然而,其庞大的计算需求往往限制了其在资源有限的环境中的应用。为了解决这一问题,,这是一个专注于构建高效、轻量级的Transformer模型的库。 ## 项目简介 `lite-transformer`的目标是提供一个可以在手机、物联网设备等边缘计算环境中运行的高质量NLP模型。这个项目采用了多种优

gitblog_00090的博客 1100

Transformer——Q116 验证轻量级Transformer(Lite Transformer)的参数量-准确率权衡

轻量级 Transformer 通过架构简化、参数共享和低秩近似等技术,在参数量与准确率之间找到了一条可行的平衡路径。在实际应用中,从移动端智能客服到多语言翻译,Lite Transformer 凭借其高效性和可部署性,为资源受限场景提供了优质解决方案。虽然它在复杂任务中仍难以媲美大型模型,但随着优化策略的不断创新(如动态架构、知识蒸馏),未来的轻量级 Transformer 有望在保持轻量化优势的同时,进一步缩小与大型模型的性能差距,真正实现 “小身材、大能量”,成为人工智能普惠化的重要推动者。

墨顿随笔 1098

探索Transformer-Simple:一款轻量级的自然语言处理工具

探索Transformer-Simple:一款轻量级的自然语言处理工具 在现代深度学习领域,Transformer模型因其高效的并行计算能力和强大的序列建模能力而备受推崇。 是一个开源项目,由Hinesboy开发,它为开发者提供了一个简洁、易于理解和实现的Transformer框架,旨在帮助初学者和专业人士快速上手Transformer模型。 项目简介 Transformer-Simple是一个基...

gitblog_00096的博客 444

TIP2023| nnFormer:利用交织3D卷积和Transformer进行医学分割的新方案

Transformer作为自然语言处理的首选模型,在医学影像界引起了很少的关注。考虑到利用长期依赖关系的能力,Transformer有望帮助非典型卷积神经网络克服其空间归纳偏差的固有缺点。nnFormer不仅利用**交织卷积和自注意**操作的结合,还引入了局部和全局基于体积的自注意机制来学习体积表示。此外,nnFormer提出在U-Net类架构中**使用跳跃注意**来代替传统的跳跃连接中的连接/求和操作

qq_45807235的博客 6575

【对称CNN:递归Transformer:SR:轻量级】

仅供自己参考

weixin_43690932的博客 1290

ICML 2023 | 轻量级视觉Transformer (ViT) 的预训练实践手册

本文介绍一下最近被 ICML 2023 接收的文章:A Closer Look at Self-Supervised Lightweight Vision Transformers.论文标题:A Closer Look at Self-Supervised Lightweight Vision Transformers论文链接:https://arxiv.org/abs/2205.14443代码链...

Paper weekly 1253

轻量级Transformer在语义分割中的大显身手:SSformer

本文提出了SSformer,这是一种轻量级的Transformer模型,用于语义分割。本文引入了一个简单的MLP解码器,它带来了很少的复杂性和参数增加。SSformer利用了Swin Transformer的分层多尺度架构,可以从预训练的Swin Transformer中进行微调。实验结果证明了其具有竞争力的性能和低时间复杂度的特点。本文相信其先进的特性可以使语义分割框架更容易应用于低计算能力的计算机和嵌入式设备。本文的源代码和模型在GitHub上公开可用。

m0_64752471的博客 2202
上一篇: 目标检测——yolov4损失函数
下一篇: 深度学习之数据预处理
iFlyAI
博客等级 码龄9年 238粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
