


该章节介绍VITGAN对抗生成网络中,Generator生成器 部分的代码实现。
目录(文章发布后会补上链接):
- 网络结构简介
- Mapping NetWork 实现
- PositionalEmbedding 实现
- MLP 实现
- MSA多头注意力 实现
- SLN自调制 实现
- CoordinatesPositionalEmbedding 实现
- ModulatedLinear 实现
- Siren 实现
- Generator生成器 实现
- PatchEmbedding 实现
- ISN 实现
- Discriminator鉴别器 实现
- VITGAN 实现
Generator生成器 简介

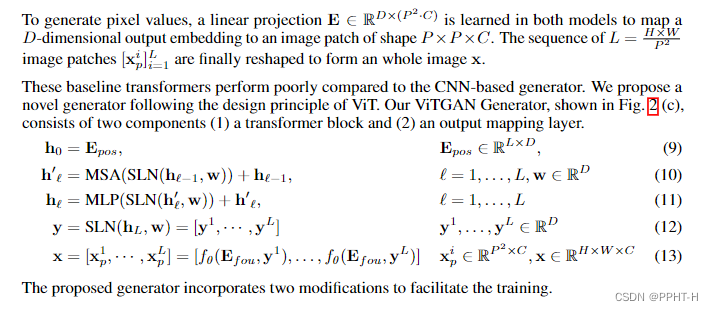
上图是整个完整的 Generator生成器结构,由前面几章的模块组合而成。
代码实现
GeneratorEncoder代码实现
import tensorflow as tf

import sys

sys.path.append('')

from models.msa import MSA
from models.mlp import MLP
from models.sln import SLN


class GeneratorEncoderLayer(tf.keras.layers.Layer):
    def __init__(self, d_model, num_heads, dropout=0.0):
        super().__init__()
        self.d_model = d_model
        self.num_heads = num_heads
        self.sln1 = SLN(d_model)
        self.msa1 = MSA(d_model, num_heads, discriminator=False)
        self.sln2 = SLN(d_model)
        self.mlp1 = MLP(d_model, discriminator=False, dropout=dropout)

    def call(self, x, w, training):
        h = x
        x = self.sln1(h=x, w=w, training=training)
        x = self.msa1(v=x, k=x, q=x, mask=None)
        x = x + h
        h = x
        x = self.sln2(h=x, w=w, training=training)
        x = self.mlp1(x)
        x = x + h
        return x

class GeneratorEncoder(tf.keras.layers.Layer):
    def __init__(self, d_model, num_heads, num_layers, dropout=0.0):
        super().__init__()
        self.d_model = d_model
        self.num_heads = num_heads
        self.num_layers = num_layers
        self.encoder_layers = [GeneratorEncoderLayer(d_model, num_heads, dropout=dropout) for i in range(num_layers)]

    def call(self, x, w, training):
        for encoder_layer in self.encoder_layers:
            x = encoder_layer(x=x, w=w, training=training)
        return x

if __name__ == "__main__":
    # layer = EncoderLayer(256, 8)
    layer = GeneratorEncoder(256, 8, 4)
    x = tf.random.uniform([2,5,256], dtype=tf.float32)
    w = tf.random.uniform([2,5,256], dtype=tf.float32)
    o1 = layer(x, w, training=True)
    tf.print('o1:', tf.shape(o1))
Generator代码实现,不含博里叶位置编码
import tensorflow as tf
import sys

sys.path.append('')

from models.mapping_network import MappingNetwork
from models.generator_transformer_encoder import GeneratorEncoder
from models.coordinates_positional_embedding import CoordinatesPositionalEmbedding
from models.siren_test import Siren
from models.sln import SLN
from models.positional_embedding import PositionalEmbedding
from models.modulated_linear import ModulatedLinear
from models.mlp import MLP


class Generator(tf.keras.layers.Layer):
    """
    生成器
    """

    def __init__(
        self,
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768,
        dropout=0.0,
    ):
        super().__init__()
        self.image_size = image_size
        self.patch_size = patch_size
        self.num_channels = num_channels
        self.d_model = d_model
        self.dropout = dropout
        self.grid_size = image_size // patch_size
        self.num_patches = self.grid_size ** 2

        self.mapping_network = MappingNetwork(
            self.d_model,
            num_layers=8
        )

        # 输入位置编码
        self.patch_positional_embedding = PositionalEmbedding(
            sequence_length=self.num_patches,
            emb_dim=self.d_model,
        )

        self.generator_transformer_encoder = GeneratorEncoder(
            d_model,
            num_heads=8,
            num_layers=4,
            dropout=dropout,
        )
        self.sln1 = SLN(d_model)

        self.siren = Siren(
            hidden_dim=d_model,
            hidden_layers=2,
            out_dim=d_model,
            first_omega_0=30,
            hidden_omega_0=30,
            demodulation=True,
            outermost_linear=False
        )

    def call(self, x, training):
        batch_size = tf.shape(x)[0]
        w = self.mapping_network(x, training=training)
        # 输入位置编码
        x_pos = self.patch_positional_embedding()
        x = self.generator_transformer_encoder(x=x_pos, w=w, training=training)
        x = self.sln1(x, w, training=training)
        x = self.siren(x) # (B, L, E=P*P*C)
        x = tf.reshape(x, [batch_size, self.grid_size, self.grid_size, self.patch_size, self.patch_size, self.num_channels])
        x = tf.transpose(x, perm=[0,1,3,2,4,5])
        x = tf.reshape(x, [batch_size, self.image_size, self.image_size, self.num_channels])
        return x


if __name__ == "__main__":
    layer = Generator(
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768
    )
    x = tf.random.uniform([2,1,768], dtype=tf.float32)
    o1 = layer(x, training=True)
    tf.print('o1:', tf.shape(o1))
    o1 = layer(x, training=False)
    tf.print('o1:', tf.shape(o1))
Generator代码实现,包含博里叶位置编码。论文没描述该结构细节,这是一种猜测,试过无效,可能有误。
import tensorflow as tf
import sys

sys.path.append('')

from models.mapping_network import MappingNetwork
from models.generator_transformer_encoder import GeneratorEncoder
from models.coordinates_positional_embedding import CoordinatesPositionalEmbedding
from models.siren import Siren
from models.sln import SLN
from models.positional_embedding import PositionalEmbedding
from models.modulated_linear import ModulatedLinear
from models.mlp import MLP


class Generator(tf.keras.layers.Layer):
    """
    生成器
    """

    def __init__(
        self,
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768,
        dropout=0.0,
    ):
        super().__init__()
        self.image_size = image_size
        self.patch_size = patch_size
        self.num_channels = num_channels
        self.d_model = d_model
        self.dropout = dropout
        self.grid_size = image_size // patch_size
        self.num_patches = self.grid_size ** 2

        self.mapping_network = MappingNetwork(
            self.d_model,
            num_layers=8
        )

        # 输入位置编码
        self.patch_positional_embedding = PositionalEmbedding(
            sequence_length=self.num_patches,
            emb_dim=self.d_model,
        )

        self.generator_transformer_encoder = GeneratorEncoder(
            d_model,
            num_heads=8,
            num_layers=4,
            dropout=dropout,
        )
        self.sln1 = SLN(d_model)
        # 博里叶位置编码
        self.coordinates_positional_embedding = CoordinatesPositionalEmbedding(
            patch_size=patch_size,
            emb_dim=d_model,
            )

        self.siren = Siren(
            hidden_dim=d_model,
            hidden_layers=2,
            out_dim=num_channels,
            first_omega_0=30,
            hidden_omega_0=30,
            demodulation=True,
            outermost_linear=False
        )

        self.modulated_linear = ModulatedLinear(
            hidden_dim=d_model,
            output_dim=d_model,
            demodulation=True,
            use_bias=False,
            kernel_initializer=tf.initializers.GlorotNormal(),
        )

    def call(self, x, training):
        batch_size = tf.shape(x)[0]
        w = self.mapping_network(x, training=training)
        # 输入位置编码
        x_pos = self.patch_positional_embedding()
        x = self.generator_transformer_encoder(x=x_pos, w=w, training=training)
        x = self.sln1(x, w, training=training)
        # 博里叶位置编码
        e_fou = self.coordinates_positional_embedding(x)
        x = self.siren((e_fou, x)) # (B*L, P*P, E)
        x = tf.reshape(x, [batch_size, self.grid_size, self.grid_size, self.patch_size, self.patch_size, self.num_channels])
        x = tf.transpose(x, perm=[0,1,3,2,4,5])
        x = tf.reshape(x, [batch_size, self.image_size, self.image_size, self.num_channels])
        return x


if __name__ == "__main__":
    layer = Generator(
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768
    )
    x = tf.random.uniform([2,1,768], dtype=tf.float32)
    o1 = layer(x, training=True)
    tf.print('o1:', tf.shape(o1))
    o1 = layer(x, training=False)
    tf.print('o1:', tf.shape(o1))
Generator代码实现,包含博里叶位置编码。论文没描述该结构细节,这是另一种猜测,试过无效,可能有误。
import tensorflow as tf
import sys

sys.path.append('')

from models.mapping_network import MappingNetwork
from models.generator_transformer_encoder import GeneratorEncoder
from models.coordinates_positional_embedding import CoordinatesPositionalEmbedding
from models.siren import Siren
from models.sln import SLN
from models.positional_embedding import PositionalEmbedding
from models.modulated_linear import ModulatedLinear
from models.mlp import MLP


class Generator(tf.keras.layers.Layer):
    """
    生成器
    """

    def __init__(
        self,
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768,
        dropout=0.0,
    ):
        super().__init__()
        self.image_size = image_size
        self.patch_size = patch_size
        self.num_channels = num_channels
        self.d_model = d_model
        self.dropout = dropout
        self.grid_size = image_size // patch_size
        self.num_patches = self.grid_size ** 2

        self.mapping_network = MappingNetwork(
            self.d_model,
            num_layers=8
        )

        # 输入位置编码
        self.patch_positional_embedding = PositionalEmbedding(
            sequence_length=self.num_patches,
            emb_dim=self.d_model,
        )

        self.generator_transformer_encoder = GeneratorEncoder(
            d_model,
            num_heads=8,
            num_layers=4,
            dropout=dropout,
        )
        self.sln1 = SLN(d_model)
        # 博里叶位置编码
        self.coordinates_positional_embedding = CoordinatesPositionalEmbedding(
            patch_size=patch_size,
            emb_dim=d_model,
            )

        self.siren = Siren(
            hidden_dim=d_model,
            hidden_layers=2,
            out_dim=d_model,
            first_omega_0=30,
            hidden_omega_0=30,
            demodulation=True,
            outermost_linear=False
        )

        self.modulated_linear = ModulatedLinear(
            hidden_dim=d_model,
            output_dim=d_model,
            demodulation=True,
            use_bias=False,
            kernel_initializer=tf.initializers.GlorotNormal(),
        )
        self.mlp1 = MLP(d_model, discriminator=False, dropout=dropout)
        self.mlp2 = MLP(num_channels, discriminator=False, dropout=dropout)

    def call(self, x, training):
        batch_size = tf.shape(x)[0]
        w = self.mapping_network(x, training=training)
        # 输入位置编码
        x_pos = self.patch_positional_embedding()
        x = self.generator_transformer_encoder(x=x_pos, w=w, training=training)
        x = self.sln1(x, w, training=training)
        # 博里叶位置编码
        e_fou = self.coordinates_positional_embedding(x) # (B*L, P*P, E)
        e_fou = self.siren(e_fou) # (B*L, P*P, E)
        x = self.modulated_linear((e_fou, x)) # (B*L, P*P, E)
        x = self.mlp1(x, training=training)
        x = self.mlp2(x, training=training)
        x = tf.math.sin(x)
        x = tf.reshape(x, [batch_size, self.grid_size, self.grid_size, self.patch_size, self.patch_size, self.num_channels])
        x = tf.transpose(x, perm=[0,1,3,2,4,5])
        x = tf.reshape(x, [batch_size, self.image_size, self.image_size, self.num_channels])
        return x


if __name__ == "__main__":
    layer = Generator(
        image_size=224,
        patch_size=16,
        num_channels=3,
        d_model=768
    )
    x = tf.random.uniform([2,1,768], dtype=tf.float32)
    o1 = layer(x, training=True)
    tf.print('o1:', tf.shape(o1))
    o1 = layer(x, training=False)
    tf.print('o1:', tf.shape(o1))

 573


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


