使用Python抓取欧洲足球联赛数据

全速数据关于足球数据接口API的Python调用示例 在下面的示例中,全速数据将展示如何使用 Python 调用一个足球数据接口 API。在这个示例中,我们将使用一个虚构的足球数据 API,假设它提供了有关比赛结果、球队信息和球员统计的数据。请注意,实际情况下,你需要替换这些虚构的端点和数据为真实的足球 API 端点和数据。在这个示例中,我们首先定义了三个函数,分别用于获取最近一场比赛的结果、球队的信息以及球员的统计数据。请记住,这只是一个简单的示例,实际情况可能会根据你使用的真实足球数据 API 进行调整。 阅读详情

背景

Web Scraping

在大数据时代,一切都要用数据来说话,大数据处理的过程一般需要经过以下的几个步骤

  • 数据的采集和获取

  • 数据的清洗,抽取,变形和装载

  • 数据的分析,探索和预测

  • 数据的展现

其中首先要做的就是获取数据,并提炼出有效地数据,为下一步的分析做好准备。

数据的来源多种多样,以为我本身是足球爱好者,而世界杯就要来了,所以我就想提取欧洲联赛的数据来做一个分析。许多的网站都提供了详细的足球数据,例如:

这些网站都提供了详细的足球数据,然而为了进一步的分析,我们希望数据以格式化的形式存储,那么如何把这些网站提供的网页数据转换成格式化的数据呢?这就要用到Web scraping的技术了。简单地说,Web Scraping就是从网站抽取信息, 通常利用程序来模拟人浏览网页的过程,发送http请求,从http响应中获得结果。

Web Scraping 注意事项

在抓取数据之前,要注意以下几点:

  • 阅读网站有关数据的条款和约束条件,搞清楚数据的拥有权和使用限制

  • 友好而礼貌,使用计算机发送请求的速度飞人类阅读可比,不要发送非常密集的大量请求以免造成服务器压力过大

  • 因为网站经常会调整网页的结构,所以你之前写的Scraping代码,并不总是能够工作,可能需要经常调整

  • 因为从网站抓取的数据可能存在不一致的情况,所以很有可能需要手工调整

Python Web Scraping 相关的库

Python提供了很便利的Web Scraping基础,有很多支持的库。这里列出一小部分

当然也不一定要用Python或者不一定要自己写代码,推荐关注import.io

Web Scraping 代码

下面,我们就一步步地用Python,从腾讯体育来抓取欧洲联赛13/14赛季的数据。

首先要安装Beautifulsoup

pip install beautifulsoup4


我们先从球员的数据开始抓取。

球员数据的Web请求是http://soccerdata.sports.qq.com/playerSearch.aspx?lega=epl&pn=2 ,返回的内容如下图所示:
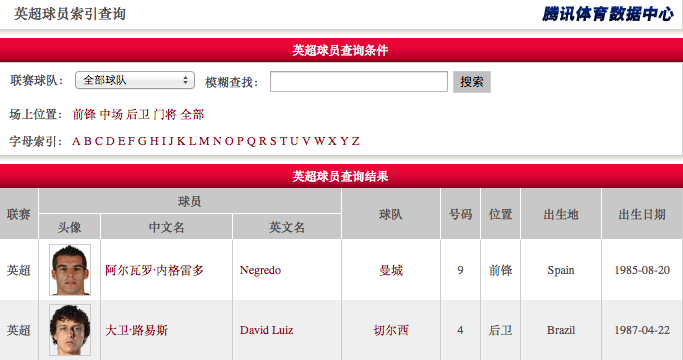
该web服务有两个参数,lega表示是哪一个联赛,pn表示的是分页的页数。

首先我们先做一些初始化的准备工作

from urllib2 import urlopen
import urlparse
import bs4

BASE_URL = "http://soccerdata.sports.qq.com"
PLAYER_LIST_QUERY = "/playerSearch.aspx?lega=%s&pn=%d"
league = ['epl','seri','bund','liga','fran','scot','holl','belg']
pag
python足球大数据分析_使用Python抓取欧洲足球联赛数据进行大数据分析 背景Web Scraping在大数据时代,一切都要用数据来说话,大数据处理的过程一般需要经过以下的几个步骤数据的采集和获取数据的清洗,抽取,变形和装载数据的分析,探索和预测数据的展现其中首先要做的就是获取数据,并提炼出有效地数据,为下一步的分析做好准备。数据的来源多种多样,以为我本身是足球爱好者,而世界杯就要来了,所以我就想提取欧洲联赛的数据来做一个分析。许多的网站都提供了详细的足球数据,例如:这... 阅读详情

相关推荐

五大欧洲足球联赛2016-2020赛季欧指数据深度分析

网络爬虫,亦称网络蜘蛛或网络机器人,是一种按照一定的规则,自动抓取互联网信息的程序或脚本。它模仿人类用户的网络行为,按照既定的路径访问网站,解析页面内容,并从中提取有价值的数据。爬虫的工作流程通常包括初始化请求、获取响应、解析内容和数据存储四个基本步骤。在请求网页时,爬虫会模拟浏览器行为发送HTTP请求,然后根据返回的HTTP响应进行分析处理。响应内容的解析通常借助于如BeautifulSoup和lxml这样的库完成,最后提取的数据将保存在数据库或文件中以供进一步分析使用。

weixin_35754676的博客 923

阿里云人工智能工程师ACA认证免费课程学习笔记

阿里云人工智能工程师ACA认证免费课程学习笔记

engchina的专栏 2014

双目相机立体匹配算法概述(含Python代码)

立体匹配任务是计算机视觉中的一个重要问题,旨在从一对具有相同场景的图像中估计每个像素的视差(disparity)。本文对现有的传统算法和深度学习算法进行了综述,以便于各位选择合适的立体匹配算法用于深度估计或三维建模。

m0_59257547的博客 8294

Wireshark抓包实战:5个CTF比赛中高频出现的流量分析技巧(附真实案例)

本文分享了Wireshark在CTF比赛和实战渗透中的五个核心流量分析技巧。内容涵盖从宏观统计概览锁定可疑目标、深度解析ICMP与HTTP等协议、追踪重组完整会话流,到利用字符串搜索和命令行工具进行自动化分析。掌握这些高阶技巧能显著提升分析海量网络流量的效率与精准度。

rrr55的博客 262

开源DIY | 打造会“听”会“走”的智能移动垃圾桶

本文详细介绍了如何利用Arduino和超声波传感器打造一款会“听”会“走”的智能移动垃圾桶。通过开源硬件和简单编程,实现声控移动和自动避障功能,适合创客爱好者和家庭DIY。项目成本控制在200元内,涵盖硬件搭建、电路连接和核心功能实现,是入门级机器人制作的理想选择。

weixin_33670713的博客 233

别让PEX和后仿真拖后腿:Calibre与Virtuoso ADE联调的那些‘坑’与最佳实践

本文深入探讨了Calibre与Virtuoso ADE在PEX寄生参数提取和后仿真联调中的常见问题与解决方案。针对DRC/LVS验证通过后出现的网表导入错误和仿真波形异常,提供了七大典型场景的实战经验,包括PEX提取模式选择、CalibreView生成细节、环境变量配置等关键环节的最佳实践,助力工程师高效完成芯片设计验证。

weixin_33695450的博客 393

基于唤醒音频的目标说话人语音识别系统设计报告

摘要 本报告设计了一套基于唤醒音频的目标说话人语音识别系统,通过五级流水线架构(唤醒检测→声纹注册→语音分离→目标ASR→拒识决策)解决复杂声学场景下的目标说话人识别问题。系统整合ECAPA-TDNN声纹模型、Conv-TasNet语音分离网络和Whisper ASR引擎,在L20 GPU上实现高效端到端推理,支持-5dB~5dB SNR范围和0~100%重叠率的双人语音场景处理。系统在目标说话人CER、拒识率和推理效率等关键指标上均达到设计目标,为智能语音交互提供了有效的身份感知解决方案。

huanghm88的专栏 75

Hermes 教程 03:Skills 系统

摘要:Hermes Skills是一种自我改进机制,可将解决问题的经验保存为可复用技能文档。v0.13.0版本遵循agentskills.io开放标准,与Claude Skills互通。技能创建流程包括发现问题、创建技能文件、加载使用和优化更新四个阶段。系统提供技能检索和自维护机制(Curator),支持技能媒体路由和多种管理命令。内置技能涵盖开发调试、创意头脑风暴等场景,通过积累技能使Hermes更适应用户需求。

程序猿_三产 734

【Flink】FlinkCDC获取mysql数据时间类型差8小时时区解决方案

​ 1、背景: 在我们使用FlinkCDC采集mysql数据的时候,日期类型是我们很常见的类型,但是FlinkCDC读取出来会和数据库的日期时间不一致,情况如下 FlinkCDC获取的数据中create_time字段1694597238000转换为时间戳2023-09-13 17:27:18,而数据库中原始数据如下,并没有到下午5点,这就导致了FlinkCDC读出来的时间和数据库中实际的时间不一致的情况,与数据库对比可以发现,这里的时间戳与数据库时间刚好相差了 8 个小时,在实际生产中这种情况是不

一杯咖啡半杯糖的博客 3855

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

上一篇: 用Python做单变量数据集的异常点分析
下一篇: 神奇的阿基米德螺线
刚是程序员
博客等级 码龄9年 47粉丝 41原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
