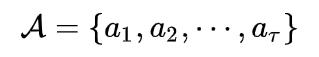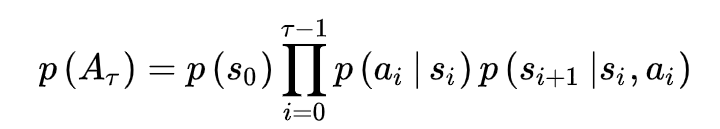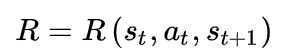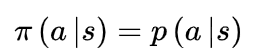【深度强化学习笔记】--第二节:马尔可夫决策过程

强化学习基础-马尔可夫决策过程(Markov Decision Process,MDP) 是一种数学框架,用于建模和求解序贯决策问题。它基于马尔可夫性质,通过定义状态、行动、转移概率函数和奖励函数来描述决策过程,并通过最优化方法来求解最优策略。本文将详细介绍马尔可夫决策过程的原理和数学公式。 阅读详情

1.马尔可夫性质

马尔可夫决策过程(Markov Decision Process, MDP)独有性质即当前时刻的状态仅与前一时刻的状态和动作有关,与其他时刻的状态和动作条件独立。
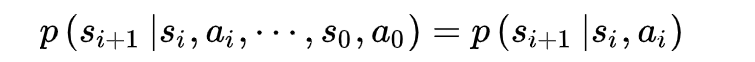
在这里插入图片描述
等式右侧的条件概率被称为MDP的状态间的转移概率 。马尔可夫性质是所有马尔可夫模型共有的性质,但相比于马尔可夫链,MDP的转移概率加入了智能体的动作,其马尔可夫性质也与动作有关

2.MDP基本组成部分

状态集合
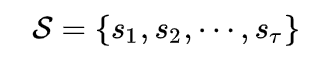
在这里插入图片描述
动作集合
在这里插入图片描述
状态转移概率函数
在这里插入图片描述
奖励函数
在这里插入图片描述
策略函数
在这里插入图片描述
●折扣因子:γ∈[0,1]
◆γ=0:贪婪法,价值只由当前延时奖励决定;
◆γ=1:所有后续状态奖励和当前状态奖励同等重要;
◆γ∈(0,1):当前延时奖励的权重比后续奖励的权重大。
马尔科夫决策过程可以表示成一个五元组

MDP(S,A,P(a|s),R(s|a),γ)

强化学习: 贝尔曼方程与马尔可夫决策过程 强化学习: 贝尔曼方程与马尔可夫决策过程 一、简介 贝尔曼方程和马尔可夫决策过程是强化学习非常重要的两个概念,大部分强化学习算法都是围绕这两个概念进行操作。尤其是贝尔曼方程,对以后理解蒙特卡洛搜索、时序差分算法以及深度强化学习算法都至关重要。这篇文章主要介绍贝尔曼方程。 常用的资料: 《Reinforcement Learning: An Introduction》 author: Richard S.Sutton and Andrew G.Barto UCL Course: https://www.dav 阅读详情

相关推荐

深度强化学习第2课|马尔可夫决策过程

文章目录0 写在前面1 简介2 马尔可夫属性3 State Transition Matrix4 MP5 示例:Student Markov Chain6 Markov Reward Process7 Return8 为什么需要衰减?9 MRP的值函数10 贝尔曼方程11 贝尔曼方程的数学表示12 MDP13 Policy14 MDP的值函数15 最优值函数16 最优策略17 寻找最优策略18 贝...

JohnJim的博客 2865

马尔科夫链(Markov Chain)

马尔科夫链原理简介

大龄小白爱折腾的博客 1万+

CoppeliaSim深度强化学习(六):马尔可夫决策过程

在时间步 t+1 时,环境的反馈仅取决于上一时间步 t 的状态 s 和动作 a,与时间步 t-1 以及步 t-1 之前的时间步都没有关联性。PSt1∣StPSt1∣S1StPSt1​∣St​PSt1​∣S1​...St​原本的马尔科夫过程加上奖励值之后就变成了马尔科夫奖励过程,其中 R 就是奖励,γ\gammaγ是折扣因子。

weixin_45560674的博客 854

马尔可夫链在 A 股市场的量化应用(2)

昨天的小文抛砖引玉,昨晚又完善了一下,分析下马尔科夫链的相关公式与基础逻辑,看来可以融入到我的量化机器人了.#

海哥谈量化 1505

强化学习 马尔可夫决策过程

强化学习中的马尔可夫决策过程(Markov Decision Process,MDP)是用于描述智能体与环境交互决策过程的数学框架。MDP是强化学习的核心概念之一,它提供了一个系统化的方法来建模和解决序列决策问题。

百态·数智思维 | 聚焦大数据、量化与未来AI 1245

马尔可夫决策过程:强化学习的数学基石

当谈论人工智能(AI)如何学习在复杂环境中做出最优决策时,我们几乎总会触及一个核心概念:强化学习 (Reinforcement Learning, RL)。从 AlphaGo 精妙的棋局策略,到自动驾驶汽车的路径规划,再到个性化推荐系统精准的用户洞察,强化学习正以前所未有的速度渗透到各个领域。而这一切辉煌成就的背后,都离不开一个坚实的数学框架——马尔可夫决策过程 (Markov Decision Process, MDP)。

高校图书馆高级系统架构师/研究馆员,推动高校AI从概念演示到可评审、可交付、可运维:路线图与立项评审、PoC交付、评测回归与上线运维(Baseline/Eval/Ops)。 1406

空间马尔科夫工具更新

PS:由于某些原因,工具视界官网转到了github,网址为gongju128.github.io。原先的版本,需要用户手动计算分位数,比较麻烦,本次更新的版本,用户可以指定软件自行计算分位数,结果表中增加了传统markov的初始分布和稳态分布结果,以及空间markov的稳态分布结果。之前默认是分4类,可是有些用户有分三类或者五类的需求,现在用户可以自由指定分类状态数。现在很多关于空间markov的文献,增加了卡方检验,这里一并加上。当然,如果有用户需要手动指定分位数,我们也保留了这一功能。

weixin_52338842的博客 448

免资源分的马尔可夫决策过程全面解析

本文还有配套的精品资源,点击获取 简介:马尔可夫决策过程(MDP)是处理动态系统中随机性和决策者选择行为的数学模型,广泛应用于多个领域解决多阶段决策问题。MDP的关键组成部分包括状态、动作、转移概率、奖励函数和折扣因子。其目标是找到最优策略以最大化预期累积奖励,常用的解决算法包括动态规划、蒙特卡洛方法和强化学习中的Q-learning。MDP在机器人导航、资源管理、游戏策略...

weixin_35751412的博客 1156

马尔可夫性的统计检验(马氏性检验)

马尔可夫预测法认为,只要当事物的现在状态为已知时,人们就可以预测其未来的状态,而不需要知道事物的过去状态,即马尔可夫链具有无后效性特征,这也被后人称为马尔可夫性。这一特性避开了其他预测方法在搜集历史资料时所遇到的一系列难题,使得它无论是理论上还是应用上都占有很重要的地位。 因此,检验随机过程是否具有马尔可夫性是应用马尔可夫概型分析的必要前提。 ...

Fo*(Bi)的博客 1万+

一种车内UWB圆极化天线的理论推导及具体实现

本文详细描述了一款工作于UWB channel 9也即中心频率为7987.2MHz,带宽为499.2MHz的圆极化天线。首先是理论推导圆极化天线的物理尺寸参数,分析物理尺寸参数对天线性能指标的影响。然后分析圆极化天线在汽车驾驶室这种狭窄空间应用中带来的优势,也即可以最大化的极化损失多径,提高主径接收信号的信噪比。

weixin_44555637的博客 2965

Android息屏后台任务保活实战:从定时器失效到厂商白名单破解

本文深入探讨了Android应用在息屏后定时任务失效的根源,即系统为省电而触发的休眠机制。文章提供了从传统方案失效分析到实战破解的完整路径,核心在于引导用户将应用加入电池优化白名单并开启自启动权限,从而合法绕过限制。同时,结合WorkManager、AlarmManager等可靠定时方案,实现稳定的后台任务执行。

weixin_28475533的博客 422

深度强化学习入门:马尔可夫决策过程(井字棋案例理解)

以井字棋案例,讲解自己对于马尔可夫决策过程(MDP)的理解

God-Excious的博客 3339

OneNET物模型实战:如何用NB-IOT模块上传JSON数据并解析

本文详细介绍了如何利用NB-IOT模块将传感器数据上传至中国移动OneNET物联网平台,并利用其物模型功能实现JSON数据的自动解析。文章从理解OneNET物模型与OneJson协议入手,逐步讲解了平台侧物模型创建、设备注册,以及设备端数据构造、HEX编码与NB-IOT模块AT指令上报的全流程,并提供了关键的调试技巧与常见问题排查方法,为物联网开发者提供了完整的实战指南。

sugar的博客 680

深度强化学习(2)马尔可夫决策过程

在随机过程中,马尔可夫性质(Markov property)指的是一个随机过程在给定现在状态及过去所有状态的情况下,其未来状态的条件概率分布仅依赖于当前状态。马尔可夫过程是一组具有马尔可夫性质的随机变量序列s1,...,sts_1,...,s_ts1​,...,st​,其中下一个时刻的状态st+1s_{t+1}st+1​只取决于当前状态sts_tst​。假设历史状态为ht={s1,s2,...,st}h_t=\{s_1,s_2,...,s_t\}ht​={s1​,s2​,...,st​},则马尔可夫过程满足

weixin_58665941的博客 1607

月薪30k+的工业视觉,必备Java+YOLO技能(工业级落地全拆解)

30k+工业视觉岗的核心不是算法调参,而是用Java把YOLO落地到工业场景的能力——稳运行、能对接、可管理是高薪的核心壁垒;必备技能分五层:模型工业级适配、Java推理核心、SpringBoot后端、工业部署运维、场景适配,每层都要练到“能落地、能讲清、能避坑”;学习路径的核心是“实战驱动”:不要只学理论,从一个完整的工业项目(如锂电缺陷检测)入手,练完就能对标高薪岗。

2601_94871597的博客 525

4.3 Langfuse 集成实战:追踪 OpenAI、LangChain 和 LangGraph 应用

本文介绍了如何将Langfuse集成到不同类型的AI应用中,包括原生OpenAI、LangChain和LangGraph应用。主要内容包括: 两种集成模式:手动追踪(精确控制)和自动追踪(通过回调机制) 三种应用场景的集成方案: 原生OpenAI应用:使用langfuse.trace()手动记录对话流程、LLM调用和工具执行 LangChain应用:通过LangfuseCallbackHandler自动追踪Agent执行过程 LangGraph应用:与LangChain相同的自动追踪方式,可可视化节点和状态

yonggeit的博客 3303

深度强化学习笔记(二)马尔可夫决策过程

马尔可夫决策过程 上图介绍了在强化学习里面 agent 跟 environment 之间的交互,agent 在得到环境的状态过后,它会采取动作,它会把这个采取的动作返还给环境。环境在得到 agent 的动作过后,它会进入下一个状态,把下一个状态传回 agent。在强化学习中,agent 跟环境就是这样进行交互的,这个交互过程是可以通过马尔可夫决策过程来表示的,所以马尔可夫决策过程是强化学习里面的一个基本框架。 在马尔可夫决策过程中(Markov Decision Process,MDP),它的环境是全部可

qq_36744449的博客 1823

核心面试聚焦:业务问题+系统问题+设计题---字节、阿里、美团等整理统计

业务系统及其他相关面试问题整理:线上相关问题排查+高并发系统的限流+高并发秒杀系统设计+负载均衡+一个网站有 20 亿 url 存在一个黑名单中,这个黑名单要怎么存?若此时随便输入一个 url,你如何快速判断该 url 是否在这个黑名单中?并且需在给定内存空间(比如:500M)内快速判断出?

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 172万+

datawhale学习-深度强化学习2:马尔可夫决策过程

折扣因子取值在0到1之间,表示了在考虑未来奖励是的重要程度,控制着当前奖励与未来奖励的权衡,即对长远目标的关注度。交互是在离散的时步交互的,t=0,1,2,...在每个t,智能体接受st,然后执行动作at,执行完会受到奖励rt+1以及环境会由于at变成新的状态st+1,以此循环下去。一般是有限马尔可夫决策过程,即t是有限的,上限记为T,也就是交互过程的最大步数,t=0,到t=T,称为一个回合(episode)。即给定历史状态下,st+1的状态只与st有关,而与s0,s1,s2,...,st-1的状态无关。

qq_45919809的博客 1111

labelImg使用教程

Anaconda环境 安装 Anaconda 之后,在开始菜单下找到 Anaconda 文件夹 找到 Anaconda Prompt 点击运行 安装 labelImg pip install labelImg #直接命令行输入 启动 labelImg labelImg #直接命令行输入名称即可 labelImg界面 开始标注 快捷键:W(创建方框),A(上一张),D(下一张) XML文件示例 <annotation> <folder>夜读</folder>

G果的博客 3万+

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

马尔可夫决策过程

本文转自:http://www.52caml.com/reinforcement-learning/chapter3-markov-decision-process/ 1. 智能体与环境 强化学习问题不同于传统机器学习问题,它是一种在交互的过程中学习并实现目标的问题。这里把具有学习能力和决策能力的程序或系统称之为Agent(代理,智能体);与之交互的对象统称为环境(Environment)。交...

weixin_37559696的博客 5625

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

深度强化学习中的马尔可夫决策过程(MDP)解析

深度强化学习中的马尔可夫决策过程(MDP)解析 【免费下载链接】d2l-en d2l-ai/d2l-en: 是一个基于 Python 的深度学习教程,它使用了 SQLite 数据库存储数据。适合用于学习深度学习,特别是对于需要使用 Python 和 SQLite 数据库的场景。特点是深度学习教程、Python、SQLit...

gitblog_00092的博客 730

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

马尔科夫决策过程-策略迭代与值迭代(基于动态规划)

强化学习入门笔记,基于easy RL提示:以下是本篇文章正文内容,下面案例可供参考。

m0_66988867的博客 2551

马尔可夫决策过程(MDP)求解全攻略:从经典算法到前沿实践

马尔可夫决策过程(MDP)求解全攻略:从经典算法到前沿实践

嗨,欢迎来到我的 优快云 博客小天地!一名深耕多年的技术发烧友。在这里,我将把日常工作中积累的宝贵经验,从复杂架构设计的精妙之处,到代码优化的实战技巧,毫无保留地分享给大家。 3495
上一篇: 【深度强化学习笔记】--第一节:强化学习模型
下一篇: 利用dockerfile生成镜像
玄月无疆
博客等级 码龄9年 34粉丝 46原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值