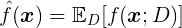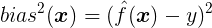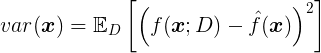《李宏毅机器学习》task2

OpenSSH命令注入漏洞复现(CVE-2020-15778) OpenSSH命令注入漏洞复现 1、简介 OpenSSH 是 SSH (Secure SHell) 协议的免费开源实现,ssh主要就是用来远程控制计算机,或传输文件,OpenSSH是使用SSH透过计算机网络加密通讯的实现。 2、漏洞概述 该漏洞是存在于scp在拷贝文件时产生的一个代码注入漏洞,攻击者可以利用此漏洞执行任意命令,比如:反弹shell, 3、影响版本 openssh <= openssh-8.3p1 4、实验环境 首先下载openssh,版本要符合漏洞影响的版本 服务端:apt-get 阅读详情

1.偏差和方差

学习误差由偏差和方差而产生

  • 偏差与方差分别是用于衡量一个模型泛化误差的两个方面;
    模型的偏差,指的是模型预测的期望值与真实值之间的差;
    模型的方差,指的是模型预测的期望值与预测值之间的差平方和;

  • 偏差用于描述模型的拟合能力;
    方差用于描述模型的稳定性。
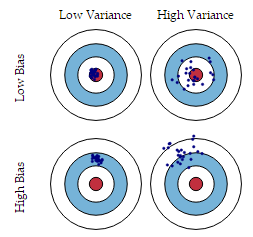
    在这里插入图片描述

记在训练集 D 上学得的模型为
在这里插入图片描述

模型的期望预测为
在这里插入图片描述

偏差(Bias)
在这里插入图片描述
方差(Variance)
在这里插入图片描述

bias描述的是根据样本拟合出的模型的输出预测结果的期望与样本真实结果的差距,简单讲,就是在样本上拟合的好不好。要想在bias上表现好,low bias,就得复杂化模型,增加模型的参数,但这样容易过拟合 (overfitting),过拟合对应上图是high variance,点很分散。low bias对应就是点都打在靶心附近,所以瞄的是准的,但手不一定稳。

varience描述的是样本上训练出来的模型在测试集上的表现,要想在variance上表现好,low varience,就要简化模型,减少模型的参数,但这样容易欠拟合(unfitting),欠拟合对应上图是high bias,点偏离中心。low variance对应就是点都打的很集中,但不一定是靶心附近,手很稳,但是瞄的不准。

在机器学习中,一般将样本分成独立的三部分训练集(train set),验证集(validation set)和测试集(test set)。其中,测试集用来检验最终选择最优的模型的性能如何。

过拟合,欠拟合
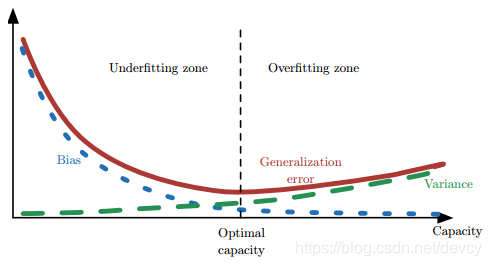
在这里插入图片描述

当训练不足时,模型的拟合能力不够(数据的扰动不足以使模型产生显著的变化),此时偏差主导模型的泛化误差;
随着训练的进行,模型的拟合能力增强(模型能够学习数据发生的扰动),此时方差逐渐主导模型的泛化误差;
当训练充足后,模型的拟合能力过强(数据的轻微扰动都会导致模型产生显著的变化),此时即发生过拟合(训练数据自身的、非全局的特征也被模型学习了)

2.鞍点,全局最优和局部最优
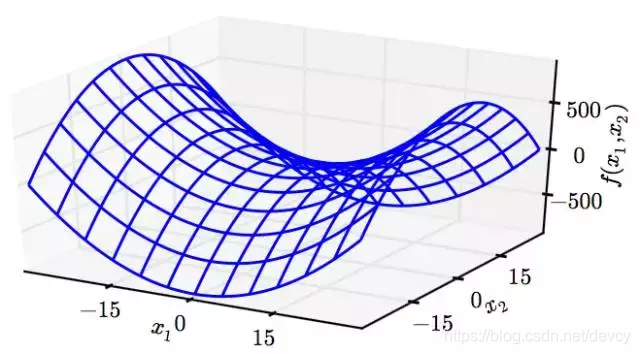
在这里插入图片描述

3.梯度下降

Mini-Batch与SGD

全量梯度下降法(Batch gradient descent)
全量梯度下降法每次学习都使用整个训练集,因此每次更新都会朝着正确的方向进行,最后能够保证收敛于极值点,凸函数收敛于全局极值点,非凸函数可能会收敛于局部极值点,缺陷就是学习时间太长,消耗大量内存。

SGD一轮迭代只用一条随机选取的数据,尽管SGD的迭代次数比BGD大很多,但一次学习时间非常快。
SGD的缺点在于每次更新可能并不会按照正确的方向进行,参数更新具有高方差,从而导致损失函数剧烈波动。不过,如果目标函数有盆地区域,SGD会使优化的方向从当前的局部极小值点跳到另一个更好的局部极小值点,这样对于非凸函数,可能最终收敛于一个较好的局部极值点,甚至全局极值点。
缺点是,出现损失函数波动,如下图所示,并且无法判断是否收敛

SGD相比BGD收敛速度快,然而,它也的缺点,那就是收敛时浮动,不稳定,在最优解附近波动,难以判断是否已经收敛。这时折中的算法小批量梯度下降法,MBGD就产生了,道理很简单,SGD太极端,一次一条,为何不多几条?MBGD就是用一次迭代多条数据的方法。
并且如果Batch Size选择合理,不仅收敛速度比SGD更快、更稳定,而且在最优解附近的跳动也不会很大,甚至得到比Batch Gradient Descent 更好的解。这样就综合了SGD和Batch Gradient Descent 的优点,同时弱化了缺点。总之,Mini-Batch比SGD和Batch Gradient Descent都好。

Batch与Mini-Batch,SGD的区别

如何根据样本大小选择哪个梯度下降

写出SGD和Mini-Batch的代码

4.交叉验证

5.归一化

6.回归模型评价指标

SSE(误差平方和):The sum of squares due to error
R-square(决定系数):Coefficient of determination
Adjusted R-square:Degree-of-freedom adjusted coefficient of determination

https://www.zhihu.com/question/27068705

博途PLC信号处理系列之卡尔曼滤波程序(Kalman Filter) 三菱系列PLC的卡尔曼滤波程序,可以参看下面这篇博文PLC滤波算法之卡尔曼滤波(kalmanFilter)代码+测试_RXXW_Dor的博客-优快云博客_plc滤波kalman滤波是采用递归的方法解决线性滤波问题,只需要当前的测量值input(西门子PLC里比如我们的模拟量通道AIW0值)和前一个采样周期的估计值(上一个时刻的滤波输出结果last_out)就能进行状态估计,需要的存储空间小,每一步的计算量小。下面我们通过程序代码一一给大家展示下。注意。...... 阅读详情

相关推荐

使用KITTI数据集测试不同算法的性能

该文章将使用同一个kitti数据集来测试不同算法的性能,目前已经测试的算法包括:LIO-SAM,FAST-LIO2,Point-LIO,Faster-LIO。

wwtx的博客 2587

DW李宏毅机器学习Task2——Regression

回归的应用: (1)股票市场的预测 (2)自动驾驶车 (3)推荐系统 应用例子:预测进化后的宝可梦CP值 Step 1:Model Linear model:y=b+∑wixiy=b+ \sum{}^{}w_ix_iy=b+∑wi​xi​ xix_ixi​:an attribute of input xxx (feature) wiw_iwi​:weight bbb:bias Step 2:Goodness of Function Source:https://www.openintro.org

momokofly的博客 297

Charles 抓包工具下载安装及基础使用

本篇内容主讲关于Charles抓包工具,从下载安装以及配置信息,证书的下载安装以及PC端设置代理配置和移动端设备配置代理,阐述关于Charles抓包工具面板的基础使用以及如何进行抓包和设置断点,对于软件测试以及对抓包感兴趣的读者可以翻阅!感谢大家的支持!!!

灵魂学者的博客 2960

【李宏毅深度学习CP1-2】(task1)机器学习简介

目录 机器学习介绍 机器学习相关的技术 监督学习 半监督学习 迁移学习 无监督学习 监督学习中的结构化学习 强化学习 为什么我们需要学习机器学习? 机器学习介绍 1950年 人工智慧(AI)、Artificial Intelligence 1980年 机器学习(ML) 、Mechine Learning 2010年 深度学习(DL)、Deep Learning 机器学习相关的技术 监督学习 监督学习是指:利用一组已知类别的样本调整分类器的参数,使其达到所...

202xxx的博客 3124

C#实践项目1

需求: 在CAD内实现两个坐标系的转换。 转换方式为文件内的所有图形从一个坐标系下的坐标,转换到另一个坐标系下的坐标。 进行坐标转换后,仅仅是坐标发生改变,图层、样式等等不会发生变化。

weixin_51182789的博客 5330

大学生电赛学习之路

可以看到全国大学生电子设计大赛的认可度是非常高的,属于A类学科竞赛。电子设计大赛的形式也是给出题目,参赛者有四天三夜的时间解决问题,题目大致可以分为:控制类、测量类、高频类以及电力电子类。该竞赛会在单数年的9月份举行。但是对于新生来说电赛确实遥不可及的,可能在很多学校本科生是不能进入实验室的,但是就算进了实验室你就有资格去参加电赛或者说能拿一个不错的奖项吗? 现在正值新生开学季,当然会有一大批学生会进入实验室的学习,电赛的举办时间是每年的暑假,所以说对于大一同学来说有一年的时间去准备,那我们就来说一说参加.

weixin_46098612的博客 8792

【李宏毅机器学习CP4】(task2)回归+Python Basics with Numpy

文章目录回归演示 回归演示 现在假设有10个x_data和y_data,x和y之间的关系是y_data=b+w*x_data。b,w都是参数,是需要学习出来的。现在我们来练习用梯度下降找到b和w。 import numpy as np import matplotlib.pyplot as plt from pylab import mpl # matplotlib没有中文字体,动态解决 plt.rcParams['font.sans-serif'] = ['Simhei'] # 显示中文 mpl.rc

发现问题,并解决问题,批判性思维 1363

海康工业相机 Could not find module MvCameraControl.dll(已解决)

【代码】海康摄像机 Could not find module MvCameraControl.dll(已解决)

hmbbpdx的博客 2226

《李宏毅机器学习》- Task2 梯度下降、误差偏差方差的关系、模型评估

1、理解偏差和方差 偏差(bias):表示测试样本集的测试期望值距离groundtruth期望值的偏差; a) bias越大,则说明预测结果越差,模型并未很好拟合训练集样本,欠拟合; b) 我们希望模型在测试样本上的bias足够小,那么就需要增加模型的复杂程度,或者简单理解为增加模型(映射函数)的泰勒展开式最高幂次。 方差(variance):表示模型在测试集上的预测结果是否稳定,或预测值...

weixin_38424903的博客 843

python爬取巨潮资讯网所有股票年报数据

爬虫获取巨潮资讯网数据

qq_42752524的博客 6128

机器视觉/将HIK海康面阵相机连接Halcon软件

本文简述了如何将海康面阵相机连接到Halcon软件中进行实时取图的过程。

Dahe.qu 4869

【李宏毅机器学习CP9】(task3下)PM2.5预测+numpy实现神经网络logistic回归

学习心得 小批量梯度下降算法中,初始参数的选择很重要,不同的初始参数,其对应损失函数收敛速度也不一样 learning rate 采用递减的方式选取的,根据经验的选择也很重要,在实验中,多积累、多总结。 文章目录学习心得第一部分:PM2.5预测一、作业描述二、任务要求三、大致任务实现方案1方案2方案3四、Reference第二部分:用numpy实现一个简单神经网络logistic回归模型一、包(库)的介绍二、问题概述三、学习算法的框架四、构建自己的算法1.Helper函数2.Initializing pa

发现问题,并解决问题,批判性思维 1814

数据库系统工程师软考备战:第三篇 - SQL语言深入解析与应用

​​创建表​​​修改表​​​删除表​。

Programming Talk 123

Datawhale X 李宏毅苹果书 AI夏令营 第五期 跟李宏毅学深度学习(入门)Task3:《深度学习详解》- 2 机器学习框架&实践攻略

Task3:《深度学习详解》- 2 机器学习框架&实践攻略(

图像检索小菜鸟_bianwencyy_的专栏 413

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

DW李宏毅机器学习笔记--Task02-回归

文章目录前言一、回归定义二、模型步骤Step 1:模型假设 - 线性模型一元线性模型(单个特征)多元线性模型(多个特征)Step 2:模型评估 - 损失函数如何判断众多模型的好坏Step 3:最佳模型 - 梯度下降梯度下降推演最优模型的过程梯度下降算法在现实世界中面临的挑战w和b偏微分的计算方法如何验证训练好的模型的好坏总结 前言 这是我在Datawhale组队学习李宏毅机器学习的记录,既作为我学习过程中的一些记录,也供同好们一起交流研究,此后还会继续更新相关内容的博客。 一、回归定义 回归(Regres

StarryPilgrim 566

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Datawhale李宏毅深度学习笔记Task02

回归 回归定义 regression是找到一个function,通过输入特征x,输出一个y(scalar)。 模型步骤 1.model假设,选择model(线性、非线性;一元、多元) y=b+w⋅xcpy = b + w·x_{cp}y=b+w⋅xcp 2.model评估,model的好坏判断(损失函数) 3.model优化,从model集里面挑选出最好的function(梯度下降) 步骤1:随机选取一个 w0 步骤2:计算微分,也就是当前的斜率,根据斜率来判定移动的方向 大于0向右移动(增加w)

DeSerANT的博客 354

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

李宏毅机器学习 <Datawhale task2学习笔记>

文章目录回归(Regression)一,模型假设二,模型评估请添加图片描述三,模型优化具体步骤总结 回归(Regression) 一,模型假设 有很多因素会决定我们想要的问题的答案。因此我们想要找到一个function,输入已知的影响因素的值(特征input),输出我们想要的数值output。 例:recommendation(ytb,tiktok,etc),self-driving car, stock market forecast… 再例:Combat Power of a pokemon! (由

Isyma的博客 361

李宏毅机器学习笔记_task2_回归

回归 回归定义 回归即是输入特征,训练机器对目标值的拟合能力,在传统线性回归当中,目标值为数值型变量,有回归变种例如逻辑回归,目标值为分类变量 应用举例 股市预测(Stock market forecast) 输入:过去10年股票的变动、新闻咨询、公司并购咨询等 输出:预测股市明天的平均值 自动驾驶(Self-driving Car) 输入:无人车上的各个sensor的数据,例如路况、测出的车距等 输出:方向盘的角度 商品推荐(Recommendation) 输入:商品A的特性,商品B的特性 输出:购买商品

Ashe_yang的博客 384

【李宏毅机器学习CP21】(task6)卷积神经网络

学习心得/总结 (1)CNN误差反向传播的细节可以参考《深度学习的数学》P200的5.5部分,还没看。 (2)卷积层可通过重复使用卷积核有效地表征局部空间,卷积核(过滤器filterfilterfilter)通过卷积的计算结果(相似度)表示该卷积核和扫描过的图像块的灰色格子部分相吻合的个数——该值越大则说明越符合卷积核的偏好程度。 ——卷积的结果矩阵为特征映射(featurefeaturefeature mapmapmap) (3)说到内积,要和HadamardHadamardHadamard乘积区分,后者

发现问题,并解决问题,批判性思维 1596

【李宏毅机器学习2021】Task02 回归

本系列是针对datawhale《李宏毅机器学习-2022 10月》的学习笔记。本次是对回归的学习总结。本节通过视频学习到回归任务的提出,三个要素,及如何优化。李老师通过层层递进,提出问题解决问题的方式不断打磨方法,从中介绍回归任务的始末,引出深度学习及网络加深伴随的过拟合问题。

QAQterrible的博客 1002

Datawhale十月组队学习--《李宏毅机器学习》--Task02

Datawhale十月组队学习:《李宏毅机器学习》 往期指路    Task01:什么是机器学习 文章目录Datawhale十月组队学习:《李宏毅机器学习》往期指路前言一、回归(Regression)二、使用步骤1.引入库2.读入数据总结 前言   本篇主要对《李宏毅机器学习》中关于【回归】部分的知识记录。 一、回归(Regression)    1、不是模型越复杂越好 2、还需要考虑数据集的大小 3、只考虑CP值是不对的,还要考虑因素,需要重新设置function set 4、过拟合:Regular

可乐的博客 527

《李宏毅机器学习》task1

1.什么是机器学习 2.中心极限定理、正态分布、最大似然估计 3.线性回归loss function推导 4.损失函数和凸函数之间的关系

devcy的博客 316

《李宏毅机器学习》task7

import numpy as np import pandas as pd def cancShannonEnt(dataSet): ''' :param dataSet: dataSet :return: shannonEnt ''' # 计算公式前,注意数据的格式(array) numEntries = len(dataSet) # 获取数据的行数 labe...

devcy的博客 208

DW李宏毅机器学习笔记--Task01-机器学习介绍

文章目录前言一、机器学习介绍1.人工智能、机器学习、深度学习之间的关系2.Hand-crafted rules与Machine learning3.机器学习的思路二、机器学习相关的技术1.监督学习A.回归(Regression)问题分类(Classification)问题Deep Learning2.半监督学习迁移学习无监督学习监督学习中的结构化学习(structured learning)强化学习总结 前言 这是我在Datawhale组队学习李宏毅机器学习的记录,既作为我学习过程中的一些记录,也供同好们

StarryPilgrim 449

《李宏毅机器学习》学习笔记 - Task01 机器学习介绍

目录Task01 机器学习介绍机器学习的概念机器学习任务分类回归(Regression)分类(Classification)聚类(Clustering)结构化学习(Structured Learning)机器学习方法分类监督学习(Supervised Learning)半监督学习(Semi-Supervised Learning)迁移学习(Transfer Learning)无监督学习(Unsupervised Learning)强化学习(Reinforcement Learning) Task01 机器学

weixin_57107764的博客 1283

《李宏毅机器学习》task5

《李宏毅机器学习》task5推导LR损失函数(1)学习LR梯度下降(2)利用代码描述梯度下降(选做)(3)Softmax原理(4)softmax损失函数(5)softmax梯度下降(6)参考文献 推导LR损失函数(1) 假定: LR逻辑回归假设样本服从泊松0–1分布,因此p(y|x)表达式: 求最大似然估计: 进而求最大对数似然估计: 损失函数: 损失函数表征预测值与真实值之间的差异程度...

devcy的博客 436
上一篇: 《李宏毅机器学习》task1
下一篇: 《李宏毅机器学习》task3
程序员椰子橙
博客等级 码龄9年 46粉丝 163原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值