


Hello 我是方才,8人后端研发leader、6年后端经验、3年团队管理&架构经验。
专注于分享成体系的编程知识、职场经验、个人成长历程等!
文末,方才送你一份优质的技术资料,记得领取哟!
Hello,我是方才,上一篇和大家分享了方才工作 7 年总结出来的数据库表设计方法论,有粉丝反馈说期望看到一个完整的实践和示例,今天他来了。
全文很干,每一个步骤都是核心内容,看到最后,我相信对你一定可以回答面试官的这个问题。
背景介绍
今天方才就以财务系统的科目余额相关需求为例,给大家展示下在实际的企业级项目中,如何应用该方法论进行数据库表结构设计。
通过这个示例,我相信大家会发现业务需求分析和技术方案的设计才是表结构设计的关键,最终关于表结构和索引的设计是可以通过参考人家的经验贴快速掌握的,但业务分析能力和技术方案设计能力,需要长期的刻意练习以及在业务领域的深耕才能有所成就。
步骤1:需求分析
方才想再次强调一下:技术是为业务服务的,所以对业务需求的分析是最最最重要的,只有理解了需求,才有可能设计出合适的技术方案,从而设计出相对最优的表结构。
先看方法论中关于需求分析的可选维度:
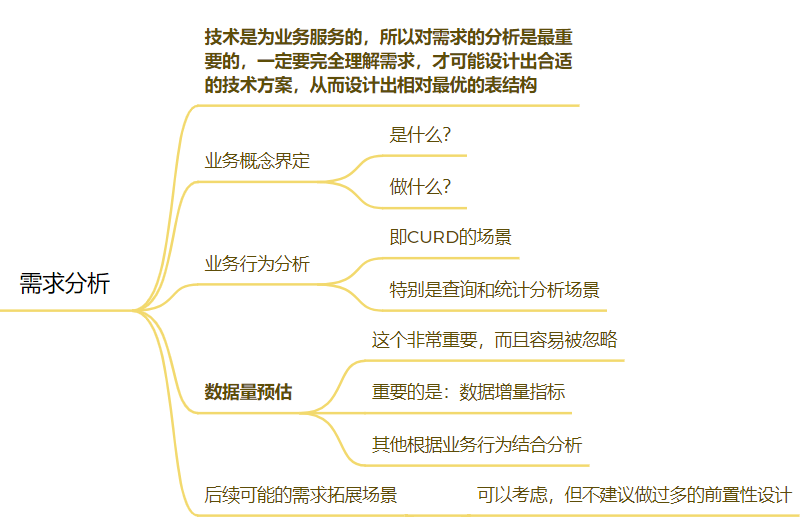
接下来参考上图,我们开始对财务系统的科目余额相关需求进行分析(考虑大家可能没有接触过财务系统,以下分析更多会用大白话解释,而不是专业的业务概念去解释):
unsetunset业务概念unsetunset
相关的概念如下:
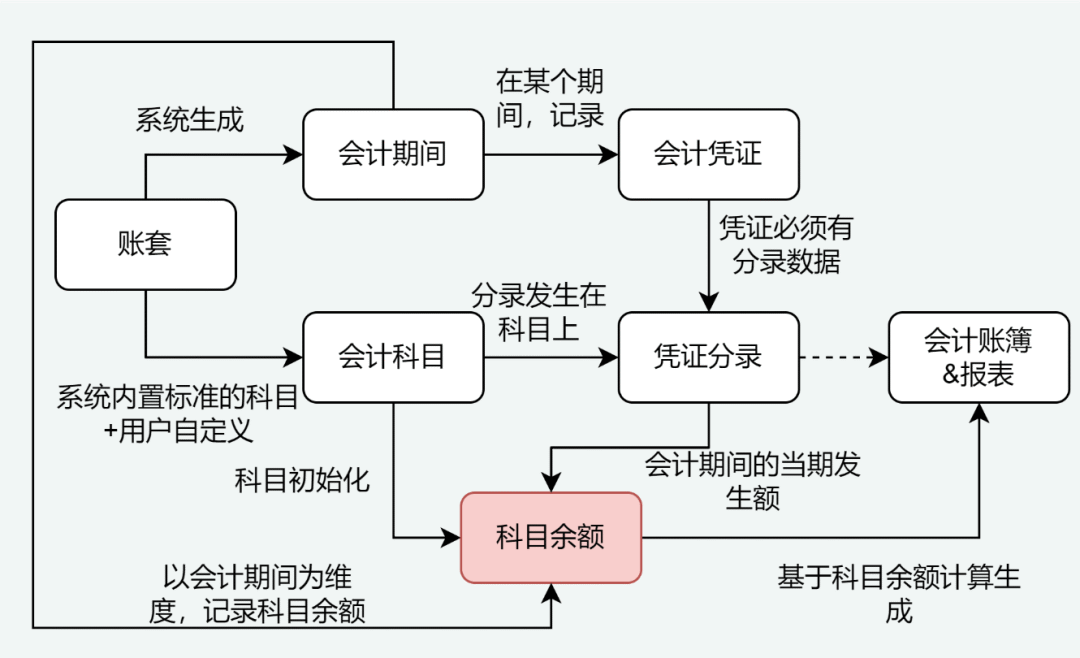
账套:指一个独立的会计核算单位的全部账簿体系,用于记录企业或组织的财务信息;
会计科目:可以简单理解为就是一个具有层级关系的分类类目;
科目余额:是某个会计科目在某一特定会计期间上的金额,通常包括期初余额、本期增加额、本期减少额和期末余额;就好比个人银行账户,按月记账,会有一个月初余额、本月收入支出、月末余额一样。
会计期间:记账的时间周期,可以简单理解为每个月就是一个会计期间,每年就有12个会计期间;
会计凭证:发生在会计科目上的财务行为记录,就好比个人银行账户的一个账单记录,记录了收支双方的信息、发生金额、备注等;
凭证分录:多个凭证分录组成一个完整的会计凭证,是具体发生在某个会计科目上的财务行为记录;
会计账簿:以科目余额和会计凭证数据为依据,形成的数据报表;
会计报表:以科目余额和会计凭证数据为依据,形成的数据报表;
unsetunset业务行为unsetunset
和会计科目余额相关的业务行为(其他无关的,方才就省略掉了):
会计科目维护:国家对会计科目有制度约束,标准的会计科目大概有167个左右,同时允许在标准的会计科目下新增下级子科目;
科目初始化:用户去维护记账初期的数据;比如你要开始记账,肯定需要先记录你有哪些账户,每个账户的当前余额有多少;
凭证记录:会实时影响到会计科目的余额;比如你给朋友转账了,那你的账户的余额会减少,你朋友账户的余额会增加;
会计账簿&报表的查询:按会计期间范围,查询对应期间的科目余额数据,并按一定的规则计算得到的报表;
某个会计期间的科目余额:通常包括期初余额(等于上一期的期末)、本期发生额(根据凭证数据计算)和期末余额(根据期初和发生额计算)等等指标;
业务模型如下图(ps:业务概念的分析,是为了后续的技术方案的设计):
unsetunset相关数据量预估unsetunset
理解了业务概念和业务行为后,就需要对相关业务进行数据量预估,这样在设计技术方案时,才能建立有效的评估指标,在本次分析的财务系统的会计科目余额相关的业务,核心的业务数据量情况如下:
账套数:前期5-10w,后期每年100w左右的增量;
会计科目数:以单账套平均300个会计科目为计算,每年在 300*100w = 3 亿的增量;
凭证数:单账套凭证总数平均为1000计算,每年在 1000*100w = 10 亿的增量;
凭证分录数:单个凭证按平均4条分录计算,每年在 10亿*4 =40 亿的增量;
会计期间维度的科目余额数据:若按会计期间维度全量存储,每年 3亿会计科目*12个月 = 36亿的增量(这个就是本文后续讨论分析的点);
ps:数据预估基础指标来源是商务和业务资料的综合分析得出,这里就不细说了。
考虑整体篇幅,后续方才就仅讨论会计期间维度的科目余额的表结构设计。所以只需要关注 会计科目数 10亿 和 凭证分录数 40亿 这两个指标了。
步骤2:拟定技术方案
前提说明:在这个量级的系统设计中,会先有业务架构设计-》应用架构设计&数据架构设计-》部署架构设计,此处讲述的技术方案属于应用架构设计中代码级别的设计。
本文的重点是讲解表结构设计,所以这里先明确一个前提:应用架构已经设计完成,数据库选型为分布式数据库TiDB,不需要分库分表(大家若对海量数据下分布式数据库TiDB的实战经验感兴趣的,可以在评论区告诉方才哟)。
基于上面的前提条件,我们就直接开始拟定关于会计科目余额计算相关的技术方案了。整个思路如下:
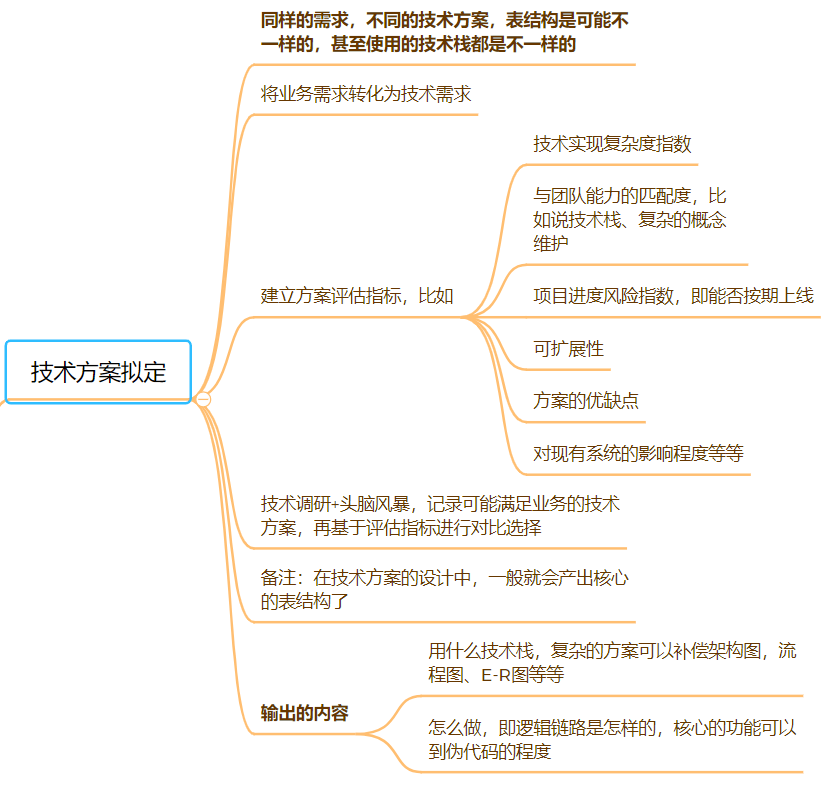
结合之前的业务分析,会计科目余额相关的依赖如下:
会计科目余额基于 科目初始化数据+会计凭证&分录数据计算生成;
会计报表&会计账簿 是基于科目余额数据进行计算生成;等价替换下,也可以直接基于 科目初始化数据+会计凭证&分录数据计算生成;
所以整个方案的关键就是:
会计科目余额数据是否需要落库;
若需要落库,那落库的时机和落库的指标字段有哪些;
不同的方案,对应的会计报表&会计账簿生成逻辑是怎样的。
经过头脑风暴,拟定3个可选方案(ps:这里更多是感知整个分析的过程,对于方案的具体的内容和逻辑,方才这里做了省略):
方案1:会计科目余额数据不落库,只是一个逻辑概念,通过接口基于科目初始化数据+会计凭证&分录数据实时计算生成。
方案2:会计科目余额数据按会计期间维度,在凭证数据更新时,记录所有会计科目的所有指标;会计报表&账簿的生成直接查询需要的数据即可;
方案3:会计科目余额数据按会计期间维度仅保存凭证分录的会计科目+本期发生额相关的指标,其他指标根据 科目初始化数据 + 会计期间维度的本期发生额 计算得来;
方案的指标对比:
评估指标 | 方案1 | 方案2 | 方案3 |
|---|---|---|---|
实现复杂度 | 本质都一样,均是根据 科目初始化数据+会计凭证&分录数据计算,区别就是中间结果是否落库 | 本质都一样 | 本质都一样 |
可能存在的性能点 | 跨期间查询时,需要查询对应期间的所有凭证分录数据,按平均值计算,需要查询4000条数据,但考虑峰值,可能会涉及查询到10万级别的数据在内存中计算的情况,可能会导致应用内存溢出或数据库压力过大拖垮整个系统。 | 科目余额数据更新频繁 ,每次有凭证更新,均需要更新对应层级树的所有的指标;同时会计科目余额表数据量会达到每年 36亿级别,对数据库资源的需求更大,且数据量上去后查询压力较大。 | 若所有科目在每个会计期间均有凭证发生,会和方案2存在同样的问题,但这几乎不可能。 |
可扩展性:以指标公式更新为场景 | 仅需要更新代码,无侵入 | 更新代码,极端情况需要重算 36亿级别的数据,同时因为记录是全量指标,发生概率比较大 | 更新代码,极端了情况需要重算7亿级别的数据,相对而言指标很少,发生概率是比较小的。 |
线上数据分析 | 数据未入库,若用户反馈数据异常,分析难度较大。需提供单独的逻辑将数据临时落库,便于分析。 | 所见即所得,用户看到的数据,数据库都有,可以快速分析出是什么指标的问题 | 指标落库不全,若用户反馈数据异常,分析难度较大。需提供单独的逻辑将数据临时落库,便于分析。 |
通过多维度对方案的对比,最终确定使用方案3进行落地实施(通过对比,可以感知到不同的方案,会计科目余额表的结构是不一样的,甚至都不需要有)。
步骤3:表结构设计
有了确定的技术方案后,就进入到了完整的表结构设计阶段。
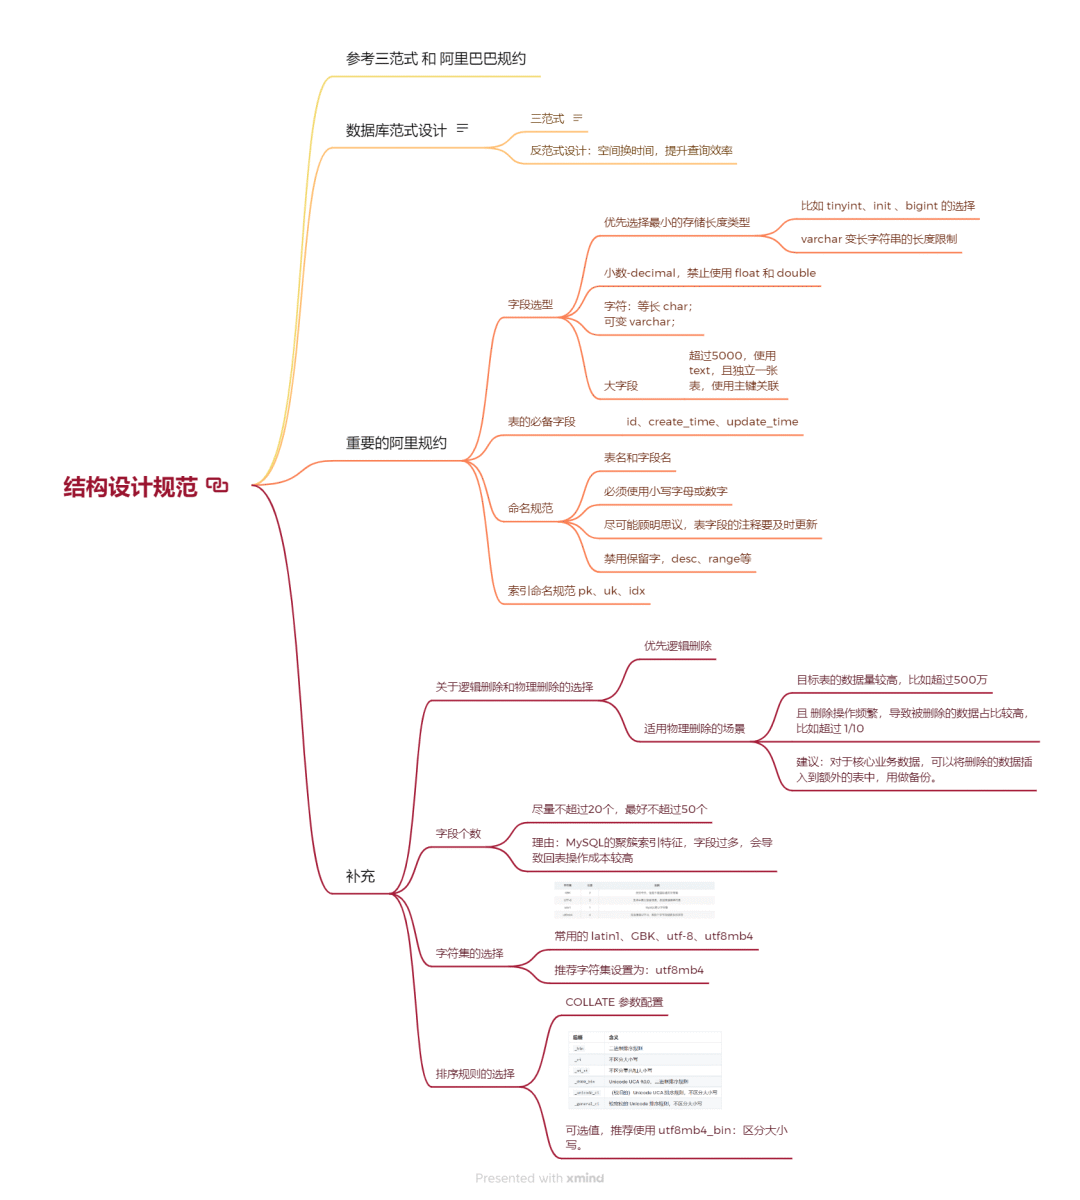
主要思路是参考数据库范式&反范式设计,结合阿里巴巴规约,以及历史经验的总结,完成从表名、字段名、字段类型的定义。
unsetunset先看完整的DDLunsetunset
先简单看下完整的表结构,然后我们再完整讲解表结构设计一些技巧。
CREATE TABLE`kjkm_fse` (
`id`bigint(20) UNSIGNEDNOTNULL AUTO_INCREMENT COMMENT'主键',
`zt_id`bigint(20) UNSIGNEDNOTNULLCOMMENT'账套id',
`kjkm_id`bigint(20) UNSIGNEDNOTNULLCOMMENT'会计科目id',
`kjkm_bm`varchar(64) NOTNULLCOMMENT'会计科目编码-冗余字段,便于查询',
`kjqj_id`bigint(20) UNSIGNEDNOTNULLCOMMENT'会计期间id',
`ljjf_je`decimal(22,2) NOTNULLDEFAULT'0.00'COMMENT'本期借方发生额',
`ljdf_je`decimal(22,2) NOTNULLDEFAULT'0.00'COMMENT'本期贷方发生额',
`bqs_je`decimal(22,2) NOTNULLDEFAULT'0.00'COMMENT'本期数-金额(借-贷,结合科目方向计算得到)',
`bqs_sl`decimal(22,2) NOTNULLDEFAULT'0.00'COMMENT'本期数-数量',
`created_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMPCOMMENT'创建时间',
`updated_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMPONUPDATECURRENT_TIMESTAMPCOMMENT'更新时间',
`create_user_id`varchar(32) NOTNULLCOMMENT'创建人用户id',
`update_user_id`varchar(32) NOTNULLCOMMENT'更新人用户id',
  PRIMARY KEY (`id`,`zt_id`),
UNIQUEKEY`uk_zt_kjqj_kjkm_id` (`zt_id`,`kjqj_id`,`kjkm_id`)
) ENGINE=InnoDBDEFAULTCHARSET=utf8mb4 COLLATE=utf8mb4_bin AUTO_INCREMENT=1COMMENT='会计科目-发生额'
PARTITIONBYHASH (`zt_id`) PARTITIONS3;
unsetunset数据库范式设计unsetunset
三范式
第一范式(1NF):确保表中的每一列都是不可再分的原子数据项。例如,
ljjf_je(本期借方发生额)和ljdf_je(本期贷方发生额)分别独立存储,每一列都是不可分割的原子数据项。第二范式(2NF):在满足1NF的基础上,确保表中的非主属性完全依赖于主键(这个主键大家可以理解为业务主键,而非ID)。通过将
zt_id(账套ID)、kjqj_id(会计期间ID)和kjkm_id(会计科目ID)组合成唯一键,确保了表中的数据与这些关键字段的强关联性。第三范式(3NF):在满足2NF的基础上,确保表中的非主属性之间不存在传递依赖关系。在上面的表里,冗余了 kjkm_bm 字段,不符合该范式。
反范式设计
反范式设计(Denormalization)是数据库设计中一种有意引入数据冗余的技术,旨在提高查询性能。
注意点:反范式设计会增加数据存储和数据的一致性维护成本。
适用于:冗余存储的字段需要用于查询,且更新频率较低或是通过预计算得到的扩展字段等情况。
例如,本表中同时存储了
kjkm_id(会计科目Id) 和kjkm_bm(会计科目编码)。这种设计虽然增加了存储空间,但减少了查询时的连表操作或计算成本,能提高查询性能。例如,本表的
bqs_je= ljjf_je - ljdf_je是通过预计算得到的扩展字段,也是为了满足查询需求。
unsetunset命名规范unsetunset
包括表名和字段名,参考以下几点:
必须使用小写字母或数字,使用下划线分割;
尽可能顾明思议,表字段的注释要及时更新,特别是枚举字段;
禁用保留字,如 desc、range、match、delayed 等;
**索引命名规范,名称前缀
uk_/ idx_**:唯一索引名为uk_字段名;普通索引名则为idx_字段名;
命名规范还是很好理解的,大家日常应该是使用英语单词更多点,财务这块名词太长,所以方才使用的是中文的首字母缩写(只要整个库保持一个风格,可读性也是很高的)。
unsetunset必备字段unsetunset
参考阿里规约,建议表的必备字段有3个:id, create_time, update_time。
说明:其中 id 必为主键,类型为 bigint unsigned、单表时自增、步长为 1。create_time, update_time 的类型均为 datetime 类型,前者现在时表示主动式创建,后者过去分词表示被动式更新。
这个可以根据实际情况,自己去约定,比如方才建的表就有5个必备的字段:
`id` bigint(20) UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '主键',
`created_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMPCOMMENT'创建时间',
`updated_time` datetime NOTNULLDEFAULTCURRENT_TIMESTAMPONUPDATECURRENT_TIMESTAMPCOMMENT'更新时间',
`create_user_id`varchar(32) NOTNULLCOMMENT'创建人用户id',
`update_user_id`varchar(32) NOTNULLCOMMENT'更新人用户id',
注意:
updated_time字段要有ON UPDATE CURRENT_TIMESTAMP属性,该属性用于指定当表中的记录被更新时,该字段的值会自动更新为当前的时间戳(CURRENT_TIMESTAMP),这个特性通常用于记录数据最后被修改的时间。create_user_id是varchar(32)类型,在此处是为了兼容历史数据,一般情况也应该是bigint(20) UNSIGNED。
unsetunset字段选型unsetunset
字段类型要尽量和实际类型保持一致,然后优先选择最小的存储长度类型即可。
整数类型
参考MySQL官网:https://dev.mysql.com/doc/refman/8.4/en/integer-types.html 。
不同整数类型的存储大小和取值范围:
Type | Storage (Bytes) | Minimum Value Signed | Minimum Value Unsigned | Maximum Value Signed | Maximum Value Unsigned |
|---|---|---|---|---|---|
TINYINT | 1 | -128 | 0 | 127 | 255 |
SMALLINT | 2 | -32768 | 0 | 32767 | 65535 |
MEDIUMINT | 3 | -8388608 | 0 | 8388607 | 16777215 |
INT | 4 | -2147483648 | 0 | 2147483647 | 4294967295 |
BIGINT | 8 | -2^63 | 0 | 2^63-1 | 2^64-1 |
按最小存储长度原则:
枚举类型的字段一般使用
TINYINT;注意字段可能的上下限,避免溢出,比如国民级软件的点赞数这种,就建议使用
BIGINT(上次抖音出现点赞数为负数,就是因为int溢出了);表的主键,明确数据量会持续增加,且无上限,就建议使用
BIGINT;若是字典维护表这种内部使用的,主键就可以用INT。
补充:关于整数类型在DDL中定义时括号中的数字的含义是显示宽度:比如 int(11) 中的 (11) 是一个 显示宽度(主要用于 ZEROFILL 选项时,指定数字显示时前面填充的零的数量),而不是数据类型的实际存储长度或精度,整数类型的存储长度是固定了的,int类型的储空间始终是 4 字节。
小数类型(比如金额字段)
对于小数类型,建议遵循阿里巴巴规约,使用decimal类型(如decimal(22,2)),禁止使用float和double,以确保数据的精确性。
注意: DECIMAL(5,2) 表示能存储任何具有 5 位数字和 2 位小数的值,值范围为 -999.99 到 999.99。
当然对于金额字段的存储,一般有两种方案,一种是使用 decimal类型 保留2位小数,单位一般为元及以上;另一种就是使用BIGINT类型,将单位转为分,进行存储。
字符串类型
MySQL中字符串类型,包括 CHAR、VARCHAR、BINARY、VARBINARY、BLOB、TEXT、ENUM 以及 SET。这里方才就只讲几个重点了:
CHAR(M)是定长字符串。CHAR列的长度固定为创建表时声明的长度。M 表示列长度(是字符的个数,不是字节的个数),当存储字符长度不足M时,会用空格右填充到指定长度。适用于存储枚举code等场景。VARCHAR是变长字符串。M 表示最大列长度(字符的最大个数)。VARCHAR的空间占用大小不得超过 65535 字节。在选择VARCHAR长度时,应当根据最长的行的大小和使用的字符集确定。是最常用的字符串类型。
下表是单个字符占用的字节数,以及
VARCHAR列长度的取值范围(关于字符集后续会讲):
字符集 | 单个字符字节数 | VARCHAR 最大列长度的取值范围 |
|---|---|---|
ascii | 1 | (0, 65535] |
latin1 | 1 | (0, 65535] |
binary | 1 | (0, 65535] |
utf8 | 3 | (0, 21845] |
utf8mb4 | 4 | (0, 16383] |
也就是说字符集为utf8mb4的 varchar类型的最大长度只能是 16383,若超过,你建表时会报错:
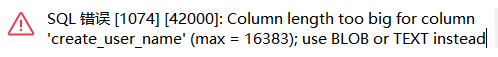
如果你需要存储更大字节的内容,就可以使用``LONGTEXT
类型,最大列长度为 4,294,967,295 字节;或者 使用二进制大文件LONGBLOB` 类型,最大列长度为 4,294,967,295 字节。注意:对于字符串字段,若长度超过5000,就建议使用
text类型,且独立出来一张表,用主键来对应,避免影响其它字段索引效率(后续讲解了聚簇索引就可以理解为什么了)。
在我们当前这个示例中,使用varchar即可:
`kjkm_bm` varchar(64) NOT NULL COMMENT '会计科目编码-冗余字段,便于查询',日期和时间类型
MySQL 的日期和时间类型,包括 DATE、TIME、DATETIME、TIMESTAMP 以及 YEAR。
DATE类型只包含日期部分,不包含时间部分。DATE类型的格式为YYYY-MM-DD,支持的范围是0000-01-01到9999-12-31。TIME类型的格式为HH:MM:SS[.fraction],支持的范围是-838:59:59.000000到838:59:59.000000。DATETIME类型是日期和时间的组合,格式为YYYY-MM-DD HH:MM:SS[.fraction]。支持的范围是0000-01-01 00:00:00.000000到9999-12-31 23:59:59.999999。TIMESTAMP类型是日期和时间的组合,支持的范围是 UTC 时间从1970-01-01 00:00:01.000000到2038-01-19 03:14:07.999999。注意:范围上限问题:
TIMESTAMP数据类型受 2038 年问题的影响。如果存储的值大于 2038,需使用DATETIME类型。时区的问题:当存储
TIMESTAMP时,MySQL 会将当前时区的TIMESTAMP值转换为 UTC 时区。当读取TIMESTAMP时,MySQL 将存储的TIMESTAMP值从 UTC 时区转换为当前时区(DATETIME` 不会这样处理)。
YEAR类型的格式为YYYY,支持的值范围是1901到2155,也支持零值0000。
所以,方才建议,日期和时间类型字段,优先选用DATETIME,同时要合理利用其自动初始化或更新为当前时间的特性,比如说创建时间和更新时间:
`created_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `updated_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间',
unsetunset逻辑删除与物理删除unsetunset
什么是物理删除?什么是逻辑删除?
物理删除:把数据从硬盘中删除,可释放存储空间
逻辑删除:给数据添加一个字段,比如
is_deleted,以标记该数据已经逻辑删除。
根据方才的经验,建议是优先采用逻辑删除。更方便去最终一些问题或者手动回滚数据等。
但若满足以下场景,是更适合使用物理删除的:
目标表的数据量较高,比如超过500万;
且删除操作频繁,导致被删除的数据占比较高,比如超过 1/10;
建议:对于核心业务数据,且无法通过其他数据派生而来,可以将删除的数据插入到额外的表中,用做备份。
这个场景下,无用的数据太多,会影响到查询和更新的效率了。
而刚好,会计科目余额表就符合这个场景,数据量超10亿,凭证更新会导致数据的频繁覆盖写入,同时本身数据就是可以通过期初数据+凭证数据计算得来,所以可以看到kjkm_fse这个表是没有is_deleted字段的。
unsetunset字段个数unsetunset
个人建议表中字段尽量不超过20个,最多不超过50个。
理由是:因为MySQL的聚簇索引特征,过多的字段会导致回表操作成本过高,影响查询性能。
unsetunset字符集的选择unsetunset
字符集影响的是字符串类型的存储,包括能否存储以及一个字符对应的字节长度。
MySQL 支持的字符集有utf8、utf8mb4、GBK、latin1等。
latin1:MySQL 默认字符集,1 个字节长度,所以容易出现乱码问题;
GBK :支持中文,但是不支持国际通用字符集,2 个字节长度;
utf8:支持中英文混合场景,国际通过,3 个字节长度;
utf8mb4: 完全兼容 utf8,4 个字节长度,可存储更多的字符;
方才推荐字符集优先选择utf8mb4,支持更广泛的字符集范围,通过建表语句 CHARSET=utf8mb4可以指定。
ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin AUTO_INCREMENT=1 COMMENT='会计科目-发生额'
PARTITION BY HASH (`zt_id`) PARTITIONS 3;
unsetunset排序规则的选择unsetunset
排序规则会影响对字符类型的排序以及查询,是非常重要的,一不小心就容易出现bug,且很难定位。
一个字符集可以有多种排序规则。排序规则的命名格式为 <character_set>_<collation_properties>。例如,utf8mb4 字符集有一个名为 utf8mb4_bin 的排序规则,它是 utf8mb4 字符集的二进制排序规则。下表是常见字符集和排序规则的后缀和含义:
后缀 | 含义 |
|---|---|
_bin | 二进制排序规则,区分大小写 |
_ci | 不区分大小写 |
_ai_ci | 不区分重音和大小写 |
_0900_bin | Unicode UCA 9.0.0,二进制排序规则 |
_unicode_ci | (较旧的)Unicode UCA 排序规则,不区分大小写 |
_general_ci | 较宽松的 Unicode 排序规则,不区分大小写 |
简单看两个示例就会理解深刻了。
下面这个示例,通过COLLATE=utf8mb4_general_ci 和COLLATE=utf8mb4_bin分别设置不同的排序规则:
CREATE TABLE`fc_test` (
`id`bigint(20) UNSIGNEDNOTNULL AUTO_INCREMENT COMMENT'主键',
`mc`varchar(64) NOTNULLCOMMENT'名称',
  PRIMARY KEY (`id`)
) ENGINE=InnoDBDEFAULTCHARSET=utf8mb4 COLLATE=utf8mb4_general_ci COMMENT='不区分大小的测试';

INSERTINTO fc_test( mc) VALUES('fangcaicoding'),('Fangcaicoding'),('cdoing');


CREATETABLE`fc_test2` (
`id`bigint(20) UNSIGNEDNOTNULL AUTO_INCREMENT COMMENT'主键',
`mc`varchar(64) NOTNULLCOMMENT'名称',
  PRIMARY KEY (`id`)
) ENGINE=InnoDBDEFAULTCHARSET=utf8mb4 COLLATE=utf8mb4_bin COMMENT='区分大小的测试';

INSERTINTO fc_test2
( mc)
VALUES('fangcaicoding'),('Fangcaicoding'),('cdoing');
查询和排序下:
-- 不区分大小写
select * from fc_test where mc = "Fangcaicoding" order by mc;
select * from fc_test order by mc desc;
-- 区分大小写
select * from fc_test2 where mc = "Fangcaicoding" order by mc;
select * from fc_test order by mc desc;
运行截图如下:
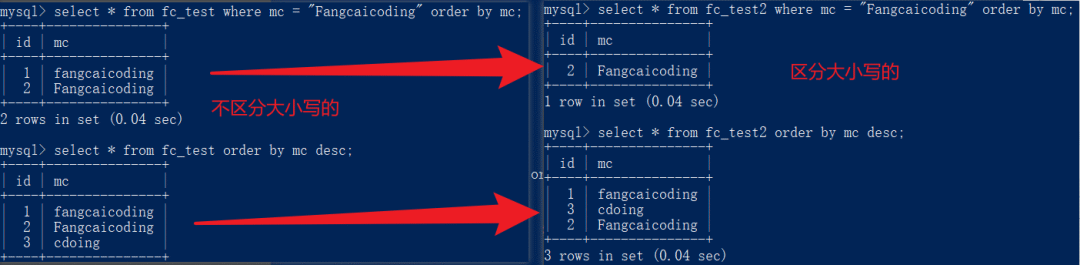
通过这个示例,我想大家都一定理解了字符集的排序规则的影响点了。
一般情况,方才推荐排序规则优先选择utf8mb4_bin,通过COLLATE=utf8mb4_bin语句设置,区分大小写,确保数据的准确性和一致性。
步骤4:索引的设计
关于索引,方才发现很多初中级程序员都没有形成一个方法论。很容易走两个极端,要么是除了主键没有其他任何索引,要么就是索引一大堆。
方才结合自己针对数十亿表的索引优化经验,总结如下:
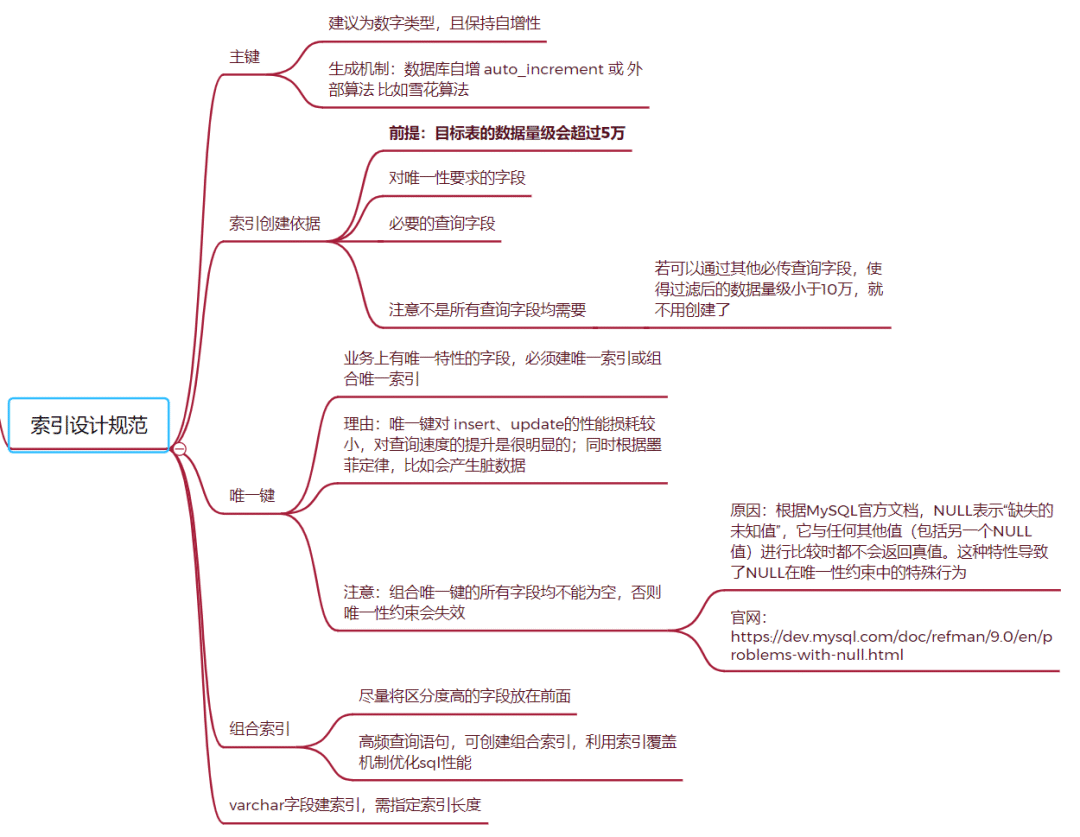
结合上面的脑图,针对kjkm_fse这个表,我们来一一分析下。
unsetunset关于主键unsetunset
方才建议所有的表均应该有主键,优先为数字类型,且保持自增性(若是辅助表,主键可以直接使用主表的)。
常用的主键生成机制有:
数据库自增 auto_increment ;
基于外部算法代码实现:比如雪花算法、百度Uid-Generator、美团Leaf等;
在kjkm_fse表是有自增id的,但因为数据量较大,使用了分区表(关于TiDB的分区表,大家若有兴趣,可以在评论区告诉方才哟),分区字段按规范需要作为主键的组合字段之一,所以该表的主键如下:
-- 省略了无效内容
CREATE TABLE `kjkm_fse` (
  `id` bigint(20) UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '主键'
  PRIMARY KEY (`id`,`zt_id`)
) PARTITION BY HASH (`zt_id`) PARTITIONS 3;
补充:如果一个表没有显示定义主键:
MySQL的 InnoDB 引擎会尝试使用第一个非空的唯一索引(
NOT NULL和UNIQUE INDEX)作为聚簇索引。如果没有合适的唯一索引,InnoDB 会自动生成一个隐藏的ROW_ID列作为聚簇索引,这个隐藏列是递增的。TiDB数据库,如果表没有主键,TiDB 会自动生成一个隐式的
_tidb_rowid列作为行 ID。这个列的值是单调递增的。
unsetunset索引创建依据unsetunset
除了主键建议均有,其他索引的创建,是需要跟进实际情况进行判断的,方才总结规则如下:
前提:目标表的数据量级会超过10万;
对唯一性要求的字段;
必要的查询字段;
索引不是越多越好,过多的索引,会影响数据更新效率,同时会导致sql的自动优化出现非预期行为;
注意不是所有查询字段均需要:若可以通过其他必传查询字段,使得过滤后的数据量级小于10万,就可以不用创建;
unsetunset唯一索引unsetunset
方才建议,业务上有唯一特性的字段,必须建唯一索引或组合唯一索引:
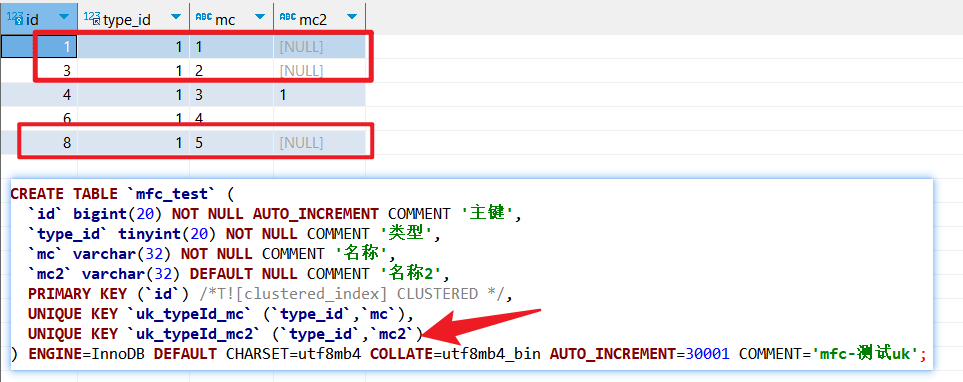
理由:唯一键对 insert、update的性能损耗较小,对查询速度的提升是很明显的;同时根据墨菲定律,比如会产生脏数据
一定要注意:组合唯一键的所有字段均不能为空,否则可能导致唯一键约束失效。
原因:根据MySQL官方文档,NULL表示“缺失的未知值”,它与任何其他值(包括另一个NULL值)进行比较时都不会返回真值。这种特性导致了NULL在唯一性约束中的特殊行为。
效果直接看下面的示例截图就知道了,
uk_typeId_mc2是没有锁住的,数据1-3-8在逻辑上都是重复的:
回到kjkm_fse这个表,在业务上,就要求一个账套下,一个会计期间,同一个科目的余额一定是只能有一条数据,所以就创建了组合唯一索引:
UNIQUE KEY `uk_zt_kjqj_kjkm_id` (`zt_id`,`kjqj_id`,`kjkm_id`)ps:业务上是有根据 kjkm_bm会计科目编码查询需求的,但这里方才并没有针对该字段创建索引,是因为什么呢?可以参考索引的创建依据说明,业务上明确所有的查询,一定都会携带zt_id账套id参数,根据该参数,已经可以将数据量过滤至5000以内了,就没有必要再创建了。
unsetunset组合索引unsetunset
关于组合索引,方才就提两个技巧:
尽量将区分度高的字段放在前面(后续分享了B+树索引后,就可以理解了);
高频查询语句,可创建组合索引,利用索引覆盖机制优化sql性能。
unsetunset普通索引unsetunset
关于普通索引的创建,就优先参考上面的内容,有必要再创建。
需要注意的是,参考阿里规约,在 varchar 字段上建立索引时,必须指定索引长度,没必要对全字段建立索引,根据实际文本区分度决定索引长度。(防止字段太长,索引内容过大,导致其他问题)。
说明:索引的长度与区分度是一对矛盾体,一般对字符串类型数据,长度为 20 的索引,区分度会高达 90%以上,可以使用 count(distinct left(列名, 索引长度))/count(*)的区分度来确定。
小结
我相信通过这个示例,大家对如何进行表结构设计,都有了自己的理解,也欢迎在评论区交流哟。
原创不易,如果对你有所帮助,记得帮方才点个赞、点个爱心,来个评论,这对方才很重要。
ps:本文的思维导图xmind源文件,都在资料库了,可以直接扫码领取。
unsetunset交流群unsetunset
茫茫人海,方才刚好写了这篇博客,而优秀的你又刚好看到且点了个赞。
相遇即是缘分,方才送你一份优质的资料,也可备注加群,方才拉你进入优质的技术交流群。

 263


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


