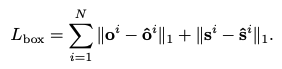[Intensive Reading]目标检测(object detection)系列(十三)CenterNet:no Anchor,no NMS

ML - 下采样&过采样 文章目录使用场景SMOTE 数据生成策略imblearn安装使用 使用场景 在样本不均衡的情况下,模型可能会一边倒。 比如,30w个正样本,500 个负样本。 因此提出两种解决方案: 下采样 Down Sampling 只从正样本中随机抽取 500个; 比例均衡了,但是只利用了一小部分数据。 过采样,Over Sampling 对数据进行变换,制造负样本(数据生成)。 策略:SMOTE算法 SMOTE 数据生成策略 对于少数类的每一个样本x,以欧式距离为标准。计算它到 少数类样本级中所有样本的距 阅读详情

在这里插入图片描述

目标检测系列:
目标检测(object detection)系列(一) R-CNN:CNN目标检测的开山之作
目标检测(object detection)系列(二) SPP-Net:让卷积计算可以共享
目标检测(object detection)系列(三) Fast R-CNN:end-to-end的愉快训练
目标检测(object detection)系列(四) Faster R-CNN:有RPN的Fast R-CNN
目标检测(object detection)系列(五) YOLO:目标检测的另一种打开方式
目标检测(object detection)系列(六) SSD:兼顾效率和准确性
目标检测(object detection)系列(七) R-FCN:位置敏感的Faster R-CNN
目标检测(object detection)系列(八) YOLOv2:更好,更快,更强
目标检测(object detection)系列(九) YOLOv3:取百家所长成一家之言
目标检测(object detection)系列(十) FPN:用特征金字塔引入多尺度
目标检测(object detection)系列(十一) RetinaNet:one-stage检测器巅峰之作
目标检测(object detection)系列(十二) CornerNet:anchor free的开端
目标检测(object detection)系列(十三) CenterNet:no Anchor,no NMS
目标检测(object detection)系列(十四) FCOS:用图像分割处理目标检测

目标检测扩展系列:
目标检测(object detection)扩展系列(一) Selective Search:选择性搜索算法
目标检测(object detection)扩展系列(二) OHEM:在线难例挖掘
目标检测(object detection)扩展系列(三) Faster R-CNN,YOLO,SSD,YOLOv2,YOLOv3在损失函数上的区别

简介

CenterNet的论文是《Objects as Points》,其作者是得克萨斯大学奥斯汀分校的Xingyi Zhou,Xingyi Zhou后续在CenterNet的基础上,将其扩展到多目标跟踪领域,近期工作为CenterTrack。
CenterNet从名字就可以很直观的看出,CenterNet是将目标检测问题看做对于目标中心点的检测,它是继CornerNet之后的又一个Anchor-free方法,它们之间也有比较多的相似之处,区别在于CornerNet是找目标的角点,而CenterNet是找目标的中心点。

CornerNet原理

Motivation

CenterNet的出发点和RetinaNet,CornerNet都是差不多的,对于one-stage的目标检测器,大量的anchor导致正负样本的不平衡,网络训练时loss会被大批量负样本所左右。同时又由于检测器是one-stage的,一旦预设了anchor,没办法二次筛选它。所以RetinaNet提出了Focal loss,在计算损失时弱化负样本的影响。而CornerNet和CenterNet则是直接弃用了anchor,除了上面的原因,还有一个就是anchor的设计是完全先验的,有大量的超参数,比如如何选择尺度,比例,多少个分支等等,每个层放几个等等,每个结构都不一样。

Inference

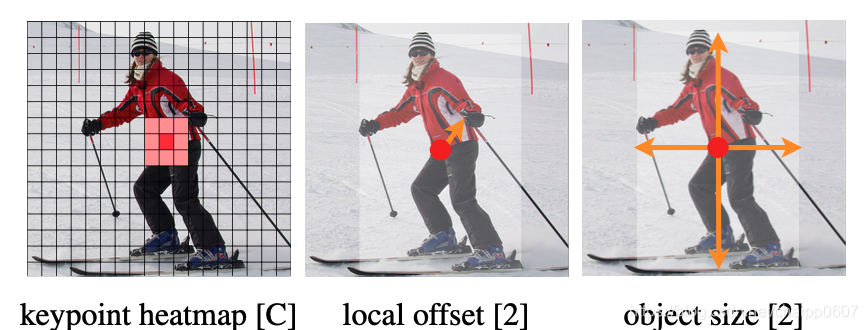
对于一个目标检测任务,一个backbone最后会输出三个分支,分别是Heatmap,Center offset和Box size,如下:

  1. Heatmap: C × H × W C\times H\times W C×H×W,最大值即为目标中心
  2. Center offset: 2 × H × W 2\times H\times W 2×H×W, 预测中心与真值的偏移量
  3. Box size: 2 × H × W 2\times H\times W 2×H×W,每个目标中心处,包含BBox大小的信息

也可以表示为下图的过程,Heatmap作为最核心的输出,表示物体的中心点,而由于下采样造成的不对称,CenterNet使用中心点的offset来修正它,确定中心点后,根据size分支的输出最后确定bbox。
而上面的C,就是目标检测任务的类别数量了,对于COCO就是80,相当于把不同类别的目标放到不同的channel上做。但是除了Heatmap,其余两个分支不需要C倍的通道数量。
在这里插入图片描述
相比于CornerNet,CenterNet的中心点Heatmap极大的简化了算法的复杂程度,因为一个目标用一个heatmap就可以表示出来,不再需要左上角和右下角两张heatmap,也就不涉及判断哪两个角点属于一个目标的问题。
至于CornerNet认为的“目标的中心点不好定义,目标角点更为清晰明确”这个观点,在CNN的拟合能力面前,看起来是不成问题的。

Train

CenterNet对于目标检测的分支有三个,所以对应的损失也是三个,分别是Heatmap损失,offset损失和size损失:

Heatmap loss:
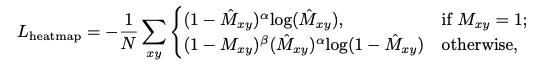
在这里插入图片描述
offset and size loss:
在这里插入图片描述
其中CenterNet的Heatmap loss参考的是CornerNet,包括高斯映射,Focal loss的使用都是这样。大家可以直接看之前的文章,在这里就不重复了,而offset loss也是和CornerNet相似的,只是CornerNet使用的smoothL1,而CenterNet直接用了L1,CornerNet预测了左上角和左下角点,所以不需要再预测size,而CenterNet的size loss和offset loss是差不多的,也是L1。

Other

no NMS

CenterNet的结构是可以不做NMS的,本质上其实也是因为no Anchor,这意味着没有大量的先验预设框,不需要过NMS进行滤除,这让CenterNet的后处理变得比较简单,并且更加接近于end-to-end。

关于下采样

此外还有一个很有意思的地方,centernet主干网络的在设计的时候,下采样倍率普遍比较小,CenterNet的倍率是4,CornerNet的下采样倍率是5,而Anchor base的方法,下采样倍率就要大的多,比如YOLOv3是在16的基础上构建三个scale,分别是8,16,32。
也就是YOLOv3最小的倍率也是CenterNet的2倍,这说明Anchor Free方法越来越接近将目标检测任务抽象成类似图像分割(语义,实例),姿态估计,人脸对齐这样的对于点的回归任务来做,而不是像之前的对Anchor修正的方式。所以Anchor Free需要一个更大尺寸的feature map来支撑这个任务,反而feature map厚度变小了,而Anchor base方法的feature map厚度普遍都比较大。

resnet主干的centernet

centernet同样选择了resnet18和resnet101主干 ,结合上面说到的下采样倍率,就会带来一个问题,怎么让resnet的结构下采样2次,4倍,而不是原来的5次,32倍?
centernet选择在resnet最后接上转置卷积,一共接了三层,每一层stride=2,这样一来原本降下的倍率又被重新升上去,变成了2,4,8,16,32,16,8,4的结构。

人体关键点预测

CenterNet由于其简洁的结构,使它非常容易的扩展到其他任务上,比如人体姿态估计,也可以成为CenterPose,以coco的17点姿态估计为例,CenterPose的输出为:

  1. Center Heatmap: 1 × H × W 1\times H\times W 1×H×W,最大值即为目标中心
  2. Center offset: 2 × H × W 2\times H\times W 2×H×W, 预测中心与真值的偏移量
  3. Center Box size: 2 × H × W 2\times H\times W 2×H×W,每个目标中心处,包含BBox大小的
  4. Center Points offset: 34 × H × W 34\times H\times W 34×H×W,每个关键点,相比于中心点的偏差
  5. Points Heatmap: 17 × H × W 17\times H\times W 17×H×W, 预测中心与真值的偏移量
  6. Points offset: 34 × H × W 34\times H\times W 34×H×W,每个关键点的中心处,与真值得offset

CenterPose一共有六个分支的输出,前四个定义了单类的目标检测任务和17个点关于中心点的偏移,这是一套17个关键点的预测,后两个定义了17点的预测以及它们各自的offset,这又是一套17个关键点的预测,所以CenterPose一共预测了两套关键点,这样冗余的设计是有意义的:
首先直接对于点的预测可信度应该是更高的(分支5),但是它没办法关联成一个person,这个关联要考分支4,因为分支1、2、3定义了一个person,分支4的offset可以估计出17个点,这17个点可以根据距离关联到5、6预测的17个点上,而对于同样5、6没有预测到的点,可以使用4的点来输出。
当然CenterPose的损失就需要有6个了。

CenterNet性能评价
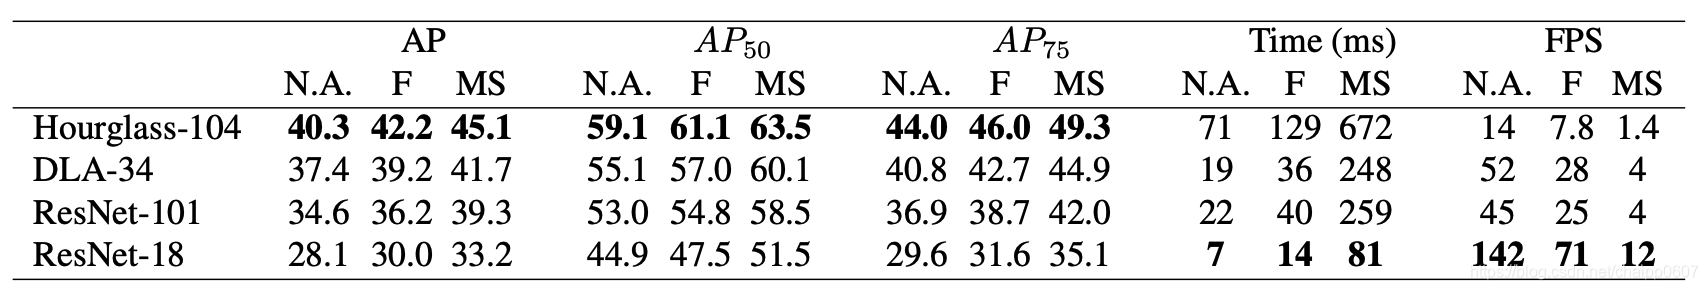
在这里插入图片描述
首先对于backbone的对比,CenterNet也使用了Hourglass-104,由于它比DLA-34大很多,所以效果也在变好,而这里提及的ResNet也不是原版的ResNet结果,而是带了转置卷积和可形变卷积的,这些主干网络其实是在参考语义分割和姿态估计任务。
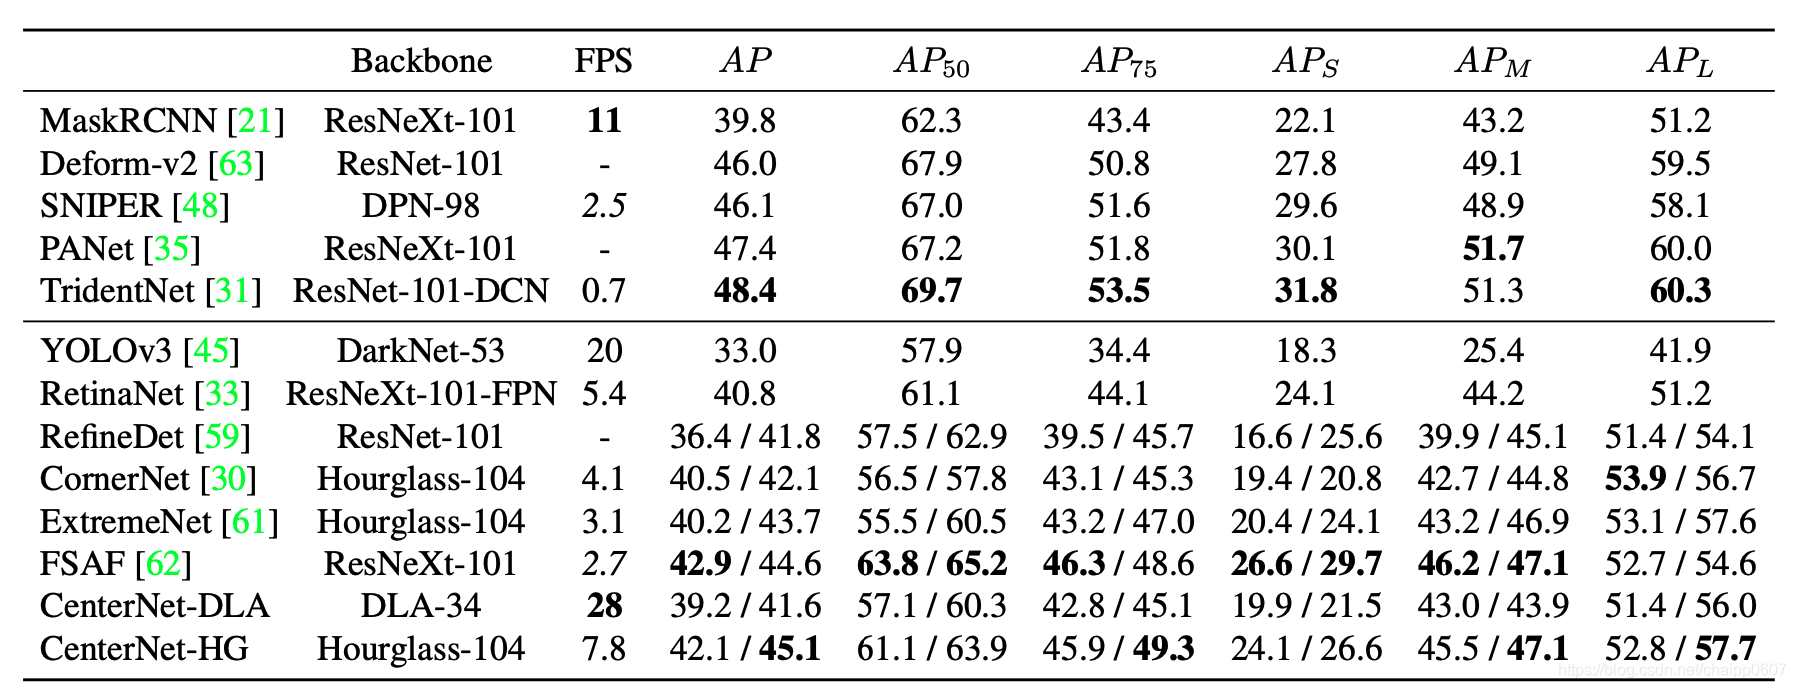
在这里插入图片描述
最后这张表很有说服力,上面是two-stage方法,下面是one-stage方法,其中包括anchor base和anchor free,anchor base里的YOLOv3被拉开了一大截,而另一个Anchor Free的CornerNet,由于是Hourglass-104的backbone,效率也没办法了CenterNet比,所以综合效率和性能,CenterNet还是很不错的。

CenterMulti:基于CenterNet训练的目标检测&人脸对齐&姿态估计模型 CenterMulti代码实现参考以下 Object detection, 3D detection, and pose estimation using center point detection: , Xingyi Zhou, Dequan Wang, Philipp Krähenbühl, 2021.03.16: COCO Model COCO val mAP FPS CenterNet-S4_DLA_8x 42.5 71 CenterNet2_R50_1x 42.9 24 CenterNet2_X101-DCN_2x 49.9 8 CenterNet2_R2-101-DCN-BiFPN_4x+4x_1560_ST 56.1 5 CenterNet2_DLA-BiFPN-P5_24x_ST 49.2 38 2020.04.09: 2020.03.25: > 2019.06.10: 立即下载

相关推荐

某商场G区火灾自动报警与控制系统设计

某商场G区火灾自动报警与控制系统设计 摘要:随着我国经济建设的迅速发展,人民生活水平不断提高,城市用地日益紧张,促使建筑物正朝着高层化、密集化方向发展。高层建筑的特点决定其火灾的危险性和高层建筑的火灾自动报警系统的重要性,一套完整的火灾自动报警及联动控制系统是高层建筑发生火灾时人们生命财产的有利保障,是能否快速准确地发现火情,把火灾扑灭在萌芽状态的关键所在。文章通过消防设计,论述了火灾自动报警及消...

weixin_44026784的博客 5366

centerpose关键点模型训练

其实上述这套设计是有冗余的,首先前4个参数预测了17个点,17点相对于中心点的offset,第5/6个参数相当于又预测了一波17个点,但是这样的冗余设计是有意义的,首先第5个分支直接对于点的预测置信度是更高的,但是它没法关联成一个person,这个关联要依赖分支4,因为1,2,3分支定义了一个person,分支4可以估计17个点,这17个点可以根据距离关联到5,6分支上,同样对于5,6分支没有预测的点,也可以用4分支来输出。get_model是通过config来进行配置,不用配置,直接写在一起。

liguandong 827

从Xilinx FPGA到MIPI DSI LCD屏:手撸代码的实战经验分享

本文分享了使用Xilinx FPGA驱动MIPI DSI LCD屏的实战经验。作者从依赖官方IP核失败,到与底层D-PHY IP缠斗,最终通过手撸代码,直接配置GTY收发器原语并实现完整的D-PHY与DSI协议栈,成功点亮屏幕。文章详细剖析了协议细节、Vivado工具链的调试技巧与避坑指南,为FPGA工程师提供了从理论到实践的宝贵参考。

weixin_29188997的博客 399

中心姿态:单阶段关键点驱动的类别级物体姿态估计

中心姿态:单阶段关键点驱动的类别级物体姿态估计 项目简介 CenterPose 是由林云芝等人在ICRA 2022论文《基于单一RGB图像的单阶段关键点类别级物体姿态估计》中提出的官方实现。该项目是一个单一阶段、基于关键点的方法,用于未知实例的已知类别的三维物体姿态估计。此外,它还扩展到了追踪问题,形成了CenterPoseTrack,如在另一篇论文《基于关键点的类别级物体姿态序列追踪与不确定性...

gitblog_00035的博客 703

《惠普工作站设置BIOS从U盘装系统》

惠普工作站设置BIOS 惠普工作站在做服务器时应用广泛,本文介绍下其BIOS开机自启动设置,附上图片,以供学习参考。 惠普工作站设置BIOS 启动步骤如下: 第一步:根据需要对BIOS进行更改,并保存 1.重启工作站按F10进入BIOS设置(也可以按ESC键选择进入BIOS设置的选项)。 图1 惠普工作站B...

istrangeboy&begin zero的博客 2万+

Redis+QMT实战:如何用Stream模式实现聚宽策略的毫秒级跟单(附完整代码)

本文详细介绍了如何利用Redis Stream模式构建一个低延迟、高可靠的量化交易信号中继系统,实现从聚宽策略到本地QMT的毫秒级跟单。通过对比传统方案,解析了Redis Stream在消息持久化、消费组和显式确认方面的核心优势,并提供了完整的架构设计思路与核心代码实现,帮助量化开发者解决云端策略信号稳定传递至本地实盘的难题。

weixin_29280657的博客 477

CenterPose 项目使用教程

CenterPose 项目使用教程 1. 项目目录结构及介绍 tensorboy/centerpose/ ├── demo/ │ ├── demo.py │ └── ... ├── experiments/ │ ├── dla_34_512x512.yaml │ └── ... ├── images/ │ └── ... ├── lib/ │ ├── __init__.py...

gitblog_00847的博客 450

ubuntu 20.04系统离线安装nfs

ubuntu环境下,离线安装nfs

m0_62464865的博客 2241

ARCore之路:AugmentedFaceExample例子分析

ARCore中人脸追踪的例子分析

ZLX的博客 719

解析AI人工智能领域AI芯片的散热技术

当你用ChatGPT写代码、用AI生成高清图片时,背后的AI芯片可能正在“发高烧”——全球TOP500超算的平均功耗已突破10兆瓦,单颗GPU的峰值功耗超过700W(相当于3台家用空调同时运行)。本文将聚焦AI芯片的散热技术,覆盖从基础原理到前沿方案的全链条解析,帮助读者理解“散热为什么比算力更重要”。

AIGC应用创新大全的博客 935

如何对正射影像DOM(卫星影像、无人机航拍影像)进行拼接、合并以及去黑边(附 Global Mapper Pro 24.0 安装包(中文注册版))

为什么要对正射影像DOM进行拼接?影像去黑边、影像拼接的操作和步骤。

从地图看世界的专栏 4299

【亲测免费】 Isaac ROS Pose Estimation:NVIDIA加速的3D物体姿态估计

Isaac ROS Pose Estimation:NVIDIA加速的3D物体姿态估计 项目介绍 Isaac ROS Pose Estimation 是一个基于深度学习的3D物体姿态估计项目,由NVIDIA开发并开源。该项目包含三个ROS 2包,分别用于预测不同类型物体的姿态。通过GPU加速的DNN推理,这些包能够高效地估计物体的3D姿态,并结合深度信息进行导航或操作。 项目技术分析 1. isa...

gitblog_00499的博客 1682

手把手教你学simulink(8.39)--基于Simulink的步进电机(Stepper Motor)仿真实例

通过这个仿真实例,你可以学习如何使用Simulink构建和仿真步进电机(Stepper Motor)系统。你可以根据实际需求调整模型和参数,进行更复杂的仿真和分析。希望这个例子对你有所帮助,祝你学习愉快!

MHD0815的博客 1052

[Intensive Reading]目标检测(object detection)系列(十四) FCOS:用图像分割处理目标检测

FCOS的paper是《FCOS: Fully Convolutional One-Stage Object Detection》,来自阿德莱德大学沈春华老师团队,作者是田植,其近期的工作时在实例分割方向非常惊艳的BoxInst。 FCOS旨在利用全卷积的思路处理目标检测问题,它是一个anchor free的单阶段检测器,一个很有意思的地方是,FCOS和CenterNet都是在CornerNet之后,但是这它们几乎是同时挂到arxiv上,都在2019年的4月,且相差不到半个月。

zhangxu 2250

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

[Intensive Reading]目标检测(object detection)扩展系列(三) Faster R-CNN,YOLO,SSD,YOLOv2,YOLOv3在损失函数上的区别

Faster R-CNN,YOLO和SSD通用目标检测领域有着奠基一般的作用, 而YOLOv2和YOLOv3由于其灵活易用的特性,在工业界一直很受欢迎,下面这篇文章主要想从损失函数的角度集中讨论下这几个主流框架的区别。

zhangxu 3023

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

目标检测之CenterNet

Objects as Points CenterNet (CVPR2019) 概要 这篇CenterNet算法也是anchor-free类型的目标检测算法,基于点的思想和CornerNet(参考博客:CornerNet笔记)是相似的,方法上做了较大的调整,整体上给人一种非常清爽的感觉,算法思想很朴素、直接,而且重点是在效果和效率之间能取得很好的平衡,提供的几个模型基本上能满足大部分人对效果和效率的需求. CenterNet和CornerNet的对比 预测目标的中心点 CenterNet,从算法名也可以看出

AndyJ的学习之旅 5780

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

center net 用3乘3的maxpool代替传统意义上的nms的原理及实现

center net 是detect objects as points,所以未做nms的feature map 是点的分布,只要得到feature map的各个局部最大的点就是object,用maxpool可以得到feature map的同尺寸的最大的点的feature map2,如果feature map某位置某元素和feature map2的一样就置1否则置0,这样得到一个mask,用mask和feature map对应元素相乘得到最终结果。 import torch.nn as nn import

AliceH1226的博客 1809

【功能性模块】功能性模块: (3)NMS :cpu版和pytorch版

功能性模块:(3)NMS :cpu版和pytorch版 一、模块介绍 如果小伙伴们接触过检测方面的算法,应该对NMS不会很陌生,NMS(Non-Maximum Suppression),即非极大值抑制,特别原理性的LZ就不专门介绍了,网上太多了。总的功能是什么呢?就是我们在做检测的时候,假设画面中有一个人脸,但是由于检测算法的不同,可能会在一个人脸上给出多个满足要求的检测框,我们当然不能把这些框都使用上,就挑选一个最满足要求的检测框就可以了。具体的效果如下图所示: 二、代码实现 1. cpu版本实现 de

Felaim的博客 2098

CenterNet算法代码剖析

针对heatmap、wh、reg分别各自使用一种loss计算方式,最后加权获得最终的loss值。其中heatmap使用FocalLoss计算方式,wh和reg使用L1Loss计算方式。

benben044的专栏 4416

CenterNet解析

论文https://arxiv.org/abs/1904.07850 代码https://github.com/xingyizhou/CenterNet CenterNet是在CornerNet的基础上进行改进,CornerNet是预测目标的一对角点,而CenterNet则是预测目标的中心点和宽高。CornerNet模型最终输出heatmap、offset、embedding三个特征图,分别用于预测角点的位置和类别、下采样坐标取整导致的偏差、将属于同一目标的一对角点组合起来。对应的,C...

00000cj的博客 1246

论文学习笔记-CenterNet(Objects as Points)

『写在前面』 应用最广泛的Anchor-Free 检测模型之一。 文章标题:《Objects as Points》 作者机构:Xingyi Zhou等, UT Austin. 原文链接:https://arxiv.org/abs/1904.07850 相关repo:https://github.com/xingyizhou/CenterNet 目录 摘要 1 介绍 2 相关工...

Custom自定义 2992

CenterNet目标检测模型及CenterFusion融合目标检测模型

CenterNet是一种基于free-anchor的目标检测模型,其继承自CornerNet目标检测模型,可以很容易迁移到例如3D目标检测和人体关键点检测等任务。 CenterFusion是一种通过融合毫米波雷达数据和可见光相机数据进行3D目标检测模型,该模型属于中端融合模型..........................................

BIT_Legend的博客 6504

目标检测论文笔记二:CenterNet《Objects as Points》

论文通过将物体建模成一个物体中心点,使用关键点估计网络来预测物体中心并回归一系列物体属性(长宽高等等)。并且相比于基于anchor的物体检测器,CenterNet 更简单、更快、更准确。 网络的整个运行流程为:在训练时,先将图像送入全卷积神经网络中生成热图,热图中的峰值点就是物体的中心点,每一个峰值点的图像特征用于预测物体框的属性。在预测时,仅为简单的网络前向过程,没有NMS作为后处理。 作者认为CenterNet与onestage的基于anchor的目标检测方法十分接近,但是却有几...

SanJin_Young的博客 1042

HigherHRnet/DEKR骨骼关键点检测笔记:heatmap和offset理解

本文是对HigherHRnet/DEKR骨骼关键点检测项目代码阅读后的笔记。 Github:https://github.com/HRNet/DEKR 论文:https://arxiv.org/abs/2104.02300 HigherHRnet/DEKR骨骼关键点检测是MIT提出一种新颖的bottom-up方法,并且在COCO和Crowdpose中达到了SOTA,利用HRnet网络预测骨骼点的heatmap和offset,得到骨骼关键点的坐标和置信度。 heatmap+offset是谷歌在CVPR2017

Victor_X的博客 5767

ARcore的简单平面识别

arcore平面识别

weixin_54479200的博客 609

CenterX:用中国特色社会主义的方式打开CenterNet

本文作者:CPFLAME | 编辑:Amusi 原文链接:https://zhuanlan.zhihu.com/p/323814368 本文已由原作者授权,不得擅自二次转载 太长不看版 笔者重构了一版centernet(objects as points)的代码,并加入了蒸馏,多模型蒸馏,转caffe,转onnx,转tensorRT,把后处理也做到了网络前向当中,对落地非常的友好。 放一个centerX多模型蒸馏出来的效果图,在蒸馏时没有用到数据集的标签,只用了两个teacher的model蒸馏同一.

weixin_47477271的博客 905
上一篇: [Intensive Reading]MOT:FairMOT
下一篇: pip install时timeout设置
zxucver
zxucver 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄11年 2159粉丝 252原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值