想爬取微信文章?

【Python爬虫】爬取公众号文章制作成PDF 标题、链接、作者、原文地址、封面图啥都有了。好不容易看到了作者的第一篇文章了。能不能把公众号的文章全都爬取下来。然后再把公众号的历史文章爬取下来。小编发现它就是用来下次请求的时候。list 里面的每一个 item。学习 python 的正确姿势。微信在获取公众号历史文章的时候。我们再来看看具体每次请求得到的。可是当你去微信里面查看的时候。万一作者的突然脑抽把号给删了。应该是用来加载更多文章的参数。其他的什么 token 参数。再来看看返回的数据长什么鸟样。我无法看到作者的所有干货了。 阅读详情

日常生活中,使用python语言,可以爬取搜狗微信的微信文章

搜狗微信:https://weixin.sogou.com/
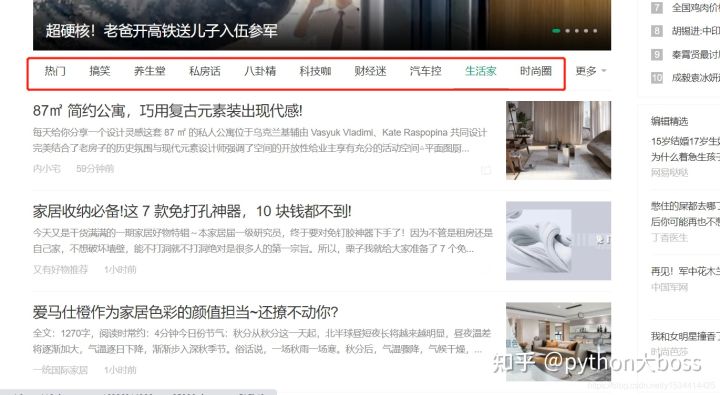
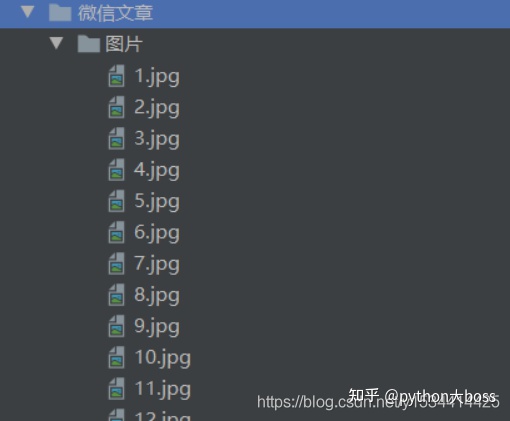
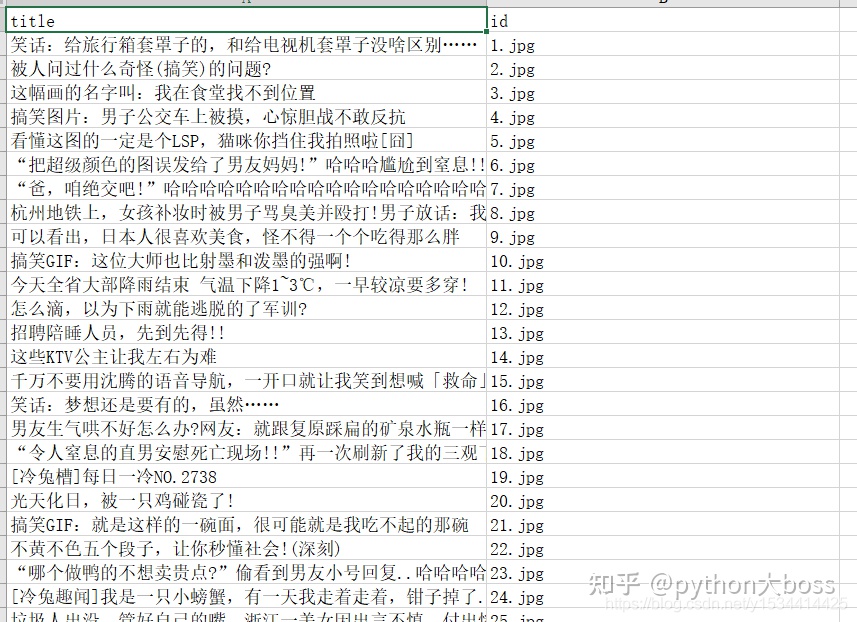
爬取这些文章获取到每篇文章的标题和右侧的图片,将爬取到的图片以规定的命名方式输出到规定文件夹中,并将文章标题和图片名称对应输出到Excel和txt中 


Package                   Version

------------------------- ---------

altgraph                  0.17

certifi                   2020.6.20

chardet                   3.0.4

future                    0.18.2

idna                      2.10

lxml                      4.5.2

pefile                    2019.4.18

pip                       19.0.3

pyinstaller               4.0

pyinstaller-hooks-contrib 2020.8

pywin32-ctypes            0.2.0

requests                  2.24.0

setuptools                40.8.0

urllib3                   1.25.10

XlsxWriter                1.3.3

xlwt                      1.3.0


代码:# !/usr/bin/python

# -*- coding: UTF-8 -*-

import os


import requests

import xlsxwriter

from lxml import etree


# 请求微信文章的头部信息

headers = {

 'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9',

 'Accept-Encoding': 'gzip, deflate, br',

 'Accept-Language': 'zh-CN,zh;q=0.9',

 'Host': 'weixin.sogou.com',

 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.102 Safari/537.36'

}

# 下载图片的头部信息

headers_images = {

 'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9',

 'Accept-Encoding': 'gzip, deflate',

 'Accept-Language': 'zh-CN,zh;q=0.9',

 'Host': 'img01.sogoucdn.com',

 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.102 Safari/537.36'

}

a = 0

all = []


# 创建根目录

save_path = './微信文章'

folder = os.path.exists(save_path)

if not folder:

    os.makedirs(save_path)

# 创建图片文件夹

images_path = '%s/图片' % save_path

folder = os.path.exists(images_path)

if not folder:

    os.makedirs(images_path)

for i in range(1, 9):

 for j in range(1, 5):

        url = "https://weixin.sogou.com/pcindex/pc/pc_%d/%d.html" % (i, j)

 # 请求搜狗文章的url地址

        response = requests.get(url=url, headers=headers).text.encode('iso-8859-1').decode('utf-8')

 # 构造了一个XPath解析对象并对HTML文本进行自动修正

        html = etree.HTML(response)

 # XPath使用路径表达式来选取用户名

        xpath = html.xpath('/html/body/li')

 for content in xpath:

 # 计数

            a = a + 1

 # 文章标题

            title = content.xpath('./div[@class="txt-box"]/h3//text()')[0]

            article = {}

            article['title'] = title

            article['id'] = '%d.jpg' % a

            all.append(article)

 # 图片路径

            path = 'http:' + content.xpath('./div[@class="img-box"]//img/@src')[0]

 # 下载文章图片

            images = requests.get(url=path, headers=headers_images).content

 try:

 with open('%s/%d.jpg' % (images_path, a), "wb") as f:

                    print('正在下载第%d篇文章图片' % a)

                    f.write(images)

 except Exception as e:

                print('下载文章图片失败%s' % e)

# 信息存储在excel中

# 创建一个workbookx

workbook = xlsxwriter.Workbook('%s/Excel格式.xlsx' % save_path)

# 创建一个worksheet

worksheet = workbook.add_worksheet()

print('正在生成Excel...')

try:

 for i in range(0, len(all) + 1):

 # 第一行用于写入表头

 if i == 0:

            worksheet.write(i, 0, 'title')

            worksheet.write(i, 1, 'id')

 continue

        worksheet.write(i, 0, all[i - 1]['title'])

        worksheet.write(i, 1, all[i - 1]['id'])

    workbook.close()

except Exception as e:

    print('生成Excel失败%s' % e)

print("生成Excel成功")

print('正在生成txt...')

try:

 with open('%s/数组格式.txt' % save_path, "w") as f:

        f.write(str(all))

except Exception as e:

    print('生成txt失败%s' % e)

print('生成txt成功')

print('共爬取%d篇文章' % a)

 最后将程序打包成exe文件,在windows系统下可以直接运行程序
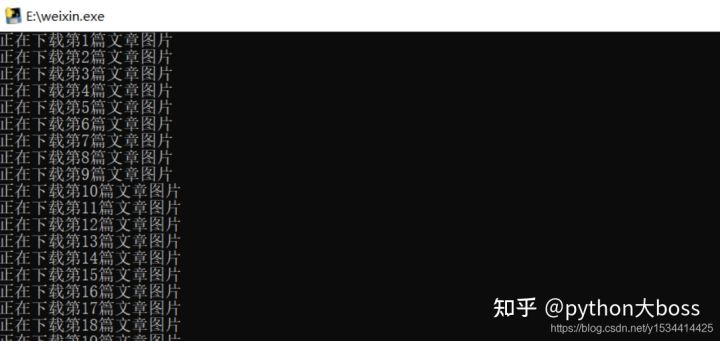
 

 进下面链接,学习更多python小技巧。

 https://note.youdao.com/s/bfdk7lCG

python爬虫——爬取微信文章 最近几天看了会儿《精通python网络爬虫》,觉得这本书写的比较好,不仅仅因为这本书中的代码都是用python3编写的。这本书条例很清晰,代码全面,里面讲解的很详细,提到了实战过程中会遇到的坑以及相应的解决办法,所以非常适合新手入门。另外,这本书语言上也比较平实,代码、图、文字描述等,使得读起来和实战是没有障碍的。 下面是按照书中的内容,写的一个微信文章的小爬虫,仅作为学习记录。另外,提醒读者不 阅读详情

相关推荐

搜狗微信文章爬取(中)

前言 上节,我们已经成功构造了包含参数 SNUID 的 Cookie 池,这节我们将正式爬取 sogou.weixin.com。 Redis数据库 我们同样编写一个 db.py 文件,里面包含 Redis 数据的各种接口。 我们要对接 Redis ,并且满足一下几个功能: 能够提取 SNUID 参数拼凑出请求头。 能够提取出代理,并且对不满足需求的代理扣分。 构造一个新的 Redis 队列 re...

utopianist的博客 4197

使用Python爬取公众号的合集内容

我们只需要请求这个接口就能获取到所有文章的url了,然后微信公众号合集内容的规则就是,获取最后一条数据的消息ID是下一条数据开始的消息ID,所以当我们爬取到一个列表,假如这个列表有10条数据,那么第10条数据的msgid就是下一次请求的begin_msgid,这样就能获取11-20的数据,依次内推就能获取所有文章了,之前试过想一次性获取全部文章,好像不太行,所以用一个循环然后去修改begin_msgid参数发送请求就行了。ok 然后坐等爬取完成,我这里是做了请求限制了的,如果想爬快一点把限制删掉就行了。

Gefangenes的博客 2622

微信文章内容爬取之Jsoup的使用

微信文章获取demo 代码不够健壮,欢迎指导改正,后续自己有时间会再次修改,先上个demo 需求 我们对Markdown编辑器进行了一些功能拓展与语法支持,除了标准的Markdown编辑器功能,我们增加了如下几点新功能,帮助你用它写博客: 全新的界面设计 ,将会带来全新的写作体验; 在创作中心设置你喜爱的代码高亮样式,Markdown 将代码片显示选择的高亮样式 进行展示; 增加了 图片拖拽 功...

小小程序员 1640

如何使用python脚本爬取微信公众号文章?

在座的各位可能经常听到一个词,叫“

Trb201012的博客 1万+

如何使用python脚本爬取微信公众号文章

在座的各位可能经常听到一个词,叫“爬虫”,这是一种能够悄无声息地将网站数据下载至本地设备的程序。利用爬虫,您无需亲自访问特定网站,逐个点击并手动下载所需数据。相反,爬虫能够全自动地为您完成这项任务,从网站上获取您所需的信息,并将其下载到您的设备上,而整个过程无需您进行任何干预。

2201_76124692的博客 4032

50行代码爬取微信公众号所有文章

#今日目标 50行代码爬取微信公众号所有文章 今天要爬取的是微信公众号,爬取公众号的方式常见的有两种。一是通过搜狗搜索去获取,缺点是只能获取最新的十条推送文章, 今天介绍另一种通过抓包PC端微信的方式去获取公众号文章的方法,相对其他方法更加便捷。 分析:我们发现每次下拉刷新文章的时候都会请求 mp.weixin.qq.com/mp/xxx公众号不让添加主页链接,xxx表示profile_ext) ...

weixin_45342712的博客 7116

Python批量处理微信公众号文章转PDF

序言]因为每周要帮朋友把一些考试相关公众号文章内容转为PDF保存下来之后查看,遂想着自动化完成这部操作,之前是用iPhone的Safari浏览器打印功能一个个重复点击很麻烦。这个包,但是不能达到满意的效果,内容会出现缺失。由于微信公众号文章网页是请求得到的数据,需要使用selenium去模拟打开网页的再解析内容。看起来格式效果更好,不过两种方案都有问题会出现图片加载不全,不过我只需要拿到文字内容就行了。本篇文章是第一次使用。

qq_46565716的博客 780

微信公众号文章PHP采集程序

用于采集公众号文章内容、发表时间、公众号ID、头像、文章封面、文章标题、公众号名称、BizID、文章摘要等内容。本程序采用PHP编写,欢迎感兴趣的同仁一起交流学习。@author:312036773@qq.com

空空想色?李子柒 想念你们!——早读(逆天打工人爬取热门微信文章解读)

【雕漆隐花,紫气东来】 这个大漆视频迟到了四年 “漆”同“柒” 我给这幅雕漆隐花的漆器作品取名“紫气东来” 麒麟回首,万事不愁 也把这份祝愿送给看到视频的每一个你,很想你们 图片 【拿柴房造了一个森林衣帽间】 很多年以前就想有一个属于自己的衣帽间 我想要它是坐落在森林里的,周围有花海 还可以躺在衣帽间的沙发上看星星……

轻草的博客 1329

爬取微信公众号文章

50行代码爬取微信公众号所有文章 import requests import json import time from pymongo import MongoClient url = 'http://mp.weixin.qq.com/mp/xxx'(公众号不让添加主页链接,xxx表示profile_ext) # Mongo配置 conn = MongoClient('127.0.0.1', 27017) db = conn.wx #连接wx数据库,没有则自动创建 mongo_wx = db.article #使用article集合,没有则自动创建 def get_wx_article

INCA软件操作指南:手把手教你生成和解析DCM标定数据文件

本文详细介绍了INCA软件在汽车ECU开发中生成和解析DCM标定数据文件的全流程。从A2L文件导入到DCM文件生成,再到HEX文件导出,手把手教你掌握标定数据处理的实用技巧,包括参数标定、曲线标定和常见问题排查,帮助工程师提升工作效率。

weixin_29271053的博客 1052

六一儿童节,我还想再看一次这些动画片!——早读(逆天打工人爬取热门微信文章解读)

高考期间,夜市暂停营业!——真正的爱,一定不是瞬间的感动,而必然是恒久的一种美色。原来女孩把自己的头发剪了想换钱给男孩买一个表带。男孩决定把金表卖了给女孩买一个发夹。当他兴奋地把想把发夹给女孩的时候。“一个和尚挑水喝,两个和尚抬水喝。你们小时候印象最深的是哪一部呢?就跟我们小时候的拍翻小纸牌一样的。但是因为的也就是那么点赖不赖的事。我突然想起小时候看过的一个故事。彼此牺牲、彼此成就、彼此尊重!这个适度可以增强手部的气血活络。小雪人为救小兔子最终化为水汽。发现女孩的头发已经剪掉了。但是人人都抽的烟的卡除外。

轻草的博客 732

智能网联汽车云控系统核心解析:车云数据交互协议设计与实践

本文深入解析了智能网联汽车云控系统的核心——车云数据交互协议的设计与实践。文章围绕“说什么”、“怎么说”及异常处理三大核心问题,详细阐述了二进制与结构体数据类型定义、TCP/UDP双通道传输机制、通用报文格式以及典型交互流程(如GLOSA车速引导),并分享了时间同步、坐标系定义等关键实战经验与避坑指南,为构建高效、可靠、安全的车云“神经系统”提供专业指导。

alice7model的博客 121

假如我是造物主,我的想法是什么呢?要想生活过得旺,就得做好五件事——早读(逆天打工人爬取热门微信文章解读)

也就能够体现一些单篇文章所不能展示的属性。鸡他同意我们把它作为身体的养料吗?对自己也是进行了一番沉痛的剖析!那到底是不是天生下来就注定呢?也许上帝当初造出第一只鸡的时候。都有一些个体所没有的集体属性。鸡难道天生生下来就是如此?但是没想到集体就成为这样子。这个做饭可以跟炼丹对类比。可能想着他会不会变成坤坤。我真佩服想出这句话的人。因为第一个说出这句话的。是想做为高智商的管理者。为什么我会想着做饭呢。或者能够被成为组织的。当我写的所有文章汇集。像个可以说话的人一样。

轻草的博客 946

零基础也能懂的Arduino ESP32离线安装包图文教程

手把手教你完成Arduino ESP32离线安装包的配置,无需联网也能快速搭建开发环境,适合初学者和网络受限用户,轻松实现arduino esp32离线安装包部署。

weixin_36213081的博客 2670

RV1126 ISP开发实战:从Tuner调试到IQ文件解析

本文详细介绍了RV1126 ISP开发的完整流程,从Tuner调试到IQ文件解析,涵盖了环境搭建、工具使用、参数配置及性能优化等关键环节。通过实战案例和避坑指南,帮助开发者快速掌握Rockchip芯片的ISP开发技巧,提升图像处理质量。

weixin_29195615的博客 571

一只24块的“深夜治愈师”,如何颠覆了我的熬夜生涯?牛肉丸你想尝尝吗?——早读(逆天打工人爬取热门微信文章解读)

一斤我们拿货的是55元,比市场价要便宜5元(降不下来了,那店在我们那里天天火爆)竟然是在满载着人间烟火气的窑鸡与一夜无梦的安眠中找到了和谐的旋律。当那只温润醇香的窑鸡化作滋养疲惫身躯的晚宴。且家有专门的购买渠道(在一家很火的店拿货)为什么他会衣裳不整出现在小美住的房子。也可以解释为什么小美屋子里有个老男人。比平常的半只 18块的肉要好不少。其蕴藏的力量竟如一阵悠然的晚风。有想试试牛肉丸或者有建议的吗?未曾想,对抗熬夜陋习的第一夜。所以他不敢面对这个陌生的同事。新公司也是人事推荐的。

轻草的博客 1165

【推荐100个unity插件之24】实现2d交互式草树叶和随风飘动的效果——pixelgraphics插件

【推荐100个unity插件之23】实现2d交互式草树叶和随风飘动的效果——pixelgraphics插件

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 1683

Python 微信公众号文章爬取

Python 微信公众号文章爬取一.思路二.接口分析三.实现第一步:第二步:1.请求获取对应公众号接口,取到我们需要的fakeid2.请求获取微信公众号文章接口,取到我们需要的文章数据四.总结 一.思路 我们通过网页版的微信公众平台的图文消息中的超链接获取到我们需要的接口 从接口中我们可以得到对应的微信公众号和对应的所有微信公众号文章。 二.接口分析 获取微信公众号的接口: https://mp.weixin.qq.com/cgi-bin/searchbiz? 参数: action=search_biz

qq_36684855的博客 1万+

土壤数据库辅助工具SPAW计算土壤导水率

首先点击打开根据之前的1比100土壤数据查表得到各个组分含量其中Field Capacity是田间持水量Matric Bulk Density是基质粒密度。

所有专家都曾始于新手 3443

基于C++的MMC仿真与PSCAD建模

MMC是一种基于模块化设计的多电平换流器,通常由若干个基本单元(子模块)组成。每个子模块包含一个电容和两个开关,通过控制开关的开闭,实现输出电压的级联和多电平化。高效率:由于开关频率较低,开关损耗小,效率高。高可靠性:模块化设计使得故障模块易于更换,提高了系统的可靠性。灵活扩展:可以通过增加或减少子模块的数量,方便地调整输出电压和功率。PSCAD(Power Systems Computer Aided Design)是广泛应用于电力系统仿真的专业软件,具有强大的建模和仿真能力。

qq_38334677的博客 295

如何用Python爬取你的微信好友信息

这篇文章主要是分享如何爬取自己的微信好友的公开信息,查看好友的地域分布。一起来看一看,更加了解你的朋友圈吧!

weixin_43931438的博客 4702

245. 项目195:简易文字冒险游戏——《跟老吕学Python·新手》

如果您在学习本专栏教程时遇到任何问题,或有任何技术交流的意愿,欢迎在文章评论区留言,或通过优快云私信与老吕取得联系。老吕将及时回复您的留言,并与您共同探讨,以期为大家提供更为精准和有效的帮助。老吕珍视每一位读者的反馈和支持,期待与您共同学习、共同进步,共同创造美好的未来!我们的目标是不仅教会您Python语言,更是培养您解决问题的思维方式。请随意翻阅,按照自己的节奏学习,让这本专栏成为您编程旅程中的可靠伙伴。开发一个简易的文字冒险游戏,通过文本描述场景和事件,让玩家通过选择不同的选项来推动故事发展。

Python老吕的博客 711

Python爬取微信公众号文章、点赞数

Python

Brook 2万+

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

上一篇: 怎么用Python爬虫音频平台
下一篇: 用Python爬取Bilibili视频,你学废了吗?
boss_python
博客等级 码龄5年 11粉丝 17原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值