用Python爬取Bilibili视频,你学废了吗?

Python实现对Bilibili视频点赞等信息的爬取 目录前言功能描述功能实现相关资料 前言 最近研究python的爬虫过程中,尝试学习了调用bilibili的各种api,可以爬取视频的信息、弹幕等,也可以爬取up主的基本信息等,故写博客记录爬取视频信息的方法。 功能描述 使用python的request库和json库实现对bilibili网站中视频av号、bv号、收藏数、投币数、点赞数等信息的爬取。 功能实现 import requests import json import csv import pandas as pd # 爬虫地址 alphabet 阅读详情


B 站视频网址:

https://vc.bilibili.com/p/eden/rank#/?tab=全部
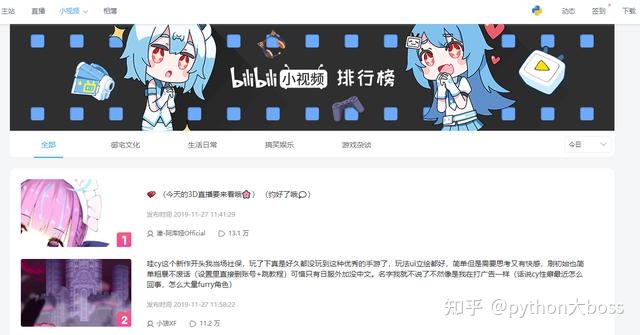
 

 通过 F12 打开开发者模式,然后在 Networking -> Name 字段下找到这个链接:

http://api.vc.bilibili.com/board/v1/ranking/top?page_size=10&next_offset=&tag=%E4%BB%8A%E6%97%A5%E7%83%AD%E9%97%A8&platform=pc
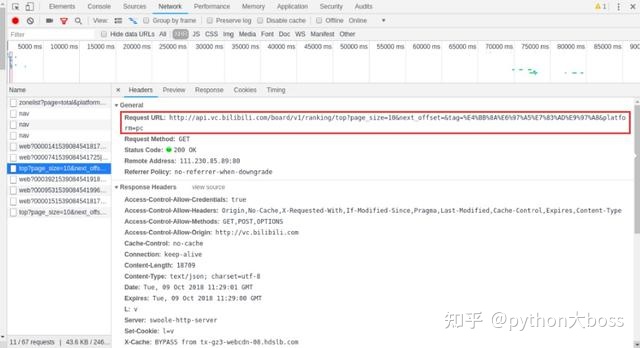
 next_offset 会一直变化,我们可以猜测,这个可能就是获取下一个视频序号,我们只需要把这部分参数取出来,把 next_offset 写成变量值,用 JSON 的格式返回到目标网页即可。
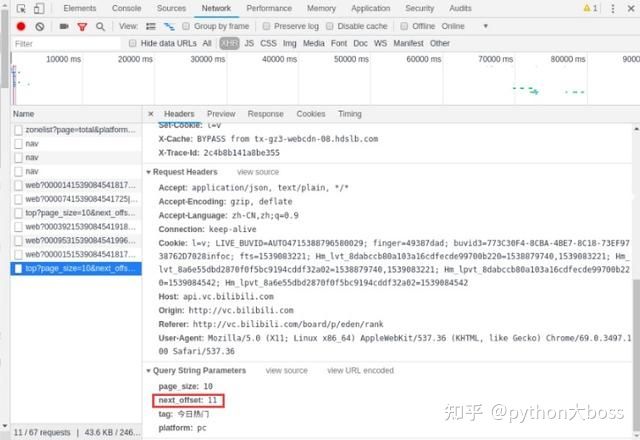
我们通过上面的尝试写了段代码,发现 B 站在一定程度上做了反爬虫操作,所以我们需要先获取 headers 信息,否则下载下来的视频是空的,然后定义 params 参数存储 JSON 数据,然后通过 requests.get 去获取其参数值信息,用 JSON 的格式返回到目标网页即可,实现代码如下:

def get_json(url):
 headers = {
 'User-Agent': 
 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36'
 }
 
 params = {
 'page_size': 10,
 'next_offset': str(num),
 'tag': '今日热门',
 'platform': 'pc'
 }
 
 try:
 html = requests.get(url,params=params,headers=headers)
 return html.json()
 
 except BaseException:
 print('request error')
 pass

为了能够清楚的看到我们下载的情况,我们折腾了一个下载器上去,实现


def download(url,path):
 start = time.time() # 开始时间
 size = 0
 headers = {
 'User-Agent': 
 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36'
 }
 
 response = requests.get(url,headers=headers,stream=True) # stream属性必须带上
 chunk_size = 1024 # 每次下载的数据大小
 content_size = int(response.headers['content-length']) # 总大小
 if response.status_code == 200:
 print('[文件大小]:%0.2f MB' %(content_size / chunk_size / 1024)) # 换算单位
 with open(path,'wb') as file:
 for data in response.iter_content(chunk_size=chunk_size):
 file.write(data)
 size += len(data) # 已下载的文件大小

 效果如下:


#!/usr/bin/env python#-*-coding:utf-8-*-import requestsimport randomimport timedef get_json(url):
 headers = {
 'User-Agent': 
 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36'
 }
 
 params = {
 'page_size': 10,
 'next_offset': str(num),
 'tag': '今日热门',
 'platform': 'pc'
 }
 
 try:
 html = requests.get(url,params=params,headers=headers)
 return html.json()
 
 except BaseException:
 print('request error')
 passdef download(url,path):
 start = time.time() # 开始时间
 size = 0
 headers = {
 'User-Agent': 
 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36'
 }
 
 response = requests.get(url,headers=headers,stream=True) # stream属性必须带上
 chunk_size = 1024 # 每次下载的数据大小
 content_size = int(response.headers['content-length']) # 总大小
 if response.status_code == 200:
 print('[文件大小]:%0.2f MB' %(content_size / chunk_size / 1024)) # 换算单位
 with open(path,'wb') as file:
 for data in response.iter_content(chunk_size=chunk_size):
 file.write(data)
 size += len(data) # 已下载的文件大小
 
 if __name__ == '__main__':
 for i in range(10):
 url = 'http://api.vc.bilibili.com/board/v1/ranking/top?'
 num = i*10 + 1
 html = get_json(url)
 infos = html['data']['items']
 for info in infos:
 title = info['item']['description'] # 小视频的标题
 video_url = info['item']['video_playurl'] # 小视频的下载链接
 print(title)
 
 # 为了防止有些视频没有提供下载链接的情况
 try:
 download(video_url,path='%s.mp4' %title)
 print('成功下载一个!')
 
 except BaseException:
 print('凉凉,下载失败')
 pass
 
 time.sleep(int(format(random.randint(2,8)))) # 设置随机等待时间

 进下面链接,学习更多python小技巧。

https://note.youdao.com/s/bfdk7lCG

Python爬虫之爬取并下载哔哩哔哩视频 它可以爬取并下载视频文件和音频文件!亲自使用过,太好用了。 阅读详情

相关推荐

Python 爬取B站(Bilibili.com)UP主的所有公开视频链接及信息

原文链接:https://blog.xieqiaokang.com/posts/36033.html Github:https://github.com/xieqk/Bilibili_Spider_by_UserID.git Gitee:https://gitee.com/xieqk/Bilibili_Spider_by_UserID.git 环境准备 selenium bs4 安装 这里使用 conda 安装,也可使用 pip conda install selenium bs4 seleniu.

xieqk's blog 1万+

非常好的Ansible入门教程(超简单)

Ansible是一个配置管理和配置工具,类似于Chef,Puppet或Salt。这是一款很简单也很容易入门的部署工具,它使用SSH连接到服务器并运行配置的任务,服务器上不用安装任何多余的软件,只需要开启ssh,所有工作都交给client端的ansible负责。 关于Ansible的一个好处是,将bash脚本转换为可执行任务是非常容易的。我们可以编写自己的配置程序,但是Ansible更加干净,因为它

pushiqiang的博客 15万+

python爬取bilibili弹幕_用Python爬取B站视频弹幕

原标题:用Python爬取B站视频弹幕via:菜J学Python众所周知,弹幕,即在网络上观看视频时弹出的评论性字幕。不知道大家看视频的时候会不会点开弹幕,于我而言,弹幕是视频内容的良好补充,是一个组织良好的评论序列。通过分析弹幕,我们可以快速洞察广大观众对于视频的看法。下面是通过一个关于《八佰》的视频弹幕数据,绘制了如下词云图,感觉效果还是可以的。 海量的弹幕数据不仅可以绘制此类词云图,还可以调...

weixin_39854923的博客 2004

Python爬虫之bili站的正确打开方式

我用 Python 对 b 站的小视频进行了爬取,因为是小视频,大小平均在 5 兆以内。排队时,没网络也能看小姐姐了,爽啊。文末给出了源码获取方式。 b 站小视频地址: http://vc.bilibili.com/p/eden/rank#/?tab=全部 我爬取了每日的小视频排行榜,学会了每日的,爬取本周、本月的就非常简单了,改个标签就行,稍后详细分析会讲到。以下是爬取结果。...

zhusongziye的博客 853

Python 爬取Bilibili 视频

import requests from lxml import html import os import pprint import time import random from requests.packages.urllib3.exceptions import InsecureRequestWarning requests.packages.urllib3.disable_warn...

csdnsunyf的专栏 1218

python B站原视频爬取,最高清晰度爬取。将你喜欢的up主的视频保存下来吧。

B站原视频爬取,我就不多说直接上代码。直接运行就好。 B站是把视频和音频分开。要把2个合并起来使用。这个需要分析才能看出来。然后就是登陆这块是比较难的。 import os import re import argparse import subprocess import prettytable from DecryptLogin import login '''B站类''' class Bilibili(): def __init__(self, username, password, **kwa

weixin_43286365的博客 1万+

Bilibili播放-获取B站播放视频源地址的过程

如果是为了下载B站视频呢,直接用 You-get,然而,我们的需求就是要在线看B站视频(清晰度要求不高),要求内嵌在自己的程序中,直接观看,加载速度要快!那先下载再预览绝对是不行了。只能尝试去获取播放源地址 获取播放源地址的过程很曲折,移动端抓包,PC-web端分析,后来,发现一个网站,终于找到了一线希望。 就是ibilibili.com了 这个网站的功能呢,就是很方便的让你获取B站视频的下载地址...

ucsheep-You see sheep! 19万+

playwright——实现bilibili爬取

最后,根据爬虫类型的不同,它会执行搜索或详情爬取操作。接着,它会创建一个任务列表,遍历视频ID列表,为每个视频ID创建一个异步任务,并将这些任务添加到任务列表中。它首先创建了一个信号量来限制并发请求的数量,然后创建了一个任务列表,遍历指定的视频ID列表,为每个视频ID创建一个获取视频信息的任务,并将这些任务添加到任务列表中。在获取了视频的信息之后,它会遍历视频详情列表,如果视频详情不为空的话,就会调用bilibili.update_bilibili_video方法来更新bilibili视频的信息。

m0_52073444的博客 1573

使用python爬虫爬取bilibili视频

可以使用 Python 爬虫框架如 Scrapy 来爬取 Bilibili 的视频。首先需要了解 Bilibili 网站的构造,包括数据是如何呈现的,然后构建请求来获取所需的数据。同时需要考虑反爬虫措施,可能需要使用代理 IP 和 User-Agent 等方法来绕过反爬虫机制。 这里提供一个简单的爬取视频标题的例子 import requests from bs4 import Beautiful...

weixin_42609225的博客 3935

找出bilibili隐藏在后方的视频并突破访问限制实现爬取

冲浪无意看到网上的bilibili爬虫,请求可能有变了,部分并不是十分方便,于是就趁着周末,去尝试做了bilibili的这么一个视频爬虫,过程就不一一介绍了,主要是思路,本文也并不是写的小白向爬虫教程。 在开始的时候我们可以发现:如果是单个分享链接的话如下https://b23.tv/ID 也就是https://m.bilibili.com/video/ID 例:https://m.bilibili.com/video/abcde 这个链接我们用作最开始的请求url前部分, abcde为后面的bvid,这

梦之序章的博客 3097

C++学习(四六六)Multiple parse contexts are available for this file

Note: Multiple parse contexts are available for this file. Choose the preferred one from the editor menu 参考: "Multiple parse contexts" in Qt creator | Qt ForumHi Do you use sessions? https://bugreports.qt.io/browse/QTCREATORBUG-18521 Anyway, its not.

hankern的专栏 4610

python爬取bilibili视频

俺好久没用python的pip了,今天pip3 install you-get的时候提示我要更新了。 You are using pip version 19.1.1, however version 20.0.2 is available. You should consider upgrading via the 'python -m pip install --upgrade pip' ...

麦芽雪冷萃 3455

POST 接口,将参数拼接到 URL 上,而不是将其作为表单数据发送

POST 接口,将参数拼接到 URL 上,而不是将其作为表单数据发送

pig_ning的博客 3144

深入解析:使用Python爬取Bilibili视频

深入解析:使用Python爬取Bilibili视频

LucianaiB的博客 5996

【网络协议】TCP的拥塞控制机制

前言 计算机网络中的带宽、交换节点中的缓存和处理机等,都是网络的资源,在某段时间内,若对网络中某一资源的需求超过了该资源所能提供的可用部分,网络的性能就要变坏,这种情况就叫做拥塞。 所谓拥塞控制,就是防止过多的数据注入到网络中,从而使网络中的路由器或链路不致过载。要注意用拥塞控制与流量控制的区别,拥塞控制是一个全局性的过程,涉及到所有的额主机、路由器,以及与降低网 拥塞控制的算法有:慢开始、拥塞避免、快重传、快恢复四种。 慢开始和拥塞避免 发送方维持一个拥塞窗口的状态变量,其大小取决于网络的拥塞程度

兰亭风雨的专栏 1万+

setup time和hold time的计算

内容仅仅为了方便记忆,与原理无关

sddhyl的博客 7814

Python爬取bilibili视频(期末设计)

Python爬取bilibili视频(期末设计) 摘要 为了解决PC端的bilibili无法下载视频的问题,使用python语言可以实现一个能够爬取bilibili某个视频资源(不包括会员视频)的程序。采用整个视频下载与分片拼接视频两种思路实现程序,比较两种方式的下载效率,最终采用分片下载视频再拼接成为一个视频的方式实现了bilibili视频(不包括会员视频)的下载。实现bilibili视频下载,可以用于离线观看或者收集成为视频素材或者用于剪辑,具有一定实际的用途。 引言 由于bilibili只能通过手机a

XT-LL的博客 3928

Outlook日历同步全攻略:Win10+安卓+iOS三端无缝衔接(附常见问题解决)

本文提供了一份详尽的Outlook日历同步指南,帮助用户在Windows 10、安卓和iOS三端实现无缝衔接。文章深入解析了Exchange ActiveSync等核心同步原理,并给出了从账户创建到各设备(特别是华为手机)的具体配置步骤、进阶管理技巧以及针对同步失败、事件重复等常见问题的实战解决方案,旨在彻底解决跨平台日程管理的痛点。

l3m4n的博客 551

python爬取bilibili数据_如何使用Python爬取bilibili视频(详细教程)

Python爬取bilibili视频摘要为了解决PC端的bilibili无法下载视频的问题,使用python语言可以实现一个能够爬取bilibili某个视频资源(不包括会员视频)的程序。采用整个视频下载与分片拼接视频两种思路实现程序,比较两种方式的下载效率,最终采用分片下载视频再拼接成为一个视频的方式实现了bilibili视频(不包括会员视频)的下载。实现bilibili视频下载,可以用于离线观看...

weixin_39611308的博客 2613

【ISP图像处理】Demosaic去马赛克技术演进与边缘优化策略

本文深入解析了ISP图像处理中的Demosaic(去马赛克)技术。从Bayer阵列原理出发,梳理了从双线性插值、Hamilton-Adams边缘导向算法到利用通道相关性与自相似性的技术演进历程,并重点探讨了针对边缘与纹理伪影的优化策略,为工程实践中的算法选型与硬件协同设计提供了专业指导。

weixin_29091445的博客 387

C++ Qt6 qml CMakeLists.txt如何添加qrc文件

本文介绍了在Qt6项目中如何通过CMake管理QML图片资源。相比Qt5的qmake,CMake需要手动创建qrc文件并配置CMakeLists.txt。关键步骤包括:1)创建resources.qrc文件并添加图片资源;2)在CMakeLists.txt中设置CMAKE_AUTORCC为ON开启自动资源处理;3)使用qt_add_resources将qrc文件绑定到项目。配置完成后,可通过"qrc:alias"方式引用资源图片,解决了相对路径管理复杂的问题。

琅嬛福地 1453

Python爬取哔哩哔哩(bilibili)视频

本篇文章主要给大家讲解下如实使用python 爬取哔哩哔哩中的视频,首先我是一名大数据开发工程师,爬虫只是我的一个业余爱好,喜欢爬虫的小伙伴可以一起交流。好了多了就不多说了喜欢的朋有可以收藏,转发请复原文链接谢谢。 一、环境准备 我这里使用的是环境如下仅供参考: 开发工具: pycharm python环境:python-3.8.0 依赖的包: shutil,os,re,json,choice,requests,lxml 二、页面分析 我在这里就拿前段时间非常火的马老师的视频来举例子吧。 视频...

chinaherolts2008的博客 8247

Matlab:Matlab 软件学习之Matlab内置的各种系统的简介、案例应用(基于Simulink模糊控制仿真/二阶瞬态震荡电路案例)之详细攻略

选择左上角要编辑变量的图标,给定当前变量的论域Range,设置隶属函数类型type(八种隶属函数类型以供选择),最后选中某个隶属度函数(选中为红色),移动绘图区的每个隶属度函数的三个端点(竖向为权重)。(1)、首先在模糊规则编辑器左边选择一个输入变量,并选中它的一个语言值(隶属函数),然后编辑器右边选择一个输出变量,并选中它的一个语言值(隶属函数),然后将这种关系添加到模糊规则中。制定完成后,会形成模糊规则矩阵,系统会根据模糊输入量(如r1、r2),经过模糊规则(如45条),进而确定输出量(Y1、Y2)。

走向CTO之路 1122

Python爬虫之bilibili视频弹幕爬取并保存为JSON格式(详解分析+代码实现)

一、项目介绍         今天我们的爬虫内容是bilibili视频弹幕爬取,并保存到本地为JSON格式,正常爬虫只需要发送请求,解析相应内容,而爬取bilibili的内容,视频弹幕并没在响应的html中,而是保存在一个响应的url中,以XML格式保存,所以这算是一个新的内容,我会在下面进行详解。 二、所需技术 import requests (发送请求...

IronmanJay 6056

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

深入解析:使用Python爬取Bilibili视频的完整指南

通过本文,我们详细介绍了如何使用Python进行Bilibili视频信息的爬取工作,包括环境配置、API调用和数据存储等步骤。尽量遵循合法合规的爬取方式,以便更好地进行数据分析和创新应用。

码上飞扬的博客 2248

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: 想爬取微信文章?
下一篇: 抖音怎么用python爬虫呢?
boss_python
博客等级 码龄5年 11粉丝 17原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值